El Reintento que Sabe Esperar: Patrones de Resiliencia para Arquitecturas de Microservicios
- Mauricio ECR
- Arquitectura
- 03 Oct, 2026
Has estado ahí. Tu microservicio recibe la respuesta de un servicio externo y no es un error técnico: no hay stack trace, no hay excepción que capturar, no hay un HTTP 500. Es algo más sutil, un estado de negocio que dice ahora no. CANCELADO. NO DISPONIBLE. El servicio está vivo, responde, simplemente no puede atender tu solicitud en este momento.
Poco después llega la instrucción del negocio: inténtalo más tarde. Y ahí empieza el problema real.
«Más tarde» suena razonable hasta que se traduce a un sistema distribuido. ¿Cuánto es más tarde? ¿Quién guarda esa intención mientras transcurre? ¿Qué ocurre si el proceso que debía esperar se reinicia a mitad de camino, o si el mismo mensaje se entrega dos veces y el reintento se duplica? ¿Y si llegan mil respuestas CANCELADO en el mismo minuto y todas deben esperar a la vez sin que nadie gaste recursos esperando?
Lo que parecía un detalle de implementación es un problema de diseño con nombre, con componentes y con varias formas de salir mal si se improvisa. Este artículo recorre ese diseño completo: por qué la espera debe ser un dato y no un proceso, qué piezas la sostienen, cómo se evita que un fallo en cualquier punto produzca duplicados o transacciones atascadas, y cómo se concreta todo en AWS, sin olvidar que el patrón es más importante que cualquier servicio.
Por qué no basta con dormir el proceso
El primer instinto suele ser retener el proceso. Un Thread.sleep, un hilo bloqueado, o un mensaje que no se confirma para que el broker lo reentregue pasado un rato. Es tentador porque funciona en local, con poco volumen y en las demostraciones donde los casos borde son teóricos.
El costo, sin embargo, crece en silencio: un proceso que espera sigue siendo un proceso. Con diez esperas simultáneas el impacto es marginal. Con mil, cifra que cualquier sistema bajo carga real alcanza sin esfuerzo, la infraestructura paga por tiempo en el que no trabaja. Escalar horizontalmente no ayuda, porque solo multiplica los procesos igualmente bloqueados.
La raíz del problema es conceptual. Se está modelando la espera como una actividad, cuando en realidad es un estado. Un proceso dormido consume memoria, hilos y conexiones, mientras que un registro en una base de datos no consume nada mientras espera: existe, y el sistema lo consulta cuando necesita saber qué hacer.
De esa distinción nace el patrón de reintento diferido duradero. Consiste en convertir la intención de «volver a intentarlo en el instante T» en información persistente, en lugar de mantenerla como tiempo de ejecución.
Tres preguntas, tres responsabilidades
Para que la espera viva en el sistema sin ocupar procesos hay que responder tres preguntas distintas, y conviene que cada una tenga un dueño distinto. La primera es cuándo debe ocurrir el reintento: alguien tiene que conservar la intención «actúa en este instante» y cumplirla aunque pasen horas. La segunda es si el reintento todavía tiene sentido cuando el momento llegue, porque la transacción pudo resolverse por otra vía mientras esperaba. La tercera es cómo garantizar que el reintento se ejecute una sola vez, aunque el sistema falle en el medio.
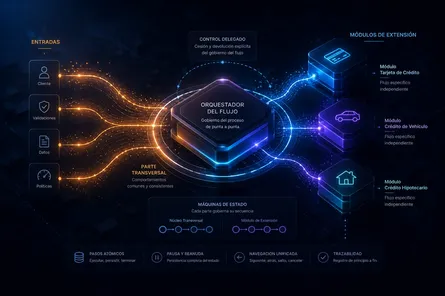
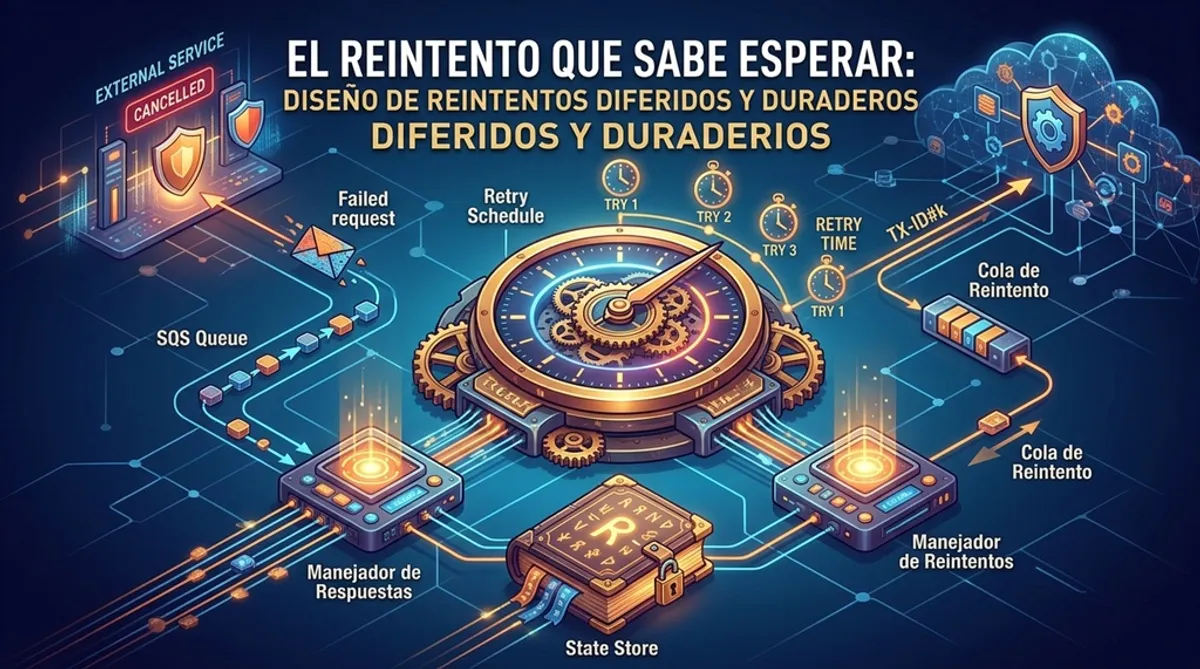
El diseño reparte esas responsabilidades entre unas pocas piezas. Tres colas desacoplan a los participantes: una recibe las respuestas del servicio externo, otra entrega los eventos de reintento cuando el planificador los dispara, y una tercera lleva las solicitudes hacia el servicio externo. Un almacén de estado funciona como fuente de verdad: guarda el estado de cada transacción, el intento en curso y el instante previsto del próximo disparo, y solo acepta cambios condicionales. Un planificador diferido conserva la intención de «entregar este evento en el instante T» sin mantener ningún proceso ocupado. Dos manejadores ejecutan la lógica de negocio: el manejador de respuestas (lo llamaré A) interpreta lo que dice el servicio externo y decide si hay que planificar un reintento, y el manejador de reintentos (B) recibe el evento del planificador, comprueba que siga siendo válido y publica la nueva solicitud. Por último, las colas de mensajes fallidos (DLQ, por dead-letter queue) aíslan lo que no se pudo procesar o entregar y levantan alertas.
Lo que hace correcto al conjunto no es la sofisticación de cada pieza, sino que cada una resuelve exactamente una cosa y desconoce las demás. El planificador no sabe nada de negocio, el almacén no sabe cuándo disparar y los manejadores no se conocen entre sí. Esa ignorancia mutua permite que el sistema se recupere de un fallo sin que ninguna pieza tenga que coordinarse con otra.
Hay además una decisión que protege el modelo existente: el planificador nunca habla directamente con el servicio externo. Publica en la cola de reintento y es B quien decide qué hacer con ese evento. Así no se abren nuevos endpoints ni se introducen caminos de ejecución paralelos. El planificador responde al cuándo y la lógica de negocio sigue viviendo donde siempre vivió.
El siguiente diagrama sigue el recorrido de un mensaje desde que el servicio externo responde CANCELADO hasta que se publica una nueva solicitud, o se descarta si ya no hace falta. Las líneas punteadas marcan rutas de fallo.
flowchart TD
    EXT["Servicio externo"] --> QR[["Cola de respuesta"]]
    QR --> A["Manejador de respuestas (A)"]
    QR -.->|mensajes fallidos| DLQ0[["DLQ de respuesta"]]
    A <--> DB[("Almacén de estado")]

    A -->|EXITOSO| OK["Flujo habitual"]
    A -->|CANCELADO, intentos agotados| FAIL["Marcar FALLIDA<br/>+ alerta"]
    A -->|"CANCELADO, intentos disponibles<br/>(1. PLANIFICANDO + proximo_disparo<br/>2. crear planificación)"| PL["Planificador diferido<br/>(espera creciente)"]

    PL --> QRE[["Cola de reintento"]]
    PL -.->|falla de entrega| DLQ1[["DLQ del planificador"]]
    QRE -.->|mensajes fallidos| DLQ2[["DLQ de reintento"]]

    QRE --> B["Manejador de reintentos (B)"]
    B <--> DB
    B -->|obsoleto o ya procesado| DROP["Descartar"]
    B -->|sigue pendiente| QS[["Cola de solicitud"]]
    QS --> EXT
Una convención pequeña que evita errores grandes
Antes de hablar de estados hay que fijar un detalle de numeración que parece trivial y, sin embargo, es responsable de errores muy difíciles de rastrear. El intento = 1 es la solicitud original, la primera vez que el microservicio contacta al servicio externo. El primer reintento es el intento = 2, el segundo es el intento = 3, y así sucesivamente. El campo max_intentos cuenta la solicitud original, no solo los reintentos: con max_intentos = 4 hay una solicitud original y hasta tres reintentos.
Si esto no queda escrito, el error de off-by-one aparece tarde y en producción. Una transacción hace un reintento de más porque alguien contó desde cero, o se detiene antes de tiempo porque otro incluyó el original en el conteo de reintentos. Son bugs silenciosos: el sistema funciona, pero no se comporta como el negocio espera.
El almacén de estado y las reglas del juego
Con la numeración clara, el siguiente paso es definir qué guarda el almacén para cada transacción. Son pocos campos, pero cada uno tiene una razón de ser.
| Campo | Qué significa | Cuándo cambia |
|---|---|---|
transaccion_id | Clave primaria | Nunca |
estado | EN_CURSO, PLANIFICANDO, PLANIFICADO, ENVIANDO, EXITOSA o FALLIDA | En cada transición condicional |
intento_actual | Último intento (n) cuya solicitud salió hacia el servicio externo | Al pasar de ENVIANDO a EN_CURSO, donde se convierte en n+1 |
intento_siguiente | Intento (n+1) que se está planificando o enviando; vacío en otro caso | Se fija al pasar de EN_CURSO a PLANIFICANDO y se limpia al volver a EN_CURSO |
max_intentos | Tope de intentos, contando el original | Constante |
proximo_disparo | Instante UTC del reintento, con la variación aleatoria ya incorporada | Se escribe junto con la transición a PLANIFICANDO |
actualizado_en | Auditoría y detección de transacciones detenidas | En cada escritura |
La razón de modelar así es que la corrección de un flujo distribuido no está en el orden de los pasos. La trampa más común al diseñar reintentos es suponer que, si cada paso se ejecuta en el orden correcto, el resultado será correcto. Pero los mensajes se reentregan, se duplican, llegan tarde, o el proceso se cae a mitad de una operación y reaparece con el mismo mensaje en la cola. En esas condiciones, la única forma de mantener la consistencia es trabajar con estados explícitos y permitir cada transición solo si el estado actual es exactamente el esperado. Si no coincide, el mensaje es obsoleto o duplicado, y se descarta sin ejecutar nada. En DynamoDB esto se logra con una ConditionExpression, y en una base relacional con un UPDATE ... WHERE estado = :esperado AND intento_actual = :n.
La vida de una transacción discurre así. Nace en EN_CURSO cuando se envía la solicitud original. Si la respuesta es exitosa, termina en EXITOSA. Si llega un CANCELADO y los intentos están agotados, termina en FALLIDA. Pero si todavía quedan intentos, pasa primero a PLANIFICANDO, un estado intermedio que significa «se decidió reintentar, aunque la planificación puede no existir aún», y luego a PLANIFICADO cuando la planificación queda confirmada. Cuando llega el evento, la transacción pasa a ENVIANDO mientras se publica la nueva solicitud y vuelve a EN_CURSO, ya con el intento incrementado, cuando la solicitud sale. Si mientras espera la transacción se resuelve por otra vía (un proceso manual, una corrección externa), puede pasar directamente a EXITOSA.
stateDiagram-v2
    [*] --> EN_CURSO: solicitud enviada (intento n)
    EN_CURSO --> EXITOSA: respuesta EXITOSO
    EN_CURSO --> FALLIDA: CANCELADO y n = max_intentos
    EN_CURSO --> PLANIFICANDO: CANCELADO y n < max_intentos<br/>(guarda intento_siguiente y proximo_disparo)
    PLANIFICANDO --> PLANIFICADO: planificación confirmada
    PLANIFICANDO --> ENVIANDO: evento llega antes de confirmar
    PLANIFICADO --> ENVIANDO: llega el evento (intento n+1)
    ENVIANDO --> ENVIANDO: reentrega retoma la publicación
    ENVIANDO --> EN_CURSO: solicitud publicada (intento_actual = n+1)
    PLANIFICANDO --> EXITOSA: resuelta por otra vía
    PLANIFICADO --> EXITOSA: resuelta por otra vía
    EXITOSA --> [*]
    FALLIDA --> [*]
Cada flecha del diagrama es, en realidad, una condición: «pasa a este estado solo si el estado actual es aquel y el número de intento es este». Si cualquiera de las dos cosas falla, la operación no se ejecuta, y esa regla aplicada sin excepciones es lo que hace correcto al sistema aunque los mensajes lleguen duplicados o desordenados.
Conviene decir que la regla de «resuelta por otra vía» es una decisión, no una verdad universal. Aquí se permite desde PLANIFICANDO y PLANIFICADO, pero no desde ENVIANDO: en ese punto la solicitud ya está en vuelo y será la respuesta del servicio externo la que decida el destino. Otros equipos podrían optar por permitirla también desde ENVIANDO e intentar cancelar la solicitud. Lo importante es elegir y dejarlo documentado.
Tres escrituras que no son atómicas
Cuando A recibe un CANCELADO y decide planificar un reintento, tiene que hacer tres cosas: actualizar el almacén de estado, crear la planificación y confirmar el mensaje de la cola. Ninguna de las tres está conectada a las otras por una transacción. Si el proceso cae entre dos de ellas, el mensaje se reentregará y A deberá poder retomar desde donde quedó, sin duplicar ni perder nada.
La primera versión intuitiva de este flujo calculaba la fecha del reintento en el momento de crear la planificación. Funciona hasta que el proceso cae justo después de crearla y antes de anotar nada: la reentrega vuelve a calcular, y como la espera incluye una variación aleatoria, obtiene un instante distinto y crea una segunda planificación para el mismo intento. El negocio terminaba viendo reintentos duplicados sin que ningún componente hubiera «fallado» en sentido estricto.
La solución es cuestión de orden. Cuando A detecta un CANCELADO con intentos disponibles, lo primero que hace es una transición condicional de EN_CURSO(n) a PLANIFICANDO, y en esa misma escritura guarda intento_siguiente = n+1 y el proximo_disparo, el instante exacto del reintento. Solo después crea la planificación, usando ese instante ya persistido. Si el proceso cae entre ambos pasos, la reentrega encuentra la transacción en PLANIFICANDO, lee el proximo_disparo guardado e intenta crear la planificación de nuevo. Si ya existía, el planificador responde con un error de conflicto que A trata como éxito, porque la planificación está creada con el instante correcto. El resultado es el mismo: un único reintento programado.
El flujo completo de A queda así. Primero descarta las respuestas tardías: si el número de intento de la respuesta no coincide con intento_actual, pertenece a un intento viejo y se confirma sin más. Si es EXITOSO y la transacción está EN_CURSO, pasa a EXITOSA. Si es CANCELADO y n = max_intentos, pasa a FALLIDA y se emite una alerta de negocio. Y si es CANCELADO con intentos disponibles, ejecuta la secuencia descrita: guardar el instante, crear la planificación, marcar PLANIFICADO y confirmar el mensaje. Si en cualquier reentrega la transacción ya está más adelante, en PLANIFICADO o ENVIANDO, significa que otra ejecución ya hizo el trabajo: A confirma el mensaje y termina. Del mismo modo, si la transición final a PLANIFICADO falla porque el estado ya avanzó, es un éxito, no un error.
sequenceDiagram
    participant Q as Cola de respuesta
    participant A as Manejador A
    participant DB as Almacén de estado
    participant PL as Planificador
    Q->>A: CANCELADO (intento n)
    A->>DB: EN_CURSO(n) → PLANIFICANDO + proximo_disparo
    Note over A,DB: Punto de fallo 1
    A->>PL: Crear planificación (nombre determinista)
    Note over A,PL: Punto de fallo 2
    PL-->>A: OK o conflicto (= éxito)
    A->>DB: PLANIFICANDO → PLANIFICADO
    Note over A,DB: Punto de fallo 3
    A->>Q: confirmar mensaje
Cuando el evento llega: ejecutar una sola vez
Horas después, el planificador dispara el evento y este aterriza en la cola de reintento, donde B lo recoge. Tanto el planificador como la cola ofrecen entrega al menos una vez, lo cual significa que el mismo evento puede llegar dos veces. B tiene que producir el mismo resultado en ambos casos, y para ello usa las mismas transiciones condicionales que A.
Al recibir el evento, B lee la transacción. Si el intento del evento no coincide con intento_siguiente, el evento es obsoleto y se descarta. Si coincide, mira el estado: desde PLANIFICADO o PLANIFICANDO intenta la transición a ENVIANDO; si ya está en EN_CURSO, EXITOSA o FALLIDA, el mensaje es un duplicado de un procesamiento terminado y se descarta. Una vez en ENVIANDO, publica la nueva solicitud en la cola del servicio externo con una clave de idempotencia que combina el identificador de la transacción con el número de intento (por ejemplo, TX-100200#2). Por último, la transición de ENVIANDO a EN_CURSO fija intento_actual = n+1, limpia intento_siguiente y cierra el ciclo.
Aquí aparecieron dos dificultades.
La primera es una carrera. Si el evento llega mientras la transacción sigue en PLANIFICANDO, porque A fue lento, cayó o su reentrega se demoró, un B que exigiera PLANIFICADO descartaría el evento, y después A marcaría PLANIFICADO sin que nadie volviera a disparar el reintento. La transacción quedaría esperando un evento que ya pasó. La salida es que B acepte también PLANIFICANDO como estado de partida, y que A trate como éxito el fallo condicional que encontrará después.
La segunda es más sutil. Si B cae después de pasar a ENVIANDO y antes de publicar, la reentrega encuentra la transacción en ENVIANDO. Con una regla ingenua de «si el estado no es el esperado, descartar», ese mensaje se tiraría y la transacción quedaría atascada para siempre, sin solicitud y sin nadie que la reintente. Por eso, cuando B encuentra ENVIANDO con el intento correcto, no descarta: retoma. Vuelve a publicar con la misma clave de idempotencia y completa la transición a EN_CURSO.
Esa decisión tiene un precio que hay que aceptar con los ojos abiertos. Si dos entregas del mismo evento llegan en paralelo, ambas pueden publicar la solicitud. Es inocuo únicamente porque el servicio externo descarta el duplicado gracias a la clave de idempotencia. Esa es una precondición del patrón, no un detalle: si el servicio externo no respeta la clave, el diseño necesita el patrón outbox. En él, la solicitud a publicar se guarda en el almacén junto con la transición de estado, y un publicador independiente se encarga de enviarla de forma fiable. Es más costoso de construir, pero elimina del todo la ventana entre publicar y confirmar.
sequenceDiagram
    participant PL as Planificador
    participant Q as Cola de reintento
    participant B as Manejador B
    participant DB as Almacén de estado
    participant QS as Cola de solicitud
    PL->>Q: evento (intento n+1)
    Q->>B: entrega del evento
    B->>DB: PLANIFICADO o PLANIFICANDO → ENVIANDO
    Note over B,DB: Punto de fallo 1
    B->>QS: publicar (clave transaccion_id#n+1)
    Note over B,QS: Punto de fallo 2
    B->>DB: ENVIANDO → EN_CURSO (intento_actual = n+1)
    Note over B,DB: Punto de fallo 3
    B->>Q: confirmar mensaje
Una espera que crece para no presionar siempre igual
Hay una pregunta que todavía no hemos contestado: cuánto hay que esperar. Si la causa del CANCELADO persiste, porque el servicio externo tiene un problema que tarda en resolverse, reintentar con el mismo intervalo cada vez aplica la misma presión sin darle tiempo real de recuperarse. La espera debería crecer. La fórmula, configurable, es la siguiente:
espera(k) = min( base × factor^(k-1) , tope ) × (1 + u), u ∈ [-jitter, +jitter]Aquí k es el número de reintento (tras fallar el intento n, se usa k = n), base es la espera antes del primer reintento, factor es cuánto crece en cada paso, tope es el máximo de la espera nominal y jitter es la variación aleatoria relativa. Con valores típicos (base = 2 h, factor = 2, tope = 24 h, jitter = ±10 %), una transacción con max_intentos = 4 queda así:
| Reintento | Intento | Espera nominal | Rango con ±10 % |
|---|---|---|---|
| 1 | 2 | 2 h | 1 h 48 min – 2 h 12 min |
| 2 | 3 | 4 h | 3 h 36 min – 4 h 24 min |
| 3 | 4 | 8 h | 7 h 12 min – 8 h 48 min |
Un matiz que suele pasarse por alto: en la fórmula, la variación se aplica después del tope, de modo que la espera real puede llegar a tope × 1,1, es decir, 26,4 horas con estos valores. Si el negocio necesita un máximo estricto, hay que recortar de nuevo tras aplicar la variación. Cualquiera de las dos opciones es válida, siempre que esté documentada.
El jitter merece su propio párrafo porque no es un adorno. Imagina que llegan mil respuestas CANCELADO en el mismo minuto, por una caída momentánea del servicio externo. Si todas calculan exactamente la misma espera, sus reintentos se disparan al mismo instante horas después y golpean al servicio en ráfaga, justo cuando intentaba recuperarse. La variación aleatoria dispersa esa ráfaga a lo largo de un intervalo, y reparte la carga de forma natural.
Hay, además, una decisión con impacto directo en la corrección: el jitter se calcula en la aplicación, no se delega al planificador. Así el proximo_disparo, con su variación ya incorporada, queda registrado en el almacén. Si el proceso falla y el mensaje se reentrega, la planificación se recrea con exactamente el mismo instante, y el comportamiento es determinista aunque el proceso se haya reiniciado.
Esta política tampoco tiene por qué ser uniforme. No todo CANCELADO representa la misma situación de negocio: algunos justifican esperas cortas y otros largas, y el criterio puede depender del tipo de transacción, del cliente o del motivo concreto del rechazo.
Proteger al servicio que se quiere recuperar
El jitter ayuda, pero no es suficiente si el volumen es muy alto o si el servicio externo está en un estado delicado. B debería incorporar tres controles adicionales.
El primero es limitar su propia concurrencia al publicar en la cola de solicitud. Si B puede procesar cien eventos por segundo pero el servicio externo solo absorbe diez, el límite debe vivir en B y no depender de que el servicio resista.
El segundo es un cortacircuitos (circuit breaker). Si el servicio está claramente degradado, porque responde lento, con errores o directamente no responde, tiene más sentido pausar o reprogramar los reintentos que seguir gastando el presupuesto de max_intentos. Un fallo por indisponibilidad técnica no equivale a un CANCELADO de negocio, y tratarlos igual acorta artificialmente la vida de una transacción que aún podría resolverse. Conviene advertir que la máquina de estados que hemos descrito no modela esta transición; hacerlo implicaría permitir, por ejemplo, volver de PLANIFICADO o ENVIANDO a PLANIFICANDO conservando intento_siguiente y fijando un nuevo proximo_disparo, con un nombre de planificación que incluya un sufijo de secuencia para evitar conflictos con el anterior.
El tercero es la cancelación proactiva de planificaciones. Si una transacción se resuelve por otra vía y todavía tiene una planificación pendiente, el sistema es correcto de todas formas: cuando el planificador dispare, B encontrará un estado distinto de los esperados y descartará el evento. Pero eliminar la planificación en cuanto la transacción se resuelve es una buena práctica, porque reduce ruido, eventos inútiles y costo.
Qué pasa cuando algo falla en el camino
La prueba real de un diseño así no es el flujo feliz, sino lo que ocurre cuando algo se rompe entre dos operaciones que no son atómicas. Recorrer los fallos relevantes es la mejor manera de comprobar que las reglas anteriores se sostienen.
| Fallo | Estado en que queda | Qué ocurre en la reentrega |
|---|---|---|
A cae antes de pasar a PLANIFICANDO | EN_CURSO | El mensaje se reentrega y el proceso se repite completo, sin efectos duplicados |
A cae tras PLANIFICANDO, antes de crear la planificación | PLANIFICANDO | Se reutiliza el proximo_disparo guardado y se crea la planificación: un solo reintento |
A cae tras crear la planificación, antes de marcar PLANIFICADO | PLANIFICANDO | La creación responde «ya existe» y se trata como éxito |
El evento llega mientras A sigue en PLANIFICANDO | PLANIFICANDO | B acepta ese estado y avanza a ENVIANDO; el fallo condicional posterior de A se trata como éxito |
| El planificador no puede entregar el evento | PLANIFICADO | Reintentos de entrega y, al agotarse, DLQ del planificador, con el mensaje conservado |
| El evento se entrega dos veces | PLANIFICADO → ENVIANDO | B descarta el duplicado por transición condicional o retoma si la primera ejecución quedó a medias |
B cae tras ENVIANDO, antes de publicar | ENVIANDO | La reentrega retoma y publica |
B cae tras publicar, antes de pasar a EN_CURSO | ENVIANDO | Se republica con la misma clave de idempotencia y el servicio externo descarta el duplicado |
| Llega una respuesta de un intento anterior | Cualquiera | Se descarta por el número de intento; el estado queda intacto |
| Se agotan los intentos | FALLIDA | Alerta de negocio: es un fallo de negocio, no técnico |
El patrón se repite en todas las filas: el almacén de estado, con sus transiciones condicionales, actúa como árbitro. Cualquier operación que llegue cuando el estado no es el esperado simplemente no tiene efecto.
Hay un caso que esta tabla deja fuera a propósito, y es el de los mensajes que terminan en una DLQ. Un mensaje que cae allí significa que la transacción quedó detenida en un estado intermedio, y cada cola cuenta una historia diferente. La DLQ de respuesta indica que A falló repetidamente con una respuesta, y la transacción quedó en EN_CURSO o PLANIFICANDO. La DLQ del planificador indica que el planificador no pudo entregar el evento a la cola, y la transacción espera en PLANIFICADO. La DLQ de reintento indica que B falló repetidamente con un evento que sí llegó, y la transacción puede estar en PLANIFICANDO, PLANIFICADO o ENVIANDO. En los tres casos, el procedimiento es el mismo: diagnosticar la causa, corregirla y reenviar el mensaje a su cola de origen. Como los manejadores son idempotentes, reprocesar es seguro. Toda DLQ debería tener una alarma que salte con el primer mensaje, porque cualquiera de ellos es una incidencia.
Aun así, un diseño serio no debería depender únicamente de que alguien mire las DLQ. Por eso conviene sumar un reconciliador, un proceso periódico que busca transacciones detenidas en un estado intermedio durante más de un umbral razonable (por ejemplo, el doble de la latencia máxima esperada). Si encuentra una en PLANIFICANDO, reintenta la creación de la planificación con el proximo_disparo guardado. Si encuentra una en PLANIFICADO con el instante muy pasado, publica directamente el evento en la cola de reintento. Si la encuentra en ENVIANDO, republica el evento para que B retome. Como todas esas acciones pasan por los mismos manejadores idempotentes, el reconciliador no introduce riesgos nuevos. Para ejecutarlo de forma eficiente en DynamoDB hace falta un índice secundario por estado y actualizado_en.
Llevarlo a AWS
Con los conceptos claros, el mapeo a servicios de AWS es casi directo, porque cada componente lógico tiene un equivalente natural. Las colas de solicitud, respuesta y reintento son colas Amazon SQS de tipo Standard. El planificador diferido es Amazon EventBridge Scheduler, usando planificaciones de una sola ejecución (one-time schedules). El almacén de estado puede ser Amazon DynamoDB, con ConditionExpression para las transiciones, o una base relacional con UPDATE ... WHERE si ya forma parte del stack. Las DLQ son colas SQS adicionales, y la plataforma de ejecución es Amazon EKS, con pods que obtienen sus permisos mediante IRSA o EKS Pod Identity. Es una combinación razonable, pero no la única posible: lo esencial del patrón sobrevive a cualquier otra elección.
La elección del planificador responde a una limitación concreta. El retraso nativo de SQS tiene un máximo de 15 minutos, suficiente para reintentos rápidos pero insuficiente cuando el negocio pide esperas de horas. EventBridge Scheduler permite registrar un evento para cualquier instante futuro, sean horas o días, sin mantener ningún proceso activo durante la espera. Las planificaciones one-time se disparan una vez y, si se configura ActionAfterCompletion = DELETE, se eliminan solas.
Un detalle que suele confundir al principio: las DLQ de esta arquitectura se configuran de dos maneras distintas. La del planificador se define en el destino de cada planificación, mediante DeadLetterConfig. Las de SQS (respuesta y reintento) se definen en la cola de origen mediante una redrive policy con un maxReceiveCount, y conviene que el visibility timeout de esas colas sea mayor que el tiempo máximo de procesamiento del manejador, para que un mensaje en proceso no reaparezca en otro consumidor.
Cómo configurar cada planificación
Cada reintento se registra como una planificación con una expresión at(yyyy-mm-ddThh:mm:ss) que fija el instante exacto. Hay varios parámetros que es fácil dejar implícitos y que después producen comportamientos inesperados.
El ScheduleExpressionTimezone debe ser explícito. Sin él, la expresión at() se interpreta en UTC, y si alguien del equipo no lo tiene presente puede esperar disparos en otro horario. Lo más sencillo es calcular siempre en UTC y dejarlo escrito. El FlexibleTimeWindow debe estar en OFF: esa propiedad permite al planificador añadir una ventana de flexibilidad para optimizar recursos, pero con ella activa el instante real de disparo deja de ser predecible, y no tiene sentido ceder ese determinismo cuando el proximo_disparo ya incorpora el jitter y está guardado. El ActionAfterCompletion debe ser DELETE, para que las planificaciones ejecutadas desaparezcan en lugar de acumularse y ocupar cuota sin propósito. Conviene, también, usar un grupo de planificaciones dedicado a los reintentos, que permite aislar permisos, etiquetas y cuotas del resto de la cuenta. Y, por último, la RetryPolicy y la DeadLetterConfig del destino garantizan que, si el planificador no logra entregar el evento a SQS, lo reintente y, al agotarse los intentos, lo envíe a la DLQ del planificador para su análisis.
Este es un ejemplo concreto, el de la planificación del segundo intento de la transacción TX-100200:
{
  "Name": "retry-TX-100200-2",
  "GroupName": "reintentos-ms-procesamiento",
  "ScheduleExpression": "at(2026-10-03T16:38:00)",
  "ScheduleExpressionTimezone": "UTC",
  "FlexibleTimeWindow": { "Mode": "OFF" },
  "ActionAfterCompletion": "DELETE",
  "Target": {
    "Arn": "arn:aws:sqs:<region>:<cuenta>:cola-reintento",
    "RoleArn": "arn:aws:iam::<cuenta>:role/scheduler-reintentos",
    "Input": "{\"transaccion_id\":\"TX-100200\",\"origen\":\"PLANIFICADOR_REINTENTO\",\"intento\":2}",
    "RetryPolicy": {
      "MaximumRetryAttempts": 5,
      "MaximumEventAgeInSeconds": 3600
    },
    "DeadLetterConfig": {
      "Arn": "arn:aws:sqs:<region>:<cuenta>:dlq-planificador"
    }
  }
}
Como JSON no admite comentarios, vale la pena leer el ejemplo campo por campo: Name es un nombre determinista (prefijo fijo, identificador de la transacción y número de intento); ScheduleExpression contiene el proximo_disparo en UTC; Target.Arn apunta a la cola de reintento; RoleArn es el rol que el planificador asume para escribir en esa cola; Input es la carga que B recibirá, con el número de intento incluido; y RetryPolicy y DeadLetterConfig gobiernan lo que ocurre si la entrega falla.
Idempotencia al crear la planificación
El nombre retry-TX-100200-2 es determinista a propósito. Si A intenta crear una planificación que ya existe, el planificador responde con un ConflictException, y A debe tratarlo explícitamente como un éxito y no como un error.
Pero hay un matiz importante. Con ActionAfterCompletion = DELETE, la planificación desaparece después de dispararse, y el nombre queda libre de nuevo. Eso significa que la unicidad del nombre no es la barrera definitiva contra los duplicados. Esa barrera sigue siendo el almacén de estado con sus transiciones condicionales: el planificador resuelve el cuándo, pero la corrección la garantiza el almacén. Un último detalle práctico: los nombres de planificación tienen restricciones de longitud y de caracteres, así que si el identificador de la transacción es largo o contiene símbolos especiales conviene codificarlo, y un hash corto funciona bien.
Permisos con el menor privilegio posible
Los pods del microservicio necesitan scheduler:CreateSchedule para crear planificaciones, scheduler:DeleteSchedule si se implementa la cancelación proactiva, e iam:PassRole restringido al rol del planificador, todo acotado al grupo de planificaciones dedicado. El rol del planificador, por su parte, solo necesita sqs:SendMessage sobre la cola de reintento y la DLQ del planificador. Si las colas están cifradas con una clave KMS gestionada por el cliente, ese rol requiere además kms:GenerateDataKey y kms:Decrypt sobre la clave. Y la política de la cola de reintento debería aceptar mensajes únicamente del rol del planificador: esa restricción cierra la posibilidad de que cualquier otro componente inyecte reintentos de forma no autorizada.
Las cuotas que conviene mirar antes de producción
Crear planificaciones es una llamada a una API con límites de tasa, y existe además un máximo de planificaciones activas simultáneamente por cuenta y región. Esos valores cambian con el tiempo, así que la fuente definitiva es Service Quotas en la consola de AWS y no la documentación de terceros.
El volumen que importa estimar no es solo la ráfaga máxima de CANCELADO por segundo, sino también cuántas planificaciones pueden estar activas al mismo tiempo. Con espera creciente, cada planificación vive más, hasta varias horas, y con muchas transacciones en espera el número puede crecer más de lo esperado. Para absorber ráfagas sin perder mensajes hay tres medidas. La primera es limitar la concurrencia del consumidor de la cola de respuesta: SQS aplica contrapresión de forma natural, y si la creación falla por throttling, el mensaje reaparece tras el visibility timeout y se reintenta. La segunda es usar reintentos con backoff y jitter en la propia llamada de creación, para no amplificar el throttling. Y la tercera es solicitar un aumento de cuota con antelación si el análisis de capacidad lo indica.
Si no hay un planificador gestionado
Todo lo anterior es independiente de la tecnología, porque el planificador diferido es un componente lógico y no necesariamente un servicio gestionado. Si el entorno no ofrece uno, la alternativa más directa es una tabla de reintentos pendientes en la base de datos, junto con un proceso periódico (poller) que busque las transacciones cuyo proximo_disparo ya pasó y las envíe a la cola de reintento.
Es más portable y no introduce dependencias externas, pero tiene un costo real: un componente más que operar, una latencia que depende de la frecuencia del sondeo en lugar de ser casi inmediata, y una presión de lectura adicional sobre el almacén proporcional al número de transacciones pendientes. La máquina de estados, la idempotencia y la política de espera creciente no cambian en absoluto; solo cambia quién dispara el evento cuando llega el momento.
La corrección del patrón no depende de tener un planificador diferido gestionado. Depende del diseño: la máquina de estados, las transiciones condicionales y los manejadores idempotentes funcionan igual con cualquier mecanismo de disparo.
Lo que hay que medir para confiar en el sistema
Un flujo con esta complejidad necesita observabilidad proporcional. Sin métricas concretas es imposible saber si el sistema funciona como se diseñó o si acumula problemas que solo aflorarán bajo carga.
En cada cola SQS hay dos métricas esenciales: ApproximateNumberOfMessagesVisible, que indica cuántos mensajes esperan procesamiento, y ApproximateAgeOfOldestMessage, que indica cuánto lleva esperando el más antiguo y suele ser la primera señal de un consumidor atascado o caído. Las DLQ merecen vigilancia aparte, porque significan cosas distintas, como vimos antes, y su alarma debería saltar ante el primer mensaje. EventBridge Scheduler publica en CloudWatch métricas de invocaciones al destino, errores de entrega, entregas enviadas a la DLQ y throttling; un pico de errores de entrega suele delatar un problema de permisos o de disponibilidad de SQS que de otro modo pasaría desapercibido. Los nombres exactos de esas métricas conviene verificarlos en la documentación vigente de AWS antes de definir alarmas.
Las métricas más valiosas para entender el comportamiento de negocio son las del propio microservicio: el porcentaje de respuestas CANCELADO sobre el total, el número de planificaciones creadas y de conflictos recibidos (que mide, indirectamente, la frecuencia de las reentregas), las transacciones que terminan en FALLIDA por intentos agotados, y la distribución de transacciones por estado e intento. Esta última permite detectar, por ejemplo, un acúmulo de transacciones en PLANIFICANDO que no avanzan a PLANIFICADO, señal clara de un problema al crear planificaciones.
Pero lo que más se agradece en un incidente real no es una métrica sino un registro de auditoría: la posibilidad de reconstruir el historial completo de una transacción, con qué intentos ocurrieron, con qué identificador de planificación, cuándo se creó, cuándo se esperaba el disparo y cuál fue el resultado. El almacén de estado solo guarda el estado actual, así que este historial exige una tabla de eventos de solo-añadir, donde cada transición deje una fila. Sin ella, cuando algo sale mal en producción la respuesta es especulación; con ella, el diagnóstico es una consulta.
Lo que el patrón garantiza, y lo que no
Conviene nombrar con claridad las garantías. Una transacción no produce reintentos duplicados. El ciclo es finito, porque cada transacción termina en un estado terminal, sea EXITOSA o FALLIDA. Y el sistema se comporta correctamente ante reentregas y fallos en cualquier punto del flujo, siempre que se cumpla la precondición de idempotencia del servicio externo, o se adopte outbox.
Lo que no garantiza es precisión de reloj. El instante programado es el momento en que el evento queda disponible en la cola, no el momento en que se ejecuta, y entre ambos intervienen la cola, la disponibilidad del consumidor y su concurrencia. La desviación es de segundos en condiciones normales. Es algo distinto del jitter, que es intencional y puede ser de minutos; ambas cosas coexisten y hay que distinguirlas al documentar el comportamiento esperado.
Antes de llevar el patrón a producción, estas garantías deberían convertirse en pruebas formales y no en afirmaciones de diseño. Una ráfaga de N cancelaciones simultáneas no debe perder ni duplicar ningún reintento. La reentrega forzada de cada mensaje, en cada paso del flujo, no debe alterar el resultado final, lo que incluye el caso del evento que llega con la transacción aún en PLANIFICANDO y el de B caído en ENVIANDO. Ninguna transacción debe superar max_intentos. Una respuesta tardía de un intento anterior no debe modificar el estado. Las alertas de DLQ y de intentos agotados deben dispararse, el reconciliador debe reanudar transacciones detenidas en cada estado intermedio, y el servicio externo no debe recibir más de X solicitudes por segundo durante una ráfaga de reintentos. No son criterios opcionales de calidad: son la forma de demostrar que el diseño funciona en condiciones reales y no solo en el camino feliz.
La espera como decisión de diseño
Volvamos al punto de partida. El negocio pide reintentar más tarde, y alguien tiene que decidir cómo se modela ese «más tarde» dentro del sistema.
Como resumen, estos son los puntos que sostienen todo lo anterior. La espera debe ser un estado persistente y no un proceso dormido, porque lo primero no cuesta nada mientras transcurre y lo segundo se paga hora a hora. Cada pieza resuelve una sola responsabilidad (cuándo, si todavía tiene sentido, y una sola vez) y por eso el conjunto se recupera sin coordinación central. La corrección vive en las transiciones condicionales del almacén y no en el orden de los pasos, de modo que cualquier mensaje duplicado, tardío u obsoleto simplemente no tiene efecto. Guardar el instante del reintento antes de crear la planificación, aceptar PLANIFICANDO en B y retomar desde ENVIANDO son las tres decisiones que cierran los huecos que las primeras versiones del diseño dejaban abiertos. Y la espera creciente con jitter calculado en la aplicación protege al servicio externo y mantiene el comportamiento determinista.
La diferencia entre un Thread.sleep y este patrón no es de complejidad superficial, sino de qué tan bien el sistema entiende su propia situación. Un proceso que duerme no sabe que está esperando un reintento, no puede decirlo, no puede auditarse y no puede recuperarse de un fallo sin ayuda externa. Un almacén de estado con transiciones condicionales sí sabe en qué punto está, puede registrarlo, puede responder preguntas sobre su historial y puede retomar exactamente donde lo dejó si algo falla. Eso es lo que hace escalable la solución, y no el hecho de que use servicios concretos: el planificador es intercambiable, mañana puede ser una tabla con un poller o un servicio de otro proveedor, y lo que permanece es la máquina de estados, la idempotencia y la política de espera.
Quedan, además, varias líneas abiertas que merecen exploración. La más inmediata es modelar formalmente el cortacircuitos dentro de la máquina de estados, distinguiendo con claridad las indisponibilidades técnicas de los rechazos de negocio, para que las primeras no consuman el presupuesto de intentos. Otra es refinar la política de espera según el motivo del rechazo, o incluso volverla adaptativa, ajustando la base y el factor a partir de la tasa de éxito observada en reintentos anteriores. También vale la pena estudiar la adopción de outbox de forma sistemática en los casos donde el servicio externo no ofrezca garantías de idempotencia, y evaluar su costo frente al de aceptar un duplicado ocasional. Y, en el plano de la validación, tiene mucho potencial la inyección controlada de fallos (chaos engineering) aplicada a cada uno de los puntos intermedios descritos, para comprobar de forma continua, y no solo antes del lanzamiento, que las garantías se mantienen a medida que el sistema evoluciona.
Darle tiempo al servicio externo para recuperarse no es una concesión ante un fallo. Es reconocer que en sistemas distribuidos los fallos suelen ser temporales, que una segunda oportunidad bien diseñada tiene un valor real, y que esperar bien, sin desperdiciar recursos, sin duplicar y sin perder el hilo, es una forma de resiliencia tan importante como actuar rápido cuando todo va bien.