- Agile 2
- Alta disponibilidad 1
- Alternativas cloud 1
- Aop 1
- Arquitectura 3
- Arquitectura distribuida 4
- Automatizacion 3
- Aws 1
- Azure devops 1
- Base de datos 1
- Buenas practicas 22
- Cloud 1
- Colas 7
- Competing consumers 1
- Convenciones 11
- Copilot 1
- Diseno 8
- Docker 2
- Docker compose 1
- Documentacion 1
- Eda 11
- Equipos 1
- Escalabilidad 1
- Flujo de negocio 1
- Flujo de trabajo 3
- Flyway 1
- Git 4
- Gradle 3
- Herramientas digitales 1
- Ia 1
- Iam 1
- Infraestructura 2
- Java 16
- Jerarquia tecnica 1
- Jpa 1
- Jsonb 1
- Kafka 7
- Kubernetes 1
- Liderazgo en software 1
- Lineamientos 1
- Log 1
- Logging 3
- Microservicios 5
- Mongodb 1
- Monitoreo 1
- Nosql 3
- Observabilidad 4
- Open source 1
- Plugins 3
- Postgresql 2
- Privacidad 1
- Programacion funcional 1
- Programacion reactiva 4
- Rabbitmq 6
- Rotacion de talento 1
- Saga 2
- Scrum 2
- Security 1
- Seguridad 1
- Self hosting 1
- Sistemas legados 1
- Snippets 1
- Spring boot 5
- Spring mvc 2
- Sql 4
- Streams 1
- Threadlocal 1
- Trazabilidad 2
- Versionado 2
- Web 1
- Webflux 2
- Websockets 1
- Zero trust 1
Arquitectura distribuida
4 artículos
El Reintento que Sabe Esperar: Patrones de Resiliencia para Arquitecturas de Microservicios
- Mauricio ECR
- Arquitectura
- 03 Oct, 2026
Has estado ahí. Tu microservicio recibe la respuesta de un servicio externo y no es un error técnico: no hay stack trace, no hay excepción que capturar, no hay un HTTP 500. Es algo más sutil, un est
El Reintento que Sabe Esperar: Patrones de Resiliencia para Arquitecturas de Microservicios
- Mauricio ECR
- Arquitectura
- 03 Oct, 2026
Has estado ahí. Tu microservicio recibe la respuesta de un servicio externo y no es un error técnico: no hay stack trace, no hay excepción que capturar, no hay un HTTP 500. Es algo más sutil, un estado de negocio que dice ahora no. CANCELADO. NO DISPONIBLE. El servicio está vivo, responde, simplemente no puede atender tu solicitud en este momento.
Poco después llega la instrucción del negocio: inténtalo más tarde. Y ahí empieza el problema real.
«Más tarde» suena razonable hasta que se traduce a un sistema distribuido. ¿Cuánto es más tarde? ¿Quién guarda esa intención mientras transcurre? ¿Qué ocurre si el proceso que debía esperar se reinicia a mitad de camino, o si el mismo mensaje se entrega dos veces y el reintento se duplica? ¿Y si llegan mil respuestas CANCELADO en el mismo minuto y todas deben esperar a la vez sin que nadie gaste recursos esperando?
Lo que parecía un detalle de implementación es un problema de diseño con nombre, con componentes y con varias formas de salir mal si se improvisa. Este artículo recorre ese diseño completo: por qué la espera debe ser un dato y no un proceso, qué piezas la sostienen, cómo se evita que un fallo en cualquier punto produzca duplicados o transacciones atascadas, y cómo se concreta todo en AWS, sin olvidar que el patrón es más importante que cualquier servicio.
Por qué no basta con dormir el proceso
El primer instinto suele ser retener el proceso. Un Thread.sleep, un hilo bloqueado, o un mensaje que no se confirma para que el broker lo reentregue pasado un rato. Es tentador porque funciona en local, con poco volumen y en las demostraciones donde los casos borde son teóricos.
El costo, sin embargo, crece en silencio: un proceso que espera sigue siendo un proceso. Con diez esperas simultáneas el impacto es marginal. Con mil, cifra que cualquier sistema bajo carga real alcanza sin esfuerzo, la infraestructura paga por tiempo en el que no trabaja. Escalar horizontalmente no ayuda, porque solo multiplica los procesos igualmente bloqueados.
La raíz del problema es conceptual. Se está modelando la espera como una actividad, cuando en realidad es un estado. Un proceso dormido consume memoria, hilos y conexiones, mientras que un registro en una base de datos no consume nada mientras espera: existe, y el sistema lo consulta cuando necesita saber qué hacer.
De esa distinción nace el patrón de reintento diferido duradero. Consiste en convertir la intención de «volver a intentarlo en el instante T» en información persistente, en lugar de mantenerla como tiempo de ejecución.
Tres preguntas, tres responsabilidades
Para que la espera viva en el sistema sin ocupar procesos hay que responder tres preguntas distintas, y conviene que cada una tenga un dueño distinto. La primera es cuándo debe ocurrir el reintento: alguien tiene que conservar la intención «actúa en este instante» y cumplirla aunque pasen horas. La segunda es si el reintento todavía tiene sentido cuando el momento llegue, porque la transacción pudo resolverse por otra vía mientras esperaba. La tercera es cómo garantizar que el reintento se ejecute una sola vez, aunque el sistema falle en el medio.
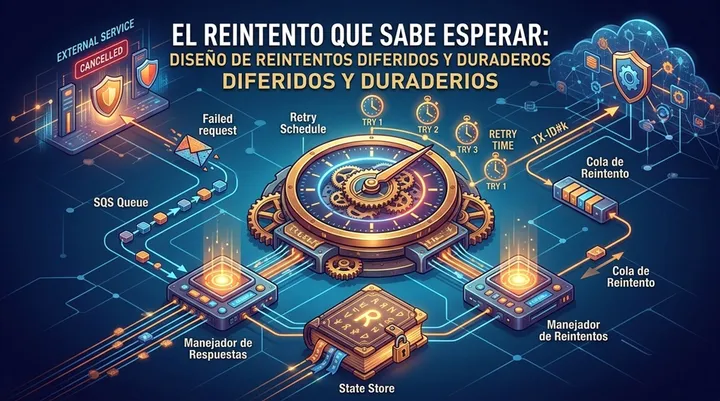
El diseño reparte esas responsabilidades entre unas pocas piezas. Tres colas desacoplan a los participantes: una recibe las respuestas del servicio externo, otra entrega los eventos de reintento cuando el planificador los dispara, y una tercera lleva las solicitudes hacia el servicio externo. Un almacén de estado funciona como fuente de verdad: guarda el estado de cada transacción, el intento en curso y el instante previsto del próximo disparo, y solo acepta cambios condicionales. Un planificador diferido conserva la intención de «entregar este evento en el instante T» sin mantener ningún proceso ocupado. Dos manejadores ejecutan la lógica de negocio: el manejador de respuestas (lo llamaré A) interpreta lo que dice el servicio externo y decide si hay que planificar un reintento, y el manejador de reintentos (B) recibe el evento del planificador, comprueba que siga siendo válido y publica la nueva solicitud. Por último, las colas de mensajes fallidos (DLQ, por dead-letter queue) aíslan lo que no se pudo procesar o entregar y levantan alertas.
Lo que hace correcto al conjunto no es la sofisticación de cada pieza, sino que cada una resuelve exactamente una cosa y desconoce las demás. El planificador no sabe nada de negocio, el almacén no sabe cuándo disparar y los manejadores no se conocen entre sí. Esa ignorancia mutua permite que el sistema se recupere de un fallo sin que ninguna pieza tenga que coordinarse con otra.
Hay además una decisión que protege el modelo existente: el planificador nunca habla directamente con el servicio externo. Publica en la cola de reintento y es B quien decide qué hacer con ese evento. Así no se abren nuevos endpoints ni se introducen caminos de ejecución paralelos. El planificador responde al cuándo y la lógica de negocio sigue viviendo donde siempre vivió.
El siguiente diagrama sigue el recorrido de un mensaje desde que el servicio externo responde CANCELADO hasta que se publica una nueva solicitud, o se descarta si ya no hace falta. Las líneas punteadas marcan rutas de fallo.
flowchart TD
    EXT["Servicio externo"] --> QR[["Cola de respuesta"]]
    QR --> A["Manejador de respuestas (A)"]
    QR -.->|mensajes fallidos| DLQ0[["DLQ de respuesta"]]
    A <--> DB[("Almacén de estado")]

    A -->|EXITOSO| OK["Flujo habitual"]
    A -->|CANCELADO, intentos agotados| FAIL["Marcar FALLIDA<br/>+ alerta"]
    A -->|"CANCELADO, intentos disponibles<br/>(1. PLANIFICANDO + proximo_disparo<br/>2. crear planificación)"| PL["Planificador diferido<br/>(espera creciente)"]

    PL --> QRE[["Cola de reintento"]]
    PL -.->|falla de entrega| DLQ1[["DLQ del planificador"]]
    QRE -.->|mensajes fallidos| DLQ2[["DLQ de reintento"]]

    QRE --> B["Manejador de reintentos (B)"]
    B <--> DB
    B -->|obsoleto o ya procesado| DROP["Descartar"]
    B -->|sigue pendiente| QS[["Cola de solicitud"]]
    QS --> EXT
Una convención pequeña que evita errores grandes
Antes de hablar de estados hay que fijar un detalle de numeración que parece trivial y, sin embargo, es responsable de errores muy difíciles de rastrear. El intento = 1 es la solicitud original, la primera vez que el microservicio contacta al servicio externo. El primer reintento es el intento = 2, el segundo es el intento = 3, y así sucesivamente. El campo max_intentos cuenta la solicitud original, no solo los reintentos: con max_intentos = 4 hay una solicitud original y hasta tres reintentos.
Si esto no queda escrito, el error de off-by-one aparece tarde y en producción. Una transacción hace un reintento de más porque alguien contó desde cero, o se detiene antes de tiempo porque otro incluyó el original en el conteo de reintentos. Son bugs silenciosos: el sistema funciona, pero no se comporta como el negocio espera.
El almacén de estado y las reglas del juego
Con la numeración clara, el siguiente paso es definir qué guarda el almacén para cada transacción. Son pocos campos, pero cada uno tiene una razón de ser.
| Campo | Qué significa | Cuándo cambia |
|---|---|---|
transaccion_id |
Clave primaria | Nunca |
estado |
EN_CURSO, PLANIFICANDO, PLANIFICADO, ENVIANDO, EXITOSA o FALLIDA |
En cada transición condicional |
intento_actual |
Último intento (n) cuya solicitud salió hacia el servicio externo |
Al pasar de ENVIANDO a EN_CURSO, donde se convierte en n+1 |
intento_siguiente |
Intento (n+1) que se está planificando o enviando; vacío en otro caso |
Se fija al pasar de EN_CURSO a PLANIFICANDO y se limpia al volver a EN_CURSO |
max_intentos |
Tope de intentos, contando el original | Constante |
proximo_disparo |
Instante UTC del reintento, con la variación aleatoria ya incorporada | Se escribe junto con la transición a PLANIFICANDO |
actualizado_en |
Auditoría y detección de transacciones detenidas | En cada escritura |
La razón de modelar así es que la corrección de un flujo distribuido no está en el orden de los pasos. La trampa más común al diseñar reintentos es suponer que, si cada paso se ejecuta en el orden correcto, el resultado será correcto. Pero los mensajes se reentregan, se duplican, llegan tarde, o el proceso se cae a mitad de una operación y reaparece con el mismo mensaje en la cola. En esas condiciones, la única forma de mantener la consistencia es trabajar con estados explícitos y permitir cada transición solo si el estado actual es exactamente el esperado. Si no coincide, el mensaje es obsoleto o duplicado, y se descarta sin ejecutar nada. En DynamoDB esto se logra con una ConditionExpression, y en una base relacional con un UPDATE ... WHERE estado = :esperado AND intento_actual = :n.
La vida de una transacción discurre así. Nace en EN_CURSO cuando se envía la solicitud original. Si la respuesta es exitosa, termina en EXITOSA. Si llega un CANCELADO y los intentos están agotados, termina en FALLIDA. Pero si todavía quedan intentos, pasa primero a PLANIFICANDO, un estado intermedio que significa «se decidió reintentar, aunque la planificación puede no existir aún», y luego a PLANIFICADO cuando la planificación queda confirmada. Cuando llega el evento, la transacción pasa a ENVIANDO mientras se publica la nueva solicitud y vuelve a EN_CURSO, ya con el intento incrementado, cuando la solicitud sale. Si mientras espera la transacción se resuelve por otra vía (un proceso manual, una corrección externa), puede pasar directamente a EXITOSA.
stateDiagram-v2
    [*] --> EN_CURSO: solicitud enviada (intento n)
    EN_CURSO --> EXITOSA: respuesta EXITOSO
    EN_CURSO --> FALLIDA: CANCELADO y n = max_intentos
    EN_CURSO --> PLANIFICANDO: CANCELADO y n < max_intentos<br/>(guarda intento_siguiente y proximo_disparo)
    PLANIFICANDO --> PLANIFICADO: planificación confirmada
    PLANIFICANDO --> ENVIANDO: evento llega antes de confirmar
    PLANIFICADO --> ENVIANDO: llega el evento (intento n+1)
    ENVIANDO --> ENVIANDO: reentrega retoma la publicación
    ENVIANDO --> EN_CURSO: solicitud publicada (intento_actual = n+1)
    PLANIFICANDO --> EXITOSA: resuelta por otra vía
    PLANIFICADO --> EXITOSA: resuelta por otra vía
    EXITOSA --> [*]
    FALLIDA --> [*]
Cada flecha del diagrama es, en realidad, una condición: «pasa a este estado solo si el estado actual es aquel y el número de intento es este». Si cualquiera de las dos cosas falla, la operación no se ejecuta, y esa regla aplicada sin excepciones es lo que hace correcto al sistema aunque los mensajes lleguen duplicados o desordenados.
Conviene decir que la regla de «resuelta por otra vía» es una decisión, no una verdad universal. Aquí se permite desde PLANIFICANDO y PLANIFICADO, pero no desde ENVIANDO: en ese punto la solicitud ya está en vuelo y será la respuesta del servicio externo la que decida el destino. Otros equipos podrían optar por permitirla también desde ENVIANDO e intentar cancelar la solicitud. Lo importante es elegir y dejarlo documentado.
Tres escrituras que no son atómicas
Cuando A recibe un CANCELADO y decide planificar un reintento, tiene que hacer tres cosas: actualizar el almacén de estado, crear la planificación y confirmar el mensaje de la cola. Ninguna de las tres está conectada a las otras por una transacción. Si el proceso cae entre dos de ellas, el mensaje se reentregará y A deberá poder retomar desde donde quedó, sin duplicar ni perder nada.
La primera versión intuitiva de este flujo calculaba la fecha del reintento en el momento de crear la planificación. Funciona hasta que el proceso cae justo después de crearla y antes de anotar nada: la reentrega vuelve a calcular, y como la espera incluye una variación aleatoria, obtiene un instante distinto y crea una segunda planificación para el mismo intento. El negocio terminaba viendo reintentos duplicados sin que ningún componente hubiera «fallado» en sentido estricto.
La solución es cuestión de orden. Cuando A detecta un CANCELADO con intentos disponibles, lo primero que hace es una transición condicional de EN_CURSO(n) a PLANIFICANDO, y en esa misma escritura guarda intento_siguiente = n+1 y el proximo_disparo, el instante exacto del reintento. Solo después crea la planificación, usando ese instante ya persistido. Si el proceso cae entre ambos pasos, la reentrega encuentra la transacción en PLANIFICANDO, lee el proximo_disparo guardado e intenta crear la planificación de nuevo. Si ya existía, el planificador responde con un error de conflicto que A trata como éxito, porque la planificación está creada con el instante correcto. El resultado es el mismo: un único reintento programado.
El flujo completo de A queda así. Primero descarta las respuestas tardías: si el número de intento de la respuesta no coincide con intento_actual, pertenece a un intento viejo y se confirma sin más. Si es EXITOSO y la transacción está EN_CURSO, pasa a EXITOSA. Si es CANCELADO y n = max_intentos, pasa a FALLIDA y se emite una alerta de negocio. Y si es CANCELADO con intentos disponibles, ejecuta la secuencia descrita: guardar el instante, crear la planificación, marcar PLANIFICADO y confirmar el mensaje. Si en cualquier reentrega la transacción ya está más adelante, en PLANIFICADO o ENVIANDO, significa que otra ejecución ya hizo el trabajo: A confirma el mensaje y termina. Del mismo modo, si la transición final a PLANIFICADO falla porque el estado ya avanzó, es un éxito, no un error.
sequenceDiagram
    participant Q as Cola de respuesta
    participant A as Manejador A
    participant DB as Almacén de estado
    participant PL as Planificador
    Q->>A: CANCELADO (intento n)
    A->>DB: EN_CURSO(n) → PLANIFICANDO + proximo_disparo
    Note over A,DB: Punto de fallo 1
    A->>PL: Crear planificación (nombre determinista)
    Note over A,PL: Punto de fallo 2
    PL-->>A: OK o conflicto (= éxito)
    A->>DB: PLANIFICANDO → PLANIFICADO
    Note over A,DB: Punto de fallo 3
    A->>Q: confirmar mensaje
Cuando el evento llega: ejecutar una sola vez
Horas después, el planificador dispara el evento y este aterriza en la cola de reintento, donde B lo recoge. Tanto el planificador como la cola ofrecen entrega al menos una vez, lo cual significa que el mismo evento puede llegar dos veces. B tiene que producir el mismo resultado en ambos casos, y para ello usa las mismas transiciones condicionales que A.
Al recibir el evento, B lee la transacción. Si el intento del evento no coincide con intento_siguiente, el evento es obsoleto y se descarta. Si coincide, mira el estado: desde PLANIFICADO o PLANIFICANDO intenta la transición a ENVIANDO; si ya está en EN_CURSO, EXITOSA o FALLIDA, el mensaje es un duplicado de un procesamiento terminado y se descarta. Una vez en ENVIANDO, publica la nueva solicitud en la cola del servicio externo con una clave de idempotencia que combina el identificador de la transacción con el número de intento (por ejemplo, TX-100200#2). Por último, la transición de ENVIANDO a EN_CURSO fija intento_actual = n+1, limpia intento_siguiente y cierra el ciclo.
Aquí aparecieron dos dificultades.
La primera es una carrera. Si el evento llega mientras la transacción sigue en PLANIFICANDO, porque A fue lento, cayó o su reentrega se demoró, un B que exigiera PLANIFICADO descartaría el evento, y después A marcaría PLANIFICADO sin que nadie volviera a disparar el reintento. La transacción quedaría esperando un evento que ya pasó. La salida es que B acepte también PLANIFICANDO como estado de partida, y que A trate como éxito el fallo condicional que encontrará después.
La segunda es más sutil. Si B cae después de pasar a ENVIANDO y antes de publicar, la reentrega encuentra la transacción en ENVIANDO. Con una regla ingenua de «si el estado no es el esperado, descartar», ese mensaje se tiraría y la transacción quedaría atascada para siempre, sin solicitud y sin nadie que la reintente. Por eso, cuando B encuentra ENVIANDO con el intento correcto, no descarta: retoma. Vuelve a publicar con la misma clave de idempotencia y completa la transición a EN_CURSO.
Esa decisión tiene un precio que hay que aceptar con los ojos abiertos. Si dos entregas del mismo evento llegan en paralelo, ambas pueden publicar la solicitud. Es inocuo únicamente porque el servicio externo descarta el duplicado gracias a la clave de idempotencia. Esa es una precondición del patrón, no un detalle: si el servicio externo no respeta la clave, el diseño necesita el patrón outbox. En él, la solicitud a publicar se guarda en el almacén junto con la transición de estado, y un publicador independiente se encarga de enviarla de forma fiable. Es más costoso de construir, pero elimina del todo la ventana entre publicar y confirmar.
sequenceDiagram
    participant PL as Planificador
    participant Q as Cola de reintento
    participant B as Manejador B
    participant DB as Almacén de estado
    participant QS as Cola de solicitud
    PL->>Q: evento (intento n+1)
    Q->>B: entrega del evento
    B->>DB: PLANIFICADO o PLANIFICANDO → ENVIANDO
    Note over B,DB: Punto de fallo 1
    B->>QS: publicar (clave transaccion_id#n+1)
    Note over B,QS: Punto de fallo 2
    B->>DB: ENVIANDO → EN_CURSO (intento_actual = n+1)
    Note over B,DB: Punto de fallo 3
    B->>Q: confirmar mensaje
Una espera que crece para no presionar siempre igual
Hay una pregunta que todavía no hemos contestado: cuánto hay que esperar. Si la causa del CANCELADO persiste, porque el servicio externo tiene un problema que tarda en resolverse, reintentar con el mismo intervalo cada vez aplica la misma presión sin darle tiempo real de recuperarse. La espera debería crecer. La fórmula, configurable, es la siguiente:
espera(k) = min( base × factor^(k-1) , tope ) × (1 + u), u ∈ [-jitter, +jitter]
Aquí k es el número de reintento (tras fallar el intento n, se usa k = n), base es la espera antes del primer reintento, factor es cuánto crece en cada paso, tope es el máximo de la espera nominal y jitter es la variación aleatoria relativa. Con valores típicos (base = 2 h, factor = 2, tope = 24 h, jitter = ±10 %), una transacción con max_intentos = 4 queda así:
| Reintento | Intento | Espera nominal | Rango con ±10 % |
|---|---|---|---|
| 1 | 2 | 2 h | 1 h 48 min – 2 h 12 min |
| 2 | 3 | 4 h | 3 h 36 min – 4 h 24 min |
| 3 | 4 | 8 h | 7 h 12 min – 8 h 48 min |
Un matiz que suele pasarse por alto: en la fórmula, la variación se aplica después del tope, de modo que la espera real puede llegar a tope × 1,1, es decir, 26,4 horas con estos valores. Si el negocio necesita un máximo estricto, hay que recortar de nuevo tras aplicar la variación. Cualquiera de las dos opciones es válida, siempre que esté documentada.
El jitter merece su propio párrafo porque no es un adorno. Imagina que llegan mil respuestas CANCELADO en el mismo minuto, por una caída momentánea del servicio externo. Si todas calculan exactamente la misma espera, sus reintentos se disparan al mismo instante horas después y golpean al servicio en ráfaga, justo cuando intentaba recuperarse. La variación aleatoria dispersa esa ráfaga a lo largo de un intervalo, y reparte la carga de forma natural.
Hay, además, una decisión con impacto directo en la corrección: el jitter se calcula en la aplicación, no se delega al planificador. Así el proximo_disparo, con su variación ya incorporada, queda registrado en el almacén. Si el proceso falla y el mensaje se reentrega, la planificación se recrea con exactamente el mismo instante, y el comportamiento es determinista aunque el proceso se haya reiniciado.
Esta política tampoco tiene por qué ser uniforme. No todo CANCELADO representa la misma situación de negocio: algunos justifican esperas cortas y otros largas, y el criterio puede depender del tipo de transacción, del cliente o del motivo concreto del rechazo.
Proteger al servicio que se quiere recuperar
El jitter ayuda, pero no es suficiente si el volumen es muy alto o si el servicio externo está en un estado delicado. B debería incorporar tres controles adicionales.
El primero es limitar su propia concurrencia al publicar en la cola de solicitud. Si B puede procesar cien eventos por segundo pero el servicio externo solo absorbe diez, el límite debe vivir en B y no depender de que el servicio resista.
El segundo es un cortacircuitos (circuit breaker). Si el servicio está claramente degradado, porque responde lento, con errores o directamente no responde, tiene más sentido pausar o reprogramar los reintentos que seguir gastando el presupuesto de max_intentos. Un fallo por indisponibilidad técnica no equivale a un CANCELADO de negocio, y tratarlos igual acorta artificialmente la vida de una transacción que aún podría resolverse. Conviene advertir que la máquina de estados que hemos descrito no modela esta transición; hacerlo implicaría permitir, por ejemplo, volver de PLANIFICADO o ENVIANDO a PLANIFICANDO conservando intento_siguiente y fijando un nuevo proximo_disparo, con un nombre de planificación que incluya un sufijo de secuencia para evitar conflictos con el anterior.
El tercero es la cancelación proactiva de planificaciones. Si una transacción se resuelve por otra vía y todavía tiene una planificación pendiente, el sistema es correcto de todas formas: cuando el planificador dispare, B encontrará un estado distinto de los esperados y descartará el evento. Pero eliminar la planificación en cuanto la transacción se resuelve es una buena práctica, porque reduce ruido, eventos inútiles y costo.
Qué pasa cuando algo falla en el camino
La prueba real de un diseño así no es el flujo feliz, sino lo que ocurre cuando algo se rompe entre dos operaciones que no son atómicas. Recorrer los fallos relevantes es la mejor manera de comprobar que las reglas anteriores se sostienen.
| Fallo | Estado en que queda | Qué ocurre en la reentrega |
|---|---|---|
A cae antes de pasar a PLANIFICANDO |
EN_CURSO |
El mensaje se reentrega y el proceso se repite completo, sin efectos duplicados |
A cae tras PLANIFICANDO, antes de crear la planificación |
PLANIFICANDO |
Se reutiliza el proximo_disparo guardado y se crea la planificación: un solo reintento |
A cae tras crear la planificación, antes de marcar PLANIFICADO |
PLANIFICANDO |
La creación responde «ya existe» y se trata como éxito |
El evento llega mientras A sigue en PLANIFICANDO |
PLANIFICANDO |
B acepta ese estado y avanza a ENVIANDO; el fallo condicional posterior de A se trata como éxito |
| El planificador no puede entregar el evento | PLANIFICADO |
Reintentos de entrega y, al agotarse, DLQ del planificador, con el mensaje conservado |
| El evento se entrega dos veces | PLANIFICADO → ENVIANDO |
B descarta el duplicado por transición condicional o retoma si la primera ejecución quedó a medias |
B cae tras ENVIANDO, antes de publicar |
ENVIANDO |
La reentrega retoma y publica |
B cae tras publicar, antes de pasar a EN_CURSO |
ENVIANDO |
Se republica con la misma clave de idempotencia y el servicio externo descarta el duplicado |
| Llega una respuesta de un intento anterior | Cualquiera | Se descarta por el número de intento; el estado queda intacto |
| Se agotan los intentos | FALLIDA |
Alerta de negocio: es un fallo de negocio, no técnico |
El patrón se repite en todas las filas: el almacén de estado, con sus transiciones condicionales, actúa como árbitro. Cualquier operación que llegue cuando el estado no es el esperado simplemente no tiene efecto.
Hay un caso que esta tabla deja fuera a propósito, y es el de los mensajes que terminan en una DLQ. Un mensaje que cae allí significa que la transacción quedó detenida en un estado intermedio, y cada cola cuenta una historia diferente. La DLQ de respuesta indica que A falló repetidamente con una respuesta, y la transacción quedó en EN_CURSO o PLANIFICANDO. La DLQ del planificador indica que el planificador no pudo entregar el evento a la cola, y la transacción espera en PLANIFICADO. La DLQ de reintento indica que B falló repetidamente con un evento que sí llegó, y la transacción puede estar en PLANIFICANDO, PLANIFICADO o ENVIANDO. En los tres casos, el procedimiento es el mismo: diagnosticar la causa, corregirla y reenviar el mensaje a su cola de origen. Como los manejadores son idempotentes, reprocesar es seguro. Toda DLQ debería tener una alarma que salte con el primer mensaje, porque cualquiera de ellos es una incidencia.
Aun así, un diseño serio no debería depender únicamente de que alguien mire las DLQ. Por eso conviene sumar un reconciliador, un proceso periódico que busca transacciones detenidas en un estado intermedio durante más de un umbral razonable (por ejemplo, el doble de la latencia máxima esperada). Si encuentra una en PLANIFICANDO, reintenta la creación de la planificación con el proximo_disparo guardado. Si encuentra una en PLANIFICADO con el instante muy pasado, publica directamente el evento en la cola de reintento. Si la encuentra en ENVIANDO, republica el evento para que B retome. Como todas esas acciones pasan por los mismos manejadores idempotentes, el reconciliador no introduce riesgos nuevos. Para ejecutarlo de forma eficiente en DynamoDB hace falta un índice secundario por estado y actualizado_en.
Llevarlo a AWS
Con los conceptos claros, el mapeo a servicios de AWS es casi directo, porque cada componente lógico tiene un equivalente natural. Las colas de solicitud, respuesta y reintento son colas Amazon SQS de tipo Standard. El planificador diferido es Amazon EventBridge Scheduler, usando planificaciones de una sola ejecución (one-time schedules). El almacén de estado puede ser Amazon DynamoDB, con ConditionExpression para las transiciones, o una base relacional con UPDATE ... WHERE si ya forma parte del stack. Las DLQ son colas SQS adicionales, y la plataforma de ejecución es Amazon EKS, con pods que obtienen sus permisos mediante IRSA o EKS Pod Identity. Es una combinación razonable, pero no la única posible: lo esencial del patrón sobrevive a cualquier otra elección.
La elección del planificador responde a una limitación concreta. El retraso nativo de SQS tiene un máximo de 15 minutos, suficiente para reintentos rápidos pero insuficiente cuando el negocio pide esperas de horas. EventBridge Scheduler permite registrar un evento para cualquier instante futuro, sean horas o días, sin mantener ningún proceso activo durante la espera. Las planificaciones one-time se disparan una vez y, si se configura ActionAfterCompletion = DELETE, se eliminan solas.
Un detalle que suele confundir al principio: las DLQ de esta arquitectura se configuran de dos maneras distintas. La del planificador se define en el destino de cada planificación, mediante DeadLetterConfig. Las de SQS (respuesta y reintento) se definen en la cola de origen mediante una redrive policy con un maxReceiveCount, y conviene que el visibility timeout de esas colas sea mayor que el tiempo máximo de procesamiento del manejador, para que un mensaje en proceso no reaparezca en otro consumidor.
Cómo configurar cada planificación
Cada reintento se registra como una planificación con una expresión at(yyyy-mm-ddThh:mm:ss) que fija el instante exacto. Hay varios parámetros que es fácil dejar implícitos y que después producen comportamientos inesperados.
El ScheduleExpressionTimezone debe ser explícito. Sin él, la expresión at() se interpreta en UTC, y si alguien del equipo no lo tiene presente puede esperar disparos en otro horario. Lo más sencillo es calcular siempre en UTC y dejarlo escrito. El FlexibleTimeWindow debe estar en OFF: esa propiedad permite al planificador añadir una ventana de flexibilidad para optimizar recursos, pero con ella activa el instante real de disparo deja de ser predecible, y no tiene sentido ceder ese determinismo cuando el proximo_disparo ya incorpora el jitter y está guardado. El ActionAfterCompletion debe ser DELETE, para que las planificaciones ejecutadas desaparezcan en lugar de acumularse y ocupar cuota sin propósito. Conviene, también, usar un grupo de planificaciones dedicado a los reintentos, que permite aislar permisos, etiquetas y cuotas del resto de la cuenta. Y, por último, la RetryPolicy y la DeadLetterConfig del destino garantizan que, si el planificador no logra entregar el evento a SQS, lo reintente y, al agotarse los intentos, lo envíe a la DLQ del planificador para su análisis.
Este es un ejemplo concreto, el de la planificación del segundo intento de la transacción TX-100200:
{
  "Name": "retry-TX-100200-2",
  "GroupName": "reintentos-ms-procesamiento",
  "ScheduleExpression": "at(2026-10-03T16:38:00)",
  "ScheduleExpressionTimezone": "UTC",
  "FlexibleTimeWindow": { "Mode": "OFF" },
  "ActionAfterCompletion": "DELETE",
  "Target": {
    "Arn": "arn:aws:sqs:<region>:<cuenta>:cola-reintento",
    "RoleArn": "arn:aws:iam::<cuenta>:role/scheduler-reintentos",
    "Input": "{\"transaccion_id\":\"TX-100200\",\"origen\":\"PLANIFICADOR_REINTENTO\",\"intento\":2}",
    "RetryPolicy": {
      "MaximumRetryAttempts": 5,
      "MaximumEventAgeInSeconds": 3600
    },
    "DeadLetterConfig": {
      "Arn": "arn:aws:sqs:<region>:<cuenta>:dlq-planificador"
    }
  }
}
Como JSON no admite comentarios, vale la pena leer el ejemplo campo por campo: Name es un nombre determinista (prefijo fijo, identificador de la transacción y número de intento); ScheduleExpression contiene el proximo_disparo en UTC; Target.Arn apunta a la cola de reintento; RoleArn es el rol que el planificador asume para escribir en esa cola; Input es la carga que B recibirá, con el número de intento incluido; y RetryPolicy y DeadLetterConfig gobiernan lo que ocurre si la entrega falla.
Idempotencia al crear la planificación
El nombre retry-TX-100200-2 es determinista a propósito. Si A intenta crear una planificación que ya existe, el planificador responde con un ConflictException, y A debe tratarlo explícitamente como un éxito y no como un error.
Pero hay un matiz importante. Con ActionAfterCompletion = DELETE, la planificación desaparece después de dispararse, y el nombre queda libre de nuevo. Eso significa que la unicidad del nombre no es la barrera definitiva contra los duplicados. Esa barrera sigue siendo el almacén de estado con sus transiciones condicionales: el planificador resuelve el cuándo, pero la corrección la garantiza el almacén. Un último detalle práctico: los nombres de planificación tienen restricciones de longitud y de caracteres, así que si el identificador de la transacción es largo o contiene símbolos especiales conviene codificarlo, y un hash corto funciona bien.
Permisos con el menor privilegio posible
Los pods del microservicio necesitan scheduler:CreateSchedule para crear planificaciones, scheduler:DeleteSchedule si se implementa la cancelación proactiva, e iam:PassRole restringido al rol del planificador, todo acotado al grupo de planificaciones dedicado. El rol del planificador, por su parte, solo necesita sqs:SendMessage sobre la cola de reintento y la DLQ del planificador. Si las colas están cifradas con una clave KMS gestionada por el cliente, ese rol requiere además kms:GenerateDataKey y kms:Decrypt sobre la clave. Y la política de la cola de reintento debería aceptar mensajes únicamente del rol del planificador: esa restricción cierra la posibilidad de que cualquier otro componente inyecte reintentos de forma no autorizada.
Las cuotas que conviene mirar antes de producción
Crear planificaciones es una llamada a una API con límites de tasa, y existe además un máximo de planificaciones activas simultáneamente por cuenta y región. Esos valores cambian con el tiempo, así que la fuente definitiva es Service Quotas en la consola de AWS y no la documentación de terceros.
El volumen que importa estimar no es solo la ráfaga máxima de CANCELADO por segundo, sino también cuántas planificaciones pueden estar activas al mismo tiempo. Con espera creciente, cada planificación vive más, hasta varias horas, y con muchas transacciones en espera el número puede crecer más de lo esperado. Para absorber ráfagas sin perder mensajes hay tres medidas. La primera es limitar la concurrencia del consumidor de la cola de respuesta: SQS aplica contrapresión de forma natural, y si la creación falla por throttling, el mensaje reaparece tras el visibility timeout y se reintenta. La segunda es usar reintentos con backoff y jitter en la propia llamada de creación, para no amplificar el throttling. Y la tercera es solicitar un aumento de cuota con antelación si el análisis de capacidad lo indica.
Si no hay un planificador gestionado
Todo lo anterior es independiente de la tecnología, porque el planificador diferido es un componente lógico y no necesariamente un servicio gestionado. Si el entorno no ofrece uno, la alternativa más directa es una tabla de reintentos pendientes en la base de datos, junto con un proceso periódico (poller) que busque las transacciones cuyo proximo_disparo ya pasó y las envíe a la cola de reintento.
Es más portable y no introduce dependencias externas, pero tiene un costo real: un componente más que operar, una latencia que depende de la frecuencia del sondeo en lugar de ser casi inmediata, y una presión de lectura adicional sobre el almacén proporcional al número de transacciones pendientes. La máquina de estados, la idempotencia y la política de espera creciente no cambian en absoluto; solo cambia quién dispara el evento cuando llega el momento.
La corrección del patrón no depende de tener un planificador diferido gestionado. Depende del diseño: la máquina de estados, las transiciones condicionales y los manejadores idempotentes funcionan igual con cualquier mecanismo de disparo.
Lo que hay que medir para confiar en el sistema
Un flujo con esta complejidad necesita observabilidad proporcional. Sin métricas concretas es imposible saber si el sistema funciona como se diseñó o si acumula problemas que solo aflorarán bajo carga.
En cada cola SQS hay dos métricas esenciales: ApproximateNumberOfMessagesVisible, que indica cuántos mensajes esperan procesamiento, y ApproximateAgeOfOldestMessage, que indica cuánto lleva esperando el más antiguo y suele ser la primera señal de un consumidor atascado o caído. Las DLQ merecen vigilancia aparte, porque significan cosas distintas, como vimos antes, y su alarma debería saltar ante el primer mensaje. EventBridge Scheduler publica en CloudWatch métricas de invocaciones al destino, errores de entrega, entregas enviadas a la DLQ y throttling; un pico de errores de entrega suele delatar un problema de permisos o de disponibilidad de SQS que de otro modo pasaría desapercibido. Los nombres exactos de esas métricas conviene verificarlos en la documentación vigente de AWS antes de definir alarmas.
Las métricas más valiosas para entender el comportamiento de negocio son las del propio microservicio: el porcentaje de respuestas CANCELADO sobre el total, el número de planificaciones creadas y de conflictos recibidos (que mide, indirectamente, la frecuencia de las reentregas), las transacciones que terminan en FALLIDA por intentos agotados, y la distribución de transacciones por estado e intento. Esta última permite detectar, por ejemplo, un acúmulo de transacciones en PLANIFICANDO que no avanzan a PLANIFICADO, señal clara de un problema al crear planificaciones.
Pero lo que más se agradece en un incidente real no es una métrica sino un registro de auditoría: la posibilidad de reconstruir el historial completo de una transacción, con qué intentos ocurrieron, con qué identificador de planificación, cuándo se creó, cuándo se esperaba el disparo y cuál fue el resultado. El almacén de estado solo guarda el estado actual, así que este historial exige una tabla de eventos de solo-añadir, donde cada transición deje una fila. Sin ella, cuando algo sale mal en producción la respuesta es especulación; con ella, el diagnóstico es una consulta.
Lo que el patrón garantiza, y lo que no
Conviene nombrar con claridad las garantías. Una transacción no produce reintentos duplicados. El ciclo es finito, porque cada transacción termina en un estado terminal, sea EXITOSA o FALLIDA. Y el sistema se comporta correctamente ante reentregas y fallos en cualquier punto del flujo, siempre que se cumpla la precondición de idempotencia del servicio externo, o se adopte outbox.
Lo que no garantiza es precisión de reloj. El instante programado es el momento en que el evento queda disponible en la cola, no el momento en que se ejecuta, y entre ambos intervienen la cola, la disponibilidad del consumidor y su concurrencia. La desviación es de segundos en condiciones normales. Es algo distinto del jitter, que es intencional y puede ser de minutos; ambas cosas coexisten y hay que distinguirlas al documentar el comportamiento esperado.
Antes de llevar el patrón a producción, estas garantías deberían convertirse en pruebas formales y no en afirmaciones de diseño. Una ráfaga de N cancelaciones simultáneas no debe perder ni duplicar ningún reintento. La reentrega forzada de cada mensaje, en cada paso del flujo, no debe alterar el resultado final, lo que incluye el caso del evento que llega con la transacción aún en PLANIFICANDO y el de B caído en ENVIANDO. Ninguna transacción debe superar max_intentos. Una respuesta tardía de un intento anterior no debe modificar el estado. Las alertas de DLQ y de intentos agotados deben dispararse, el reconciliador debe reanudar transacciones detenidas en cada estado intermedio, y el servicio externo no debe recibir más de X solicitudes por segundo durante una ráfaga de reintentos. No son criterios opcionales de calidad: son la forma de demostrar que el diseño funciona en condiciones reales y no solo en el camino feliz.
La espera como decisión de diseño
Volvamos al punto de partida. El negocio pide reintentar más tarde, y alguien tiene que decidir cómo se modela ese «más tarde» dentro del sistema.
Como resumen, estos son los puntos que sostienen todo lo anterior. La espera debe ser un estado persistente y no un proceso dormido, porque lo primero no cuesta nada mientras transcurre y lo segundo se paga hora a hora. Cada pieza resuelve una sola responsabilidad (cuándo, si todavía tiene sentido, y una sola vez) y por eso el conjunto se recupera sin coordinación central. La corrección vive en las transiciones condicionales del almacén y no en el orden de los pasos, de modo que cualquier mensaje duplicado, tardío u obsoleto simplemente no tiene efecto. Guardar el instante del reintento antes de crear la planificación, aceptar PLANIFICANDO en B y retomar desde ENVIANDO son las tres decisiones que cierran los huecos que las primeras versiones del diseño dejaban abiertos. Y la espera creciente con jitter calculado en la aplicación protege al servicio externo y mantiene el comportamiento determinista.
La diferencia entre un Thread.sleep y este patrón no es de complejidad superficial, sino de qué tan bien el sistema entiende su propia situación. Un proceso que duerme no sabe que está esperando un reintento, no puede decirlo, no puede auditarse y no puede recuperarse de un fallo sin ayuda externa. Un almacén de estado con transiciones condicionales sí sabe en qué punto está, puede registrarlo, puede responder preguntas sobre su historial y puede retomar exactamente donde lo dejó si algo falla. Eso es lo que hace escalable la solución, y no el hecho de que use servicios concretos: el planificador es intercambiable, mañana puede ser una tabla con un poller o un servicio de otro proveedor, y lo que permanece es la máquina de estados, la idempotencia y la política de espera.
Quedan, además, varias líneas abiertas que merecen exploración. La más inmediata es modelar formalmente el cortacircuitos dentro de la máquina de estados, distinguiendo con claridad las indisponibilidades técnicas de los rechazos de negocio, para que las primeras no consuman el presupuesto de intentos. Otra es refinar la política de espera según el motivo del rechazo, o incluso volverla adaptativa, ajustando la base y el factor a partir de la tasa de éxito observada en reintentos anteriores. También vale la pena estudiar la adopción de outbox de forma sistemática en los casos donde el servicio externo no ofrezca garantías de idempotencia, y evaluar su costo frente al de aceptar un duplicado ocasional. Y, en el plano de la validación, tiene mucho potencial la inyección controlada de fallos (chaos engineering) aplicada a cada uno de los puntos intermedios descritos, para comprobar de forma continua, y no solo antes del lanzamiento, que las garantías se mantienen a medida que el sistema evoluciona.
Darle tiempo al servicio externo para recuperarse no es una concesión ante un fallo. Es reconocer que en sistemas distribuidos los fallos suelen ser temporales, que una segunda oportunidad bien diseñada tiene un valor real, y que esperar bien, sin desperdiciar recursos, sin duplicar y sin perder el hilo, es una forma de resiliencia tan importante como actuar rápido cuando todo va bien.
Vistas y funciones como contratos de API sobre una base unificada
- Mauricio ECR
- Arquitectura
- 29 Aug, 2026
En proyectos donde los microservicios comparten una misma base de datos, hay momentos en los que un cambio que comienza como una tarea rutinaria dentro de un equipo puede terminar en una reunión con t
Vistas y funciones como contratos de API sobre una base unificada
- Mauricio ECR
- Arquitectura
- 29 Aug, 2026
En proyectos donde los microservicios comparten una misma base de datos, hay momentos en los que un cambio que comienza como una tarea rutinaria dentro de un equipo puede terminar en una reunión con tres equipos distintos. Clientes, el servicio responsable de las cuentas de usuario, despliega una limpieza de cuentas inactivas, cambia el tipo de su identificador o renombra una columna que hasta entonces consideraba interna. Sus pruebas pasan y el despliegue parece correcto. Poco después, Pedidos empieza a fallar.
Normalmente, la situación comienza de una forma mucho más sencilla. Pedidos necesita consultar determinada información de Clientes y, como ambos servicios comparten la misma base de datos, acceder directamente a sus tablas parece una solución rápida y práctica. Con el tiempo, esa consulta puede dejar de ser algo puntual y convertirse en parte del funcionamiento habitual de Pedidos. El servicio comienza entonces a asumir que las tablas, columnas y estructuras que consulta estarán disponibles y conservarán el mismo significado.
Lo que inicialmente parecía una integración sencilla puede terminar haciendo que decisiones internas de Clientes tengan consecuencias sobre Pedidos. Clientes puede ser responsable de la identidad, el estado y las reglas de ciclo de vida de una persona, mientras que Pedidos solo necesita conservar una referencia estable al cliente y obtener determinados datos para cumplir con sus propias responsabilidades. Sin embargo, cuando Pedidos resuelve esa necesidad consultando directamente las tablas de Clientes, termina dependiendo no solo de los datos que necesita, sino también de la forma en que Clientes los almacena y organiza.
Este escenario plantea una cuestión que va más allá de una consulta concreta o de una columna que haya cambiado. Si dos microservicios comparten la misma base de datos, ¿cómo pueden relacionarse sin convertir las estructuras internas de un dominio en dependencias del otro? Y, sobre todo, ¿cómo se puede establecer una frontera clara cuando la infraestructura sigue siendo compartida?
El problema real: acoplamiento al esquema ajeno
Supongamos que Clientes es responsable de la identidad, el estado y las reglas de ciclo de vida de una persona. Pedidos, en cambio, es responsable de los pedidos y necesita conservar una referencia estable al cliente asociado.
Pedidos necesita saber quién es el cliente, pero no necesita conocer cómo Clientes organiza internamente esa información. No debería depender de si el nombre se almacena en una columna, en dos columnas, en una tabla normalizada o mediante una relación con otra entidad. Tampoco debería decidir qué significa anonimizar una cuenta ni asumir que todas las columnas existentes en clientes son datos que puede interpretar.
Sin embargo, cuando ambos servicios comparten una base de datos, es fácil terminar con algo como esto:
CREATE TABLE pedidos (
    id UUID PRIMARY KEY,
    cliente_id UUID NOT NULL,
    total NUMERIC(12, 2) NOT NULL,
    creado_en TIMESTAMPTZ NOT NULL DEFAULT NOW(),

    CONSTRAINT fk_pedidos_cliente
        FOREIGN KEY (cliente_id) REFERENCES clientes(id)
);
Al estudiar pedidos, la FOREIGN KEY deja visible una relación con clientes. Esa relación es importante, pero conviene distinguir dos conceptos que suelen mezclarse.
Una clave foránea expresa una garantía de integridad referencial. Le dice al motor que un valor de pedidos.cliente_id debe corresponder a un registro existente en clientes.id, de acuerdo con las reglas de la restricción.
Eso no significa que clientes se haya convertido en una API para Pedidos.
Tampoco significa que Pedidos tenga derecho a consultar cualquier columna de la tabla, ejecutar JOIN arbitrarios o depender de la forma en que Clientes almacena sus datos. La clave foránea hace visible una relación entre estructuras; no define una interfaz de integración entre dominios.
El verdadero acoplamiento aparece cuando Pedidos empieza a hacer algo como esto:
SELECT
    p.id,
    p.total,
    c.nombre,
    c.estado,
    c.tipo_documento
FROM pedidos p
JOIN clientes c ON c.id = p.cliente_id;
La consulta parece inocente. El problema es que convierte clientes en una interfaz accidental.
A partir de ese momento, Clientes no puede modificar libremente nombre, estado o tipo_documento porque Pedidos ha asumido que esas columnas forman parte de su contrato. Si mañana Clientes normaliza el nombre, cambia el modelo de estados o separa la información personal de la comercial, el cambio deja de ser exclusivamente suyo.
flowchart LR
    Clientes[(Clientes)]
    Pedidos[(Pedidos)]

    Pedidos -->|JOIN y acceso a tablas privadas| Clientes
La frontera se ha roto porque el consumidor depende de la estructura interna del propietario para funcionar.
Por eso, al analizar una base de datos compartida, la pregunta importante no es únicamente «¿existe una FOREIGN KEY?». La pregunta relevante es «¿qué parte de esta estructura está siendo utilizada como interfaz por otro dominio?».
Relación local o contrato entre dominios
Antes de modificar el DDL conviene clasificar la relación.
Cuando la relación protege una invariante dentro del mismo dominio, la FOREIGN KEY sigue siendo una herramienta apropiada. Si dos tablas pertenecen al mismo modelo y la existencia de una fila depende de la existencia de otra, eliminar la restricción únicamente para conseguir una apariencia de autonomía significa renunciar a una garantía que el motor puede proporcionar de forma fiable.
La situación cambia cuando la relación cruza límites de propiedad.
Pedidos puede conservar cliente_id como referencia estable al cliente. Ese identificador expresa una relación entre conceptos, pero no concede a Pedidos permiso para interpretar el modelo interno de Clientes.
Esta distinción es importante porque eliminar una FOREIGN KEY no crea automáticamente autonomía. Solo elimina una garantía de integridad referencial.
La autonomía aparece cuando cada dominio puede modificar su estructura interna sin romper a sus consumidores.
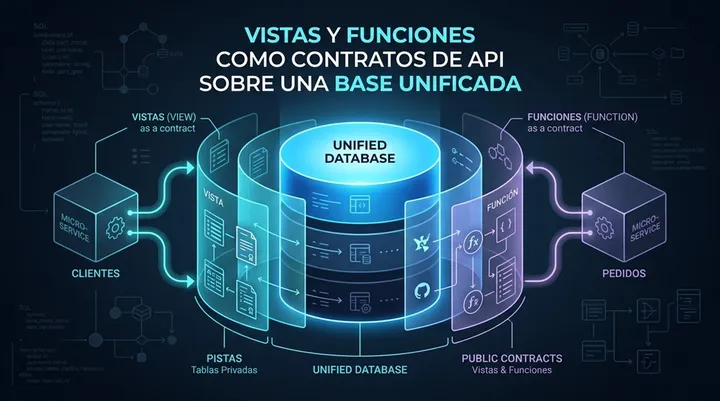
De aquí surge una estrategia especialmente útil para escenarios de transición: Database as an API. La base de datos continúa siendo compartida desde el punto de vista físico, pero sus esquemas dejan de funcionar como una superficie de acceso indiscriminado. Cada dominio mantiene sus estructuras privadas y decide explícitamente qué información publica y qué operaciones permite.
La frontera lógica aparece antes que la frontera física.
Vistas como contratos de lectura
Para las lecturas entre dominios, una de las herramientas más sencillas disponibles en una base relacional es una vista.
Clientes puede mantener sus tablas privadas y publicar únicamente la información que Pedidos necesita:
CREATE VIEW clientes_publicos_para_pedidos AS
SELECT
    id AS cliente_id,
    nombre_comercial,
    estado_comercial
FROM clientes;
Pedidos deja entonces de depender directamente de clientes:
SELECT
    cliente_id,
    nombre_comercial,
    estado_comercial
FROM clientes_publicos_para_pedidos
WHERE cliente_id = :cliente_id;
La diferencia parece pequeña desde el punto de vista de SQL, pero es significativa desde el punto de vista arquitectónico.
La tabla clientes representa el modelo interno del dominio. La vista clientes_publicos_para_pedidos representa una superficie publicada.
La vista puede funcionar conceptualmente como un DTO o como un endpoint GET: expone un conjunto definido de datos y oculta cómo se obtiene internamente.
Clientes podría, por ejemplo, pasar de una tabla monolítica a varias tablas normalizadas:
clientes
    ├── identidades
    ├── perfiles
    └── estados_comerciales
Mientras la vista conserve su contrato:
cliente_id
nombre_comercial
estado_comercial
Pedidos no necesita conocer ese cambio.
La vista, por supuesto, no hace que el contrato desaparezca. Al contrario: lo hace explícito. Cambiar el nombre de una columna publicada, eliminarla o alterar significativamente su semántica debe tratarse como un cambio contractual, aunque no exista HTTP de por medio.
Esta estrategia resulta particularmente útil cuando varios servicios ya utilizan el mismo motor de base de datos. Permite reducir el acoplamiento sin exigir inmediatamente una migración física completa.
También puede tener ventajas operativas. Una lectura que permanece dentro del mismo motor evita llamadas adicionales entre microservicios y puede evitar tráfico de red o costos de egress que aparecerían al sacar la consulta fuera de la infraestructura. Pero conviene no confundir esto con «latencia cero»: la consulta sigue consumiendo CPU, memoria, I/O y capacidad de concurrencia de la base de datos.
Además, una vista no crea independencia física. Los servicios siguen compartiendo disponibilidad, capacidad, credenciales, copias de seguridad, mantenimiento y, potencialmente, una misma condición de fallo.
La vista reduce el acoplamiento al esquema. No elimina el acoplamiento operativo a la infraestructura compartida.
Las lecturas y las escrituras necesitan fronteras diferentes
Aquí aparece una distinción fundamental. No todas las interacciones con una base de datos pueden modelarse de la misma manera.
Una lectura puede exponerse mediante una vista porque, conceptualmente, está proporcionando una representación de información. Una escritura, en cambio, puede modificar el estado del dominio y activar decisiones de negocio.
Por eso conviene distinguir entre una operación técnica y una operación que expresa una decisión de negocio.
Cuando la operación pertenece al negocio
Si una escritura necesita validar reglas, permisos, transiciones de estado, límites, invariantes o efectos secundarios, la autoridad debería permanecer en el servicio propietario.
En ese caso, REST o gRPC son canales adecuados para expresar la operación:
Pedidos
   |
   | POST /clientes/{id}/suspension
   v
Clientes
   |
   +--> valida autorización
   +--> comprueba estado actual
   +--> aplica reglas de negocio
   +--> registra auditoría
   +--> persiste el nuevo estado
Pedidos no debería ejecutar directamente una función SQL equivalente a «suspender cliente» simplemente porque ambos servicios comparten una base de datos.
La suspensión no es solamente un UPDATE. Es una decisión.
Clientes debe determinar si la transición es válida, quién puede ejecutarla, qué auditoría requiere y qué otros efectos deben producirse. Si Pedidos pudiera modificar directamente la fila, el servicio propietario perdería el control de su propio dominio.
Cuando la operación es puramente técnica
Existe otro tipo de operación que sí puede tener sentido encapsular en SQL: una operación técnica, acotada, atómica y sin decisiones de negocio.
Por ejemplo, una función podría eliminar un registro temporal identificado explícitamente:
CREATE FUNCTION purgar_registro_temporal(p_registro_id UUID)
RETURNS VOID
LANGUAGE SQL
AS $$
    DELETE FROM registros_temporales
    WHERE id = p_registro_id;
$$;
La semántica es deliberadamente limitada. Si el registro existe, se elimina; si no existe, la operación no necesita tomar una decisión adicional.
La función no determina quién tiene derecho a suspender una cuenta, qué significa que una cuenta esté inactiva ni qué transición de negocio corresponde.
Este tipo de función puede ser útil como mecanismo de infraestructura, pero existe un riesgo importante: convertir gradualmente la base de datos en una segunda capa de aplicación.
Cuando cada nueva regla termina implementada como un stored procedure, la lógica queda repartida entre el backend y la base de datos. Las pruebas, el versionado, la observabilidad y el razonamiento sobre las reglas se vuelven progresivamente más difíciles.
La regla práctica es sencilla:
La base puede encapsular acceso y operaciones técnicas; el servicio debe conservar las decisiones del dominio.
Una matriz para decidir dónde vive cada operación
Esta separación puede resumirse en una regla operativa:
| Operación | Tipo de lógica | Canal | Responsabilidad |
|---|---|---|---|
| Lectura de datos publicados | Consulta | VIEW |
El dominio propietario define el contrato |
| Escritura técnica acotada | Infraestructura | FUNCTION SQL |
La función ejecuta una operación atómica y limitada |
| Escritura con decisiones | Negocio | REST/gRPC | El servicio propietario valida y persiste |
| Lectura entre dominios | Consulta | VIEW |
Se evita el JOIN sobre tablas privadas |
La matriz no pretende convertir la base de datos en un reemplazo universal de los servicios. Su propósito es asignar cada responsabilidad al canal que puede sostenerla sin volver a abrir el acceso indiscriminado al esquema interno.
El contrato también necesita gobierno
Una vista por sí sola no resuelve el problema. Si cualquier desarrollador puede modificarla sin considerar a sus consumidores, simplemente se habrá sustituido una dependencia implícita por otra.
Cada esquema y cada tabla privada deben tener un propietario claro. Las credenciales de Pedidos no deberían disponer de escritura sobre las tablas de Clientes y, cuando sea posible, tampoco deberían tener lectura directa sobre ellas.
El acceso público debe concederse sobre objetos concretos:
clientes
    ├── tablas privadas
    ├── funciones internas
    └── vistas publicadas
            └── acceso para Pedidos
El principio de mínimo privilegio ayuda a convertir la arquitectura deseada en una restricción técnica. Si Pedidos no tiene permiso para leer clientes, un nuevo JOIN directo deja de ser una tentación que depende exclusivamente de la disciplina del equipo.
Los contratos publicados también necesitan versionado.
Si la vista expone:
cliente_id
nombre_comercial
estado_comercial
y una nueva versión requiere eliminar estado_comercial, no debería tratarse como una modificación trivial. Es un cambio de contrato.
Una estrategia puede ser crear una nueva versión:
clientes_publicos_para_pedidos_v1
clientes_publicos_para_pedidos_v2
y mantener ambas durante un período de transición.
La nomenclatura concreta puede variar. Lo importante es que exista una forma de distinguir entre cambios compatibles y cambios incompatibles y que los consumidores puedan migrar deliberadamente.
El mismo principio aplica a las funciones SQL. Su firma, parámetros, comportamiento y permisos forman parte de una interfaz. No porque exista HTTP, sino porque otro componente depende de ella.
Medir antes de retirar
Una de las dificultades prácticas de estas migraciones es descubrir quién utiliza realmente una tabla.
En sistemas maduros, la documentación rara vez contiene todas las dependencias. Puede haber consultas en servicios antiguos, procesos batch, scripts operativos, herramientas de análisis, trabajos programados o accesos manuales que nadie recuerda.
Por eso la migración debería empezar con un inventario.
No basta con buscar referencias en el código fuente. También conviene revisar permisos, consultas observables en el motor, jobs programados, procesos de integración y consumidores conocidos.
El objetivo es construir un mapa aproximado:
                 ┌── Pedidos
clientes ────────┼── Facturación
                 ├── Reportes
                 └── Batch histórico
A partir de ahí, cada dependencia puede clasificarse.
Algunas serán invariantes legítimas. Otras serán lecturas que deberían convertirse en vistas. Otras serán escrituras que necesitan regresar al servicio propietario. Y algunas serán dependencias históricas que ya pueden eliminarse.
La observabilidad también permite medir el éxito de la transición: número de consumidores, frecuencia de consultas, latencia, errores, volumen de datos y tráfico entre dominios.
El objetivo no es solamente cambiar SQL. Es poder demostrar que la frontera está funcionando.
Una migración gradual sobre la misma infraestructura
Una de las ventajas de este enfoque es que no exige separar físicamente las bases desde el primer día.
La transición puede comenzar con la infraestructura actual.
Primero se construye un inventario de JOIN, consultas directas, procesos batch y permisos entre esquemas. Después se clasifican las relaciones para distinguir invariantes locales de dependencias entre dominios.
A continuación se declara quién es propietario de cada tabla, identificador y regla de ciclo de vida. Esta definición es importante porque una arquitectura no puede establecer fronteras si no está claro quién tiene autoridad sobre aquello que queda dentro de ellas.
Las lecturas necesarias para otros dominios se trasladan a vistas públicas. Las escrituras que expresan reglas de negocio se llevan a REST o gRPC. Las funciones SQL que permanezcan se mantienen deliberadamente pequeñas y técnicas.
Después se versionan los contratos y se empieza a medir su utilización.
Solo cuando los consumidores han dejado de depender de las tablas privadas tiene sentido retirar gradualmente esos permisos y revisar las FOREIGN KEY que atraviesan límites de propiedad.
Este orden importa.
Eliminar primero las restricciones o mover físicamente las bases no resuelve las dependencias semánticas. Es posible tener dos bases de datos completamente separadas y seguir manteniendo un acoplamiento fuerte si un servicio depende de la estructura interna del otro mediante consultas, replicaciones o procesos frágiles.
La frontera lógica debe preceder a la frontera física.
Preparar una futura separación física
Este modelo también puede funcionar como una etapa intermedia hacia una arquitectura con bases independientes.
Mientras ambos dominios comparten el mismo motor, Pedidos puede consumir:
VIEW clientes_publicos_para_pedidos
Más adelante, si Clientes pasa a tener su propia base de datos, esa misma semántica puede representarse mediante:
GET /clientes/{id}
o mediante un contrato equivalente en gRPC.
El cambio de infraestructura no necesita redefinir desde cero qué información necesita Pedidos. La interfaz conceptual ya existía.
Esto permite entender Database as an API no como una arquitectura final obligatoria, sino como una técnica de transición: primero se estabiliza el contrato y después, si es necesario, se separa la infraestructura que lo implementa.
La separación física deja de ser el mecanismo que crea la frontera y pasa a ser una consecuencia posible de una frontera que ya estaba definida.
Conclusión: la frontera que realmente hay que proteger
El desafío de trabajar con microservicios sobre una base de datos compartida no está en la existencia de una relación entre tablas, sino en determinar qué parte del modelo pertenece a cada dominio y qué información puede ser utilizada por los demás. Una relación entre pedidos y clientes puede ser necesaria desde el punto de vista de los datos, pero eso no significa que Pedidos deba conocer o depender de la estructura interna con la que Clientes gestiona sus propias entidades.
La autonomía comienza cuando cada dominio puede evolucionar su modelo interno sin obligar a los demás servicios a conocer esos cambios. Para conseguirlo, la base de datos compartida necesita límites explícitos. Las vistas permiten publicar únicamente los datos que un consumidor necesita; las funciones SQL pueden encapsular operaciones técnicas acotadas; y las decisiones que contienen reglas de negocio deben permanecer bajo la responsabilidad del servicio propietario, mediante REST, gRPC u otro mecanismo de integración apropiado.
Esto convierte la base de datos en algo más que un repositorio común. Puede actuar como una infraestructura compartida que ofrece contratos de acceso definidos y gobernados, en lugar de convertirse en un espacio donde cualquier servicio puede consultar y modificar libremente las estructuras de los demás.
Para que este modelo sea sostenible, los contratos necesitan las mismas garantías que cualquier otra interfaz entre componentes: propietarios claros, permisos restringidos, versionado, compatibilidad entre cambios, observabilidad y un proceso controlado para retirar consumidores. De esta manera, una vista o una función no son simplemente objetos de base de datos, sino parte de una superficie que un dominio decide publicar y mantener.
Este enfoque también permite avanzar de forma gradual. No es necesario separar físicamente las bases de datos para comenzar a establecer límites entre los servicios. Primero pueden definirse los contratos y eliminarse las dependencias directas sobre las tablas privadas. Más adelante, si las necesidades operativas lo requieren, esos mismos contratos pueden trasladarse a una API o a otra forma de comunicación entre servicios.
La separación física, por tanto, no tiene que ser el punto de partida para conseguir autonomía. Puede ser una evolución posterior de una frontera que ya existe a nivel lógico.
La idea central es sencilla:
Compartir una base de datos no obliga a compartir el modelo interno de cada dominio.
La cuestión importante no es cuándo eliminar una relación entre tablas ni cuándo separar físicamente las bases de datos. La cuestión es qué información y qué operaciones está dispuesto a publicar cada dominio, bajo qué condiciones y con qué garantías de estabilidad.
Cuando esa frontera está claramente definida, la base de datos compartida deja de ser una fuente de dependencias accidentales y puede convertirse en una etapa controlada hacia una arquitectura con mayor independencia. El siguiente paso natural consiste en estudiar cómo versionar estos contratos, detectar automáticamente a sus consumidores y establecer mecanismos que permitan evolucionar desde una base unificada hacia servicios con almacenamiento independiente cuando la arquitectura y las necesidades operativas lo justifiquen.
Estándar de Arquitectura: Transacciones Distribuidas (Patrón Saga)
- Mauricio ECR
- Arquitectura
- 14 Feb, 2026
PARTE I: PRINCIPIOS Y NORMATIVA 1. Fundamentos de Consistencia Eventual Debido a la naturaleza distribuida del sistema, se abandona el modelo ACID tradicional (Atomicidad inmediata con bloque

Estándar de Arquitectura: Transacciones Distribuidas (Patrón Saga)
- Mauricio ECR
- Arquitectura
- 14 Feb, 2026
PARTE I: PRINCIPIOS Y NORMATIVA
1. Fundamentos de Consistencia Eventual
Debido a la naturaleza distribuida del sistema, se abandona el modelo ACID tradicional (Atomicidad inmediata con bloqueos) en favor del modelo BASE (Basically Available, Soft state, Eventually consistent).
Implicaciones arquitectónicas:
- Los datos pueden estar temporalmente inconsistentes entre servicios
- La consistencia se alcanza mediante propagación de eventos y compensaciones
- Cada servicio mantiene su propia fuente de verdad (base de datos)
- No existen transacciones atómicas que abarquen múltiples servicios
Garantías del sistema:
- Disponibilidad: Los servicios responden incluso si otros están caídos
- Durabilidad: Los eventos se persisten antes de considerarse publicados
- Convergencia: El sistema eventualmente alcanzará un estado consistente
2. Patrones Permitidos
2.1 Patrón Primario: Saga basada en Coreografía
Los servicios participantes reaccionan a eventos de dominio de manera autónoma sin conocer el flujo completo de la transacción distribuida. Cada servicio:
- Escucha eventos relevantes de su dominio
- Ejecuta su lógica de negocio local
- Publica eventos de resultado
- No tiene conocimiento de qué otros servicios participan en el proceso
Ventajas: Bajo acoplamiento, alta escalabilidad, sin punto único de fallo.
Desventajas: Flujo implícito, difícil depuración, complejidad en el rastreo.
2.2 Patrón Complementario: Orquestación Ligera de Estado
Se permite que UN servicio actúe como Coordinador de Estado (no como orquestador tradicional) con las siguientes restricciones:
Permitido:
- Mantener una tabla de estado que rastree el progreso de la saga
- Escuchar todos los eventos relevantes del flujo
- Tomar decisiones de cancelación basadas en eventos recibidos
- Emitir comandos de compensación cuando sea necesario
- Proveer endpoints de consulta del estado de la transacción
Prohibido:
- Invocar directamente (HTTP/gRPC) a otros servicios para ejecutar pasos
- Mantener lógica de negocio que corresponde a otros dominios
- Actuar como proxy o gateway entre servicios
Clarificación: El coordinador observa y reacciona, no comanda y espera. La comunicación sigue siendo asíncrona mediante el bus de eventos.
2.3 Prohibiciones Absolutas
- Two-Phase Commit (2PC): No se permite debido a bloqueos prolongados y baja disponibilidad
- XA Transactions: Prohibido extender transacciones de base de datos entre servicios
- Distributed Locks: No se permiten bloqueos compartidos entre servicios (excepto Semantic Locks de negocio, ver Parte III)
- Llamadas Síncronas en Flujo Crítico: HTTP/REST/gRPC solo para consultas (queries), nunca para comandos (writes) en sagas
3. Comunicación y Mensajería
3.1 Intermediario Obligatorio
Toda comunicación entre pasos de una saga debe realizarse a través de un Message Broker con las siguientes características:
Requisitos mínimos del broker:
- Persistencia en disco (durabilidad de mensajes)
- Garantía de entrega "al menos una vez" (at-least-once delivery)
- Capacidad de reintento automático
- Soporte para Dead Letter Queues (DLQ)
- Ordenamiento por partición (opcional pero recomendado)
Brokers aprobados: Kafka, RabbitMQ, Amazon SQS/SNS, Azure Service Bus, Google Pub/Sub.
3.2 Topología de Mensajería
Para eventos de dominio:
- Utilizar patrón Publish-Subscribe (pub/sub)
- Múltiples consumidores pueden suscribirse al mismo evento
- Los productores no conocen a los consumidores
Para comandos directos (casos excepcionales):
- Utilizar colas punto-a-punto
- Un solo consumidor procesa el mensaje
- Incluir timeout de procesamiento
3.3 Restricciones de Comunicación Síncrona
Prohibido para:
- Ejecutar el siguiente paso de una transacción crítica
- Confirmar operaciones de escritura entre servicios
- Propagar cambios de estado en flujos transaccionales
Permitido para:
- Consultas de solo lectura (queries)
- Validaciones previas no bloqueantes
- Obtención de datos de referencia
- Healthchecks y monitoreo
4. Transactional Outbox Pattern (Obligatorio)
4.1 Definición del Problema
El Dual Write Problem ocurre cuando un servicio intenta:
- Actualizar su base de datos local
- Publicar un evento en el broker
Si la publicación falla después del commit de BD, el sistema queda inconsistente. Si falla antes, se pierde el evento.
4.2 Solución Mandatoria
Regla de Oro: Un servicio nunca debe publicar directamente en el broker dentro de su código de negocio.
Implementación del patrón:
Primera fase - Transacción Atómica Local:
- Iniciar transacción de base de datos
- Ejecutar operación de negocio (INSERT/UPDATE/DELETE en tablas de dominio)
- Insertar el evento a publicar en una tabla especial llamada OUTBOX
- Confirmar transacción completa (COMMIT atómico)
Segunda fase - Publicación Asíncrona: 5. Un proceso independiente (Relay/Publisher) lee continuamente la tabla OUTBOX 6. Publica los eventos pendientes en el broker 7. Marca los eventos como publicados o los elimina
Tabla OUTBOX - Estructura requerida:
Campos obligatorios:
- Identificador único del mensaje (UUID)
- Tipo de evento (nombre del evento de dominio)
- Cuerpo del evento (payload serializado)
- Timestamp de creación
- Estado de publicación (pendiente, publicado, fallido)
- Número de intentos de publicación
- Agregado raíz asociado (para ordenamiento)
- Versión del esquema del evento
4.3 Estrategias de Relay
Opción A - Polling:
- Proceso que consulta periódicamente la tabla OUTBOX
- Publica eventos pendientes ordenados por timestamp
- Marca como publicados tras confirmación del broker
- Intervalo recomendado: 100-500 milisegundos
Opción B - Change Data Capture (CDC):
- Herramienta que lee el transaction log de la base de datos
- Detecta inserts en OUTBOX en tiempo real
- Publica automáticamente en el broker
- Ejemplos: Debezium, Maxwell, AWS DMS
Opción C - Database Triggers:
- Trigger que se activa al insertar en OUTBOX
- Invoca procedimiento que publica en broker
- No recomendado por acoplamiento y menor resiliencia
5. Resiliencia e Idempotencia
5.1 Principio de Idempotencia
Dado que los brokers garantizan entrega "al menos una vez", es inevitable que algunos mensajes se entreguen duplicados. Todo consumidor de eventos DEBE ser idempotente.
Definición: Una operación es idempotente si ejecutarla múltiples veces produce el mismo resultado que ejecutarla una sola vez.
Verificación obligatoria: Antes de procesar un evento, el consumidor debe verificar si el identificador del mensaje ya fue procesado previamente.
5.2 Implementación de Deduplicación
Tabla de Registro de Mensajes Procesados:
Cada servicio debe mantener una tabla dedicada con:
- Identificador del mensaje (clave primaria)
- Tipo de evento procesado
- Timestamp de procesamiento
- Estado final (éxito/fallo)
- Índice en timestamp para limpieza periódica
Flujo de procesamiento idempotente:
- Recibir mensaje del broker
- Iniciar transacción de base de datos local
- Intentar insertar el identificador del mensaje en la tabla de registro
- Si la inserción falla por duplicado: hacer rollback y retornar éxito (ya fue procesado)
- Si la inserción es exitosa: ejecutar lógica de negocio
- Insertar evento resultante en tabla OUTBOX (si aplica)
- Confirmar transacción completa
- Enviar ACK al broker
Política de limpieza: Eliminar registros con más de siete días de antigüedad mediante proceso nocturno.
5.3 Estrategias de Compensación
Para toda operación de escritura que modifique estado de negocio, el servicio debe implementar una Transacción Compensatoria.
Definición: Acción lógicamente inversa que deshace (o mitiga) el efecto de una operación previamente confirmada.
Ejemplos de compensación:
Operación original → Compensación:
- CrearPedido → AnularPedido
- ReservarInventario → LiberarReserva
- CobrarPago → ReembolsarPago
- EnviarNotificacion → EnviarNotificacionCorreccion
- AsignarRecurso → DesasignarRecurso
Características de compensaciones:
- Debe ser idempotente (puede ejecutarse múltiples veces)
- Puede ser semántica (no necesariamente restaura estado exacto)
- Debe registrarse en logs de auditoría
- Debe emitir eventos de compensación para trazabilidad
Tipos de compensación:
- Compensación perfecta: Restaura el estado exacto anterior (ej: cancelar reserva)
- Compensación aproximada: Restaura un estado equivalente (ej: reembolso en créditos en vez de dinero)
- Compensación simbólica: Registra el intento de reversión cuando la compensación real es imposible (ej: no se puede "des-enviar" un email, pero se envía corrección)
5.4 Manejo de Errores y Reintentos
Clasificación de fallos:
Fallos Transitorios: Errores temporales que pueden resolverse reintentando
- Pérdida de conexión de red
- Timeouts de base de datos por carga
- Servicio dependiente temporalmente no disponible
- Límites de rate limiting
Fallos Permanentes: Errores que no se resolverán reintentando
- Validaciones de negocio fallidas
- Datos malformados o incompletos
- Violaciones de reglas de dominio
- Permisos insuficientes
- Recursos no encontrados
Estrategia de Reintentos - Exponential Backoff:
Para fallos transitorios se debe implementar:
- Espera inicial entre primer y segundo intento: 500 milisegundos
- Multiplicador exponencial: factor de 2
- Espera máxima entre intentos (techo): 60 segundos
- Número máximo de intentos: 5
- Jitter aleatorio: añadir variación del 10-25% para evitar thundering herd
Progresión ejemplo: 500ms → 1s → 2s → 4s → 8s → DLQ
Dead Letter Queue (DLQ):
Después de agotar los reintentos, el mensaje debe enviarse a una cola especial para:
- Análisis manual posterior
- Alertas al equipo de operaciones
- Posible reprocesamiento manual tras corrección
- Auditoría de fallos recurrentes
Propiedades requeridas en mensajes de DLQ:
- Mensaje original completo
- Número de intentos realizados
- Timestamps de cada intento
- Detalles de cada error ocurrido
- Trace completo del último error
6. Versionado y Evolución de Contratos
6.1 Esquemas Explícitos Obligatorios
Todo evento de dominio publicado en el bus debe tener un esquema formal que defina:
- Nombre y tipo de cada campo
- Campos obligatorios vs opcionales
- Tipos de datos permitidos
- Restricciones de validación
- Descripción semántica de cada campo
Formatos aprobados: Avro, Protocol Buffers (Protobuf), JSON Schema.
Prohibido: Publicar eventos con estructura ad-hoc sin definición formal.
6.2 Versionado Semántico de Eventos
Todo evento debe incluir un campo de metadatos que indique su versión siguiendo el formato semántico: MAJOR.MINOR.PATCH
Ejemplo: "schema_version": "1.2.0"
Interpretación de versiones:
MAJOR: Cambios incompatibles que requieren actualización del consumidor
- Eliminar campos
- Cambiar tipo de dato existente
- Cambiar semántica del campo
- Renombrar campos
MINOR: Cambios retrocompatibles que agregan funcionalidad
- Agregar nuevos campos opcionales
- Agregar nuevos valores a enumeraciones
- Deprecar campos (sin eliminarlos)
PATCH: Correcciones menores sin impacto funcional
- Corregir descripciones
- Mejorar documentación
- Correcciones de typos en nombres
6.3 Estrategias de Evolución
Para cambios ADITIVOS (Minor/Patch):
- Agregar solo campos opcionales con valores por defecto
- Los consumidores antiguos ignoran campos nuevos
- Los productores nuevos deben tolerar consumidores antiguos
- No requiere coordinación de despliegue
Para cambios BREAKING (Major):
- Crear un nuevo tipo de evento con sufijo de versión
- Ejemplo: "OrdenSolicitada_v2"
- Mantener publicación dual por período de transición
- El productor emite tanto evento v1 como v2
- Los consumidores migran gradualmente a la nueva versión
- Período mínimo de convivencia: 90 días calendario
- Después del período, deprecar y eliminar versión antigua
Política de deprecación:
- Anunciar deprecación con 90 días de anticipación
- Añadir warnings en logs cuando se use versión antigua
- Publicar métricas de uso de versiones obsoletas
- Coordinar migración con todos los equipos consumidores
- Eliminar soporte solo cuando uso sea cero por 30 días
6.4 Registro Centralizado de Esquemas
Obligatorio: Mantener un Schema Registry centralizado que:
- Almacena todas las versiones de esquemas de eventos
- Valida compatibilidad antes de registrar nuevas versiones
- Provee APIs para consulta programática de esquemas
- Genera documentación automática de contratos
- Permite validación en tiempo de runtime
Herramientas recomendadas: Confluent Schema Registry, AWS Glue Schema Registry, Apicurio Registry.
7. Observabilidad y Rastreabilidad
7.1 Rastreo Distribuido
Generación de Identificadores:
El servicio que inicia una saga debe generar los siguientes identificadores únicos:
Saga ID: Identificador global único (UUID versión 4) que representa toda la transacción distribuida. Se genera una sola vez al inicio y se propaga sin cambios.
Span ID: Identificador único para cada paso o evento individual dentro de la saga. Cada servicio que procesa genera su propio Span ID.
Parent Span ID: Referencia al Span ID del paso anterior, creando una jerarquía de trazas.
Propagación de Contexto:
Estos identificadores deben incluirse como headers/metadatos en todos los mensajes:
- Nombre del header de Saga ID: "X-Saga-ID"
- Nombre del header de Span ID: "X-Span-ID"
- Nombre del header de Parent Span: "X-Parent-Span-ID"
Los servicios intermedios deben:
- Preservar el Saga ID sin modificarlo
- Generar su propio Span ID
- Copiar el Span ID recibido como su Parent Span ID
- Propagar estos tres valores en todos los eventos que emitan
7.2 Logging Estructurado
Formato Obligatorio:
Cada entrada de log relacionada con procesamiento de eventos de saga debe ser estructurada (no texto plano) e incluir los siguientes campos:
Campos mandatorios de contexto:
- Identificador de saga (copiado del mensaje)
- Tipo de evento procesado
- Versión del esquema del evento
- Nombre del servicio que genera el log
- Timestamp en formato ISO-8601 con zona horaria UTC
- Identificador del span actual
- Identificador del span padre
Campos mandatorios de resultado:
- Estado del procesamiento: RECEIVED, PROCESSING, SUCCESS, FAILED, COMPENSATING, COMPENSATED
- Duración en milisegundos de la operación
- Número de intento (para reintentos)
Campos opcionales pero recomendados:
- Identificador de correlación de negocio (ej: número de orden)
- Identificador del usuario o entidad que inició la transacción
- Datos relevantes del payload (sin información sensible)
- Detalles del error (en caso de fallo)
- Nombre del nodo/instancia que procesó
Niveles de Log:
- INFO: Inicio y fin exitoso de procesamiento de evento
- WARN: Reintentos por fallos transitorios
- ERROR: Fallos permanentes, envío a DLQ
- DEBUG: Detalles de validaciones y decisiones de negocio
Ejemplo descriptivo de entrada de log:
Un log estructurado indicando que el servicio de Inventario procesó exitosamente un evento PagoExitoso en 150 milisegundos, este fue el primer intento, pertenece a la saga con ID alfa-123, el span actual es beta-456 hijo del span gamma-789, ocurrió el 7 de febrero de 2026 a las 10:30:00 UTC, procesó la versión 1.0 del evento, y resultó en éxito.
7.3 Métricas Requeridas
Todos los servicios participantes en sagas deben exponer las siguientes métricas en formato compatible con sistemas de monitoreo:
Métricas de duración:
- Nombre: saga_duration_seconds
- Tipo: Histogram
- Etiquetas: tipo_de_saga, estado_final (success, failed, compensated)
- Descripción: Tiempo total desde inicio hasta conclusión de la saga
Métricas de errores por paso:
- Nombre: saga_step_errors_total
- Tipo: Counter (contador acumulativo)
- Etiquetas: nombre_servicio, tipo_evento, tipo_error
- Descripción: Cantidad total de fallos al procesar eventos
Métricas de compensaciones:
- Nombre: saga_compensations_total
- Tipo: Counter
- Etiquetas: nombre_servicio, razón_compensación
- Descripción: Cantidad de transacciones compensatorias ejecutadas
Métricas de mensajes pendientes:
- Nombre: outbox_pending_messages
- Tipo: Gauge (valor instantáneo)
- Etiquetas: nombre_servicio
- Descripción: Cantidad de eventos en tabla OUTBOX pendientes de publicar
Métricas de mensajes en DLQ:
- Nombre: dlq_messages_total
- Tipo: Gauge
- Etiquetas: nombre_servicio, tipo_evento
- Descripción: Cantidad de mensajes en Dead Letter Queue por servicio
Formato de exportación: Prometheus, OpenMetrics, o CloudWatch.
7.4 Trazabilidad de Auditoría
Para procesos críticos de negocio se debe mantener:
- Tabla de auditoría de saga con todos los cambios de estado
- Timestamp de cada transición de estado
- Razón del cambio (evento que lo provocó)
- Usuario o sistema responsable del inicio
- Datos relevantes de negocio (sin información sensible duplicada)
- Retención mínima: según políticas regulatorias (típicamente 7 años)
8. Límites Operacionales y Timeouts
8.1 Parámetros Configurables Mandatorios
Todo servicio participante en sagas debe exponer y documentar los siguientes parámetros de configuración:
Reintentos:
Número máximo de intentos antes de enviar a DLQ
- Valor mínimo permitido: 3 intentos
- Valor recomendado: 5 intentos
Espera inicial entre primer y segundo intento (backoff inicial)
- Valor mínimo permitido: 100 milisegundos
- Valor recomendado: 500 milisegundos
Espera máxima entre intentos (techo de backoff)
- Valor mínimo permitido: 30 segundos
- Valor recomendado: 60 segundos
Timeouts de saga completa:
- Tiempo máximo total para completar toda la saga
- Valor mínimo permitido: 1 hora
- Valor recomendado: 24 horas
- Nota: Ajustar según naturaleza del proceso de negocio
Timeouts por paso individual:
- Tiempo máximo de espera por respuesta de un paso
- Valor mínimo permitido: 30 segundos
- Valor recomendado: 5 minutos (300 segundos)
Estos valores deben ser configurables sin recompilar código (variables de entorno, archivos de configuración, configuration server).
8.2 Política de Timeouts
Para timeouts de paso individual:
Si un evento esperado no llega dentro del plazo configurado:
- El servicio coordinador (si existe) debe emitir un evento de timeout
- Nombre del evento: "StepTimedOut" o similar
- Incluir en el payload: saga_id, paso esperado, tiempo transcurrido
- Iniciar proceso de compensación
- Registrar en logs con nivel ERROR
- Incrementar métrica de timeouts
Para timeouts de saga completa:
Si la saga no se completa dentro del plazo total configurado:
- Ejecutar compensación automática de todos los pasos confirmados
- Marcar la saga con estado TIMED_OUT
- Emitir evento de saga expirada para auditoría
- Notificar al usuario/sistema iniciador del fallo
- Generar alerta para equipo de operaciones
- No eliminar datos de auditoría (mantener para análisis)
8.3 Monitoreo de Umbrales
Alertas obligatorias:
- Si el porcentaje de sagas fallidas supera 5% en ventana de 15 minutos
- Si el tiempo promedio de saga supera el doble del baseline histórico
- Si la cantidad de mensajes en DLQ supera 10 por servicio
- Si hay mensajes en OUTBOX pendientes por más de 10 minutos
- Si una saga individual supera el 80% del timeout configurado
Niveles de severidad:
- CRITICAL: Afecta flujos de negocio críticos (pagos, pedidos)
- HIGH: Afecta funcionalidad importante pero no crítica
- MEDIUM: Degradación de rendimiento sin pérdida de funcionalidad
- LOW: Anomalías detectadas pero sin impacto inmediato
PARTE II: IMPLEMENTACIÓN DE REFERENCIA
1. Caso de Uso: Procesamiento de Órdenes con Validación Preventiva
Dominio de negocio: Sistema de comercio electrónico
Objetivo: Procesar una orden de compra asegurando disponibilidad de inventario antes de ejecutar el cobro, minimizando reembolsos por falta de stock.
Estrategia elegida: Check-Then-Act (Verificación antes de Acción Financiera)
Justificación: Reducir costos de transacciones bancarias fallidas y mejorar experiencia del cliente evitando cobros seguidos de reembolsos.
2. Definición del Flujo Transaccional
El proceso se divide en cuatro fases secuenciales:
Fase 1 - Intención:
- Acción: Registro inicial de la orden en el sistema
- Estado resultante: PENDIENTE_VALIDACION
- Evento emitido: OrdenSolicitada
Fase 2 - Validación:
- Acción: Consulta de disponibilidad de inventario sin reserva
- Tipo de operación: Lectura (SELECT) sin bloqueos
- Eventos posibles: StockVerificado o StockNoDisponible
Fase 3 - Cobro Condicional:
- Acción: Ejecución de transacción financiera
- Precondición: Solo si Fase 2 fue exitosa
- Eventos posibles: PagoExitoso o PagoRechazado
Fase 4 - Asignación con Bloqueo:
- Acción: Descuento definitivo de inventario
- Tipo de operación: Escritura (UPDATE) con bloqueo pesimista
- Eventos posibles: StockAsignado o FalloAsignacion
3. Servicios Participantes y Responsabilidades
3.1 Servicio: Gestor de Pedidos
Rol: Coordinador de estado (Orquestación Ligera)
Responsabilidades:
- Recibir la solicitud inicial del cliente
- Crear el registro de orden con estado inicial
- Generar el Saga ID único
- Emitir el evento OrdenSolicitada vía patrón Outbox
- Escuchar eventos de progreso del resto de participantes
- Mantener máquina de estados de la orden
- Actualizar estado según eventos recibidos
- Notificar al cliente sobre el resultado final
Transiciones de estado:
Estado PENDIENTE_VALIDACION al recibir:
- StockVerificado → PENDIENTE_PAGO
- StockNoDisponible → CANCELADA_SIN_STOCK (flujo termina)
- Timeout de validación → CANCELADA_TIMEOUT
Estado PENDIENTE_PAGO al recibir:
- PagoExitoso → PENDIENTE_ASIGNACION
- PagoRechazado → CANCELADA_PAGO_RECHAZADO
Estado PENDIENTE_ASIGNACION al recibir:
- StockAsignado → COMPLETADA (flujo exitoso)
- FalloAsignacion → CANCELADA_CON_REEMBOLSO (requiere compensación)
Eventos que escucha:
- StockVerificado
- StockNoDisponible
- PagoExitoso
- PagoRechazado
- StockAsignado
- FalloAsignacion
- ReembolsoEjecutado
Eventos que emite:
- OrdenSolicitada (inicio del flujo)
- OrdenCompletada (conclusión exitosa)
- OrdenCancelada (conclusión con fallo)
3.2 Servicio: Gestor de Inventario
Rol: Validador y Ejecutor (participa en dos momentos diferentes)
Responsabilidades:
Momento 1 - Validación (Fase 2):
- Escuchar evento OrdenSolicitada
- Consultar disponibilidad actual en base de datos
- Validar si existe stock suficiente para los ítems solicitados
- NO realizar ninguna reserva ni modificación de datos
- Emitir resultado de validación
Momento 2 - Asignación (Fase 4):
- Escuchar evento PagoExitoso
- Iniciar transacción de base de datos con bloqueo pesimista
- Re-verificar disponibilidad actual (puede haber cambiado desde Fase 2)
- Descontar las unidades si aún hay stock disponible
- Confirmar transacción o hacer rollback según resultado
- Emitir resultado de asignación
Lógica de validación (Momento 1):
Para cada ítem en la orden:
- Consultar tabla de productos con el SKU solicitado
- Leer campo de cantidad disponible actual
- Comparar cantidad solicitada vs cantidad disponible
- Si para TODOS los ítems hay stock suficiente: emitir StockVerificado
- Si para ALGÚN ítem no hay stock suficiente: emitir StockNoDisponible con detalles
Lógica de asignación (Momento 2):
- Iniciar transacción con nivel de aislamiento REPEATABLE_READ o superior
- Aplicar bloqueo pesimista (SELECT FOR UPDATE) sobre los productos afectados
- Re-leer cantidad disponible actual
- Validar nuevamente que hay stock suficiente
- Si validación exitosa:
- Ejecutar UPDATE restando las unidades
- Insertar evento StockAsignado en tabla OUTBOX
- COMMIT de transacción
- Si validación falla (race condition, stock consumido por otra transacción):
- Insertar evento FalloAsignacion en tabla OUTBOX
- COMMIT de transacción (el evento de fallo debe publicarse)
Eventos que escucha:
- OrdenSolicitada (trigger de validación)
- PagoExitoso (trigger de asignación)
Eventos que emite:
- StockVerificado
- StockNoDisponible
- StockAsignado
- FalloAsignacion
Compensación: Si recibe evento de compensación (por fallo en paso posterior):
- Restaurar las unidades de inventario sumando la cantidad original
- Emitir evento StockLiberado
3.3 Servicio: Procesador de Pagos
Rol: Intermediario financiero condicional
Responsabilidades:
Operación Normal:
- Escuchar evento StockVerificado (NO OrdenSolicitada, para evitar cobros sin stock)
- Extraer información de pago del payload del evento
- Invocar API de pasarela de pagos externa (Stripe, PayPal, etc.)
- Manejar respuesta de la pasarela
- Emitir resultado de la operación financiera
Operación de Compensación:
- Escuchar evento FalloAsignacion
- Identificar la transacción financiera original asociada
- Ejecutar reembolso o reversa en la pasarela de pagos
- Emitir evento de confirmación de compensación
Lógica de cobro:
- Recibir evento StockVerificado
- Validar que evento no fue procesado previamente (idempotencia)
- Extraer datos: monto, método de pago, token de tarjeta, etc.
- Llamar API de pasarela con timeout de 30 segundos
- Si respuesta es exitosa:
- Almacenar ID de transacción de la pasarela
- Insertar evento PagoExitoso en OUTBOX con referencia de transacción
- COMMIT
- Si respuesta es rechazo (fondos insuficientes, tarjeta inválida):
- Insertar evento PagoRechazado en OUTBOX con código de error
- COMMIT
- Si hay timeout o error de red:
- Aplicar política de reintentos con exponential backoff
- Tras agotar intentos: enviar a DLQ para revisión manual
Lógica de compensación:
- Recibir evento FalloAsignacion
- Extraer Saga ID para identificar la transacción financiera original
- Buscar en base de datos local el ID de transacción de la pasarela
- Llamar API de reembolso de la pasarela con el ID original
- Si reembolso exitoso:
- Insertar evento ReembolsoEjecutado en OUTBOX
- COMMIT
- Si reembolso falla:
- Reintentar con backoff exponencial
- Tras 5 intentos fallidos: enviar alerta crítica a equipo de finanzas
- Marcar para reembolso manual
Eventos que escucha:
- StockVerificado (trigger de cobro)
- FalloAsignacion (trigger de compensación)
Eventos que emite:
- PagoExitoso
- PagoRechazado
- ReembolsoEjecutado
- FalloReembolso (para casos críticos)
4. Escenarios de Ejecución
4.1 Escenario A: Flujo Exitoso (Happy Path)
Contexto inicial:
- Cliente solicita 1 unidad del producto SKU-123
- Inventario actual: 10 unidades disponibles
- No hay operaciones concurrentes
Secuencia de eventos:
Cliente envía solicitud HTTP POST al endpoint de Pedidos
Pedidos crea registro de orden con estado PENDIENTE_VALIDACION
Pedidos genera Saga ID: "550e8400-e29b-41d4-a716-446655440000"
Pedidos inserta en OUTBOX el evento OrdenSolicitada
Relay de Pedidos publica evento en topic "order-events"
Inventario consume evento OrdenSolicitada
Inventario consulta: SELECT cantidad FROM productos WHERE sku = 'SKU-123'
Inventario verifica: 10 unidades disponibles, pedido requiere 1, verificación OK
Inventario inserta en OUTBOX el evento StockVerificado
Relay de Inventario publica evento en topic "inventory-events"
Pedidos consume StockVerificado y actualiza estado a PENDIENTE_PAGO
Pagos consume StockVerificado
Pagos invoca API de pasarela: "Cobrar 50.00 USD a tarjeta terminada en 4242"
Pasarela responde: "Aprobado, transaction_id: txn_abc123"
Pagos inserta en OUTBOX el evento PagoExitoso con referencia txn_abc123
Relay de Pagos publica evento en topic "payment-events"
Pedidos consume PagoExitoso y actualiza estado a PENDIENTE_ASIGNACION
Inventario consume PagoExitoso
Inventario inicia transacción con: BEGIN; SELECT cantidad FROM productos WHERE sku = 'SKU-123' FOR UPDATE
Inventario lee cantidad bloqueada: 10 unidades
Inventario valida: 10 >= 1, OK
Inventario ejecuta: UPDATE productos SET cantidad = cantidad - 1 WHERE sku = 'SKU-123'
Inventario inserta en OUTBOX el evento StockAsignado
Inventario confirma: COMMIT
Relay de Inventario publica evento en topic "inventory-events"
Pedidos consume StockAsignado y actualiza estado a COMPLETADA
Pedidos emite evento OrdenCompletada
Pedidos envía notificación al cliente: "Tu orden ha sido confirmada"
Resultado final:
- Orden completada exitosamente
- Inventario reducido a 9 unidades
- Cliente cobrado y notificado
- Duración total: aproximadamente 2-5 segundos
4.2 Escenario B: Fallo Temprano (Sin Stock Disponible)
Contexto inicial:
- Cliente solicita 5 unidades del producto SKU-456
- Inventario actual: 0 unidades disponibles
- Optimización: evitar cobro innecesario
Secuencia de eventos:
Cliente envía solicitud HTTP POST al endpoint de Pedidos
Pedidos crea registro de orden con estado PENDIENTE_VALIDACION
Pedidos genera Saga ID: "7c9e6679-7425-40de-944b-e07fc1f90ae7"
Pedidos inserta en OUTBOX el evento OrdenSolicitada
Relay de Pedidos publica evento en topic "order-events"
Inventario consume evento OrdenSolicitada
Inventario consulta: SELECT cantidad FROM productos WHERE sku = 'SKU-456'
Inventario verifica: 0 unidades disponibles, pedido requiere 5, verificación FALLA
Inventario inserta en OUTBOX el evento StockNoDisponible con detalles
Relay de Inventario publica evento en topic "inventory-events"
Pedidos consume StockNoDisponible
Pedidos actualiza estado a CANCELADA_SIN_STOCK
Pedidos emite evento OrdenCancelada con razón "stock insuficiente"
Pedidos envía notificación al cliente: "Lo sentimos, el producto está agotado"
Comportamiento de Pagos:
- El servicio de Pagos NO escucha el evento StockNoDisponible
- Por tanto, NO se ejecuta ninguna operación financiera
- No hay cargos ni reembolsos
Resultado final:
- Orden cancelada rápidamente (en menos de 1 segundo)
- Cliente no fue cobrado
- Costo financiero: cero
- Experiencia de cliente: transparente y honesta
Beneficio del patrón: Esta arquitectura evita aproximadamente el 95% de reembolsos comparado con estrategias de "cobrar primero, verificar después".
4.3 Escenario C: Fallo Tardío (Race Condition)
Contexto inicial:
- Cliente A solicita 1 unidad del producto SKU-789
- Inventario actual: 1 unidad disponible
- Evento concurrente: Cliente B también solicita 1 unidad del mismo producto
Secuencia de eventos para Cliente A:
Pedidos A crea orden con Saga ID: "saga-aaa"
Pedidos A emite OrdenSolicitada
Inventario verifica disponibilidad para saga-aaa
Inventario consulta: 1 unidad disponible
Inventario emite StockVerificado para saga-aaa
Pagos procesa cobro para saga-aaa
Pasarela aprueba transacción: txn_xyz789
Pagos emite PagoExitoso para saga-aaa
Evento concurrente (Cliente B):
Mientras el flujo de Cliente A está entre Fase 3 y Fase 4:
- Pedidos B emite OrdenSolicitada para saga-bbb
- Inventario verifica: aún hay 1 unidad, emite StockVerificado para saga-bbb
- Pagos cobra a Cliente B: txn_def456
- Pagos emite PagoExitoso para saga-bbb
Continuación para Cliente A (intenta asignar primero):
Inventario consume PagoExitoso para saga-aaa
Inventario inicia: BEGIN; SELECT cantidad FROM productos WHERE sku = 'SKU-789' FOR UPDATE
Inventario lee cantidad: 1 unidad
Inventario valida: 1 >= 1, OK
Inventario ejecuta: UPDATE productos SET cantidad = 0
Inventario inserta evento StockAsignado para saga-aaa
Inventario confirma: COMMIT
Pedidos A recibe StockAsignado
Orden A finaliza con estado COMPLETADA
Continuación para Cliente B (llega segundo):
Inventario consume PagoExitoso para saga-bbb
Inventario inicia: BEGIN; SELECT cantidad FROM productos WHERE sku = 'SKU-789' FOR UPDATE
Inventario lee cantidad: 0 unidades (ya fue consumida por Cliente A)
Inventario valida: 0 >= 1, FALLA
Inventario NO ejecuta UPDATE
Inventario inserta evento FalloAsignacion para saga-bbb con razón "race condition"
Inventario confirma: COMMIT (importante: confirmar para que evento se publique)
Pagos consume FalloAsignacion para saga-bbb
Pagos busca transacción original: txn_def456
Pagos invoca API de pasarela: "Reembolsar txn_def456"
Pasarela confirma: "Reembolso procesado, refund_id: rfnd_xyz"
Pagos inserta evento ReembolsoEjecutado para saga-bbb
Relay de Pagos publica evento
Pedidos B consume ReembolsoEjecutado
Pedidos B actualiza estado a CANCELADA_CON_REEMBOLSO
Pedidos B envía notificación al Cliente B: "Tu pago ha sido reembolsado, el producto se agotó durante el proceso"
Resultado final:
- Cliente A: orden completada, inventario asignado
- Cliente B: orden cancelada, dinero reembolsado automáticamente
- Sistema mantuvo consistencia a pesar de concurrencia
- No hubo sobreventa (overselling)
Observación crítica: Este escenario demuestra por qué la verificación en Fase 2 es "optimista" (sin bloqueo) y la asignación en Fase 4 es "pesimista" (con bloqueo). El bloqueo temprano causaría alta contención. El bloqueo tardío minimiza ventana crítica.
5. Consideraciones de Implementación
5.1 Ordenamiento de Eventos
Problema: Los brokers garantizan orden dentro de una partición, no globalmente.
Solución para este caso de uso:
- Particionar eventos por Saga ID
- Todos los eventos de una misma saga van a la misma partición
- Configurar clave de partición: Saga ID
- Garantiza que eventos de UNA orden se procesan en orden
- No importa el orden entre órdenes diferentes
5.2 Manejo de Duplicados
Ejemplo de deduplicación en Inventario:
Cuando llega evento PagoExitoso:
- Extraer Message ID del header: "msg-12345"
- Iniciar transacción
- Intentar: INSERT INTO processed_messages (message_id, event_type) VALUES ('msg-12345', 'PagoExitoso')
- Si falla por clave duplicada:
- Significa que este mensaje ya fue procesado
- Hacer ROLLBACK
- Retornar ACK al broker (no reintentar)
- Registrar en log: "Evento duplicado ignorado"
- Si inserción exitosa:
- Proceder con lógica de asignación de stock
- COMMIT incluye tanto la nueva fila en processed_messages como el UPDATE de inventario
- Retornar ACK al broker
5.3 Consistencia de OUTBOX
Garantía crítica: El evento en OUTBOX y el cambio de estado de negocio deben confirmarse en la misma transacción atómica de base de datos.
Ejemplo en Pedidos al recibir StockVerificado:
Transacción única:
- BEGIN
- UPDATE orders SET status = 'PENDIENTE_PAGO' WHERE saga_id = '550e8400...'
- INSERT INTO outbox (event_type, payload, saga_id) VALUES ('OrdenActualizada', '{...}', '550e8400...')
- COMMIT
Si falla el COMMIT, ningún cambio se persiste. Si se confirma, ambos cambios quedan guardados atómicamente.
5.4 Configuración de Timeouts por Servicio
Pedidos:
- Timeout de validación de stock: 30 segundos
- Timeout de pago: 60 segundos (APIs bancarias pueden ser lentas)
- Timeout de asignación: 15 segundos
- Timeout total de saga: 2 horas
Inventario:
- Timeout de consulta de BD: 5 segundos
- Timeout de bloqueo pesimista: 10 segundos
Pagos:
- Timeout de llamada a pasarela: 30 segundos
- Reintentos en pasarela: 3 intentos con backoff de 2-8-18 segundos
- Timeout de reembolso: 60 segundos
PARTE III: PATRONES AVANZADOS (OPCIONAL)
1. Sagas de Larga Duración
Definición: Procesos que requieren más de una hora para completarse, típicamente por intervención humana, validaciones externas, o pasos asíncronos lentos.
Ejemplos:
- Proceso de aprobación de crédito (requiere revisión manual)
- Workflow de incorporación de empleado (múltiples pasos en días)
- Proceso de compra B2B con aprobaciones corporativas
- Integración con sistemas legacy batch que procesan nocturnamente
1.1 Desafíos Específicos
Problema 1: Estado en Memoria No es viable mantener el estado de la saga en memoria de un servicio durante horas o días. El servicio puede reiniciarse.
Problema 2: Escalabilidad Miles de sagas activas simultáneas durante días consumen recursos si no se gestionan apropiadamente.
Problema 3: Visibilidad Usuarios y operadores necesitan consultar el estado de procesos que toman días.
1.2 Estrategia de Implementación
Persistencia de Estado Explícita:
Crear una tabla dedicada para rastrear sagas activas:
Campos requeridos:
- Identificador único de saga (PK)
- Tipo de saga (ej: "AprobacionCredito")
- Estado actual (ej: "ESPERANDO_REVISION_MANUAL")
- Timestamp de inicio
- Timestamp de última actualización
- Paso actual en el flujo
- Contexto de negocio (datos necesarios para reanudar)
- Usuario o entidad propietaria
- Fecha de expiración o timeout
Timers Persistentes:
En lugar de mantener timers en memoria, usar:
- Scheduled jobs que consultan tabla de sagas periódicamente
- Buscar sagas en estado de espera cuyo timeout ha expirado
- Emitir eventos de timeout para reanudar o compensar
- Ejemplo: Job cada 5 minutos revisa sagas con "expected_event_by" < NOW()
Endpoints de Consulta:
Exponer APIs REST para que usuarios consulten estado:
- GET /sagas/saga-id/status → Retorna estado actual y progreso
- GET /sagas/saga-id/history → Retorna todos los eventos y transiciones
- POST /sagas/saga-id/cancel → Permite cancelación manual (ejecuta compensación)
1.3 Patrón de Reanudación
Caso de uso: Proceso pausado esperando aprobación humana.
Flujo:
- Saga llega a paso que requiere aprobación
- Servicio emite evento "AprobacionSolicitada"
- Servicio actualiza tabla de sagas: estado = "ESPERANDO_APROBACION"
- Se envía notificación a aprobador (email, dashboard, etc.)
- Servicio NO mantiene nada en memoria, libera recursos
- Horas o días después, aprobador toma decisión
- Sistema de UI/backoffice emite evento "AprobacionOtorgada" o "AprobacionRechazada"
- Servicio escucha evento, consulta estado de saga en tabla
- Servicio carga contexto de negocio desde tabla
- Servicio reanuda flujo desde el paso siguiente
- Servicio actualiza estado en tabla
Beneficio: El servicio es stateless, puede reiniciarse sin perder progreso.
2. Sub-Sagas Anidadas
Definición: Una saga que, como parte de uno de sus pasos, inicia otra saga completa e independiente.
Ejemplo:
- Saga principal: "ProcesarCompraEmpresarial"
- Paso 3 de la saga requiere: "ValidarCreditoProveedor"
- ValidarCreditoProveedor es en sí una saga con múltiples pasos (consultar bureaus, validar referencias, aprobar monto)
2.1 Reglas de Anidación
Máximo permitido: 2 niveles de profundidad
- Saga Nivel 0 (raíz)
- Saga Nivel 1 (hija directa)
- Prohibido: Saga Nivel 2 (nieta)
Razón: Complejidad exponencial de compensación. Si una saga de nivel 2 falla, hay que compensar nivel 2, luego nivel 1, luego nivel 0. El rastreo se vuelve intratable.
2.2 Responsabilidad de Compensación
Principio: La saga padre es responsable de compensar sagas hijas si el flujo general falla.
Ejemplo:
Saga Padre: ProcesarCompra
- Paso 1: CrearOrden → OK
- Paso 2: ValidarCredito (invoca sub-saga) → OK
- Paso 3: EnviarMercancia → FALLA
Compensación:
- Saga Padre emite evento de compensación para Paso 3 (no aplica, nunca ocurrió)
- Saga Padre emite evento "CancelarValidacionCredito" para sub-saga
- Sub-saga ejecuta su propia compensación interna (liberar límite de crédito reservado)
- Saga Padre compensa Paso 1 (CancelarOrden)
Implementación:
La saga padre debe:
- Mantener registro de todas las sub-sagas iniciadas (almacenar Sub-Saga IDs)
- Al compensar, emitir eventos de compensación dirigidos a cada sub-saga
- Esperar confirmación de compensación de sub-sagas antes de completar su propia compensación
- Implementar timeout: si sub-saga no confirma compensación en X tiempo, alertar para intervención manual
2.3 Propagación de Contexto
Identificadores requeridos:
- Saga ID del padre (Root Saga ID)
- Saga ID de la hija (Child Saga ID)
- Nivel de anidación (0 = raíz, 1 = hija)
Headers en eventos de sub-saga:
- X-Root-Saga-ID: ID de la saga raíz
- X-Parent-Saga-ID: ID de la saga que inició esta
- X-Saga-Level: Nivel numérico de anidación
Uso en observabilidad: Permite visualizar jerarquía completa en herramientas de tracing:
- Root Saga: ProcesarCompra-123
- Child Saga: ValidarCredito-456
- Event: ConsultarBureau
- Event: ValidarReferencias
- Event: EnviarMercancia
- Child Saga: ValidarCredito-456
3. Semantic Lock (Bloqueo Semántico de Negocio)
Problema: Prevenir race conditions en recursos críticos sin recurrir a bloqueos pesimistas de base de datos que reducen throughput.
Ejemplo del problema: Dos usuarios intentan reservar el mismo asiento de avión simultáneamente. Sin bloqueo, ambos podrían ver "asiento disponible" y ambos intentar comprarlo.
3.1 Concepto de Reserva Soft
En lugar de modificar inmediatamente el estado del recurso, se marca como "reservado temporalmente" con:
- Identificador de quién reservó (Saga ID)
- Timestamp de expiración (TTL - Time To Live)
Diferencia con bloqueo tradicional:
- Bloqueo tradicional (SELECT FOR UPDATE): Mantiene lock de base de datos hasta commit/rollback
- Semantic Lock: Marca lógica en el dato que otros respetan, lock se libera automáticamente por TTL
3.2 Flujo de Tres Fases
Fase 1 - Reserva Soft (Check):
- Servicio verifica disponibilidad del recurso
- Si está disponible, marca como "reservado" con Saga ID y TTL de 5 minutos
- Emite evento "RecursoReservado"
- NO compromete definitivamente el recurso
Fase 2 - Operación Crítica (Execute):
- Se ejecuta la operación costosa (ej: cobro de pago)
- Si falla, la reserva expira automáticamente por TTL
- Si tiene éxito, emite evento para confirmar
Fase 3 - Confirmación Hard (Commit):
- Servicio escucha evento de éxito de operación crítica
- Convierte reserva soft en asignación definitiva
- Cambia estado de "reservado" a "vendido"
- Limpia TTL
Fase Alternativa - Liberación Automática:
- Si saga falla o expira, el TTL llega a cero
- Job periódico (cada minuto) busca reservas expiradas
- Cambia estado de "reservado" a "disponible"
- Recurso queda libre para otros
3.3 Ejemplo Completo: Reserva de Asiento
Tabla de asientos:
Campos:
- id_asiento (PK)
- numero_asiento
- estado: DISPONIBLE, RESERVADO, VENDIDO
- reservado_por_saga_id (nullable)
- reservado_hasta_timestamp (nullable)
Paso 1 - Validación y Reserva:
Servicio de Asientos escucha OrdenDeVueloSolicitada:
- Consultar: SELECT estado, reservado_hasta FROM asientos WHERE numero = '12A'
- Si estado = VENDIDO: emitir AsientoNoDisponible
- Si estado = RESERVADO AND reservado_hasta > NOW: emitir AsientoNoDisponible
- Si estado = DISPONIBLE OR (estado = RESERVADO AND reservado_hasta <= NOW):
- UPDATE asientos SET estado = 'RESERVADO', reservado_por_saga_id = 'saga-123', reservado_hasta = NOW + 5 minutos
- Emitir AsientoReservado
- COMMIT
Paso 2 - Pago:
Servicio de Pagos procesa cobro (toma 30 segundos):
- Si éxito: emite PagoExitoso
- Si fallo: NO emite nada, saga expira
Paso 3 - Confirmación:
Servicio de Asientos escucha PagoExitoso:
- Verificar que saga_id coincide: SELECT reservado_por_saga_id FROM asientos WHERE numero = '12A'
- UPDATE asientos SET estado = 'VENDIDO', reservado_por_saga_id = NULL, reservado_hasta = NULL
- Emitir AsientoConfirmado
- COMMIT
Job de Limpieza (cada 1 minuto):
- SELECT numero FROM asientos WHERE estado = 'RESERVADO' AND reservado_hasta <= NOW
- Para cada asiento encontrado:
- UPDATE asientos SET estado = 'DISPONIBLE', reservado_por_saga_id = NULL, reservado_hasta = NULL
- Registrar en log: "Reserva expirada para asiento X de saga Y"
Ventajas de este patrón:
- Alta concurrencia: No bloquea filas durante el pago
- Auto-recuperación: Fallos liberan recursos automáticamente
- Fairness: Primer solicitante obtiene reserva temporal
- Sin deadlocks: No hay bloqueos de base de datos
Desventajas:
- Complejidad adicional en lógica de negocio
- Requiere job de limpieza confiable
- Ventana de race condition muy pequeña (pero existe) en actualización de reserva
PARTE IV: GUÍAS DE IMPLEMENTACIÓN
1. Checklist de Desarrollo
Todo servicio que participe en una saga debe cumplir los siguientes requisitos antes de pasar a producción:
1.1 Persistencia y Mensajería
Verificar que:
- Existe tabla OUTBOX con todos los campos mandatorios
- Existe tabla de mensajes procesados para deduplicación
- Existe proceso Relay que publica eventos desde OUTBOX al broker
- El Relay se ejecuta con intervalo no mayor a 1 segundo
- Todos los eventos incluyen campo schema_version
- Todos los eventos tienen esquemas registrados en Schema Registry
1.2 Idempotencia
Verificar que:
- Todo handler de evento verifica Message ID antes de procesar
- La verificación y el procesamiento están en la misma transacción
- Existe test automatizado que envía mismo mensaje 3 veces y verifica resultado único
- Existe limpieza automática de tabla de mensajes procesados
1.3 Compensación
Verificar que:
- Para cada operación de escritura existe handler de compensación
- La compensación es idempotente (puede ejecutarse N veces)
- Existen tests que verifican que compensación revierte el estado
- La compensación emite evento de confirmación
- La compensación se registra en logs de auditoría
1.4 Configuración
Verificar que:
- Todos los parámetros de timeout son configurables externamente
- Valores por defecto cumplen con mínimos del estándar
- Configuración se carga al inicio y se valida
- Cambios de configuración no requieren recompilación
1.5 Observabilidad
Verificar que:
- Todos los logs de saga son estructurados (no texto plano)
- Saga ID se propaga en todos los eventos emitidos
- Todas las métricas mandatorias están implementadas
- Existe dashboard de monitoreo con visualización de métricas
- Existen alertas configuradas para casos anómalos
1.6 Testing
Verificar que:
- Existen tests de happy path completo
- Existen tests de cada escenario de compensación
- Existen tests de race conditions simuladas
- Existen tests de chaos engineering (matar servicio en medio de saga)
- Existe test de duplicación de mensaje
2. Templates de Eventos Estándar
Todos los eventos deben seguir una estructura consistente para facilitar consumo y rastreo.
2.1 Estructura Base de Evento
Todo evento publicado debe incluir tres secciones:
Sección 1 - Metadatos de Rastreo:
- Identificador único del mensaje (UUID)
- Identificador de la saga (UUID)
- Identificador del span actual (UUID)
- Identificador del span padre (UUID o null si es raíz)
- Versión del esquema del evento (formato semántico)
- Timestamp de creación en UTC ISO-8601
- Nombre del servicio que emitió el evento
- Tipo de evento (nombre descriptivo)
Sección 2 - Datos de Negocio (Payload):
- Información específica del dominio
- Solo datos necesarios para los consumidores
- Sin información sensible sin encriptar
- Con tipos de datos explícitos
Sección 3 - Metadatos Adicionales (Opcional):
- Identificador de correlación de negocio
- Identificador del usuario que inició el flujo
- Información de contexto relevante
- Tags o labels para filtrado
2.2 Ejemplo Descriptivo: Evento OrdenSolicitada
Metadatos de rastreo:
- message_id contiene un UUID único generado al crear el evento
- saga_id contiene el identificador de la saga completa de procesamiento de orden
- span_id contiene un UUID único para este evento específico
- parent_span_id contiene null porque este es el evento inicial
- schema_version contiene el string "1.0.0"
- timestamp contiene la fecha y hora de creación en formato ISO-8601 UTC
- source_service contiene el string "pedidos"
- event_type contiene el string "OrdenSolicitada"
Payload de negocio:
- order_id contiene el identificador único de la orden en el sistema de pedidos
- customer_id contiene el identificador del cliente que hizo la orden
- items es una lista de objetos, cada uno contiene:
- sku: código del producto
- quantity: cantidad solicitada (número entero)
- price: precio unitario (número decimal con dos decimales)
- total_amount contiene el monto total de la orden (número decimal)
- shipping_address es un objeto que contiene:
- street: calle
- city: ciudad
- country: país
- postal_code: código postal
- payment_method es un objeto que contiene:
- type: tipo de pago (string: "credit_card", "paypal", etc.)
- token: token de pago tokenizado (NO el número de tarjeta real)
Metadatos adicionales:
- correlation_id contiene un identificador de correlación de negocio (ej: número de orden visible al cliente)
- user_id contiene el identificador del usuario autenticado
- channel contiene el canal de origen: "web", "mobile", "api"
3. Estrategias de Testing
3.1 Tests de Unidad para Idempotencia
Objetivo: Verificar que procesar el mismo evento múltiples veces produce el mismo resultado.
Escenario de test:
- Preparar estado inicial de base de datos
- Crear un evento de prueba con Message ID específico
- Ejecutar handler del evento por primera vez
- Capturar estado resultante de base de datos
- Ejecutar handler del mismo evento (mismo Message ID) por segunda vez
- Verificar que estado de base de datos es idéntico al del paso 4
- Ejecutar handler por tercera vez
- Verificar nuevamente estado idéntico
- Verificar que tabla de mensajes procesados tiene solo UNA entrada para ese Message ID
Resultado esperado:
- Operación de negocio se ejecutó solo una vez
- Llamadas subsecuentes fueron ignoradas
- No hubo duplicación de datos
- No hubo errores
3.2 Tests de Compensación
Objetivo: Verificar que la transacción compensatoria revierte el efecto de la operación original.
Escenario de test para Inventario:
- Estado inicial: Producto SKU-999 tiene 100 unidades
- Publicar evento PagoExitoso para orden de 5 unidades de SKU-999
- Esperar procesamiento
- Verificar: Producto SKU-999 tiene 95 unidades
- Publicar evento FalloAsignacion (trigger de compensación)
- Esperar procesamiento de compensación
- Verificar: Producto SKU-999 tiene 100 unidades nuevamente
- Verificar en logs: Existe entrada de compensación ejecutada
- Verificar: Se emitió evento StockLiberado
Casos adicionales a probar:
- Compensar cuando la operación original nunca ocurrió (compensación debe ser no-op)
- Compensar dos veces (debe ser idempotente)
- Compensar cuando el recurso ya no existe (debe manejarse gracefully)
3.3 Tests de Chaos Engineering
Objetivo: Verificar resiliencia ante fallos de infraestructura.
Escenario 1 - Matar Servicio Después de COMMIT:
- Iniciar saga de prueba
- Instrumentar código para matar proceso inmediatamente después de COMMIT en base de datos pero ANTES de enviar ACK al broker
- Iniciar servicio
- Esperar que saga procese
- Servicio muere
- Verificar: Cambio en BD se persistió
- Verificar: Evento en OUTBOX se persistió
- Reiniciar servicio
- Verificar: Relay publica evento pendiente
- Verificar: Saga continúa normalmente
Escenario 2 - Desconectar Broker Durante Saga:
- Iniciar saga
- Cuando llegue al paso 2, simular desconexión de red al broker
- Verificar: Servicio reintenta con exponential backoff
- Verificar: Eventos quedan pendientes en OUTBOX
- Restaurar conexión después de 2 minutos
- Verificar: Relay publica eventos pendientes
- Verificar: Saga completa exitosamente
Escenario 3 - Latencia Extrema de Base de Datos:
- Simular latencia de 10 segundos en todas las queries de BD
- Iniciar saga
- Verificar: Timeouts se activan correctamente
- Verificar: Mensajes van a DLQ después de reintentos
- Verificar: Se emiten alertas apropiadas
- Verificar: No hay deadlocks ni procesos zombies
3.4 Tests End-to-End de Saga Completa
Objetivo: Verificar flujo completo en ambiente similar a producción.
Infraestructura de test:
- Broker real (Kafka o RabbitMQ dockerizado)
- Bases de datos reales por servicio (PostgreSQL dockerizado)
- Los tres servicios corriendo (Pedidos, Inventario, Pagos)
- Mock de pasarela de pagos externa
Test de Happy Path:
- Insertar datos de prueba en BD de Inventario: SKU-TEST con 50 unidades
- Enviar request HTTP POST a servicio de Pedidos: crear orden de 10 unidades de SKU-TEST
- Esperar máximo 10 segundos
- Verificar en BD de Pedidos: orden existe con estado COMPLETADA
- Verificar en BD de Inventario: SKU-TEST tiene 40 unidades
- Verificar en BD de Pagos: existe registro de transacción aprobada
- Verificar en logs: todos los eventos se emitieron en orden correcto
- Verificar en métricas: saga_duration_seconds registró tiempo total
Test de Fallo y Compensación:
- Configurar mock de pasarela para rechazar pagos
- Insertar datos: SKU-TEST2 con 20 unidades
- Enviar request: crear orden de 5 unidades de SKU-TEST2
- Esperar procesamiento
- Verificar: Orden en estado CANCELADA_PAGO_RECHAZADO
- Verificar: Inventario NO se modificó (sigue en 20 unidades)
- Verificar: NO existe registro de transacción en BD de Pagos
- Verificar en logs: evento PagoRechazado fue emitido
Test de Race Condition:
- Insertar datos: SKU-TEST3 con 1 unidad
- Lanzar DOS requests simultáneos: ambos piden 1 unidad de SKU-TEST3
- Esperar procesamiento
- Verificar: UNA orden en estado COMPLETADA
- Verificar: OTRA orden en estado CANCELADA_CON_REEMBOLSO
- Verificar: Inventario en 0 unidades (solo una asignación exitosa)
- Verificar en logs: evento FalloAsignacion emitido para segunda saga
- Verificar: Mock de pasarela recibió llamada de reembolso
ANEXO A: Architecture Decision Records (ADR)
ADR-001: Prohibición de Two-Phase Commit y XA Transactions
Fecha: 2026-02-01
Estado: Aceptado
Contexto:
En arquitecturas de microservicios distribuidos, la coordinación de transacciones entre múltiples servicios requiere decisiones sobre consistencia vs disponibilidad. El protocolo Two-Phase Commit (2PC) y las transacciones XA ofrecen atomicidad estricta pero con costos significativos.
Decisión:
Se prohíbe el uso de transacciones distribuidas bloqueantes (2PC, XA Transactions) en todo el ecosistema de microservicios. En su lugar, se adopta el patrón Saga con consistencia eventual.
Razones:
Disponibilidad: 2PC requiere que todos los participantes estén disponibles simultáneamente. Si un servicio está caído, toda la transacción se bloquea. En sistemas distribuidos con múltiples servicios, la probabilidad de que algún componente esté temporalmente no disponible es alta.
Latencia: El protocolo requiere múltiples roundtrips de red (prepare, vote, commit). Esto incrementa significativamente la latencia percibida por usuarios finales.
Bloqueos: Los recursos (filas de base de datos) quedan bloqueados durante todo el protocolo. En sistemas de alta concurrencia, esto reduce dramáticamente el throughput.
Complejidad Operacional: Requiere coordinador transaccional centralizado (Transaction Manager) que se convierte en punto único de fallo. La recuperación de fallos en 2PC es compleja y propensa a estados inconsistentes.
Escalabilidad Limitada: No escala horizontalmente bien porque el coordinador se convierte en bottleneck.
Consecuencias:
Positivas:
- Mayor disponibilidad del sistema (cada servicio puede operar independientemente)
- Mejor throughput en operaciones concurrentes (sin bloqueos prolongados)
- Escalabilidad horizontal sin límites de coordinador central
- Resiliencia ante fallos parciales (saga puede progresar aunque un servicio esté caído temporalmente)
Negativas:
- Complejidad lógica incrementada (implementación de compensaciones)
- Ventanas de inconsistencia temporal (datos pueden estar desincronizados por segundos o minutos)
- Mayor complejidad en testing (necesidad de probar escenarios de compensación)
- Debugging más complejo (flujo implícito, necesidad de rastreo distribuido)
Mitigaciones de Consecuencias Negativas:
- Implementar Transactional Outbox Pattern para garantizar publicación de eventos
- Establecer observabilidad robusta con rastreo distribuido
- Documentar claramente lógica de compensación
- Implementar idempotencia estricta en todos los consumidores
- Definir límites de timeout para evitar sagas infinitas
ADR-002: Validación de Inventario Antes de Pago
Fecha: 2026-02-01
Estado: Aceptado
Contexto:
En sistemas de comercio electrónico, existen dos estrategias principales para manejar inventario en el flujo de compra:
- Estrategia A (Pay-First): Cobrar primero, luego verificar/asignar inventario. Si no hay stock, reembolsar.
- Estrategia B (Check-Then-Pay): Verificar inventario primero, luego cobrar solo si hay disponibilidad.
Decisión:
Se adopta la estrategia Check-Then-Pay: validar disponibilidad de inventario ANTES de ejecutar el cobro financiero.
Razones:
Costos Financieros: Cada transacción con pasarela de pagos tiene un costo (típicamente 2.9% + 0.30 USD). Los reembolsos también incurren en costos. La estrategia Pay-First genera costos innecesarios cuando el pedido finalmente se cancela por falta de stock.
Experiencia de Usuario: Los clientes perciben negativamente ser cobrados y luego reembolsados días después. Genera desconfianza y fricción. La estrategia Check-Then-Pay ofrece feedback inmediato sobre disponibilidad.
Complejidad Contable: Los reembolsos complican la contabilidad y reconciliación bancaria. Requieren procesos adicionales de seguimiento.
Carga en Soporte: Clientes cobrados y luego reembolsados generan tickets de soporte preguntando por el cargo temporal.
Trade-offs Considerados:
Ventana de Race Condition: Entre la validación (Fase 2) y la asignación (Fase 4), el inventario puede ser consumido por otra transacción concurrente. Esto resulta en que algunos pagos exitosos requieran reembolso de todos modos.
Latencia Adicional: Agregar paso de validación aumenta latencia total del flujo en aproximadamente 200-500ms.
Mitigación del Race Condition:
- Implementar re-verificación con bloqueo pesimista en Fase 4
- Implementar compensación automática de pago (reembolso) cuando ocurra race condition
- Monitorear tasa de race conditions y ajustar inventario buffer si es muy alta
Consecuencias:
Positivas:
- Reducción del 95% en costos de transacciones fallidas (según estudios de caso de e-commerce)
- Mejor experiencia de usuario (feedback inmediato de falta de stock)
- Menor carga operacional (menos reembolsos manuales)
- Contabilidad más limpia
Negativas:
- Posibilidad de race condition (aproximadamente 5% de casos en alta concurrencia)
- Latencia adicional de 200-500ms por validación previa
- Complejidad de implementar lógica de re-verificación con bloqueo
Métricas de Éxito:
- Tasa de reembolsos por falta de stock < 5%
- Latencia total de checkout < 3 segundos en percentil 95
- Tasa de quejas de clientes por cobros incorrectos < 0.1%
ADR-003: Coreografía con Coordinador de Estado vs Coreografía Pura
Fecha: 2026-02-01
Estado: Aceptado
Contexto:
Las sagas pueden implementarse mediante dos patrones principales:
Coreografía Pura: Cada servicio escucha eventos relevantes y emite eventos de resultado sin conocer el flujo completo. No existe ningún componente central.
Orquestación: Un servicio centralizado (orquestador) coordina toda la saga invocando directamente a participantes y esperando respuestas.
Híbrido (Coreografía con Coordinador de Estado): Servicios se comunican vía eventos (coreografía) pero uno de ellos mantiene estado de la saga para visibilidad y decisiones de alto nivel.
Decisión:
Se adopta el patrón híbrido: Coreografía con Coordinador de Estado opcional. Se prohíbe orquestación tradicional con llamadas síncronas.
Razones a Favor de Coreografía:
- Bajo acoplamiento entre servicios
- Alta escalabilidad y resiliencia
- Facilita evolución independiente de servicios
- No hay punto único de fallo
Razones Contra Coreografía Pura:
- Difícil rastrear estado completo de una saga
- Complejo identificar en qué punto está una transacción de negocio
- No hay lugar obvio para implementar timeouts de saga completa
- Testing end-to-end más complejo
Razones Contra Orquestación Tradicional:
- Orquestador se convierte en bottleneck
- Alto acoplamiento (orquestador conoce todos los servicios)
- Punto único de fallo
- Dificulta escalabilidad horizontal
Solución Híbrida:
Permitir que el servicio iniciador (ej: Pedidos) actúe como Coordinador de Estado con restricciones:
- Puede mantener tabla de estado de saga
- Puede escuchar eventos de progreso
- Puede tomar decisiones de compensación
- NO puede invocar directamente a otros servicios
- NO puede ejecutar lógica de negocio de otros dominios
Consecuencias:
Positivas:
- Mantiene beneficios de coreografía (bajo acoplamiento, escalabilidad)
- Provee visibilidad centralizada de estado de saga
- Facilita implementación de timeouts
- Simplifica queries de estado para usuarios
- Facilita testing y debugging
Negativas:
- Incremento leve de complejidad en servicio coordinador
- Riesgo de que coordinador acumule lógica que debería estar en otros servicios (debe vigilarse en code reviews)
Reglas de Implementación:
- El coordinador solo mantiene estado, no ejecuta lógica de negocio
- Toda comunicación sigue siendo asíncrona vía eventos
- El coordinador es stateless (estado persiste en BD, no en memoria)
- Debe ser posible eliminar el coordinador sin romper el flujo (otros servicios siguen funcionando)
ADR-004: Outbox Pattern como Estándar Obligatorio
Fecha: 2026-02-01
Estado: Aceptado
Contexto:
Al trabajar con microservicios y messaging, existe el problema de Dual Writes: un servicio necesita actualizar su base de datos local Y publicar un evento en el broker. No existe transacción distribuida que abarque ambos sistemas.
Escenarios problemáticos sin Outbox:
- Escenario 1: Servicio actualiza BD, luego intenta publicar en broker, pero broker está caído → Cambio persiste pero evento nunca se publica → Inconsistencia
- Escenario 2: Servicio publica en broker exitosamente, luego intenta commit en BD, pero falla → Evento publicado pero cambio no persiste → Inconsistencia
- Escenario 3: Servicio hace commit en BD, luego proceso muere antes de publicar → Evento perdido → Inconsistencia
Decisión:
Hacer obligatorio el uso de Transactional Outbox Pattern en todos los servicios que participen en sagas.
Razones:
Atomicidad Garantizada: La tabla OUTBOX está en la misma base de datos que las tablas de negocio. Un commit atómico garantiza que ambos (cambio de negocio + evento) se persistan juntos o ninguno se persista.
Resiliencia ante Fallos: Si el proceso muere después del commit pero antes de publicar, el Relay independiente eventualmente publicará el evento pendiente.
Simplicidad Conceptual: La lógica de negocio se simplifica: solo se preocupa por persistir en BD local. La publicación en broker es responsabilidad del Relay.
Debugging Facilitado: Todos los eventos a publicar quedan registrados en una tabla. Se puede auditar qué eventos se publicaron, cuándo, cuántos intentos tomó, etc.
Implementaciones Consideradas:
Opción A - Polling: Proceso que consulta tabla OUTBOX periódicamente
- Pros: Simple de implementar, funciona con cualquier BD
- Contras: Latencia adicional (según intervalo de polling)
Opción B - Change Data Capture (CDC): Herramienta lee transaction log de BD
- Pros: Latencia mínima (casi real-time), no impacta rendimiento de BD
- Contras: Requiere herramienta adicional (Debezium), complejidad operacional
Opción C - Triggers de BD: Trigger que publica al insertar en OUTBOX
- Pros: Latencia cero
- Contras: Acopla BD con broker, dificulta testing, problemas de resiliencia
Decisión de Implementación:
- Opción A (Polling) es mandatoria para todos los servicios
- Opción B (CDC) es recomendada para servicios críticos de alto volumen
- Opción C (Triggers) está prohibida por acoplamiento
Consecuencias:
Positivas:
- Cero pérdida de eventos
- Garantía de atomicidad entre cambio de negocio y publicación
- Resiliencia ante fallos de broker o red
- Auditoría completa de eventos
Negativas:
- Latencia adicional (100-500ms típicamente con polling)
- Necesidad de proceso Relay adicional
- Tabla OUTBOX crece y requiere limpieza
- Complejidad adicional en infraestructura
Mitigaciones:
- Optimizar intervalo de polling (100-500ms es aceptable)
- Implementar limpieza automática de eventos publicados después de 7 días
- Usar índices apropiados en tabla OUTBOX para queries eficientes
- Monitorear tamaño de OUTBOX y alertar si crece anormalmente
ANEXO B: Glosario de Términos
BASE: Modelo de consistencia para sistemas distribuidos. Acrónimo de Basically Available (Básicamente Disponible), Soft state (Estado Suave), Eventually consistent (Eventualmente Consistente). Contrasta con ACID.
Broker de Mensajes: Sistema intermediario que facilita comunicación asíncrona entre servicios mediante colas y topics. Ejemplos: Kafka, RabbitMQ.
Change Data Capture (CDC): Técnica para detectar y capturar cambios en base de datos mediante lectura del transaction log. Usado para publicar eventos sin Dual Write Problem.
Compensación: Transacción lógicamente inversa que deshace o mitiga el efecto de una operación previamente confirmada. Ejemplo: Si se cargó una tarjeta, la compensación es reembolsar.
Consistencia Eventual: Propiedad de sistemas distribuidos donde, en ausencia de nuevas actualizaciones, eventualmente todas las réplicas convergerán al mismo estado. No garantiza cuándo ocurrirá.
Coreografía: Patrón de saga donde cada servicio escucha eventos relevantes y reacciona autónomamente sin coordinación central. Comparable a bailarines que siguen música sin director.
Correlation ID: Identificador único que se propaga a través de múltiples servicios y operaciones para rastrear una transacción de negocio completa en logs y métricas distribuidos.
Dead Letter Queue (DLQ): Cola especial donde se envían mensajes que fallaron repetidamente después de múltiples intentos de procesamiento. Permite análisis y reprocesamiento manual.
Dual Write Problem: Problema de consistencia que ocurre al intentar escribir en dos sistemas diferentes (ej: base de datos + message broker) sin transacción atómica que abarque ambos.
Exponential Backoff: Estrategia de reintentos donde el tiempo de espera entre intentos crece exponencialmente. Ejemplo: 1s, 2s, 4s, 8s, 16s. Previene sobrecarga durante fallos.
Idempotencia: Propiedad de una operación que puede ejecutarse múltiples veces sin cambiar el resultado más allá de la primera ejecución. Ejemplo: "Establecer X = 5" es idempotente, "Incrementar X" no lo es.
Message Broker: Ver Broker de Mensajes.
Orquestación: Patrón de saga donde un componente central (orquestador) coordina explícitamente todos los pasos invocando a participantes y esperando respuestas.
Outbox Pattern: Ver Transactional Outbox Pattern.
Race Condition: Situación donde el resultado de una operación depende del tiempo relativo de eventos concurrentes. Ejemplo: dos transacciones leyendo el mismo inventario antes de que cualquiera lo actualice.
Relay: Proceso que lee eventos de la tabla OUTBOX y los publica en el message broker. Puede ser implementado via polling o CDC.
Saga: Patrón de diseño para manejar transacciones distribuidas mediante secuencia de transacciones locales coordinadas por eventos, con compensaciones para revertir en caso de fallo.
Schema Registry: Servicio centralizado que almacena y versiona esquemas de eventos/mensajes. Permite validación de compatibilidad y generación de documentación.
Semantic Lock: Bloqueo lógico a nivel de negocio (no de base de datos) que marca un recurso como "reservado temporalmente" con TTL, permitiendo alta concurrencia.
Span: En rastreo distribuido, representa una unidad de trabajo individual. Una saga completa contiene múltiples spans (uno por cada paso/evento).
Timeout: Límite de tiempo máximo para esperar una respuesta o completar una operación. Previene esperas infinitas ante fallos.
Transactional Outbox Pattern: Patrón que resuelve Dual Write Problem insertando eventos en tabla local (OUTBOX) dentro de la misma transacción de negocio, para luego publicarlos asíncronamente.
TTL (Time To Live): Tiempo de vida de un recurso o dato después del cual expira automáticamente. Usado en Semantic Locks para liberar reservas no confirmadas.
Two-Phase Commit (2PC): Protocolo de transacciones distribuidas bloqueantes que garantiza atomicidad mediante fase de preparación y fase de commit. Prohibido en este estándar.
ANEXO C: Referencias y Recursos
Documentación Técnica Recomendada
Libros:
- "Designing Data-Intensive Applications" por Martin Kleppmann - Capítulos 7-9 sobre transacciones distribuidas y consistencia
- "Microservices Patterns" por Chris Richardson - Capítulo 4 completo sobre Sagas
- "Building Microservices" por Sam Newman - Segunda edición, capítulo sobre workflows y consistencia
Papers Académicos:
- "Sagas" por Hector Garcia-Molina y Kenneth Salem (1987) - Paper original que define el patrón
- "Life beyond Distributed Transactions: an Apostate's Opinion" por Pat Helland - Argumentos contra transacciones distribuidas
- "Building on Quicksand" por Pat Helland y Dave Campbell - Fundamentos de consistencia eventual
Recursos Online:
- Microservices.io - Patrón Saga: https://microservices.io/patterns/data/saga.html
- Documentación de Debezium para CDC: https://debezium.io
- Confluent Schema Registry documentation: https://docs.confluent.io/platform/current/schema-registry/
Bibliotecas y Frameworks Recomendados
Para Java/JVM:
- Eventuate Tram Saga Framework - Framework especializado en sagas con outbox pattern
- Axon Framework - CQRS y Event Sourcing con soporte para sagas
- Apache Camel - Integración con múltiples brokers y patrones de mensajería
Para .NET:
- MassTransit - Framework de messaging con soporte nativo para sagas
- NServiceBus - Bus de servicios con soporte para sagas de larga duración
- Rebus - Bus de mensajes ligero con soporte para sagas
Para Node.js:
- Moleculer - Framework de microservicios con soporte para sagas
- NestJS con Bull - Soporte para colas y workflows complejos
Para Python:
- Nameko - Framework de microservicios con soporte para eventos
- Celery - Sistema de colas distribuidas con soporte para workflows
Herramientas de Observabilidad
Rastreo Distribuido:
- Jaeger - Sistema open-source de rastreo distribuido
- Zipkin - Rastreo distribuido con múltiples integraciones
- AWS X-Ray - Servicio administrado de AWS para rastreo
- Google Cloud Trace - Servicio de rastreo para GCP
Logging:
- ELK Stack (Elasticsearch, Logstash, Kibana) - Stack completo de logging
- Grafana Loki - Sistema de agregación de logs
- Splunk - Plataforma enterprise de análisis de logs
Métricas:
- Prometheus - Sistema de métricas con modelo pull
- Grafana - Visualización de métricas
- Datadog - Plataforma SaaS completa de observabilidad
Comunidades y Foros
- CNCF Slack - Canal #microservices
- Stack Overflow - Tag "saga-pattern" y "distributed-transactions"
- Reddit r/microservices
- DDD/CQRS Google Group
FIN DEL DOCUMENTO
Última Actualización: Febrero 2026
Próxima Revisión: Agosto 2026
Responsable: Equipo de Arquitectura Empresarial
Contacto: [email protected]
Arquitectura distribuida y el abandono consciente de ACID
- Mauricio ECR
- Arquitectura
- 14 Feb, 2026
En el mundo de los sistemas distribuidos, hay una verdad incómoda que enfrentamos tarde o temprano: no podemos tenerlo todo. La promesa de las transacciones ACID tradicionales —esa garantía tranquiliz

Arquitectura distribuida y el abandono consciente de ACID
- Mauricio ECR
- Arquitectura
- 14 Feb, 2026
En el mundo de los sistemas distribuidos, hay una verdad incómoda que enfrentamos tarde o temprano: no podemos tenerlo todo. La promesa de las transacciones ACID tradicionales —esa garantía tranquilizadora de que nuestros datos siempre estarán perfectamente sincronizados— se desvanece en el momento en que decidimos distribuir nuestra aplicación monolítica en múltiples servicios independientes. Es un momento de madurez arquitectónica que muchos equipos experimentan con cierta resistencia, similar a cuando un adolescente comprende que el mundo no es tan simple como parecía en la infancia.
Esta transformación no es meramente técnica; representa un cambio filosófico en cómo concebimos la consistencia de datos. Abandonamos el confort de las transacciones atómicas inmediatas, donde todo sucede o nada sucede en un instante perfecto, y abrazamos algo más orgánico, más real: la consistencia eventual. Los datos pueden estar temporalmente desalineados entre servicios, como músicos de una orqestra que momentáneamente pierden el compás para luego reconectarse con la melodía principal. La belleza de este modelo —conocido como BASE (Basically Available, Soft state, Eventually consistent)— radica en su pragmatismo: el sistema responde incluso cuando algunos servicios están caídos, los eventos se persisten antes de considerarse publicados, y eventualmente, con la paciencia de un jardinero que espera la floración, el sistema converge hacia un estado consistente.
El Arte de la Coreografía Distribuida
Imagina un ballet donde los bailarines no siguen a un director de orquesta central, sino que responden a las acciones de sus compañeros de manera autónoma. Este es el corazón del patrón Saga basado en coreografía. Cada servicio actúa como un participante independiente que escucha eventos relevantes de su dominio, ejecuta su lógica de negocio local, publica eventos de resultado y —esto es crucial— no tiene conocimiento completo de qué otros servicios participan en el proceso general.
Esta autonomía trae consigo ventajas significativas: bajo acoplamiento entre servicios, alta escalabilidad y la ausencia de un punto único de fallo. Pero también presenta desafíos genuinos. El flujo completo de la transacción se vuelve implícito, emergente de las interacciones locales, lo que puede hacer que la depuración se asemeje a seguir las huellas de un animal esquivo en el bosque. La complejidad en el rastreo es real, y no debemos minimizarla.
Para contextos donde necesitamos mayor visibilidad del flujo completo, existe una alternativa complementaria: la orquestación ligera de estado. Aquí, un servicio actúa como coordinador de estado —no como un tirano centralizado que comanda cada movimiento, sino como un observador atento que rastrea el progreso, mantiene una tabla de estado de la saga, escucha todos los eventos relevantes y puede tomar decisiones de cancelación cuando sea necesario. La distinción es sutil pero fundamental: el coordinador observa y reacciona, no comanda y espera. La comunicación sigue siendo asíncrona mediante el bus de eventos, preservando así los beneficios de la arquitectura desacoplada.
Hay, por supuesto, caminos que debemos evitar absolutamente. El Two-Phase Commit (2PC) y las transacciones XA, que extienden transacciones de base de datos entre servicios, están prohibidos debido a los bloqueos prolongados que generan y la baja disponibilidad resultante. Los bloqueos distribuidos compartidos entre servicios son igualmente problemáticos, con la excepción de los bloqueos semánticos de negocio que discutiremos más adelante. Las llamadas síncronas en flujos críticos —HTTP, REST, gRPC— deben reservarse exclusivamente para consultas de solo lectura, nunca para comandos que modifican estado en el contexto de una saga.
El Problema Dual Write y su Solución Elegante
Uno de los desafíos más insidiosos en sistemas distribuidos es el "Dual Write Problem". El escenario es simple pero traicionero: un servicio necesita actualizar su base de datos local y publicar un evento en el broker de mensajería. Si la publicación falla después del commit de la base de datos, el sistema queda inconsistente. Si falla antes, perdemos el evento y el flujo se interrumpe sin que nadie lo sepa.
La solución a este dilema es el patrón Transactional Outbox, una técnica elegante que convierte un problema de coordinación distribuida en dos problemas locales secuenciales. La regla de oro es simple: un servicio nunca debe publicar directamente en el broker dentro de su código de negocio. En su lugar, la operación se divide en dos fases distintas.
La primera fase es una transacción atómica local donde todo sucede dentro de los límites seguros de una sola base de datos. Iniciamos la transacción, ejecutamos nuestra operación de negocio —quizás un INSERT, UPDATE o DELETE en las tablas de dominio— e inmediatamente después insertamos el evento que queremos publicar en una tabla especial llamada OUTBOX. Finalmente, confirmamos la transacción completa. El punto crítico aquí es que ambas escrituras están protegidas por el mismo commit atómico: o ambas suceden, o ninguna sucede.
La segunda fase es completamente asíncrona y resiliente. Un proceso independiente —típicamente llamado Relay o Publisher— lee continuamente la tabla OUTBOX, encuentra eventos pendientes, los publica en el broker y los marca como publicados o los elimina. Este proceso puede fallar, reintentar, detenerse y reiniciarse sin comprometer la integridad de nuestros datos, porque la fuente de verdad —la tabla OUTBOX— está segura en nuestra base de datos.
La estructura de la tabla OUTBOX debe incluir campos obligatorios que garanticen su funcionamiento correcto: un identificador único del mensaje (típicamente un UUID), el tipo de evento de dominio, el cuerpo del evento serializado, timestamp de creación, estado de publicación (pendiente, publicado, fallido), número de intentos, el agregado raíz asociado para ordenamiento, y la versión del esquema del evento.
Para implementar el proceso de relay tenemos tres opciones principales. El polling tradicional es simple y confiable: un proceso consulta periódicamente la tabla OUTBOX —recomendamos intervalos de 100 a 500 milisegundos— publica eventos pendientes ordenados por timestamp y los marca como publicados tras confirmación del broker. Change Data Capture (CDC) es más sofisticado: herramientas como Debezium, Maxwell o AWS DMS leen el transaction log de la base de datos, detectan inserts en OUTBOX en tiempo real y publican automáticamente en el broker. Los triggers de base de datos son la opción menos recomendada debido al acoplamiento que generan y su menor resiliencia, aunque técnicamente funcional: un trigger se activa al insertar en OUTBOX e invoca un procedimiento que publica en el broker.
Idempotencia: El Escudo Contra la Duplicación
Aquí nos encontramos con otra verdad incómoda de los sistemas distribuidos: los brokers de mensajería garantizan entrega "al menos una vez", lo que significa que inevitablemente algunos mensajes llegarán duplicados. No es un error del broker, es una característica inherente a sistemas que priorizan la disponibilidad sobre la consistencia perfecta. Por tanto, todo consumidor de eventos debe ser idempotente.
La definición es directa pero profunda: una operación es idempotente si ejecutarla múltiples veces produce el mismo resultado que ejecutarla una sola vez. Es como presionar el botón del elevador repetidamente —el elevador viene una sola vez, sin importar cuántas veces presionamos el botón. Cada servicio debe mantener una tabla dedicada de mensajes procesados con el identificador del mensaje como clave primaria, el tipo de evento procesado, timestamp de procesamiento, estado final (éxito o fallo) y un índice en timestamp para limpieza periódica.
El flujo de procesamiento idempotente se convierte en un ritual casi ceremonial. Al recibir un mensaje del broker, iniciamos una transacción de base de datos local e intentamos insertar el identificador del mensaje en la tabla de registro. Si la inserción falla por clave duplicada, sabemos que este mensaje ya fue procesado anteriormente: hacemos rollback y retornamos éxito al broker sin ejecutar nada. Si la inserción es exitosa, procedemos con la lógica de negocio, potencialmente insertamos un evento resultante en nuestra tabla OUTBOX, confirmamos la transacción completa y enviamos ACK al broker. Como medida de higiene, eliminamos registros con más de siete días de antigüedad mediante un proceso nocturno.
La Danza de la Compensación
Cuando las cosas van mal en un sistema distribuido —y eventualmente lo harán— necesitamos una estrategia para deshacer operaciones que ya fueron confirmadas. Aquí entra el concepto de transacción compensatoria: una acción lógicamente inversa que deshace o mitiga el efecto de una operación previamente confirmada.
Los ejemplos son intuitivos una vez que comprendemos el patrón. CrearPedido se compensa con AnularPedido. ReservarInventario con LiberarReserva. CobrarPago con ReembolsarPago. EnviarNotificacion con EnviarNotificacionCorreccion. AsignarRecurso con DesasignarRecurso. Pero la compensación no siempre es perfecta en el sentido matemático de restaurar el estado exacto anterior.
Existen tres tipos de compensación, cada uno con su propia filosofía. La compensación perfecta restaura el estado exacto anterior —como cancelar una reserva que aún no ha sido utilizada. La compensación aproximada restaura un estado equivalente pero no idéntico —como ofrecer un reembolso en créditos de la tienda en lugar de dinero, cuando ambos tienen valor similar para el cliente. La compensación simbólica es la más interesante: registra el intento de reversión cuando la compensación real es físicamente imposible. No podemos "des-enviar" un email una vez que salió, pero podemos enviar un email de corrección o aclaración.
Las compensaciones deben ser idempotentes (pueden ejecutarse múltiples veces sin efectos adversos), deben registrarse en logs de auditoría para trazabilidad, y deben emitir eventos de compensación para que otros servicios puedan reaccionar apropiadamente.
El Arte del Reintento Inteligente
No todos los errores son creados iguales. Esta distinción es fundamental para implementar una estrategia de reintentos efectiva. Los fallos transitorios son errores temporales que pueden resolverse reintentando: pérdida de conexión de red, timeouts de base de datos por carga momentánea, un servicio dependiente temporalmente no disponible, o límites de rate limiting alcanzados. Los fallos permanentes no se resolverán sin intervención humana o cambios en el código: validaciones de negocio fallidas, datos malformados o incompletos, violaciones de reglas de dominio, permisos insuficientes, o recursos no encontrados.
Para fallos transitorios implementamos exponential backoff con jitter. La progresión es elegante: empezamos con una espera inicial de 500 milisegundos entre el primer y segundo intento, luego multiplicamos por un factor de 2 en cada intento subsecuente, con un techo máximo de 60 segundos entre intentos y un límite de 5 intentos totales. Añadimos jitter aleatorio —una variación del 10-25%— para evitar el fenómeno de "thundering herd" donde múltiples procesos reintentan simultáneamente, creando picos de carga que agravan el problema original. La progresión típica sería: 500ms → 1s → 2s → 4s → 8s → Dead Letter Queue.
La Dead Letter Queue (DLQ) es nuestro hospital para mensajes enfermos. Después de agotar los reintentos automáticos, el mensaje se envía a esta cola especial donde espera análisis manual posterior, genera alertas al equipo de operaciones, puede ser reprocesado manualmente tras corrección del problema subyacente, y sirve para auditoría de fallos recurrentes. Los mensajes en DLQ deben preservar información forense completa: el mensaje original completo, número de intentos realizados, timestamps de cada intento, detalles de cada error ocurrido, y el trace completo del último error.
Evolución sin Ruptura: El Versionado de Contratos
Los sistemas vivos evolucionan, y los contratos entre servicios deben evolucionar con ellos sin romper el ecosistema existente. Todo evento de dominio publicado debe tener un esquema formal —Avro, Protocol Buffers o JSON Schema— que defina nombre y tipo de cada campo, campos obligatorios versus opcionales, tipos de datos permitidos, restricciones de validación, y descripción semántica de cada campo.
El versionado semántico se convierte en nuestra brújula. Cada evento incluye un campo "schema_version" con formato MAJOR.MINOR.PATCH. Un cambio MAJOR indica incompatibilidad que requiere actualización del consumidor: eliminar campos, cambiar tipos de datos existentes, cambiar la semántica de un campo, o renombrar campos. Un cambio MINOR representa adiciones retrocompatibles: agregar nuevos campos opcionales, agregar nuevos valores a enumeraciones, o deprecar campos sin eliminarlos. Un PATCH es para correcciones menores sin impacto funcional: corregir descripciones, mejorar documentación, o corregir typos en nombres.
Para cambios aditivos (Minor o Patch), agregamos solo campos opcionales con valores por defecto. Los consumidores antiguos ignoran campos nuevos que no conocen, los productores nuevos toleran consumidores antiguos, y no se requiere coordinación de despliegue. Es evolución pacífica y gradual.
Para cambios breaking (Major), necesitamos una estrategia más cuidadosa. Creamos un nuevo tipo de evento con sufijo de versión —por ejemplo, "OrdenSolicitada_v2"— y mantenemos publicación dual por un período de transición. El productor emite tanto el evento v1 como el v2, permitiendo que los consumidores migren gradualmente. El período mínimo de convivencia es 90 días calendario. Solo después de este período podemos deprecar y eventualmente eliminar la versión antigua.
La política de deprecación es deliberadamente conservadora: anunciamos la deprecación con 90 días de anticipación, añadimos warnings en logs cuando se use la versión antigua, publicamos métricas de uso de versiones obsoletas, coordinamos la migración con todos los equipos consumidores, y eliminamos soporte solo cuando el uso sea cero por 30 días consecutivos. Es un proceso tedioso, sí, pero necesario para la salud del ecosistema.
Observabilidad: Iluminando la Caja Negra
Un sistema distribuido sin observabilidad es como navegar un barco en niebla densa sin instrumentos. El rastreo distribuido nos permite seguir el viaje completo de una transacción a través de múltiples servicios. El servicio que inicia una saga genera un Saga ID —un identificador global único, típicamente UUID versión 4— que representa toda la transacción distribuida. Este ID se genera una sola vez al inicio y se propaga sin cambios a través de todos los pasos subsecuentes.
Adicionalmente, cada servicio que procesa genera su propio Span ID —un identificador único para ese paso específico— y mantiene referencia al Parent Span ID del paso anterior, creando así una jerarquía de trazas como un árbol genealógico de operaciones. Estos identificadores viajan como headers en todos los mensajes: "X-Saga-ID", "X-Span-ID" y "X-Parent-Span-ID". Los servicios intermedios preservan el Saga ID sin modificarlo, generan su propio Span ID, copian el Span ID recibido como su Parent Span ID, y propagan estos tres valores en todos los eventos que emitan.
El logging estructurado es nuestra memoria colectiva. Cada entrada de log relacionada con procesamiento de eventos debe incluir campos mandatorios de contexto —identificador de saga, tipo de evento, versión del esquema, nombre del servicio, timestamp en ISO-8601 con zona horaria UTC, identificador del span actual y padre— junto con campos mandatorios de resultado: estado del procesamiento (RECEIVED, PROCESSING, SUCCESS, FAILED, COMPENSATING, COMPENSATED), duración en milisegundos de la operación, y número de intento para reintentos.
Las métricas son nuestros sensores vitales. saga_duration_seconds es un histograma que mide el tiempo total desde inicio hasta conclusión, etiquetado por tipo de saga y estado final. saga_step_errors_total es un contador acumulativo de fallos al procesar eventos, etiquetado por nombre de servicio, tipo de evento y tipo de error. saga_compensations_total cuenta las transacciones compensatorias ejecutadas. outbox_pending_messages es un gauge que muestra cuántos eventos están pendientes de publicar en cada servicio. dlq_messages_total indica la cantidad de mensajes problemáticos en Dead Letter Queue.
Para procesos críticos de negocio mantenemos tablas de auditoría completas con todos los cambios de estado de la saga, timestamp de cada transición, razón del cambio (evento que lo provocó), usuario o sistema responsable del inicio, y datos relevantes de negocio. La retención mínima sigue políticas regulatorias, típicamente siete años para sectores financieros.
Límites Temporales y la Paciencia del Sistema
Todo proceso distribuido debe tener límites temporales claramente definidos. No podemos esperar indefinidamente. Los parámetros configurables son nuestra red de seguridad: número máximo de intentos antes de enviar a DLQ (recomendamos 5 intentos con mínimo de 3), espera inicial entre primer y segundo intento (recomendamos 500 milisegundos con mínimo de 100), espera máxima entre intentos (recomendamos 60 segundos con mínimo de 30), timeout de saga completa (recomendamos 24 horas con mínimo de 1 hora, ajustable según naturaleza del proceso), y timeout por paso individual (recomendamos 5 minutos con mínimo de 30 segundos).
La filosofía de timeouts tiene dos niveles. Para timeouts de paso individual, si un evento esperado no llega dentro del plazo configurado, el coordinador emite un evento de timeout, inicia proceso de compensación, registra en logs con nivel ERROR e incrementa métricas de timeouts. Para timeouts de saga completa, si la saga no se completa dentro del plazo total, ejecutamos compensación automática de todos los pasos confirmados, marcamos la saga con estado TIMED_OUT, emitimos evento de saga expirada para auditoría, notificamos al usuario o sistema iniciador del fallo, y generamos alerta para el equipo de operaciones. Crucialmente, no eliminamos datos de auditoría —los mantenemos para análisis post-mortem.
Las alertas obligatorias actúan como sistema de alerta temprana: si el porcentaje de sagas fallidas supera 5% en ventana de 15 minutos, si el tiempo promedio supera el doble del baseline histórico, si la cantidad de mensajes en DLQ supera 10 por servicio, si hay mensajes en OUTBOX pendientes por más de 10 minutos, o si una saga individual supera el 80% del timeout configurado. Cada alerta tiene su nivel de severidad: CRITICAL para flujos de negocio críticos como pagos y pedidos, HIGH para funcionalidad importante pero no crítica, MEDIUM para degradación de rendimiento sin pérdida de funcionalidad, y LOW para anomalías sin impacto inmediato.
Del Concepto a la Realidad: Un Caso Práctico
La teoría cobra vida cuando la aplicamos a un caso concreto. Consideremos un sistema de comercio electrónico donde necesitamos procesar una orden de compra asegurando disponibilidad de inventario antes de ejecutar el cobro. El objetivo es claro: minimizar reembolsos por falta de stock, reducir costos de transacciones bancarias fallidas, y mejorar la experiencia del cliente evitando cobros seguidos de reembolsos inmediatos.
Nuestra estrategia es Check-Then-Act: verificación antes de acción financiera. El proceso se divide en cuatro fases secuenciales, cada una con su propósito específico. En la fase de intención, registramos la orden inicial con estado PENDIENTE_VALIDACION y emitimos el evento OrdenSolicitada. En la fase de validación, consultamos disponibilidad de inventario sin realizar ninguna reserva —es una operación de lectura pura, sin bloqueos— que resulta en StockVerificado o StockNoDisponible. En la fase de cobro condicional, ejecutamos la transacción financiera solo si la fase anterior fue exitosa, resultando en PagoExitoso o PagoRechazado. Finalmente, en la fase de asignación con bloqueo, realizamos el descuento definitivo de inventario con un UPDATE que usa bloqueo pesimista, resultando en StockAsignado o FalloAsignacion.
Tres servicios orquestan este ballet: el Gestor de Pedidos actúa como coordinador de estado, el Gestor de Inventario participa en dos momentos diferentes (validación y asignación), y el Procesador de Pagos actúa como intermediario financiero condicional.
El Gestor de Pedidos mantiene la máquina de estados de la orden. Cuando está en estado PENDIENTE_VALIDACION y recibe StockVerificado, transiciona a PENDIENTE_PAGO. Si recibe StockNoDisponible, va directamente a CANCELADA_SIN_STOCK y el flujo termina. Desde PENDIENTE_PAGO, al recibir PagoExitoso transiciona a PENDIENTE_ASIGNACION, pero si recibe PagoRechazado va a CANCELADA_PAGO_RECHAZADO. Finalmente, desde PENDIENTE_ASIGNACION, StockAsignado lleva a COMPLETADA (el flujo exitoso), mientras que FalloAsignacion resulta en CANCELADA_CON_REEMBOLSO y requiere compensación.
El Gestor de Inventario tiene una doble vida fascinante. En el momento de validación, al escuchar OrdenSolicitada, simplemente consulta disponibilidad actual sin tocar nada. Es como asomarse a la despensa para ver si hay suficiente harina sin tomar nada todavía. Si hay stock suficiente para todos los ítems, emite StockVerificado. Si algún ítem no tiene stock suficiente, emite StockNoDisponible con detalles. En el momento de asignación, al escuchar PagoExitoso, la cosa se pone seria: inicia una transacción con bloqueo pesimista (SELECT FOR UPDATE), re-verifica disponibilidad actual —que puede haber cambiado desde la validación inicial— descuenta las unidades si aún hay stock, y confirma transacción o hace rollback según el resultado.
Esta re-verificación en la fase de asignación es crítica. Durante el tiempo transcurrido entre la validación optimista (fase 2) y la asignación pesimista (fase 4), otra transacción concurrente podría haber consumido ese stock. El bloqueo pesimista en la fase 4 garantiza que, una vez que obtenemos el lock, nadie más puede modificar esos registros hasta que terminemos.
El Procesador de Pagos es deliberadamente ciego a OrdenSolicitada. Solo reacciona a StockVerificado, lo que previene cobros innecesarios cuando no hay stock disponible. Al recibir StockVerificado, valida que el evento no fue procesado previamente (idempotencia), extrae datos de pago, llama a la API de la pasarela con timeout de 30 segundos, y maneja la respuesta apropiadamente. Si la pasarela aprueba, almacena el ID de transacción e inserta PagoExitoso en OUTBOX. Si hay rechazo por fondos insuficientes o tarjeta inválida, inserta PagoRechazado. Si hay timeout o error de red, aplica la política de reintentos con exponential backoff, y tras agotar intentos envía a DLQ para revisión manual.
La compensación en Pagos es igualmente importante. Al recibir FalloAsignacion, extrae el Saga ID para identificar la transacción financiera original, busca en su base de datos local el ID de transacción de la pasarela, llama a la API de reembolso, y si es exitoso inserta ReembolsoEjecutado en OUTBOX. Si el reembolso falla, reintenta con backoff exponencial, y tras 5 intentos fallidos envía alerta crítica al equipo de finanzas y marca para reembolso manual.
Tres Historias, Tres Destinos
El flujo exitoso —el happy path que todos queremos ver— es casi poético en su simplicidad. Un cliente solicita 1 unidad del producto SKU-123. El inventario actual tiene 10 unidades disponibles. No hay operaciones concurrentes. El cliente envía su solicitud HTTP POST, Pedidos crea el registro con estado PENDIENTE_VALIDACION, genera un Saga ID único, inserta OrdenSolicitada en OUTBOX. El relay publica el evento. Inventario lo consume, consulta la base de datos, verifica que hay 10 unidades y el pedido requiere solo 1, inserta StockVerificado en OUTBOX. Pagos consume StockVerificado, invoca la API de la pasarela que aprueba el cobro, inserta PagoExitoso. Inventario consume PagoExitoso, inicia transacción con bloqueo pesimista, re-verifica que aún hay stock, ejecuta el UPDATE restando 1 unidad, inserta StockAsignado, confirma la transacción. Pedidos consume StockAsignado, actualiza estado a COMPLETADA, emite OrdenCompletada, y notifica al cliente. Todo el proceso toma aproximadamente 2-5 segundos. Elegante, eficiente, exitoso.
El fallo temprano es igualmente instructivo. Un cliente solicita 5 unidades del producto SKU-456. El inventario actual tiene 0 unidades. Pedidos crea la orden y emite OrdenSolicitada. Inventario consulta, verifica que hay 0 unidades pero el pedido requiere 5, inmediatamente inserta StockNoDisponible en OUTBOX. Pedidos consume este evento, actualiza estado a CANCELADA_SIN_STOCK, emite OrdenCancelada, y notifica al cliente que el producto está agotado. Lo crucial aquí es que el servicio de Pagos nunca se entera de nada —no escucha StockNoDisponible— por tanto no se ejecuta ninguna operación financiera. No hay cargos, no hay reembolsos. La orden se cancela en menos de 1 segundo. El costo financiero es cero. Esta arquitectura evita aproximadamente el 95% de reembolsos comparado con estrategias de "cobrar primero, verificar después".
El fallo tardío —la race condition— es donde el diseño realmente brilla. Cliente A solicita 1 unidad del producto SKU-789. Inventario actual: 1 unidad disponible. Cliente B también solicita 1 unidad del mismo producto simultáneamente. Ambos pasan la validación optimista porque en ese momento había 1 unidad disponible. Ambos son cobrados exitosamente por la pasarela de pagos. Pero en la fase de asignación, solo uno puede ganar.
Digamos que Cliente A llega primero a la fase de asignación. Inventario inicia transacción con SELECT FOR UPDATE, obtiene el lock, lee 1 unidad disponible, valida que 1 >= 1, ejecuta UPDATE restando la unidad, deja el inventario en 0, inserta StockAsignado, confirma. Cliente A recibe su orden completa. Segundos después, Cliente B llega a la fase de asignación. Inventario inicia otra transacción con SELECT FOR UPDATE, obtiene el lock (Cliente A ya liberó el lock al hacer COMMIT), pero ahora lee 0 unidades disponibles, valida que 0 < 1, la validación falla, no ejecuta el UPDATE, pero —esto es crucial— sí confirma la transacción para que el evento FalloAsignacion se publique correctamente.
Pagos consume FalloAsignacion para Cliente B, busca la transacción original que había aprobado, invoca la API de reembolso de la pasarela, recibe confirmación, inserta ReembolsoEjecutado. Pedidos consume este evento, actualiza estado a CANCELADA_CON_REEMBOLSO, y notifica a Cliente B que su pago ha sido reembolsado porque el producto se agotó durante el proceso. Cliente A tiene su orden completada, Cliente B tiene su dinero de vuelta automáticamente, el sistema mantuvo consistencia a pesar de la concurrencia, y crucialmente, no hubo sobreventa (overselling).
Este escenario demuestra por qué la verificación en fase 2 es optimista (sin bloqueo) y la asignación en fase 4 es pesimista (con bloqueo). Si bloqueáramos en la fase de validación, tendríamos alta contención —cada consulta de disponibilidad bloquearía las filas, forzando a otras transacciones a esperar. El bloqueo tardío minimiza la ventana crítica a solo el momento de la asignación definitiva.
Consideraciones Finales de Implementación
El ordenamiento de eventos merece atención especial. Los brokers garantizan orden dentro de una partición, no globalmente. La solución es particionar eventos por Saga ID, asegurando que todos los eventos de una misma saga vayan a la misma partición. Configuramos la clave de partición como el Saga ID. Esto garantiza que eventos de una orden específica se procesen en orden correcto, aunque no importa el orden entre órdenes diferentes —cada orden es independiente.
El manejo de duplicados es un ritual bien definido. Cuando llega un evento PagoExitoso al servicio de Inventario, extraemos el Message ID del header, iniciamos una transacción, e intentamos insertar ese ID en la tabla processed_messages. Si la inserción falla por clave duplicada, sabemos que este mensaje ya fue procesado: hacemos rollback, retornamos ACK al broker sin hacer nada más, y registramos en logs "Evento duplicado ignorado". Si la inserción es exitosa, procedemos con la lógica de asignación de stock, y el COMMIT incluye tanto la nueva fila en processed_messages como el UPDATE de inventario. Ambos cambios o ninguno —atomicidad local garantizada.
La consistencia de OUTBOX es una garantía crítica inviolable: el evento en OUTBOX y el cambio de estado de negocio deben confirmarse en la misma transacción atómica de base de datos. Por ejemplo, cuando Pedidos recibe StockVerificado, en una sola transacción ejecuta UPDATE de la orden cambiando estado a PENDIENTE_PAGO e INSERT en OUTBOX del evento OrdenActualizada, seguido de COMMIT. Si el COMMIT falla, ningún cambio se persiste. Si se confirma, ambos cambios quedan guardados atómicamente. Esta es la base de toda la confiabilidad del sistema.
Los timeouts deben configurarse pensando en las características reales de cada operación. Para Pedidos: timeout de validación de stock de 30 segundos (consultas de base de datos son rápidas), timeout de pago de 60 segundos (APIs bancarias pueden ser lentas), timeout de asignación de 15 segundos (es un UPDATE simple), y timeout total de saga de 2 horas (permitiendo delays en procesamiento de eventos). Para Inventario: timeout de consulta de base de datos de 5 segundos, timeout de bloqueo pesimista de 10 segundos. Para Pagos: timeout de llamada a pasarela de 30 segundos, 3 reintentos con backoff de 2-8-18 segundos, y timeout de reembolso de 60 segundos.
Reflexiones sobre la Consistencia Eventual
Implementar el patrón Saga es, en esencia, aceptar la naturaleza distribuida de la realidad. No estamos simulando un sistema monolítico con trucos de coordinación; estamos abrazando honestamente que nuestros servicios son entidades autónomas que colaboran a través de eventos. La consistencia eventual no es una limitación que debemos lamentar, sino una propiedad emergente que podemos diseñar deliberadamente.
Los desafíos son reales: flujos implícitos, depuración compleja, compensaciones que requieren pensamiento cuidadoso, race conditions que debemos anticipar, y la necesidad constante de idempotencia. Pero las recompensas también son sustanciales: servicios verdaderamente desacoplados que pueden evolucionar independientemente, escalabilidad horizontal sin límites artificiales, resiliencia ante fallos parciales, y la capacidad de razonar sobre procesos de negocio complejos mediante eventos de dominio.
La clave está en la disciplina. El patrón Transactional Outbox elimina el dual write problem. La deduplicación sistemática maneja mensajes duplicados. Las compensaciones bien diseñadas permiten deshacer operaciones. Los reintentos inteligentes distinguen entre fallos transitorios y permanentes. El versionado cuidadoso permite evolución sin ruptura. La observabilidad exhaustiva ilumina lo que de otra manera sería opaco.
Cada uno de estos elementos es un pilar que sostiene el edificio completo. Eliminar cualquiera de ellos compromete la integridad estructural. Pero implementados en conjunto, con la atención al detalle que merece cada uno, nos permiten construir sistemas distribuidos que no solo funcionan sino que son comprensibles, mantenibles y confiables a largo plazo.
Al final, el patrón Saga nos enseña una lección más amplia sobre la arquitectura de software: los sistemas complejos emergen de la composición de partes simples que interactúan mediante protocolos bien definidos. No necesitamos coordinación central omnisciente. No necesitamos transacciones globales mágicas. Necesitamos servicios que comprendan sus responsabilidades, eventos que comuniquen intenciones claras, y mecanismos de compensación que permitan corrección de errores. Con estos ingredientes, la consistencia eventual emerge naturalmente, como un patrón que se forma en la arena cuando las olas retroceden.
Esta es la belleza del diseño distribuido: aceptamos las limitaciones fundamentales de la física —la información viaja a velocidad finita, los sistemas fallan parcialmente, el tiempo no es absoluto— y construimos abstracciones que funcionan dentro de estas limitaciones en lugar de pretender superarlas. El patrón Saga es nuestra forma de bailar con la entropía en lugar de luchar contra ella.