- Agile 2
- Alta disponibilidad 1
- Alternativas cloud 1
- Aop 1
- Arquitectura 3
- Arquitectura distribuida 4
- Automatizacion 3
- Aws 1
- Azure devops 1
- Base de datos 1
- Buenas practicas 22
- Cloud 1
- Colas 7
- Competing consumers 1
- Convenciones 11
- Copilot 1
- Diseno 8
- Docker 2
- Docker compose 1
- Documentacion 1
- Eda 11
- Equipos 1
- Escalabilidad 1
- Flujo de negocio 1
- Flujo de trabajo 3
- Flyway 1
- Git 4
- Gradle 3
- Herramientas digitales 1
- Ia 1
- Iam 1
- Infraestructura 2
- Java 16
- Jerarquia tecnica 1
- Jpa 1
- Jsonb 1
- Kafka 7
- Kubernetes 1
- Liderazgo en software 1
- Lineamientos 1
- Log 1
- Logging 3
- Microservicios 5
- Mongodb 1
- Monitoreo 1
- Nosql 3
- Observabilidad 4
- Open source 1
- Plugins 3
- Postgresql 2
- Privacidad 1
- Programacion funcional 1
- Programacion reactiva 4
- Rabbitmq 6
- Rotacion de talento 1
- Saga 2
- Scrum 2
- Security 1
- Seguridad 1
- Self hosting 1
- Sistemas legados 1
- Snippets 1
- Spring boot 5
- Spring mvc 2
- Sql 4
- Streams 1
- Threadlocal 1
- Trazabilidad 2
- Versionado 2
- Web 1
- Webflux 2
- Websockets 1
- Zero trust 1
Diseno
8 artículos
Paginacion: Cuando offset ya no es suficiente
- Mauricio ECR
- Arquitectura
- 27 Sep, 2026
Te llega la tarea y parece de las fáciles: "agregar paginación al listado de artículos". Añades ?page=0&size=20, Spring te proporciona Pageable, el repositorio hereda findAll(pageable) y, en poc
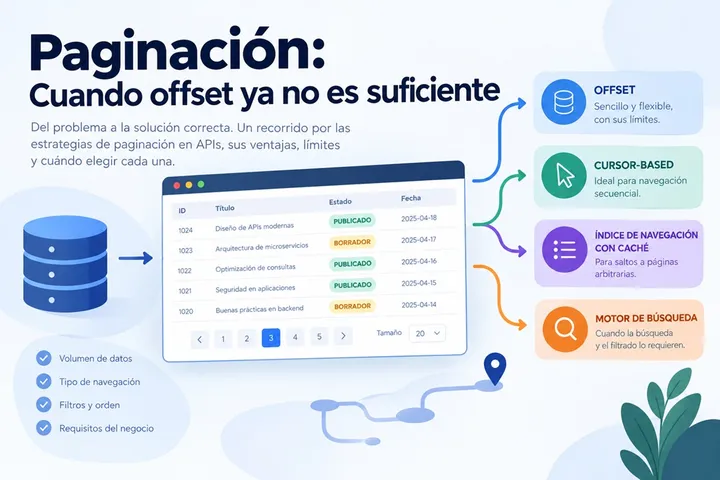
Paginacion: Cuando offset ya no es suficiente
- Mauricio ECR
- Arquitectura
- 27 Sep, 2026
Te llega la tarea y parece de las fáciles: "agregar paginación al listado de artículos". Añades ?page=0&size=20, Spring te proporciona Pageable, el repositorio hereda findAll(pageable) y, en pocos minutos, tienes un endpoint funcionando.
En desarrollo, con mil registros, todo va bien. En staging, con diez mil, probablemente también. El problema aparece más adelante, cuando la tabla alcanza cientos de miles de filas, los filtros se vuelven más complejos y los tiempos de respuesta empiezan a crecer de una forma que ya no resulta tan fácil de explicar.
Y esa lentitud no aparece porque sí. Tiene una causa concreta, relacionada con la forma en que la base de datos resuelve la consulta internamente.
El costo invisible de OFFSET
La paginación tradicional suele apoyarse en dos cláusulas SQL: LIMIT, que determina cuántos registros devolver, y OFFSET, que indica cuántos registros deben quedar fuera antes de comenzar a devolver resultados.
SELECT * FROM articulos
ORDER BY created_at DESC
LIMIT 20 OFFSET 10000;
La consulta parece directa. Pero lo que ocurre para resolverla no siempre lo es.
Para obtener los veinte registros solicitados, el motor necesita avanzar hasta la posición indicada por el OFFSET. Los registros anteriores no forman parte del resultado final, pero el trabajo necesario para llegar hasta ellos existe.
Por eso, a medida que aumenta la profundidad de la página, puede aumentar también el trabajo que debe realizar el motor. La página 1 con tamaño 20 apenas necesita avanzar. Una página mucho más profunda tiene que recorrer una cantidad considerablemente mayor de registros antes de llegar al conjunto que finalmente devolverá.
La diferencia puede ser especialmente importante en tablas grandes. Los índices ayudan a reducir el trabajo necesario, pero no eliminan por completo la naturaleza del problema: la posición se expresa como una cantidad de registros que deben quedar atrás.
Existe además otro problema, menos visible durante las pruebas: la posición de una página puede cambiar mientras el usuario navega.
Imagina que un cliente solicita la página 3 y, antes de solicitar la página 4, se inserta un nuevo registro que queda al principio del orden.
Ese nuevo registro desplaza las posiciones siguientes. Como consecuencia, el cliente puede recibir un registro que ya había visto o dejar de recibir otro que esperaba encontrar en la siguiente página.
El mismo tipo de desplazamiento puede producirse cuando se eliminan registros o cuando una modificación cambia su posición dentro del orden.
No es necesariamente un error que aparezca durante una prueba funcional. Es un comportamiento que puede hacerse visible cuando varios usuarios navegan mientras el sistema continúa recibiendo escrituras.
Tenemos, entonces, dos problemas diferentes pero relacionados:
- El costo puede aumentar a medida que se profundiza en las páginas.
- Los resultados pueden desplazarse entre una solicitud y la siguiente cuando los datos cambian.
Estos problemas explican por qué una implementación de OFFSET que funcionaba perfectamente con una tabla pequeña puede empezar a presentar dificultades cuando cambian el volumen o la forma de utilizar el endpoint.
Pero todavía no podemos concluir que haya que reemplazar OFFSET.
La pregunta siguiente es otra: ¿qué características tiene el caso de uso que estamos intentando resolver?
Las variables que realmente determinan la solución
No existe una única solución para todos los escenarios de paginación. La estrategia adecuada depende de cómo se navegan los resultados, cómo se filtran, cómo se ordenan y cuánto crecerán los datos.
Antes de comparar alternativas, conviene responder cuatro preguntas.
La primera es probablemente la más importante:
¿El usuario navega secuencialmente o necesita saltar a páginas arbitrarias?
Navegar secuencialmente significa avanzar a partir del resultado anterior: siguiente, anterior, scroll infinito o cualquier otra interfaz en la que el usuario recorre los resultados de forma progresiva.
La navegación aleatoria es diferente. Aquí el usuario puede seleccionar directamente una página concreta, por ejemplo la 53, sin haber recorrido las anteriores.
Esta diferencia es fundamental porque algunas estrategias utilizan precisamente el resultado anterior como punto de referencia. Si el usuario necesita saltar directamente a una posición arbitraria, ese modelo deja de encajar tan bien.
La segunda pregunta aparece cuando entran en juego los filtros:
¿Los filtros utilizan valores discretos o rangos abiertos?
Un filtro discreto trabaja con un conjunto relativamente acotado de posibilidades: estado, categoría, autor o tipo.
Un rango abierto permite prácticamente cualquier combinación dentro de un continuo: una fecha entre X e Y, un precio entre A y B o una búsqueda de texto libre.
Esta diferencia se vuelve especialmente importante cuando se considera una estrategia basada en caché. Si existen pocas combinaciones posibles, una consulta puede reutilizar un resultado previamente calculado. Cuando las combinaciones son prácticamente infinitas, esa reutilización se vuelve mucho menos probable.
La tercera pregunta tiene que ver con el orden:
¿El orden de los resultados es estable o puede cambiar?
Un orden estable puede ser, por ejemplo, created_at DESC, acompañado de un identificador como desempate.
Un orden dinámico permite que el usuario cambie la columna o los criterios de orden durante la navegación. En ese caso, una referencia calculada para el orden anterior deja de representar correctamente la posición dentro del nuevo orden.
Finalmente está el volumen:
¿Cuántos registros existen hoy y cuánto se espera que crezca la tabla?
Una tabla con cincuenta mil registros presenta unas necesidades diferentes a una que puede alcanzar varios millones.
El volumen no determina por sí solo la solución, pero sí cambia el costo de las estrategias. Algo que resulta perfectamente razonable en una tabla pequeña puede dejar de serlo cuando aumentan la profundidad de las páginas, la cantidad de consultas y la concurrencia.
Con estas cuatro variables definidas, ya podemos comparar las alternativas de manera más precisa. Cada una resuelve una combinación diferente de necesidades y, al mismo tiempo, introduce sus propios límites.
Cuando OFFSET sigue siendo suficiente
La primera posibilidad es también la más sencilla: mantener OFFSET, pero controlar las condiciones en las que se utiliza.
Esto tiene sentido cuando el volumen es moderado, las páginas profundas son poco frecuentes y la navegación aleatoria forma parte de los requisitos.
En muchos sistemas, los usuarios rara vez llegan a páginas extremadamente profundas. Si una interfaz obliga a recorrer miles de páginas para encontrar un registro, probablemente el problema de fondo sea que falta una búsqueda o un mecanismo de filtrado más adecuado.
Por eso, establecer un límite máximo de profundidad puede ser una decisión razonable. Por ejemplo, se puede impedir que una API consulte páginas más allá de cierto límite y obligar al consumidor a utilizar filtros o búsqueda para localizar registros concretos.
El segundo elemento importante es el índice.
Supongamos que la consulta utiliza:
ORDER BY estado, created_at, id
Si esas columnas participan habitualmente en el orden y los filtros, un índice compuesto diseñado de acuerdo con el patrón real de consulta puede reducir considerablemente el trabajo necesario.
El costo asociado con la profundidad no desaparece por completo, pero puede disminuir de forma importante.
Aquí aparece una idea importante: no toda paginación necesita una arquitectura sofisticada.
Si el problema es pequeño y los requisitos son sencillos, introducir cursores, Redis o un motor de búsqueda puede añadir mucha más complejidad de la que realmente se necesita.
Cuándo encaja
OFFSET puede seguir siendo una buena opción cuando:
- El volumen es moderado.
- Las páginas profundas son poco frecuentes.
- El usuario necesita saltar a páginas arbitrarias.
- Los filtros y órdenes pueden cambiar dinámicamente.
- Se quiere mantener un contrato de API convencional basado en
pageysize. - La simplicidad de implementación es importante.
Qué no resuelve
El costo de las páginas profundas sigue existiendo.
Además, los cambios en los datos entre solicitudes pueden desplazar los resultados de una página a otra.
Cuando esas limitaciones dejan de ser aceptables, aparece una estrategia basada en una idea diferente: dejar de identificar la posición mediante un número y utilizar el propio orden de los datos como referencia.
Cuando la navegación es secuencial: cursor-based pagination
Aquí aparece la paginación basada en cursores, también conocida como keyset pagination.
La diferencia conceptual es sencilla.
Con OFFSET, la consulta pregunta:
"Dame los registros que están después de las primeras N posiciones."
Con un cursor, la consulta pregunta:
"Dame los registros que vienen después de este punto concreto del orden."
Por ejemplo:
SELECT * FROM articulos
WHERE (created_at, id) < (:ultima_fecha, :ultimo_id)
ORDER BY created_at DESC, id ASC
LIMIT 20;
En este caso, el último registro recibido se convierte en el punto de referencia para solicitar el siguiente conjunto.
La base de datos ya no necesita interpretar la página como una posición numérica. Puede utilizar los valores del orden para localizar el punto desde el que debe continuar.
Cuando existe un índice adecuado, esto permite evitar gran parte del trabajo asociado con recorrer posiciones profundas mediante OFFSET.
Por eso, la profundidad de la navegación deja de tener el mismo efecto que tenía en la estrategia anterior.
El cursor que recibe el cliente suele ser un token opaco. Puede contener los valores de las columnas utilizadas para determinar la posición y estar codificado, por ejemplo, mediante Base64URL.
El cliente no necesita conocer su estructura. Solo necesita conservarlo y devolverlo cuando solicite la siguiente página.
Esto permite que el backend cambie la representación interna del cursor sin obligar al cliente a interpretar sus componentes.
El requisito que hace posible un cursor
Para que este modelo funcione correctamente, el orden debe ser determinista.
Si varios registros tienen exactamente el mismo valor para el criterio principal, necesitamos una columna adicional que permita desempatar.
Por ejemplo:
ORDER BY created_at DESC, id ASC
Aquí created_at determina el orden principal y id permite distinguir registros que tienen la misma fecha.
Cuando el orden de negocio tiene varios niveles, todos ellos forman parte de la referencia.
Por ejemplo:
estado → created_at → id
El cursor deberá contener la información necesaria para reproducir esa posición dentro del orden.
El backend recibe el token, recupera esos valores y construye la condición correspondiente.
La contrapartida: la navegación deja de ser aleatoria
Aquí aparece la principal diferencia con OFFSET.
Un cursor representa un punto dentro del orden, no un número de página.
Por eso, si el usuario está recorriendo:
página 1 → página 2 → página 3 → página 4
es natural solicitar la siguiente posición.
Pero si quiere saltar directamente a la página 53, el cursor de esa página no puede calcularse simplemente a partir del número 53.
Esto significa que los cursores son especialmente adecuados cuando la navegación es secuencial.
No son simplemente una optimización de SQL: también representan un cambio en el contrato de la API y, en algunos casos, en la interfaz.
Una tabla tradicional basada en números de página no puede sustituirse por cursores manteniendo exactamente la misma semántica.
Cuándo encaja
La estrategia basada en cursores resulta especialmente apropiada para:
- Feeds.
- Historiales.
- Scroll infinito.
- Exportaciones secuenciales.
- Integraciones entre servicios.
- Tablas de gran volumen.
- Sistemas con escrituras frecuentes.
- Casos en los que el usuario no necesita saltar a una página arbitraria.
Qué no resuelve
No permite una navegación aleatoria equivalente a page=53.
Además, necesita un orden estable y determinista.
Cuando el requisito de navegación aleatoria es obligatorio, debemos buscar otra estrategia.
Cuando necesitas saltar directamente a una página
Supongamos ahora que el volumen es grande y que el usuario sí necesita ir directamente a una página concreta.
En ese caso, un cursor no encaja con el requisito principal de la interfaz.
Una posibilidad consiste en separar dos problemas que hasta ahora estaban mezclados: determinar qué registros ocupan cada posición y recuperar después los datos de esas posiciones.
La idea es construir un índice de navegación que contenga únicamente los identificadores de los registros que cumplen el filtro, en el orden correspondiente.
Por ejemplo:
SELECT id
FROM articulos
WHERE estado = :estado
  AND categoria = :categoria
ORDER BY
    CASE estado
        WHEN 'BORRADOR' THEN 1
        WHEN 'PUBLICADO' THEN 2
        ELSE 3
    END ASC,
    created_at DESC,
    id ASC;
El resultado conceptual sería:
[uuid_1, uuid_2, uuid_3, ..., uuid_N]
No estamos almacenando los artículos completos. Estamos almacenando el mapa que permite saber qué identificadores corresponden a cada posición.
Ese resultado puede guardarse en una caché utilizando como clave una representación de los filtros y del criterio de orden.
Por ejemplo:
hash(filtros + orden) → [id_1, id_2, id_3, ...]
Si la misma combinación se solicita nuevamente mientras el índice sigue siendo válido, puede reutilizarse.
Si el usuario cambia el filtro o el orden, cambia la clave y se genera otro índice.
A partir de ese mapa, solicitar la página 53 significa seleccionar las posiciones correspondientes.
Con un tamaño de página de 20:
página 53 → posiciones 1040 a 1059
Después, el sistema puede recuperar directamente los registros identificados:
SELECT *
FROM articulos
WHERE id = ANY(:ids_pagina);
Finalmente, debe reconstruir el mismo orden utilizado por el índice.
Una consecuencia importante: la consulta representa una fotografía
Esta estrategia introduce una propiedad que conviene hacer explícita.
El índice representa el conjunto de resultados en el momento en que fue construido.
Si se inserta un nuevo registro después de crear el índice, ese registro no tiene por qué aparecer en la navegación actual.
Si se elimina uno de los registros, el índice puede seguir haciendo referencia a un elemento que ya no existe y será necesario decidir cómo gestionar ese caso.
La ventaja es que el comportamiento deja de depender de desplazamientos implícitos entre solicitudes y pasa a formar parte explícita del diseño.
En otras palabras, el sistema está diciendo:
"Esta navegación corresponde a esta fotografía del conjunto de resultados."
Dependiendo del caso de uso, eso puede ser precisamente lo que se necesita.
El papel de los filtros
Aquí las características de los filtros que definimos antes adquieren importancia.
Si existen filtros discretos y relativamente acotados, es posible que diferentes usuarios soliciten repetidamente las mismas combinaciones.
Por ejemplo:
estado=PUBLICADO
categoria=TECNOLOGIA
orden=created_at
Ese tipo de consulta tiene más posibilidades de reutilizar un índice existente.
En cambio, si cada usuario puede especificar una fecha inicial, una fecha final, un precio mínimo, un precio máximo y otros parámetros arbitrarios, el número de combinaciones crece rápidamente.
En ese escenario, la caché puede tener menos oportunidades de reutilización y la generación del índice inicial puede convertirse en un costo importante.
Cuándo encaja
Este enfoque resulta especialmente interesante cuando:
- La navegación aleatoria es necesaria.
- El volumen de datos es elevado.
- Los filtros son relativamente discretos y repetibles.
- El orden de negocio es complejo.
- La misma combinación de filtros se consulta con frecuencia.
- Se dispone de infraestructura de caché.
Qué no resuelve
La generación inicial del índice sigue teniendo un costo proporcional al conjunto de resultados que debe procesar.
Además, mantener la caché introduce complejidad operacional: expiración, invalidación, memoria utilizada y comportamiento ante cambios en los datos.
Cuando los filtros dejan de ser discretos y pasan a incluir texto libre o rangos arbitrarios, puede ser necesario cambiar nuevamente de enfoque.
Cuando el problema ya es de búsqueda
Llegados a este punto, aparece un escenario diferente.
El problema ya no consiste únicamente en decidir cómo recorrer una lista grande.
Supongamos que el endpoint necesita combinar:
- Texto libre.
- Rangos arbitrarios.
- Múltiples dimensiones de filtrado.
- Orden dinámico.
- Millones de registros.
- Consultas frecuentes y concurrentes.
- Navegación sobre grandes conjuntos de resultados.
Aquí puede tener sentido utilizar un motor de búsqueda especializado.
Herramientas como Elasticsearch u OpenSearch utilizan estructuras de indexación diseñadas específicamente para búsquedas y filtrados complejos.
En lugar de depender exclusivamente del modelo de consulta de una tabla relacional, mantienen estructuras especializadas que permiten localizar documentos a partir de los términos y valores buscados.
También ofrecen mecanismos orientados a recorrer grandes conjuntos de resultados, como search_after, que permite continuar una búsqueda a partir de una posición determinada.
Esto cambia la naturaleza del problema.
Ya no estamos intentando hacer que una tabla relacional resuelva eficientemente cualquier combinación imaginable de búsqueda, filtro y orden.
Estamos utilizando una infraestructura especializada para ese patrón de acceso.
Pero esa decisión introduce un costo nuevo: ahora existe una infraestructura adicional que debe mantenerse sincronizada con la base de datos principal.
El flujo puede verse, conceptualmente, así:
Base de datos principal
        ↓
Proceso de sincronización
        ↓
Índice de búsqueda
Esto obliga a resolver preguntas que no existían con una única base de datos:
- ¿Cuándo se actualiza el índice?
- ¿Qué ocurre si la sincronización falla?
- ¿Cuánto retraso puede existir entre ambos sistemas?
- ¿Cuál es la fuente de verdad?
- ¿Cómo se reconstruye el índice?
- ¿Cómo se monitoriza?
Por eso, un motor de búsqueda no debería incorporarse simplemente porque OFFSET sea lento.
Tiene sentido cuando las necesidades de búsqueda y filtrado justifican la infraestructura adicional.
Cuándo encaja
Puede resultar adecuado cuando:
- El texto libre es una parte central del caso de uso.
- Existen rangos y filtros complejos.
- Se combinan múltiples dimensiones de búsqueda.
- El volumen de datos es elevado.
- Las consultas son frecuentes y concurrentes.
- La base de datos principal ya no ofrece una solución eficiente para el patrón de búsqueda requerido.
Qué no resuelve
No elimina la complejidad: la desplaza hacia la arquitectura.
Aparecen nuevos componentes, sincronización, monitorización, gestión de índices y una nueva forma de consultar los datos.
Si una solución más sencilla satisface los requisitos, incorporar otro sistema puede ser innecesario.
El árbol de decisión
A estas alturas, las cuatro estrategias ya no aparecen como alternativas aisladas. Cada una responde a las condiciones que acabamos de analizar.
El recorrido puede resumirse así:
flowchart TD
A([Necesito paginar una tabla])
--> B{¿Volumen moderado<br/>y páginas superficiales?}
B -->|Sí| S1[OFFSET con índices<br/>bien diseñados]
B -->|No| C{¿El usuario necesita<br/>saltar a páginas arbitrarias?}
C -->|No — navegación secuencial| D{¿El orden puede ser<br/>determinista?}
D -->|Sí| S2[Cursor-based pagination<br/>CursorRequest + CursorPage<T>]
D -->|No| D2[Añadir una columna<br/>de desempate única al orden]
D2 --> D
C -->|Sí — acceso aleatorio| E{¿Los filtros son<br/>discretos y acotados?}
E -->|Sí| S3[Índice de navegación con caché<br/>Hash del filtro → IDs en Redis]
E -->|No| F{¿La búsqueda y el volumen<br/>justifican infraestructura adicional?}
F -->|Sí| S4[Motor de búsqueda dedicado<br/>Elasticsearch / OpenSearch]
F -->|No| S1b[OFFSET con límite<br/>de profundidad]
El árbol no debe interpretarse como una fórmula rígida.
Por ejemplo, el número de registros por sí solo no determina qué estrategia utilizar. Lo que importa es cómo se combina ese volumen con la profundidad de navegación, el patrón de consulta, los filtros, el orden y la frecuencia de acceso.
El objetivo del árbol es obligarnos a formular las preguntas correctas antes de introducir complejidad.
Lo que cada solución no resuelve
Después de recorrer las alternativas, aparece una conclusión importante: ninguna estrategia elimina el costo de la paginación; cada una lo desplaza hacia un lugar diferente.
OFFSET mantiene un contrato sencillo y permite navegar directamente a páginas arbitrarias. Su costo aparece principalmente cuando la profundidad aumenta y los datos son numerosos.
Los cursores reducen el trabajo asociado con posiciones profundas y funcionan especialmente bien para navegación secuencial. A cambio, el cliente deja de trabajar con páginas numéricas y debe conservar un punto de referencia.
El índice de navegación con caché permite recuperar páginas arbitrarias a partir de un mapa previamente construido. A cambio, introduce un costo inicial y una infraestructura adicional para almacenar y gestionar ese mapa.
El motor de búsqueda permite resolver escenarios donde el problema ya no es solamente paginar, sino buscar y filtrar grandes volúmenes de información. A cambio, introduce otra pieza de infraestructura y la necesidad de mantenerla coordinada con la fuente de datos principal.
Por eso, la decisión no consiste en encontrar una solución que no tenga costos.
Consiste en decidir qué costo es aceptable para el contexto concreto del sistema.
Volver al endpoint que "simplemente funcionaba"
Cuando aquel endpoint que inicialmente "simplemente funcionaba" empieza a mostrar tiempos de respuesta cada vez mayores, es tentador concluir que OFFSET fue una mala decisión desde el principio.
Pero esa conclusión sería demasiado simple.
OFFSET puede ser una solución perfectamente válida para determinados escenarios.
El problema aparece cuando cambian las condiciones para las que fue elegido y nadie revisa la decisión.
Una tabla que comenzó con 20.000 registros puede terminar teniendo varios millones.
Una interfaz que inicialmente mostraba cinco páginas puede terminar necesitando búsqueda avanzada.
Un listado que solo se consultaba ocasionalmente puede convertirse en una de las rutas más utilizadas de la aplicación.
Y un criterio de orden sencillo puede terminar acompañado de múltiples filtros y reglas de negocio.
Por eso, la pregunta importante no es si OFFSET es bueno o malo.
La pregunta es si sigue siendo adecuado para las condiciones actuales del endpoint.
Ese cambio de perspectiva también modifica la forma de diseñar la solución desde el principio.
Antes de implementar la paginación, conviene conocer:
- cómo navegará el usuario;
- si necesita saltos arbitrarios;
- qué filtros tendrá disponibles;
- si esos filtros son discretos o abiertos;
- cómo se ordenarán los resultados;
- si ese orden es determinista;
- cuánto volumen existe actualmente;
- cuánto se espera que crezca;
- y cuánto pueden cambiar los datos mientras el usuario navega.
Con esa información, OFFSET, cursores, un índice de navegación o un motor de búsqueda dejan de ser decisiones basadas en preferencias técnicas.
Se convierten en respuestas a requisitos concretos.
Y esa es probablemente la idea más importante de todo el problema: la paginación no debería elegirse por costumbre ni por la tecnología que tenemos disponible, sino por la forma en que el endpoint realmente necesita ser utilizado.
La tarea puede seguir siendo "agregar paginación al listado de artículos".
Lo que cambia es la pregunta que hacemos antes de tocar el código.
No:
"¿Cuál es la mejor técnica de paginación?"
Sino:
"¿Qué tipo de navegación, filtrado, orden y volumen necesita realmente este endpoint?"
A partir de ahí, la implementación deja de ser una decisión aislada y pasa a formar parte del diseño técnico del sistema.
Y cuando el volumen, los filtros o la forma de navegación cambien, la estrategia puede revisarse de nuevo.
Ese punto de revisión es tan importante como la decisión inicial.
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
- Mauricio ECR
- Arquitectura
- 12 Sep, 2026
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload Seguro que alguna vez empezaste con un endpoint de listado que parecía no necesitar demasiado. Un par de fil
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
- Mauricio ECR
- Arquitectura
- 12 Sep, 2026
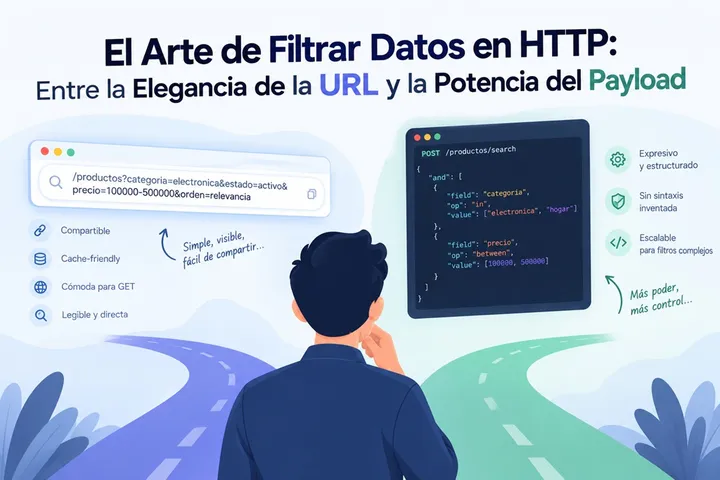
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
Seguro que alguna vez empezaste con un endpoint de listado que parecía no necesitar demasiado. Un par de filtros simples: nombre, categoría, quizá un estado. Todo cabía cómodamente en una URL como ?categoria=electronica&estado=activo, era fácil de leer y nadie tenía demasiadas razones para cuestionar la decisión.
El problema aparece cuando esa pantalla deja de ser simple.
Alguien de producto pide filtrar por varias categorías al mismo tiempo, añadir un rango de precios, restringir por fecha de publicación y, además, ordenar por relevancia. Nada especialmente extraño: es el tipo de evolución que termina teniendo cualquier sistema de búsqueda que crece un poco. Lo que cambia no es la necesidad funcional, sino la dificultad de representar esa necesidad dentro de HTTP.
Y es ahí donde una decisión que parecía puramente sintáctica empieza a afectar cosas bastante más importantes: la legibilidad de las URLs, su capacidad para compartirse, el caché, la infraestructura que las procesa y, finalmente, la forma en que el propio código del backend tiene que recibirlas.
Cuando los filtros dejan de caber cómodamente en una URL
La primera reacción suele ser intentar mantener el modelo que ya funciona y llevarlo un poco más lejos. Si un parámetro alcanza para un filtro, quizá varios parámetros puedan representar varios filtros.
Pronto aparece algo parecido a esto:
filter[0][field]=categoria&filter[0][op]=in&filter[0][value][]=electronica&filter[0][value][]=hogar&filter[1][field]=precio&filter[1][op]=between&filter[1][value][]=100000&filter[1][value][]=500000
El problema no es que esta representación sea imposible. El problema es que, a medida que aumenta la complejidad, empieza a depender de una sintaxis que la propia API tiene que inventar y documentar. No existe una convención universal que garantice que otro equipo, otro framework o incluso otro endpoint vaya a interpretar exactamente esa estructura de la misma manera.
Con dos condiciones todavía se puede tolerar. Con tres o cuatro, la URL deja de comunicar lo que está ocurriendo y pasa a convertirse en una estructura que hay que descifrar.
La siguiente idea parece más atractiva precisamente porque elimina esa sintaxis inventada: si el filtro es estructurado, ¿por qué no representarlo directamente como JSON?
Por ejemplo:
{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    }
  ]
}
Conceptualmente es mucho mejor. La estructura expresa exactamente lo que se quiere consultar y no hace falta inventar una notación propia para representar operadores, campos y valores.
El problema llega cuando ese JSON tiene que viajar dentro de una URL.
Después de aplicar URL encoding, una estructura que originalmente era legible termina convertida en una secuencia como esta:
%7B%22and%22%3A%5B%7B%22field%22%3A%22categoria%22%2C%22op%22%3A%22in%22%2C%22value%22%3A%5B%22electronica%22%2C%22hogar%22%5D%7D%5D%7D
La información sigue estando ahí. El problema es que dejó de ser visible.
Esto parece una molestia estética hasta que aparece un caso real de diagnóstico. Una URL así puede terminar en un mensaje de chat del equipo, en Postman, en un log de producción o en un ticket donde alguien intenta explicar por qué una búsqueda devolvió resultados inesperados. En ninguno de esos escenarios resulta evidente qué filtro representa la cadena.
Hay que decodificarla antes de poder entenderla.
Y entonces aparece una tercera posibilidad, casi inevitable: abandonar la URL y enviar el JSON en el body de un POST.
La solución fácil también cambia el contrato
La propuesta de utilizar POST tiene una ventaja evidente: el filtro vuelve a verse exactamente como lo que es.
POST /productos/search
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Desde el punto de vista de representación, es probablemente la solución más cómoda. Pero resuelve el problema de legibilidad introduciendo otro: la búsqueda ya no está contenida en una URL que pueda copiarse, pegarse y compartir como un recurso de lectura.
Además, aunque el caché de respuestas POST es posible con configuraciones específicas, no tiene la misma interoperabilidad ni la misma naturalidad que el caché de un GET. Una petición GET encaja directamente con las expectativas de navegadores, proxies, CDN y clientes HTTP para operaciones de lectura.
Esto no significa que POST sea incorrecto. Significa que, al elegirlo, se está renunciando deliberadamente a ciertas propiedades.
Y esa distinción es importante porque permite formular mejor el problema. No se trata de encontrar una opción universalmente correcta entre query params, JSON en la URL y POST. Se trata de decidir qué propiedad del contrato HTTP se necesita conservar.
Si la búsqueda debe poder compartirse como enlace y además interesa mantenerla como GET, todavía quedan alternativas que merece la pena explorar — y antes de comprometerse con una, conviene entender de qué depende cada una.
Dos caminos para conservar el GET, con distinta dependencia
Cuando la meta es mantener la búsqueda como GET compartible sin caer en URLs ilegibles, hay dos familias de solución, y no son intercambiables porque no piden lo mismo al resto del sistema.
Una es codificar el filtro tal cual el frontend lo pensó (un objeto JSON con la forma que el dominio necesite) y transportarlo como un blob opaco en un único parámetro. Esta idea no le exige nada a la capa de persistencia: el servidor recibe una cadena, la decodifica, obtiene un JSON y lo interpreta como quiera. Es agnóstica al motor de datos por completo.
La otra es expresar el filtro directamente como una gramática de texto pensada para mapear campo-operador-valor, apoyándose en que exista una capa de acceso a datos capaz de traducir esa gramática a una consulta ejecutable. Esta idea sí depende de algo externo a la propia idea: solo funciona si hay un traductor gramática→query, típicamente provisto por un ORM con soporte de construcción dinámica de condiciones (Criteria API en el mundo Java, query builders equivalentes en otros stacks).
Esa diferencia — necesitar o no una capa de traducción externa — es la que determina cuál conviene en cada caso, y conviene resolverla antes de escribir una sola línea de código.
El camino agnóstico: JSON opaco vía Base64URL
Cuando el filtro es estructurado pero sigue siendo razonablemente pequeño, una posibilidad es serializarlo como JSON y después codificar ese JSON utilizando Base64URL.
El flujo conceptual es sencillo:
- Se construye el filtro como un objeto.
- Se serializa a JSON.
- Ese JSON se codifica mediante Base64URL.
- El resultado se envía como un único parámetro de query.
- El servidor lo decodifica y recupera nuevamente el JSON.
La diferencia importante es que no se intenta hacer legible el contenido del filtro dentro de la URL. Se acepta que sea opaco, pero se consigue que la representación sea mucho más adecuada para convivir con la sintaxis de una URL.
También conviene precisar el nombre. No se trata simplemente de Base64 tradicional.
Base64 utiliza caracteres como +, / y =, que pueden requerir tratamiento adicional cuando aparecen dentro de una URL. Base64URL, definido en la sección 5 del RFC 4648, utiliza - y _ en lugar de esos caracteres y permite omitir el padding cuando el protocolo que lo utiliza lo contempla.
Tomemos el filtro completo:
{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Después de codificarlo, la petición puede quedar así:
GET /productos?filter=eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhIiwib3AiOiJpbiIsInZhbHVlIjpbImVsZWN0cm9uaWNhIiwiaG9nYXIiXX0seyJmaWVsZCI6InByZWNpbyIsIm9wIjoiYmV0d2VlbiIsInZhbHVlIjpbMTAwMDAwLDUwMDAwMF19XX0
La cadena sigue siendo opaca. No pretende ser legible para una persona. Pero ya no está dominada por secuencias %XX, y lo más importante es que la operación continúa siendo un GET.
Eso permite conservar varias propiedades útiles: la búsqueda puede copiarse, guardarse y compartirse como enlace y, cuando la infraestructura está configurada para ello, la respuesta puede aprovechar el caché asociado a una petición GET.
Hay, eso sí, una condición que no conviene esconder: el filtro debe seguir teniendo un tamaño razonable. Si la consulta contiene decenas de condiciones, listas enormes o estructuras profundamente anidadas, el problema deja de ser cómo codificarla y empieza a ser cuánto sentido tiene seguir transportándola dentro de una URL.
Pero para una búsqueda con un conjunto moderado de filtros, Base64URL puede ser un punto intermedio razonable.
Lo que queda pendiente es hacer que el backend pueda consumir esa representación sin convertir cada controlador en responsable de la decodificación.
El camino dependiente de la persistencia: RSQL
Existe otra manera de mantener el GET sin sacrificar legibilidad, pero que parte de una premisa distinta: en lugar de esconder el filtro dentro de un blob opaco, expresarlo directamente como texto legible dentro del propio query param.
RSQL es una extensión de FIQL (Feed Item Query Language) que permite escribir eso: una gramática de comparaciones encadenadas con AND/OR, pensada para mapear uno a uno contra atributos de una entidad. La URL sigue siendo un GET, sigue siendo compartible, y además no pierde legibilidad:
GET /productos?filter=categoria=in=(electronica,hogar);precio=ge=100000;precio=le=500000
El punto y coma es AND, la coma es OR, los paréntesis agrupan. Los paths de relaciones se escriben con notación de punto:
GET /productos?filter=marca.pais==Argentina;estado!=suspendido
Comparado con Base64URL, la ganancia es evidente: no hace falta decodificar nada para entender qué se está pidiendo. La cadena es el filtro.
Pero esa legibilidad no es gratis, y ahí está el punto que conviene no pasar por alto: RSQL no resuelve nada por sí mismo. Es una gramática de texto; alguien tiene que parsearla y, sobre todo, alguien tiene que traducirla a una consulta ejecutable contra el almacenamiento real. A diferencia de Base64URL — donde el servidor simplemente decodifica y deserializa un JSON con sus propias reglas —, RSQL necesita que exista, entre el parser y la base de datos, una capa capaz de convertir cada nodo de comparación en una condición de persistencia. Sin esa capa, RSQL es solo una cadena de texto sin ningún lugar donde ejecutarse.
En el ecosistema Java, esa capa la provee típicamente la Criteria API de JPA a través de una Specification, y existen librerías (no oficiales de Spring, sino de terceros) que hacen ese puente automáticamente. En otros stacks el concepto se mantiene — una gramática campo-operador-valor traducida a un query builder dinámico —, pero el mecanismo concreto cambia según el ORM disponible. Quien quiera ver cómo se ve esa integración en un proyecto Spring Boot real puede saltar directamente al anexo al final del artículo.
Esa dependencia tiene además una consecuencia de seguridad que conviene resolver antes de decidirse por este camino, no después.
El vector de seguridad que ninguna gramática resuelve por defecto
Cualquier mecanismo que traduzca texto libre a una condición de persistencia enfrenta el mismo riesgo, independientemente del lenguaje o el framework: el parser no sabe, por sí solo, qué campos del modelo deberían ser alcanzables desde afuera.
Si una entidad tiene una relación hacia otra entidad con datos sensibles, nada en la gramática impide que un consumidor intente comparar directamente contra esos campos:
GET /productos?filter=usuario.password==algo
GET /productos?filter=usuario.resetToken==abc123
El sistema no devolvería esos valores en el body, pero sí variaría el número de resultados según si la condición se cumple o no. Es suficiente para montar un ataque de oráculo e inferir, comparación a comparación, valores que nunca deberían ser accesibles desde un filtro de listado.
La mitigación es siempre la misma en cualquier stack: recorrer la estructura del filtro ya parseado (su AST) antes de ejecutar la consulta y rechazar cualquier campo que no esté en una allowlist explícita, y componer esa consulta junto con las condiciones base que el usuario nunca debería poder eludir (soft-delete, tenant, permisos).
Esto es exactamente lo que distingue este camino del de Base64URL con un DTO tipado: ahí, los campos filtrables son exactamente los que el desarrollador declaró en la clase. No hay forma de filtrar por usuario.resetToken si ese campo no existe en el tipo — la allowlist es estructural, la garantiza el propio DTO. En el camino de la gramática de texto, en cambio, la allowlist es una responsabilidad operacional: hay que construirla y mantenerla activamente, y es un paso que se puede omitir bajo presión sin que nada lo impida a nivel de compilación.
Cuándo conviene cada camino
La pregunta que separa un camino del otro no es cuál es "mejor", sino qué tan bien el filtro se mapea contra atributos simples de una entidad persistida:
- Si los filtros son AND/OR sobre atributos que existen tal cual en el modelo de datos, y se cuenta con una capa de persistencia capaz de traducir esa gramática (Specification, Criteria API o equivalente), una gramática de texto como RSQL resuelve el problema con muy poco código y conserva la legibilidad de la URL — a cambio de mantener activamente una allowlist.
- Si el contrato del filtro es propio del dominio, con operadores específicos, estructuras anidadas particulares o simplemente no hay (o no se quiere depender de) una capa de traducción gramática→persistencia, Base64URL con un DTO tipado ofrece un contrato explícito, no le pide nada al motor de datos, y su allowlist es estructural en lugar de operacional.
Esta bifurcación es la que después vuelve a aparecer, ya formalizada, en el árbol de decisión al final del artículo.
Llevar la idea de Base64URL a un endpoint real con Spring Boot
En cualquier framework aparece la misma pregunta: alguien tiene que recibir el parámetro, decodificarlo, convertir el JSON en el DTO correspondiente y manejar los errores que puedan producirse durante el proceso.
En Spring Boot, la solución más directa consiste en hacerlo dentro del controlador:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @RequestParam("filter") String filterBase64,
        ObjectMapper objectMapper) throws IOException {

    byte[] jsonBytes = Base64.getUrlDecoder().decode(filterBase64);

    FiltroProductosDto filtro =
            objectMapper.readValue(jsonBytes, FiltroProductosDto.class);

    return ResponseEntity.ok(productoService.buscar(filtro));
}
Para un solo endpoint, no hay nada especialmente problemático en este enfoque. El inconveniente aparece cuando el sistema crece.
Si existen diez endpoints de búsqueda, probablemente aparezcan diez implementaciones prácticamente iguales. Y entonces la cuestión deja de ser si podemos decodificar Base64URL y pasa a ser si queremos mantener esa lógica repartida por todos los controladores.
En ese punto aparecen problemas de consistencia bastante concretos.
¿Todos los endpoints manejan el padding de la misma forma? ¿Todos distinguen entre un Base64URL inválido y un JSON inválido? ¿Todos responden de la misma manera cuando falta el parámetro? ¿Todos deserializan el contenido con las mismas reglas? ¿Todos aplican las mismas validaciones?
La duplicación empieza a convertir una decisión de transporte en una responsabilidad del código de negocio.
Una solución más limpia consiste en hacer que el controlador reciba directamente el DTO que necesita:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(productoService.buscar(filtro));
}
El controlador ya no necesita saber que el filtro llegó codificado. Esa información pertenece a la capa que transforma la petición HTTP en los argumentos del método.
Spring MVC proporciona precisamente un mecanismo para realizar esa transformación: HandlerMethodArgumentResolver.
Sacar la infraestructura del controlador
El primer paso es definir una anotación que identifique los parámetros que deben resolverse mediante este mecanismo:
import java.lang.annotation.*;

@Target(ElementType.PARAMETER)
@Retention(RetentionPolicy.RUNTIME)
public @interface Base64Filter {

    String value() default "filter";
}
El valor permite mantener filter como nombre por defecto, pero también utilizar otro parámetro cuando el endpoint lo necesite:
@Base64Filter("criteria")
FiltroProductosDto filtro
La anotación por sí sola no hace la transformación. El trabajo lo realiza el resolver.
Aquí aparece además una cuestión importante que puede pasar desapercibida: cuando Spring construye automáticamente un objeto mediante mecanismos como @RequestBody, el ciclo de validación habitual puede ejecutarse de forma transparente. Cuando el objeto lo construimos manualmente dentro de un HandlerMethodArgumentResolver, esa validación no aparece automáticamente solo porque hayamos escrito @Valid.
Por eso el resolver tiene que encargarse también de esa parte.
Una implementación posible es:
@Component
public class Base64FilterArgumentResolver implements HandlerMethodArgumentResolver {

    private final ObjectMapper objectMapper;
    private final Validator validator;

    public Base64FilterArgumentResolver(ObjectMapper objectMapper, Validator validator) {
        this.objectMapper = objectMapper;
        this.validator = validator;
    }

    @Override
    public boolean supportsParameter(MethodParameter parameter) {
        return parameter.hasParameterAnnotation(Base64Filter.class);
    }

    @Override
    public Object resolveArgument(
            MethodParameter parameter,
            ModelAndViewContainer mavContainer,
            NativeWebRequest webRequest,
            WebDataBinderFactory binderFactory) throws Exception {

        Base64Filter annotation = parameter.getParameterAnnotation(Base64Filter.class);
        String paramName = annotation.value();
        String rawValue = webRequest.getParameter(paramName);
        Class<?> targetType = parameter.getParameterType();

        Object filtro;

        if (rawValue == null || rawValue.isBlank()) {
            filtro = targetType.getDeclaredConstructor().newInstance();
        } else {
            try {
                byte[] jsonBytes = Base64.getUrlDecoder().decode(rawValue);
                filtro = objectMapper.readValue(jsonBytes, targetType);
            } catch (IllegalArgumentException e) {
                throw new FiltroInvalidoException(
                        "El parámetro '" + paramName + "' no es Base64URL válido");
            } catch (JacksonException e) {
                throw new FiltroInvalidoException(
                        "El parámetro '" + paramName + "' no contiene un JSON de filtro válido");
            }
        }

        if (parameter.hasParameterAnnotation(Valid.class)) {
            Set<ConstraintViolation<Object>> violations = validator.validate(filtro);
            if (!violations.isEmpty()) {
                throw new FiltroInvalidoException(
                        "El filtro no cumple las validaciones: " + violations);
            }
        }

        return filtro;
    }
}
Hay varias decisiones dentro de este código que conviene entender porque son parte del contrato y no simples detalles de implementación.
El método supportsParameter hace que el resolver intervenga únicamente cuando el parámetro tiene la anotación @Base64Filter. Esto mantiene el comportamiento localizado y evita que todos los parámetros de la aplicación intenten pasar por la misma lógica.
Después se obtiene el nombre del parámetro desde la anotación y se recupera su valor desde la petición. Si no existe o está vacío, el ejemplo construye una instancia vacía del DTO. Esa decisión puede ser apropiada cuando la ausencia del filtro significa "sin restricciones", pero no debería convertirse en una regla universal. Si en el dominio la ausencia del parámetro tiene otro significado, ese comportamiento debe reflejarlo.
Cuando sí existe un valor, primero se decodifica Base64URL y después se deserializa el JSON utilizando ObjectMapper.
Las dos operaciones pueden fallar por motivos diferentes, y distinguirlas permite devolver mensajes de error más útiles. Un contenido que no es Base64URL válido no representa el mismo problema que una cadena correctamente codificada que contiene un JSON malformado.
Una vez construido el objeto, el resolver comprueba si el parámetro utiliza @Valid. Solo en ese caso ejecuta explícitamente Bean Validation.
Eso permite mantener en el DTO las reglas habituales:
public class FiltroProductosDto {

    @Size(
        max = 10,
        message = "No se permiten más de 10 categorías"
    )
    private List<String> categorias;

    @Min(0)
    private Long precioMinimo;

    @Min(0)
    private Long precioMaximo;

    // getters y setters
}
De esta manera, colocar @Valid junto con @Base64Filter activa las validaciones sintácticas habituales sin introducir lógica adicional en el controlador.
Es importante, sin embargo, no confundir validación sintáctica con validación de negocio.
Una regla como "no se permiten más de diez categorías" o "el precio mínimo no puede ser negativo" pertenece naturalmente a esta capa. En cambio, comprobar que precioMinimo sea menor que precioMaximo, que una categoría exista realmente o que determinado filtro esté permitido para un usuario concreto puede requerir información que el resolver no debería conocer.
Esas decisiones pertenecen a una capa posterior, normalmente al servicio o a la lógica de dominio.
Registrar el resolver y completar la separación
Una vez creado el resolver, hay que registrarlo en Spring MVC:
@Configuration
public class WebConfig implements WebMvcConfigurer {

    private final Base64FilterArgumentResolver resolver;

    public WebConfig(Base64FilterArgumentResolver resolver) {
        this.resolver = resolver;
    }

    @Override
    public void addArgumentResolvers(List<HandlerMethodArgumentResolver> resolvers) {
        resolvers.add(resolver);
    }
}
A partir de ahí, el controlador puede mantenerse completamente centrado en su responsabilidad:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(
            productoService.buscar(filtro)
    );
}
El beneficio real de esta arquitectura no es que Spring haya aprendido a decodificar Base64URL. El beneficio es haber separado dos decisiones que no deberían estar mezcladas.
Una decisión responde a cómo viaja el filtro por HTTP.
La otra responde a qué filtro necesita el caso de uso.
El controlador solo debería preocuparse por la segunda.
Cuando llegue el endpoint de búsqueda número once, no será necesario copiar la misma secuencia de decodificación, deserialización y validación. El mecanismo de transporte queda encapsulado en una pieza transversal y los endpoints pueden expresar únicamente el contrato que necesitan.
Pero conseguir que el código quede limpio no significa que el diseño esté terminado. Hay varias cuestiones que el resolver no puede solucionar por sí solo.
Codificar no significa proteger
La primera es seguridad.
Base64URL no cifra el contenido. Tampoco lo convierte en secreto. Cualquier persona que tenga acceso a la cadena puede decodificarla y recuperar el JSON original.
Por eso nunca debe interpretarse la codificación como una medida de protección.
Después de deserializar el filtro siguen siendo necesarias las comprobaciones correspondientes: campos permitidos, operadores válidos, tipos esperados, tamaños máximos y, cuando la estructura lo permita, profundidad máxima de anidamiento.
Esto es especialmente relevante cuando el filtro admite estructuras complejas. Una petición puede ser perfectamente válida desde el punto de vista sintáctico y, aun así, provocar un consumo excesivo de CPU o memoria si el servidor acepta estructuras arbitrariamente grandes o profundas.
La validación, por tanto, no es un accesorio que se añade después de implementar Base64URL. Forma parte del contrato de entrada.
Los errores también forman parte del diseño
El segundo punto es el manejo de errores.
El resolver puede lanzar FiltroInvalidoException, pero eso no significa que cada controlador deba capturarla individualmente. La aplicación puede centralizar la conversión de esa excepción en una respuesta HTTP uniforme:
@RestControllerAdvice
public class FiltroExceptionHandler {

    @ExceptionHandler(FiltroInvalidoException.class)
    public ResponseEntity<ErrorResponse> handleFiltroInvalido(FiltroInvalidoException ex) {
        return ResponseEntity.badRequest().body(new ErrorResponse(ex.getMessage()));
    }
}
Esto elimina otro nivel de duplicación, pero todavía conviene conservar internamente las distintas categorías de fallo.
No es lo mismo recibir un Base64URL inválido que recibir un JSON malformado. Tampoco es lo mismo un JSON válido que no puede convertirse al DTO esperado, un DTO que incumple las validaciones, o un filtro completamente válido que no está permitido para determinado usuario.
No siempre es necesario exponer todas esas diferencias al consumidor. De hecho, en algunos casos sería contraproducente. Pero mantenerlas diferenciadas internamente puede resultar decisivo cuando haya que investigar un comportamiento extraño en producción.
La uniformidad hacia fuera no debería implicar perder información hacia dentro.
Si el consumidor no sabe qué codificar, el contrato está incompleto
Hay todavía otra pieza que suele olvidarse porque no afecta directamente al funcionamiento del endpoint: la documentación.
Una anotación personalizada como @Base64Filter no necesariamente será interpretada automáticamente por herramientas como springdoc-openapi como un parámetro de query convencional. Si el consumidor no recibe una explicación explícita, terminará teniendo que averiguar por su cuenta cómo construir la cadena.
Por ejemplo:
@Operation(
    summary = "Búsqueda de productos con filtro estructurado"
)
@Parameter(
    name = "filter",
    description =
        "Filtro JSON codificado en Base64URL según RFC 4648 §5",
    example =
        "eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhIn1dfQ",
    schema = @Schema(type = "string")
)
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(
            productoService.buscar(filtro)
    );
}
Una buena documentación debería mostrar las dos representaciones.
Por un lado, el JSON conceptual que el consumidor realmente quiere expresar. Por otro, la cadena Base64URL que debe enviar.
La transformación puede ser transparente para el servidor, pero no debe ser un misterio para quien consume la API.
El coste que aparece después: una URL que ya no se puede leer
Hasta este punto, Base64URL parece haber conseguido un equilibrio bastante atractivo: mantiene GET, conserva una URL autocontenida y evita llenar el query string de secuencias de escape.
Pero ese equilibrio tiene un precio evidente.
La URL deja de ser legible.
Un log como este:
GET /productos?filter=eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhI...
no permite saber inmediatamente qué filtros se utilizaron.
Y eso importa especialmente porque las URLs aparecen en muchos lugares que no están bajo el control directo del desarrollador que diseñó el endpoint: logs de servidores, herramientas de monitoreo, historial del navegador, sistemas de analítica y mecanismos de diagnóstico.
Es exactamente el costo que, como vimos antes, RSQL evita — a cambio de pedir una capa de traducción a persistencia y una allowlist mantenida activamente. Ninguna de las dos alternativas gana en todo; cada una conserva una propiedad distinta.
Cuándo RSQL se queda corto
Incluso en el escenario donde sí conviene la gramática de texto — filtros que mapean bien a atributos y operadores relacionales estándar —, hay límites concretos donde deja de alcanzar.
El primero es semántica propia. Un operador =between= con dos valores puede registrarse como extensión del parser, pero si el dominio necesita expresar algo como un rango con extremos configurables o un operador geoespacial con parámetros propios, la gramática obliga a inventar una notación que ya no es estándar. El DTO tipado puede incluir esos campos con semántica explícita.
El segundo es correlación en colecciones. Si Producto tiene una lista de Variante y la consulta necesita encontrar productos que tengan una variante que sea simultáneamente roja y con stock mayor a cero, una traducción directa campo-operador-valor genera un JOIN que evalúa las condiciones por separado. Puede devolver un producto con una variante roja sin stock y otra variante con stock pero de distinto color. Para expresar esa correlación hace falta un subquery o un EXISTS, que la gramática no modela.
El tercero es contexto de runtime. Un score de relevancia calculado en el momento de la petición, una distancia geoespacial o un ranking de machine learning no tienen representación natural como par campo-operador-valor.
Cuando el filtro cruza alguno de esos límites, Base64URL con DTO tipado vuelve a ser la opción más honesta: el contrato es explícito, los campos posibles están acotados por el tipo y la estructura puede ser tan específica como lo exija el dominio.
Cuando el filtro crece, el problema deja de ser de codificación
Hasta aquí estamos hablando de un escenario bastante concreto: filtros estructurados pero todavía razonablemente pequeños.
La situación cambia cuando la consulta empieza a crecer.
Decenas de condiciones. Listas extensas de identificadores. Estructuras anidadas varios niveles hacia abajo. Combinaciones complejas de operadores.
En ese momento, insistir en mantener todo dentro de una URL deja de ser una cuestión de encontrar una codificación más conveniente.
Se convierte en una decisión de diseño de interfaz.
Y es precisamente ahí donde POST vuelve a tener sentido, pero esta vez por una razón diferente a la del comienzo.
No se utiliza porque no hayamos encontrado una manera suficientemente ingeniosa de meter el filtro en un GET. Se utiliza porque el contrato ha cambiado y ahora el body es un lugar más apropiado para transportar una estructura grande.
POST /productos/search
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Se gana una representación natural del filtro y se evita someterlo a las limitaciones prácticas de una URL.
A cambio, la búsqueda deja de ser un recurso autocontenido en forma de enlace y pierde la misma naturalidad para el caché que tendría un GET.
Pero si el filtro ya ha alcanzado un tamaño que hace poco razonable mantenerlo en la URL, esa pérdida probablemente sea aceptable.
Una tercera posibilidad: QUERY
Existe además una alternativa más reciente que resulta conceptualmente interesante: el método HTTP QUERY.
La motivación es precisamente separar la semántica de una operación de consulta de la necesidad de transportar una estructura compleja en el body.
En teoría, encaja muy bien con el problema: una consulta segura podría mantener una semántica específica de consulta y, al mismo tiempo, recibir contenido estructurado sin tener que comprimirlo artificialmente dentro de la URL.
El inconveniente está en el ecosistema.
Que un método esté definido mediante un estándar no significa que navegadores, proxies, firewalls, gateways y otras piezas de infraestructura lo soporten con la misma madurez que GET o POST.
Por eso puede ser una opción interesante para mantener en el radar, especialmente cuando se controla de extremo a extremo la infraestructura, pero no necesariamente es la elección más conservadora para una API pública que necesita máxima interoperabilidad.
Cuando ni siquiera el body es suficiente
Hay todavía un escenario más extremo.
Supongamos que la consulta es muy grande, pero además se reutiliza constantemente. Enviar todo el filtro en cada petición puede empezar a resultar innecesario.
En ese caso, quizá el problema ya no consista en decidir cómo transportar el filtro, sino en dejar de transportarlo.
Una alternativa es convertir la búsqueda en un recurso persistente:
POST /saved-searches
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    }
  ]
}
El servidor puede almacenar esa definición y devolver un identificador:
HTTP/1.1 201 Created

Location: /saved-searches/abc123
A partir de ahí, las peticiones posteriores pueden referirse al identificador en lugar de reenviar toda la estructura.
La decisión es diferente porque también lo es el problema.
Ya no estamos intentando representar una búsqueda compleja dentro de una URL. Estamos modelando la búsqueda como un recurso que puede persistir y reutilizarse.
Del lado del frontend
Todas estas decisiones del backend tienen una contraparte en el cliente que construye la petición.
El problema no es solo cómo codificar el filtro. Es que si el filtro vive únicamente en el estado del componente, el usuario pierde la posibilidad de compartir la búsqueda, usar el botón atrás del navegador o guardarla como favorito. La URL deja de ser el estado de la pantalla.
La solución en Angular es sincronizar el filtro con los query params del Router en ambas direcciones. Cuando el usuario aplica filtros, la URL se actualiza. Cuando alguien llega con una URL que ya tiene filtros, el formulario se rellena y la búsqueda se ejecuta automáticamente.
Para Base64URL el helper de codificación es simple:
encode(filter: object): string {
  const json = JSON.stringify(filter);
  return btoa(unescape(encodeURIComponent(json)))
    .replace(/\+/g, '-')
    .replace(/\//g, '_')
    .replace(/=+$/, '');
}
Y la sincronización con el router:
// Al cambiar filtros → actualizar la URL
this.router.navigate([], {
  relativeTo: this.route,
  queryParams: { filter: this.encode(filter) },
  queryParamsHandling: 'merge'
});

// Al inicializar → leer filtros de la URL
this.route.queryParams.pipe(
  map(params => params['filter']),
  filter(Boolean),
  map(encoded => this.decode(encoded))
).subscribe(filter => {
  this.applyToForm(filter);
  this.search(filter);
});
Para RSQL la mecánica es idéntica. Solo cambia el formato del string que viaja en el param: en lugar de Base64URL opaco viaja una cadena legible como categoria=in=(electronica,hogar);precio=ge=100000. El router no distingue entre uno y otro.
Volver a aquella URL de 400 caracteres
Aquella URL llena de %7B%22and%22%3A no era realmente un problema de sintaxis.
Era una señal.
La complejidad de la consulta había empezado a superar la comodidad del mecanismo elegido para transportarla, pero todavía no se había tomado una decisión consciente sobre qué propiedad del contrato era importante conservar.
Si los filtros se mapean bien a campos de una entidad persistida y a operadores relacionales estándar, una gramática de texto como RSQL resuelve el problema con muy poco código y conserva la legibilidad de la URL — a costa de depender de una capa de traducción a persistencia y de mantener activamente una allowlist. Si el contrato del filtro es propio del dominio, con operadores específicos o estructuras que no encajan en el modelo relacional directo, Base64URL con DTO tipado ofrece un contrato explícito, no depende de ningún motor de datos particular, y su allowlist es estructural en lugar de operacional.
flowchart TD
    A[¿Qué tipo de filtros necesitás?] --> B
    A --> C
    A --> D
    A --> E

    B["Campos simples\nsin lógica compleja"]
    --> F["QueryDSL Web Bindings\nCero código, nativo Spring Data"]

    C["AND / OR sobre atributos\nde una entidad persistida"]
    --> G{¿Existe una capa que traduzca\ngramática de texto a persistencia?}
    G -->|Sí| H["RSQL / gramática similar\nCon allowlist explícita"]
    G -->|No| D

    D["Operadores custom\nlógica de dominio\ncolecciones correlacionadas"]
    --> I{¿Necesitás URL compartible?}
    I -->|Sí, filtro moderado| J["Base64URL + HandlerMethodArgumentResolver"]
    I -->|No, o filtro grande| K["POST /search\nBody JSON estructurado"]

    E["Filtros enormes\nreutilizados entre sesiones"]
    --> L["saved-searches como recurso\nPOST para crear, GET con ID para reutilizar"]
Cuando el filtro deja de ser razonablemente pequeño, el problema cambia de naturaleza. POST con JSON puede ser un contrato mucho más apropiado. Y si la búsqueda se vuelve grande y reutilizable, puede tener más sentido convertirla en un recurso persistente y referenciarla mediante un identificador.
La decisión correcta no consiste en elegir una tecnología y aplicarla a todas las búsquedas.
Consiste en reconocer que cada representación conserva unas propiedades y sacrifica otras.
Query params simples conservan una URL muy legible, pero se vuelven incómodos cuando la estructura crece. Una gramática de texto como RSQL mantiene esa legibilidad con más expresividad, pero exige que exista una capa de traducción a persistencia y una allowlist explícita mantenida activamente, o la superficie de ataque crece silenciosamente. Base64URL mantiene la búsqueda como GET y permite un contrato de filtro completamente propio, sin depender de ningún motor de datos particular, aunque sacrifica legibilidad en logs. POST recupera la representación natural del JSON cuando la consulta ya es demasiado grande. Y una búsqueda persistente elimina directamente la necesidad de reenviar una estructura que ya existe en el servidor.
El verdadero cambio, entonces, no está en Base64URL, en RSQL, en Spring Boot ni siquiera en HTTP.
Está en dejar de pedirle al mismo mecanismo que resuelva problemas de tamaños y necesidades diferentes.
Cuando una búsqueda es pequeña, puede viajar como una consulta.
Cuando necesita estructura pero todavía cabe razonablemente en una URL, puede codificarse, con la representación que mejor encaje con el contrato.
Cuando crece demasiado, puede pasar al body.
Y cuando se convierte en algo que se reutiliza como entidad propia, puede dejar de viajar por completo y convertirse en un recurso.
Ese es el criterio que permite que la arquitectura evolucione con la complejidad real del problema, en lugar de obligar a cada nueva necesidad a encajar a la fuerza en la decisión que se tomó cuando el endpoint todavía parecía sencillo.
Anexo: RSQL en el stack Java (Spring Boot + JPA)
Todo lo dicho sobre RSQL en el cuerpo del artículo es válido para cualquier stack que cuente con una capa de traducción gramática→persistencia equivalente. Este anexo muestra cómo se ve concretamente esa integración en el ecosistema Java, donde esa capa la provee la Criteria API de JPA a través de una Specification.
La integración más difundida usa un starter de terceros (no es un proyecto oficial de Spring) que convierte directamente la cadena RSQL en una Specification:
<dependency>
    <groupId>io.github.perplexhub</groupId>
    <artifactId>rsql-jpa-spring-boot-starter</artifactId>
    <version>6.0.18</version>
</dependency>
@GetMapping("/productos")
public Page<Producto> buscar(
        @RequestParam(defaultValue = "") String filter,
        Pageable pageable) {

    return productoRepository.findAll(
        RSQLJPASupport.toSpecification(filter),
        pageable
    );
}
Eso es todo el controlador. Sin anotaciones custom, sin resolver, sin ObjectMapper — la contrapartida es la dependencia externa a un motor de persistencia relacional vía JPA, que es justamente lo que el cuerpo del artículo señala como condición de existencia de este camino.
La allowlist mencionada antes se implementa recorriendo el AST que produce el parser de RSQL, antes de convertirlo en Specification, y rechazando cualquier campo fuera de lo permitido:
private void validarCamposPermitidos(String filter, Set<String> permitidos) {
    if (filter.isBlank()) return;

    new RSQLParser().parse(filter).accept(new RSQLVisitor<Void, Void>() {
        public Void visit(AndNode node, Void p) {
            node.getChildren().forEach(c -> c.accept(this, null)); return null;
        }
        public Void visit(OrNode node, Void p) {
            node.getChildren().forEach(c -> c.accept(this, null)); return null;
        }
        public Void visit(ComparisonNode node, Void p) {
            if (!permitidos.contains(node.getSelector()))
                throw new FiltroInvalidoException(
                    "Campo no permitido: " + node.getSelector());
            return null;
        }
    });
}
Y componer la Specification resultante con los filtros base que el usuario nunca debe poder eludir:
Specification<Producto> spec = RSQLJPASupport.<Producto>toSpecification(filter)
    .and((root, query, cb) -> cb.equal(root.get("eliminado"), false))
    .and((root, query, cb) -> cb.equal(root.get("tenantId"), TenantContext.get()));
En otro stack o con otro ORM, el nombre de las piezas cambia, pero el rol de cada una se mantiene: un parser de la gramática, un traductor hacia el mecanismo de consulta dinámica del ORM disponible, y una allowlist que se aplica sobre el árbol ya parseado antes de ejecutar nada contra la base de datos.

El tramo en cascada que todo proyecto ágil necesita (y casi ninguno tiene)
- Mauricio ECR
- Gestion
- 02 Aug, 2026
Llevas un tiempo trabajando en equipos que dicen practicar Scrum, y algo no termina de cuadrarte. Los sprints avanzan, la demo sale en tiempo, el tablero se vacía cada dos semanas. Y aun así, al cabo

El tramo en cascada que todo proyecto ágil necesita (y casi ninguno tiene)
- Mauricio ECR
- Gestion
- 02 Aug, 2026
Llevas un tiempo trabajando en equipos que dicen practicar Scrum, y algo no termina de cuadrarte. Los sprints avanzan, la demo sale en tiempo, el tablero se vacía cada dos semanas. Y aun así, al cabo de varios meses, el sistema tiene algo raro: funciona por partes, pero no tiene columna vertebral. Cada módulo fue una decisión tomada en el momento, sin conversación con las anteriores. Se ve ágil desde afuera. Se siente frágil desde adentro.
No es que el equipo sea poco disciplinado. Los rituales se hacen, el backlog está priorizado, el Product Owner participa. El problema es más silencioso que eso: nadie definió, antes de arrancar, qué parte del proyecto no puede improvisarse sprint a sprint. Y esa omisión, que parece menor al principio, se cobra con intereses compuestos.
Lo que nadie dice en la retrospectiva
El síntoma más claro aparece cuando alguien intenta cambiar algo que parecía simple. Un ajuste en el modelo de datos toca cuatro historias ya entregadas. Un nuevo servicio necesita un contrato que nadie documentó porque se asumió. Una integración que "ya estaba resuelta" resulta que cada equipo la resolvió a su manera. Cada uno de esos problemas tiene la misma raíz: una decisión estructural que se tomó con la misma liviandad que una tarea de sprint.
La fragilidad no nace de hacer sprints cortos. Nace de confundir dos tipos de decisiones que tienen costos de reversión completamente distintos, y tratarlas como si fueran iguales.
Hay decisiones de implementación —cómo se resuelve una historia de usuario específica, en qué orden se atacan las funcionalidades dentro de una misma capa, qué tan grande es cada tarea— que son baratas de revertir. Si una no funciona, la corriges en el siguiente sprint sin que nada estructural se rompa. Esas son exactamente las decisiones que se benefician de la flexibilidad ágil: se ajustan con la información más fresca posible, sprint a sprint, sin necesidad de comité.
Y hay decisiones estructurales —el modelo de datos central, los contratos entre servicios, los patrones de comunicación del sistema— que son caras de cambiar una vez que varios equipos ya construyeron sobre ellas. Cada sprint que pasa sin que esas decisiones estén tomadas es un sprint que agrega capas sobre cimientos que nadie inspeccionó. El costo de revertirlas no crece linealmente: crece con cada historia que asumió que esa decisión ya estaba resuelta.
El error que produce proyectos frágiles no es aplicar demasiado ágil. Es aplicar la flexibilidad de la capa barata en la capa cara.
La solución incómoda
La respuesta es que esa capa cara necesita el tratamiento opuesto: rigidez deliberada antes de que comience el primer sprint. Se define una vez, con la misma seriedad que un plano estructural, y cambiarla requiere un proceso formal, no una conversación de pasillo. Es, en ese tramo específico, exactamente lo que hace la cascada.
Decirlo así genera resistencia inmediata. "Eso es cascada" es la objeción más rápida, y es comprensible: el malestar con la rigidez de los proyectos tradicionales es real y justificado. Pero la objeción parte de una confusión sobre qué es lo que realmente distingue cascada de ágil, y vale la pena deshacerla antes de continuar.
Lo que define a la cascada no es tener fases, ni tener diseño antes de construcción, ni tener decisiones tomadas de antemano. Lo que la define es que el mapa completo de trabajo —qué se construye, en qué orden, con qué criterios— se cierra una sola vez al principio y no se vuelve a abrir con lo que se aprende en el camino. Un proyecto en cascada puede tener veinte subproyectos y entregas parciales. Sigue siendo cascada porque el subproyecto quince ya estaba escrito en el mes uno, aunque se ejecute en el mes diez, y lo que se aprendió construyendo el subproyecto tres no tuvo ningún efecto sobre él.
Lo que distingue a ágil es una sola cosa: cuando terminas de ejecutar una unidad de trabajo, lo que aprendiste ahí puede reescribir el contenido, el orden o la existencia de la unidad que sigue. Es un bit de información viajando en dirección contraria al plan. Ese bit es lo que mantiene vivo el aprendizaje. Y ese bit puede existir perfectamente en un proyecto que tiene una arquitectura base cerrada, contratos entre servicios definidos antes del primer sprint, y una Definition of Ready rigurosa. Nada de eso impide que lo aprendido en el sprint tres cambie el alcance del sprint seis. Solo impide que lo aprendido en el sprint tres destruya los cimientos sobre los que ya construyó el resto del equipo.
Aplicar rigidez en la capa cara no es cascada. Es reconocer que no todas las decisiones tienen el mismo costo de reversión, y tratarlas en consecuencia.
Dónde vive esa rigidez dentro de Scrum
Lo interesante es que no necesitas inventar nada por fuera del framework. Ágil ya tiene nombre para cada capa de este sistema de gobernanza, y los tres elementos son igual de obligatorios.
El primero es el walking skeleton: antes de que arranque el primer sprint de construcción, el equipo define un esqueleto funcional y liviano que recorre el sistema de punta a punta. No es el diseño completo — es lo mínimo necesario para que todos los equipos construyan sobre la misma base sin pisarse. Incluye las decisiones que son caras de revertir: el modelo de datos central, los contratos entre servicios, los patrones de comunicación, las convenciones técnicas que el resto del proyecto va a asumir como dadas. Quién lo construye es el equipo técnico completo, antes del sprint uno, con la misma formalidad con que un arquitecto firma un plano estructural. Lo que viene después puede crecer y cambiar libremente — precisamente porque ese esqueleto existe.
El segundo y el tercero viven dentro de cada sprint y protegen ese esqueleto historia por historia: la Definition of Ready es la puerta de entrada —ninguna historia entra a un sprint sin demostrar que respeta los contratos que el walking skeleton estableció—, y la Definition of Done es la puerta de salida —ninguna historia se declara terminada sin haber verificado que sigue encajando con el sistema completo, no solo con el módulo recién construido.
Dicho así suena razonable. El problema es que la mayoría de los equipos tratan esa puerta de entrada como un trámite: "la historia tiene criterios de aceptación, ya está lista". Eso responde apenas una parte de la pregunta. Antes de que una historia entre a un sprint, alguien tiene que haber respondido, con la misma seriedad con que un ingeniero civil revisa un plano antes de excavar, qué depende de qué.
No basta con saber que la historia es viable en abstracto. Hay que identificar explícitamente qué habilitadores necesita para poder construirse: un endpoint que todavía no existe, un cambio en el modelo de datos que otra historia debe entregar primero, un permiso o una integración externa que tarda en aprobarse. Y aquí está el punto que casi siempre se salta: no puedes nombrar esas dependencias con honestidad si nadie diseñó, aunque sea a nivel de solución técnica, cómo se va a construir esa historia en concreto.
Decir "esto depende de X" sin haber bajado al menos un boceto de la solución —qué componentes toca, qué contrato de datos necesita, por dónde entra y por dónde sale la información— no es identificar una dependencia, es adivinarla. Y las dependencias adivinadas son exactamente las que aparecen a mitad del sprint disfrazadas de sorpresa.
Lo que una DoR seria realmente exige
Por eso la rigidez concreta no está en agregar más preguntas a un checklist de planning. Está en aceptar que ninguna historia entra a un sprint sin haber pasado antes por un ejercicio de diseño de solución propio, específico para esa actividad. No el diseño de arquitectura completo del sistema —eso vive en el walking skeleton y rara vez se toca. Es un diseño más modesto pero igual de innegociable: la DoR deja de ser una intención difusa en el momento en que se convierte en un entregable verificable con campos obligatorios.
Ninguna historia entra a Sprint Planning sin esos campos completos, y no admite medias respuestas. Como mínimo:
- El diseño de solución específico de esa actividad: qué componentes toca, por dónde entra y sale la información, qué contratos consume o expone.
- La lista explícita de dependencias y habilitadores identificados a partir de ese diseño, no adivinados desde la descripción funcional.
- La estimación de esfuerzo apoyada en esa lista. Construir algo que necesita tres piezas ajenas no cuesta lo mismo que construir algo autocontenido, aunque la descripción funcional suene igual de simple.
- Los criterios de aceptación funcionales: lo que ve el usuario.
- Los criterios no funcionales: rendimiento, seguridad, manejo de errores, mantenibilidad. Una historia puede cumplir su criterio funcional y aun así ser un desastre para el sistema si nadie exigió que respetara los estándares que el resto del proyecto ya adoptó.
- Dos validaciones distintas: la del dueño de producto, que confirma que resuelve el problema del usuario; y la del responsable técnico, que confirma que la solución respeta la arquitectura y los lineamientos que el walking skeleton estableció.
Si a la historia le falta cualquiera de esos ítems, no está lista, sin importar qué tan urgente parezca meterla al sprint. No es un principio abstracto: es un documento con campos obligatorios que nadie puede saltarse por falta de tiempo, exactamente igual que un plano estructural no se salta porque la obra vaya con retraso.
Esa segunda validación —la del responsable técnico— es la que casi nunca se sienta en la conversación. El usuario final valida si la historia resuelve su problema, pero eso es necesario y no suficiente. Falta quien evalúe si el modo en que se va a construir mantiene viva la coherencia del sistema completo. Puedes tener una historia perfectamente aprobada por el producto y absolutamente inaceptable para quien tiene que mantener esa base de código dentro de un año. Si tu Definition of Ready solo mira la primera validación, ya sembraste el mismo desacople que estás intentando evitar.
La Definition of Done cierra el ciclo: exigir pruebas de integración contra el sistema completo —y no solo contra el módulo recién construido— garantiza que lo que se declara terminado realmente encaja con todo lo demás. Ninguna de estas tres piezas rompe el Scrum Guide. Todas simplemente convierten en obligatorio, para ese proyecto específico, algo que el framework siempre dejó como decisión de cultura de equipo —y que la mayoría, por prisa o por comodidad, nunca llegó a decidir en serio.
De vuelta al tablero
Lo que hace funcionar este sistema no es la cantidad de rigor que aplicas, sino dónde lo aplicas. La mayor parte del proyecto —reglas de negocio, funcionalidades, flujos de usuario— se beneficia de decidirse tarde, con la información más fresca posible. Solo una fracción pequeña necesita el tratamiento opuesto: definirse antes, con formalidad, y no tocarse sin proceso. El walking skeleton, la DoR y la DoD son exactamente los tres puntos donde esa fracción vive.
Cuando vuelves al tablero de ese sprint en el que todo se veía bien —los puntos avanzaban, la demo salía en tiempo, nadie levantaba la mano— y lo comparas con el sistema que quedó meses después, frágil, sin columna vertebral, con cada módulo viviendo en su propia realidad, la distancia entre los dos momentos ya tiene explicación. No fueron los rituales, ni la disciplina del equipo, ni el framework. Fue que nadie definió los tres puntos donde el rigor no es opcional: el walking skeleton que estableciera la base común, la DoR que obligara a diseñar antes de construir, y la DoD que verificara que cada pieza encajaba con el resto.
Eso no es traicionar el manifiesto ágil. Es leerlo con más cuidado.
Cuando un sistema debe ejecutar lo mismo siempre y algo distinto cada vez
- Mauricio ECR
- Arquitectura
- 24 May, 2026
Imagina que estás diseñando el flujo de solicitud de productos financieros de un banco. Un cliente puede pedir una tarjeta de crédito o un crédito para comprar un vehículo. Los dos productos son disti

Cuando un sistema debe ejecutar lo mismo siempre y algo distinto cada vez
- Mauricio ECR
- Arquitectura
- 24 May, 2026
Imagina que estás diseñando el flujo de solicitud de productos financieros de un banco. Un cliente puede pedir una tarjeta de crédito o un crédito para comprar un vehículo. Los dos productos son distintos: tienen pasos diferentes, documentos diferentes, validaciones diferentes. Pero también comparten algo que no puede variar: antes de que cualquier producto se evalúe, el banco necesita saber quién es el cliente, confirmar su identidad y consultar su historial crediticio. Eso ocurre siempre, para cualquier producto, sin excepción.
La pregunta que se presenta de inmediato parece técnica pero es en realidad arquitectónica: ¿dónde vive ese comportamiento compartido? ¿Lo repites en cada flujo de producto? ¿Lo centralizas en algún lugar y los flujos de producto lo invocan? ¿Construyes un flujo único con condicionales que bifurcan la lógica según el tipo de producto?
Cualquiera de esas tres respuestas funciona mientras el sistema es pequeño. El problema aparece cuando el banco decide lanzar un tercer producto, luego un cuarto. Cuando un equipo necesita cambiar la validación de identidad sin tocar los flujos de tarjeta ni de vehículo. Cuando hay que agregar un paso transversal nuevo y ese cambio no puede romper nada de lo que ya está operando. Ahí es donde las soluciones aparentemente razonables revelan su costo real.
Si duplicaste la lógica compartida, ahora debes modificarla en tres o cuatro lugares y confiar en que todos los cambios sean consistentes. Si la centralizaste mediante invocaciones directas, los flujos de producto están acoplados a ese componente central y cualquier cambio en él requiere verificar el impacto en todos los consumidores. Si construiste un flujo con condicionales, cada nuevo producto aumenta la complejidad del núcleo hasta que nadie entiende del todo qué hace ese código.
La tensión es real: hay pasos que deben ejecutarse de forma consistente en toda instancia del flujo, pero cada caso de negocio introduce lógica específica que no puede ni debe generalizarse. Y esa tensión no se resuelve eligiendo uno de los dos lados. Se resuelve separándolos con precisión y definiendo el mecanismo exacto por el que conviven.
La separación que sostiene todo lo demás
El problema que tienen las tres soluciones descritas antes es que todas intentan resolver la tensión desde el mismo lugar: deciden quién ejecuta qué. Una duplica la ejecución, otra la centraliza, otra la condiciona. Pero ninguna se hace la pregunta más profunda: ¿quién tiene el gobierno del flujo en cada momento?
Esa distinción importa porque gobernar el flujo no es lo mismo que ejecutar un paso. Gobernar significa saber en qué punto está el proceso, decidir qué viene después y ser responsable de que el flujo llegue a su fin de forma consistente. Cuando esa responsabilidad está dispersa entre varios componentes que ejecutan partes del proceso, nadie la tiene completamente. Y cuando nadie la tiene completamente, el flujo se fragmenta.
La respuesta natural a ese problema es concentrar el gobierno. Que haya un único responsable del flujo completo que sepa en todo momento dónde está el proceso y qué debe ocurrir a continuación. Ese responsable ejecuta lo que es común a todos los casos y, cuando llega el momento en que cada caso tiene su propia lógica, cede el gobierno temporalmente a quien sabe cómo manejarla. No lo invoca, no lo llama como si fuera una función: le transfiere el control de forma explícita, permanece en espera y lo recupera cuando termina.
Eso es exactamente lo que hace el núcleo transversal: concentra el gobierno del flujo completo, ejecuta los pasos que son comunes a todos los casos y cede el control cuando la especificidad de cada caso debe intervenir. Y eso es exactamente lo que hace un módulo de extensión: recibe ese control, ejecuta la lógica propia de su caso y lo devuelve. El módulo no conoce al núcleo, no depende de él y no lo dirige. Solo sabe que en algún momento va a recibir el gobierno y que cuando termine debe devolverlo.
Para que esa cesión y esa devolución ocurran con precisión, ambas partes necesitan saber en todo momento dónde están y qué viene después. Ese mecanismo es una máquina de estados: un registro del punto exacto en que se encuentra el proceso y un conjunto de transiciones válidas desde ahí. El núcleo tiene la suya, que gobierna sus pasos transversales. Cada módulo tiene la propia, completamente independiente, que gobierna sus pasos específicos. Cuando el núcleo cede el gobierno, su máquina de estados transiciona a un estado que reconoce explícitamente esa cesión. Mientras está en ese estado, cualquier solicitud de navegación que llegue al núcleo es redirigida al módulo activo. Cuando el módulo termina, el núcleo recibe el control de vuelta y su máquina de estados avanza hacia el cierre.
El flujo, visto desde afuera, parece continuo. Visto desde adentro, está compuesto por pasos atómicos: unidades independientes que no conocen ni necesitan conocer los pasos anteriores ni los siguientes. Cada paso se ejecuta, produce un resultado, lo persiste y termina. La secuencia no es responsabilidad del paso, es responsabilidad de la máquina de estados que lo gobierna.
Esa independencia entre pasos le da al flujo algo que los modelos continuos no tienen: la capacidad de pausarse sin romperse. Si un paso necesita información del cliente, el flujo persiste su estado completo y se detiene. Cuando el cliente responde, la máquina de estados retoma exactamente desde donde estaba. Y si el cliente quiere corregir algo que ya ingresó, puede retroceder: la máquina activa, sea la del núcleo o la del módulo, hace la transición hacia atrás y el paso anterior vuelve a estar disponible.
Un núcleo que no cambia pero se adapta
La estabilidad del núcleo es una decisión de diseño, no una limitación técnica. Cuando se incorpora un nuevo producto al banco, el núcleo no se modifica. No necesita saber qué pasos tiene el nuevo módulo, qué validaciones aplica ni qué documentos solicita. Lo único que necesita es que el módulo cumpla un contrato: un acuerdo lógico formal que define las reglas mínimas de interacción entre el núcleo y cualquier módulo que quiera participar del flujo. El módulo no tiene referencia al núcleo ni a otros módulos. Su única dependencia es hacia ese contrato.
Ese contrato es deliberadamente mínimo. En el momento de la cesión, el núcleo no le entrega al módulo un paquete de información recopilada durante la parte transversal. Le entrega una sola cosa: el identificador de la transacción en curso, un identificador único que el núcleo genera cuando el flujo se inicia y que lo acompaña hasta el cierre. Con ese identificador, el módulo puede relacionar cada uno de sus pasos con la transacción correcta. Y si en algún punto de su ejecución necesita información que el núcleo recolectó durante la parte transversal, como los datos del cliente o el resultado de la validación de identidad, la solicita activamente a través de los endpoints que el núcleo expone para ese propósito.
Eso resuelve un problema que los modelos con contratos de entrada ricos suelen enfrentar: si el núcleo evoluciona y empieza a recolectar información nueva, no hay necesidad de modificar el contrato de cesión ni de actualizar los módulos existentes. El núcleo simplemente expone un endpoint nuevo. Los módulos que necesitan esa información lo adoptan cuando lo necesitan. Los que no lo necesitan no saben que existe y no se ven afectados.
Pero la estabilidad del núcleo no significa rigidez. Cuando un módulo se registra, puede declarar una configuración que adapta ciertos comportamientos del núcleo para su caso particular: activar o desactivar capacidades transversales, ajustar ciertas acciones según las respuestas esperadas. La distinción es precisa: el núcleo decide desde su diseño qué aspectos son adaptables y los expone de forma explícita. Un módulo solo puede moverse dentro de ese espacio predefinido, nunca ampliarlo ni redefinirlo. Lo que no fue diseñado como configurable permanece invariante sin importar qué módulo se registre.
Cómo se registra un módulo
Antes de que cualquier flujo pueda ejecutarse, cada módulo debe registrarse en el núcleo. Este proceso ocurre una única vez por módulo y es completamente independiente del flujo de ejecución.
El módulo se presenta ante el componente de registro del núcleo, declara su identidad y entrega su configuración. Como parte de esa configuración, declara también el listado completo de sus pasos: cuántos son y cómo se llama cada uno. Esa información queda almacenada en el núcleo como dato estático y se convierte en la fuente de verdad para el indicador de progreso que verá el cliente durante el flujo. El núcleo valida que el módulo cumpla el contrato de extensión y que su configuración sea válida dentro del espacio de adaptación permitido. Si todo es correcto, el módulo queda disponible para ser invocado.
A partir de ese momento el núcleo sabe que ese módulo existe, cómo debe comportarse cuando sea invocado y cuántos pasos lo componen. No sabe nada más. No conoce la lógica interna del módulo, no puede modificarla y no necesita hacerlo.
Cómo se ejecuta el flujo
Cuando el cliente inicia una solicitud e indica qué producto desea, el núcleo busca el módulo correspondiente, carga su configuración y adapta su comportamiento dentro de los límites predefinidos. Su máquina de estados transiciona al primer estado activo.
El primer paso es el preprocesamiento: el núcleo normaliza y construye el contexto inicial del flujo. En el caso del banco, esto incluye los datos básicos del cliente que llegaron con la solicitud. Al completarse, persiste el estado y la máquina de estados avanza al siguiente paso.
El siguiente paso es la validación transversal. El núcleo confirma la identidad del cliente y consulta su historial crediticio. Si alguna de esas validaciones requiere información adicional del cliente, el flujo se pausa, persiste su estado completo y espera. Cuando el cliente responde, la máquina de estados retoma exactamente desde donde estaba y la validación continúa. Al completarse, el estado se persiste y la máquina de estados avanza.
Es en este punto donde el flujo hace algo que ninguno de los tres modelos anteriores podía hacer limpiamente: reconoce que lo que sigue ya no le pertenece. La máquina de estados del núcleo transiciona al estado de control delegado y genera el identificador único de la transacción en curso. Ese identificador es lo único que el núcleo le entrega al módulo en el momento de la cesión. Con él, el módulo sabe a qué transacción pertenece cada uno de sus pasos. Y con él, puede consultar al núcleo cualquier información que necesite de la parte transversal ya completada.
A partir de ese instante, la máquina de estados del módulo toma el gobierno. El núcleo permanece en ese estado de espera activa, sin intervenir. Toda solicitud de navegación que llegue al núcleo durante este período es redirigida al módulo activo.
La máquina de estados del módulo activa sus pasos en la secuencia que ella misma define. Cada paso se ejecuta, produce un resultado y termina. Si un paso requiere interacción con el cliente, el flujo se pausa y espera exactamente igual que en la parte transversal. Después de cada paso, el estado se persiste y la máquina evalúa si hay un paso siguiente o si el módulo ha terminado.
Cuando no hay más pasos, el módulo devuelve el control al núcleo. La máquina de estados del núcleo transiciona desde el estado de control delegado hacia el cierre: registra la trazabilidad del flujo completo, persiste el estado final y notifica al cliente que el proceso ha concluido.
Lo que ve el cliente durante todo este proceso
Desde la perspectiva del cliente, el flujo es una secuencia continua de pantallas con un indicador de progreso que avanza. No hay ninguna señal visible de que en algún punto el gobierno pasó de una máquina de estados a otra. Esa continuidad no es cosmética: es el resultado de dos decisiones de diseño que trabajan juntas.
La primera es que el núcleo actúa como proxy de navegación. Toda instrucción del cliente, avanzar, retroceder, saltar a un paso anterior, cancelar, llega siempre al núcleo. El núcleo evalúa en qué punto del flujo se encuentra y decide si la ejecuta directamente o la redirige al módulo activo. El cliente nunca sabe esa distinción. Para él, siempre está hablando con el mismo interlocutor.
La segunda es que el indicador de progreso funciona sin necesidad de consultar al módulo en cada momento. El núcleo ya sabe cuántos pasos tiene el flujo completo desde el registro: el módulo declaró sus pasos al registrarse y esa información quedó almacenada de forma estática. Durante la ejecución, el núcleo solo necesita consultar al módulo por el paso actual, y únicamente cuando el control está delegado. El total de pasos nunca cambia y nunca necesita preguntarse de nuevo.
Con esas dos piezas en su lugar, cada pantalla puede ser completamente autónoma. No necesita conocer el flujo completo para saber qué mostrar ni con quién hablar. La navegación, avanzar, retroceder, saltar, cancelar, siempre pasa por el núcleo. Pero la interacción propia de cada paso, los datos que el cliente ingresa y las respuestas específicas de ese punto del flujo, van directamente al responsable de ese paso: el núcleo si el paso es transversal, el módulo si el paso le pertenece a él. Esto es posible porque cada pantalla es tan atómica como el paso que representa: desde el diseño se definen sus puntos de comunicación, con quién habla y para qué. No hay lógica en tiempo de ejecución que decida eso. La pantalla ya lo sabe.
Los comandos que el cliente puede dar en cualquier momento del flujo, y quién los resuelve, son los siguientes:
| Comando | Propósito | Quién resuelve la lógica |
|---|---|---|
| Consulta de pasos | Obtiene el total de pasos y el nombre de cada uno | Núcleo, usando el dato declarado en el registro del módulo |
| Consulta de progreso | Retorna el total de pasos, el paso actual y el último paso completado | Núcleo. Cuando el control está delegado, consulta al módulo por el paso actual |
| Siguiente | Avanza al siguiente paso lógico | Núcleo si el paso es transversal, módulo si el paso es del módulo |
| Atrás | Retrocede al paso anterior | Núcleo si el paso es transversal, módulo si el paso es del módulo |
| Salto | Navega a un paso específico, siempre que no supere el último paso alcanzado | Núcleo si el destino es transversal, módulo si el destino es del módulo |
| Cancelar | Termina el flujo completamente | Núcleo |
Lo que esta tabla muestra, más allá de los detalles técnicos, es que el cliente siempre tiene el mismo conjunto de comandos disponibles sin importar en qué parte del flujo se encuentra. El hecho de que algunos los resuelva el núcleo y otros el módulo es invisible para él. Y esa invisibilidad es exactamente lo que permite que el caso del banco, con sus dos productos distintos, se sienta como una sola experiencia coherente.
Lo que esta separación realmente cuesta
Sería deshonesto presentar este modelo sin nombrar lo que exige.
El contrato de extensión debe estar bien definido desde el principio. No en términos de la información que se transfiere en la cesión, que es mínima por diseño, sino en términos de las reglas de interacción: cómo se registra un módulo, qué debe declarar, cómo devuelve el control y qué formato tienen las respuestas que el núcleo espera. Si esas reglas están mal definidas o son ambiguas, los módulos las interpretarán de formas distintas y el flujo producirá comportamientos inconsistentes que son difíciles de rastrear porque la causa no está en la lógica de ningún paso sino en el acuerdo que los articula.
La máquina de estados de cada módulo requiere diseño cuidadoso. No es compleja en términos de implementación, pero sí requiere que quien diseña el módulo tenga claridad total sobre la secuencia de sus pasos, las transiciones válidas y los estados de pausa. Un módulo con una máquina de estados mal definida produce comportamientos inconsistentes que son difíciles de rastrear porque la lógica de secuencia está separada de la lógica de cada paso. Cuando algo falla, no es obvio si el problema está en el paso que se ejecutó o en la transición que lo activó.
Los endpoints que el núcleo expone para que los módulos consulten información transversal deben tratarse con la misma disciplina que el contrato de extensión. Son una interfaz pública que los módulos van a consumir, y cualquier cambio en ellos tiene el potencial de romper módulos existentes. Agregar endpoints nuevos es seguro: los módulos que no los necesitan simplemente no los usan. Pero modificar o eliminar endpoints existentes requiere coordinación con todos los módulos que los consumen, y esa coordinación tiene un costo real que crece con la cantidad de módulos operativos.
El modelo de proxy de navegación en el núcleo introduce una dependencia en tiempo de ejecución que debe estar bien resuelta. Cuando el núcleo redirige una solicitud de navegación al módulo activo, necesita tener una referencia válida a ese módulo. Si el módulo no está disponible por cualquier razón, esa solicitud falla. Esto no es diferente a cualquier otra dependencia en tiempo de ejecución, pero debe tenerse en cuenta en el diseño de tolerancia a fallos del sistema.
Finalmente, la disciplina de no modificar el núcleo es una restricción organizacional además de técnica. En la práctica, siempre hay presión para agregar una excepción aquí, un comportamiento especial allá. Cada vez que esa presión cede, el núcleo pierde algo de su estabilidad y el modelo empieza a degradarse. Mantener esa disciplina requiere que el equipo entienda bien por qué el núcleo es cerrado a modificación, no solo que sepa que lo es.
Todo ese costo tiene un punto de equilibrio. Si el sistema tiene un solo tipo de caso y es poco probable que eso cambie, el modelo agrega complejidad estructural sin beneficio real. La separación entre núcleo y módulos, las dos máquinas de estados, el contrato de extensión, los endpoints de consulta: todo eso se justifica cuando hay variabilidad real entre casos, cuando el comportamiento transversal necesita mantenerse consistente y evolucionar de forma independiente, y cuando la incorporación de nuevos casos debe ser posible sin riesgo sobre lo que ya está operando. Cuanto más de esas tres condiciones se cumplen, más sentido tiene asumir la exigencia que el modelo impone.
De vuelta al banco
Con el modelo completo sobre la mesa, el caso del banco deja de verse como un flujo de productos financieros y empieza a revelar el problema arquitectónico que realmente estaba presente desde el principio.
La dificultad nunca fue únicamente validar identidad, consultar historial crediticio o pedir documentos distintos según el producto. Eso podía resolverse de muchas maneras. El problema real era otro: cómo permitir que el sistema creciera sin que cada nuevo producto aumentara el acoplamiento, duplicara lógica o volviera más frágil el flujo completo.
Cuando el núcleo concentra únicamente las responsabilidades transversales y los productos viven en módulos independientes con su propia máquina de estados, el crecimiento deja de sentirse como una modificación del sistema existente y empieza a comportarse como una extensión controlada. Nuevos productos pueden incorporarse sin intervenir los flujos que ya operan, los equipos dejan de depender entre sí para evolucionar casos específicos y la complejidad deja de acumularse en un único lugar.
Hoy existen dos productos. Mañana habrá créditos hipotecarios, productos empresariales, validaciones regulatorias nuevas y recorridos especializados que todavía no existen. Cada uno traerá lógica distinta, pasos distintos y reglas distintas. Pero todos seguirán compartiendo la misma necesidad transversal: entender quién es el cliente antes de tomar cualquier decisión.
El valor del modelo no está en resolver bien los dos productos actuales. Está en evitar que el tercer producto convierta al sistema en algo más difícil de modificar que el segundo. Está en permitir que la variabilidad crezca sin que el núcleo pierda estabilidad. Está en separar la evolución de los productos de la evolución del flujo transversal.
Las tres soluciones iniciales parecían razonables mientras el sistema era pequeño. Duplicar lógica, centralizar mediante invocaciones directas o resolver todo con condicionales podían funcionar durante un tiempo. El problema aparecía después, cuando cada nuevo caso hacía que el sistema completo fuera más difícil de entender, probar y evolucionar. La pregunta que el banco se hacía al principio, dónde vive el comportamiento compartido, no tenía una respuesta técnica. Tenía una respuesta arquitectónica. Y la diferencia entre las dos es exactamente lo que determina si el cuarto producto se incorpora con la misma facilidad que el segundo o si para entonces ya nadie quiere tocar ese código.
Arquitectura Modular por Contexto: Cuando la Teoría se Encuentra con la Realidad
- Mauricio ECR
- Arquitectura
- 21 Mar, 2026
Has estado ahí. Es lunes por la mañana, abres el proyecto en tu IDE, y necesitas modificar cómo se procesa un pedido. Treinta minutos después, todavía estás navegando entre carpetas intentando encontr

Arquitectura Modular por Contexto: Cuando la Teoría se Encuentra con la Realidad
- Mauricio ECR
- Arquitectura
- 21 Mar, 2026
Has estado ahí. Es lunes por la mañana, abres el proyecto en tu IDE, y necesitas modificar cómo se procesa un pedido. Treinta minutos después, todavía estás navegando entre carpetas intentando encontrar todas las piezas del rompecabezas. El caso de uso está en algún lugar del módulo de dominio, el controlador REST disperso en los entry points, el adaptador de base de datos perdido en persistencia, y probablemente algunos DTOs compartidos en carpetas que juraste que recordarías. Este es el dilema que enfrentamos constantemente: las herramientas que usamos nos imponen una estructura técnica impecable, pero nuestro cerebro humano necesita algo diferente. Necesitamos que todo lo relacionado con "procesar un pedido" esté junto, fácil de encontrar, fácil de entender, fácil de modificar.
La Estructura que las Herramientas Imponen
Para entender el problema, primero necesitamos entender cómo funcionan las herramientas de scaffolding modernas, particularmente Scaffolding of Clean Architecture—una herramienta que muchas organizaciones adoptan porque estandariza proyectos y acelera su inicio. Esta herramienta genera automáticamente una estructura basada en Clean Architecture, pero con una característica particular: todo se organiza estrictamente por naturaleza técnica a través de módulos independientes de Gradle. No son simples carpetas; son módulos que se compilan independientemente, gestionan sus propias dependencias, y establecen fronteras arquitectónicas reales. La estructura generada típicamente incluye: Un módulo de dominio completamente independiente, sin dependencias hacia otros módulos del proyecto. Aquí viven las entidades, los casos de uso, los servicios de dominio, y crucialmente, las interfaces (gateways) que definen qué operaciones necesita el dominio sin especificar cómo se implementan. Es el núcleo puro de la lógica de negocio. Un módulo de infraestructura que se subdivide en dos grandes grupos. Por un lado, los "driven adapters"—módulos para implementar persistencia (jpa-repository), para consumir servicios externos (rest-consumer), para publicar mensajes (message-sender), y otros adaptadores que implementan los contratos que el dominio define. Por otro lado, los "entry points"—módulos para exponer APIs REST (api-rest), para consumir eventos (message-listener), para tareas programadas (scheduled-task), y otros puntos de entrada al sistema. Un módulo de aplicación que ensambla todo, conteniendo la configuración que conecta las piezas, los aspectos transversales como logging y auditoría, y el punto de arranque que levanta el sistema. Desde una perspectiva arquitectónica pura, es hermoso. Inversión de dependencias impecable: el dominio define contratos, la infraestructura los implementa. Separación clara de responsabilidades: cada módulo tiene su propósito bien definido. Fronteras forzadas por el sistema de build: no puedes violar accidentalmente las dependencias porque Gradle simplemente no compilará.
El Problema que Nadie Quiere Admitir
Pero entonces llega el día a día del desarrollo, y la fricción se hace evidente.
Necesitas implementar una nueva funcionalidad: registrar un usuario. Ejecutas el comando de scaffolding para generar el caso de uso. La herramienta lo crea en domain/usecase/ en una estructura genérica. Ejecutas otro comando para generar el entry point REST. Se crea en infrastructure/entry-points/api-rest/ en otra ubicación genérica. Necesitas persistencia, ejecutas el comando para generar el adaptador JPA. Aparece en infrastructure/driven-adapters/jpa-repository/ en su propia ubicación técnica.
Cada componente vive exactamente donde debe vivir según su naturaleza técnica. El problema es que conceptualmente todos estos componentes están relacionados—todos son parte de "registrar un usuario"—pero físicamente están dispersos por toda la estructura del proyecto según su clasificación técnica.
El resultado es predecible: cinco pestañas abiertas en tu IDE, navegación constante entre módulos y carpetas, DTOs compartidos en ubicaciones centralizadas que sirven a múltiples propósitos, validadores reutilizables que intentan ser genéricos, y mappers comunes que traducen entre representaciones para varios casos de uso.
Y hay algo peor: seis meses después, cuando otro desarrollador necesita modificar esa funcionalidad de registro de usuarios, el proceso se repite. Buscar, navegar, intentar recordar dónde quedaron todas las piezas dispersas. El conocimiento está fragmentado, la comprensión es difícil, y cada modificación se siente como resolver un rompecabezas.
La pregunta natural surge: ¿por qué no simplemente abandonar esta estructura modular y volver a algo más simple donde todo esté junto? Porque entonces perdemos beneficios reales que los módulos independientes proporcionan: compilación incremental que solo recompila lo que cambió, gestión explícita de dependencias que previene acoplamiento accidental, y fronteras arquitectónicas forzadas que mantienen la integridad del diseño a largo plazo.
O podrías pensar: ¿por qué no compartir más componentes entre funcionalidades? Crear carpetas centralizadas de DTOs reutilizables, validadores comunes, mapeadores genéricos. Suena eficiente hasta que dos funcionalidades que comparten un validador divergen en sus necesidades. Entonces enfrentas la decisión imposible: ¿modificas el validador compartido arriesgando romper la otra funcionalidad, o duplicas el código que justamente intentabas evitar?
La Solución Está en la Dualidad
La respuesta no está en elegir entre estructura técnica o cohesión conceptual. La respuesta está en reconocer que ambas son valiosas pero en diferentes niveles.
Imagina mantener la estructura de módulos técnicos que Scaffolding of Clean Architecture genera—porque proporciona beneficios arquitectónicos reales—pero cambiar radicalmente cómo organizas el código dentro de cada módulo. En lugar de estructuras técnicas genéricas donde todos los componentes del mismo tipo conviven en carpetas planas, organizas por contextos de negocio donde cada funcionalidad tiene su propio espacio autocontenido.
El módulo de dominio sigue siendo un módulo de dominio, pero cuando lo abres, en lugar de encontrar una carpeta usecase/ con cincuenta casos de uso en una lista plana, encuentras algo diferente. Cada caso de uso vive en su propia carpeta de contexto: usecase/registrar-usuario/, usecase/procesar-pedido/, usecase/consultar-inventario/. Cada contexto agrupa todo lo que esa funcionalidad específica necesita.
Dentro de registrar-usuario/ no solo está el archivo del caso de uso. Está su carpeta dto/ con los DTOs de entrada y salida diseñados exactamente para lo que este caso de uso necesita—no DTOs genéricos compartidos que intentan servir múltiples propósitos. Está su carpeta mapper/ con traductores que mapean precisamente entre las representaciones que este caso de uso maneja. Está su carpeta validator/ con validadores que aplican las reglas específicas de negocio de registrar usuarios. Si necesita enriquecer datos desde otras fuentes, tiene su carpeta enricher/. Si requiere utilidades especializadas, tiene su carpeta util/.
Todo junto. Todo cohesivo. Todo autocontenido.
Lo mismo sucede en el módulo de entry points. En lugar de una carpeta genérica api-rest/ con todos los controladores mezclados, encuentras api-rest/registrar-usuario-api/ como su propio contexto. Dentro están los DTOs específicos de la API REST—diferentes de los DTOs del caso de uso porque representan el contrato externo, no el contrato de dominio. Están los mapeadores que traducen entre el mundo HTTP y el mundo del dominio. Están los validadores específicos de la capa de presentación que verifican formatos y restricciones del protocolo.
Y en el módulo de adaptadores, en lugar de entidades JPA genéricas en una carpeta común, encuentras jpa-repository/usuario-persistencia/ como contexto autocontenido con sus entidades JPA, sus repositorios Spring Data, su implementación del gateway del dominio, sus mapeadores entre entidades JPA y entidades de dominio, todo junto porque conceptualmente pertenece junto.
La estructura de módulos técnicos permanece intacta. El dominio sigue siendo independiente. Los adaptadores siguen implementando contratos del dominio. Los entry points siguen invocando casos de uso. Clean Architecture se mantiene en todo su esplendor. Pero dentro de cada módulo, la organización refleja el negocio, no solo la técnica.
Los Beneficios Tangibles que Cambian Todo
Esta dualidad—módulos técnicos afuera, contextos de negocio adentro—transforma radicalmente la experiencia de desarrollo.
Cuando necesitas modificar el registro de usuarios seis meses después de implementarlo, abres domain/usecase/registrar-usuario/ y todo está ahí. No hay búsquedas en carpetas compartidas. No hay intentos de recordar dónde quedó el validador o el mapper. La lógica del caso de uso, sus DTOs, sus validadores, sus enriquecedores, sus utilidades—todo en un solo lugar. Abres api-rest/registrar-usuario-api/ y encuentras todo lo relacionado con cómo esa funcionalidad se expone vía REST. Abres jpa-repository/usuario-persistencia/ y encuentras todo lo relacionado con cómo se persiste.
La velocidad de comprensión se dispara. Un desarrollador nuevo asignado a modificar una funcionalidad específica puede abrir su contexto y ver inmediatamente qué hace, cómo lo hace, y qué elementos utiliza. No necesita entender todo el sistema, solo el contexto específico con el que trabajará. El onboarding que solía tomar semanas ahora toma días porque el conocimiento no está disperso por todo el código base sino contenido en unidades comprensibles.
El mantenimiento se simplifica dramáticamente. Un bug en el procesamiento de pedidos significa ir a domain/usecase/procesar-pedido/. La mayoría de las veces, el problema y la solución están completamente contenidos en ese contexto. Haces el cambio, ejecutas los tests de ese contexto específico, y tienes alta confianza de que no rompiste nada más porque la independencia entre contextos minimiza los efectos colaterales.
La evolución del sistema se vuelve orgánica y natural. Una funcionalidad crítica del negocio crece en complejidad: agregas más validadores en su carpeta validator/, más enriquecedores en su carpeta enricher/, más utilidades en su carpeta util/. Otra funcionalidad permanece simple porque así lo requiere el negocio, con solo el caso de uso, un par de DTOs, y un mapper básico. No hay presión por mantener todo al mismo nivel de complejidad o estructura uniforme. Cada contexto crece según sus propias necesidades.
El trabajo en equipo fluye mejor sin fricción constante. Múltiples desarrolladores trabajan simultáneamente en diferentes contextos—uno en registrar usuarios, otro en procesar pedidos, un tercero en consultar inventario—sin colisionar porque el código está físicamente separado. Los conflictos de merge que solían ser diarios ahora son raros. Las revisiones de código son más efectivas porque los cambios están claramente contenidos: puedes ver exactamente qué se modificó dentro de un contexto específico y entender su alcance sin necesitar conocimiento exhaustivo de todo el sistema.
Y quizás lo más valioso: la confianza al hacer cambios. Cuando todo lo relacionado con una funcionalidad está junto y los contextos son genuinamente independientes, puedes modificar código con la confianza de que tus cambios no tendrán efectos colaterales sorpresa en funcionalidades no relacionadas. Los tests del contexto verifican que no rompiste esa funcionalidad específica, y la independencia entre contextos garantiza que no afectaste otras inadvertidamente.
El Principio de Duplicación Intencional
Pero hay un elefante en la habitación que necesitamos abordar directamente: verás código aparentemente duplicado. Y eso va a incomodarte.
Dos contextos tendrán validadores que lucen similares. Tres contextos tendrán mappers que parecen hacer traducciones parecidas. Varios contextos tendrán utilidades que se ven redundantes. Tu instinto—entrenado por años de escuchar "Don't Repeat Yourself"—gritará que esto está mal, que debes extraer, generalizar, compartir.
Necesitas resistir ese impulso porque está basado en una falsa equivalencia entre similitud y identidad.
Dos validadores que hoy lucen idénticos no son el mismo concepto. Uno valida emails en el contexto de registrar usuarios, donde quizás solo verificas el formato básico. Otro valida emails en el contexto de enviar campañas de marketing, donde quizás verificas que el dominio no esté en una lista de bloqueo, que el usuario haya dado consentimiento, que el email haya sido verificado previamente. Parecen el mismo código hoy, pero representan reglas de negocio de contextos diferentes que inevitablemente divergirán mañana.
Si hubieras compartido ese validador "para no duplicar código", cuando uno de los contextos necesite evolucionar—y lo necesitará—enfrentarás una decisión imposible. O modificas el validador compartido y arriesgas romper todos los contextos que lo usan, o agregas condicionales que verifican desde qué contexto se está llamando (acoplamiento horrible), o terminas duplicando el código de todas formas cuando la presión del deadline no te deja tiempo para refactorizaciones elegantes.
La duplicación intencional es el precio que pagas por la independencia. Y resulta ser un precio extraordinariamente bajo comparado con el costo del acoplamiento que crearías compartiendo componentes prematuramente.
Esto no significa nunca compartir nada. Significa compartir solo lo que tiene una razón de negocio genuina para ser compartido. Un modelo de dominio como Usuario que representa el mismo concepto fundamental a través de múltiples contextos merece vivir en domain/model/usuario/ como elemento transversal. Un servicio de dominio con lógica compleja de cálculo de precios que múltiples casos de uso invocan justifica su existencia en domain/service/calculo-precios/. Pero un validador que casualmente verifica el mismo formato en dos contextos diferentes no necesita ser compartido solo porque el código se ve similar.
La guía es simple: extrae como transversal solo cuando hay identidad conceptual de negocio, no cuando hay mera similitud técnica superficial. Y cuando dudes, prefiere duplicar. Es más fácil extraer código duplicado después cuando verdaderamente lo necesitas que desenredar dependencias compartidas cuando los contextos necesitan divergir.
Cómo Convive con las Herramientas de Scaffolding
La pregunta práctica que surge inmediatamente es: si Scaffolding of Clean Architecture genera código en ubicaciones genéricas basadas en naturaleza técnica, ¿cómo logras esta organización por contextos?
La respuesta es un flujo de trabajo disciplinado que combina generación automática con reorganización consciente.
Cuando necesitas crear un caso de uso, ejecutas el comando de scaffolding que lo genera en domain/usecase/ en una estructura base genérica. Inmediatamente después, antes de escribir una línea de lógica, creas manualmente la carpeta de contexto domain/usecase/nombre-funcionalidad/ y mueves el archivo generado ahí. Creas las subcarpetas que ese caso de uso específico necesitará: dto/, mapper/, validator/, etc.
Cuando generas un entry point REST, el scaffolding lo crea en infrastructure/entry-points/api-rest/ en ubicación genérica. De inmediato creas la carpeta de contexto api-rest/nombre-funcionalidad-api/ y reorganizas. Cuando generas un adaptador de persistencia, se crea en infrastructure/driven-adapters/jpa-repository/ genéricamente. Creas jpa-repository/contexto-persistencia/ y contextualizas.
El scaffolding proporciona el esqueleto técnico correcto en el módulo correcto con la estructura base apropiada. Tú proporcionas la organización conceptual que refleja el negocio. Es trabajo adicional, sí, pero es trabajo que pagas una vez y recuperas mil veces cada vez que necesitas encontrar, entender, o modificar código.
Esta reorganización no puede ser opcional ni algo que "haremos cuando tengamos tiempo". Debe ser parte no negociable del proceso de desarrollo desde el día uno. Cada componente generado se contextualiza inmediatamente antes de comenzar a escribir su lógica. Las revisiones de código verifican no solo que el código funciona sino que está correctamente organizado en su contexto apropiado.
La disciplina es crucial porque es fácil tomar atajos bajo presión. "Solo por esta vez dejaré el código donde el scaffolding lo generó, no tengo tiempo de reorganizar ahora." Pero esos atajos se acumulan. La estructura se vuelve inconsistente—algunos componentes contextualizados, otros dispersos genéricamente—y gradualmente pierdes todos los beneficios. Es como mantener limpia una cocina: si lavas los platos después de cada comida es fácil, si los dejas acumular se vuelve insoportable.
Maximizando los Beneficios: Desarrollo Outside-In
Con la estructura clara y el proceso de reorganización establecido, hay una práctica que potencia enormemente los beneficios de esta organización por contextos: el desarrollo outside-in. No es obligatorio seguir este enfoque, pero resulta extraordinariamente efectivo para avanzar con la seguridad de que cada paso está correctamente implementado antes de pasar al siguiente. Esta afirmación se entiende mejor al contrastarla con los inconvenientes de la forma tradicional de iniciar el desarrollo. En la forma tradicional normalmente se comienza desde el dominio y se trabaja hacia afuera. Esto implica que no puedes validar realmente que algo funciona hasta que todas las capas están implementadas. Pasas días o semanas escribiendo código sin poder ejecutar nada end-to-end, descubriendo problemas de integración solo al final cuando son más caros de resolver. El enfoque que mejor aprovecha esta estructura es el opuesto: comenzar desde el punto de entrada y avanzar hacia adentro, validando cada capa inmediatamente después de crearla.
Empiezas con el entry point. Si la funcionalidad se expondrá vía REST, generas el controlador con scaffolding, lo reorganizas en su contexto api-rest/crear-pedido-api/, creas sus DTOs de request y response, y haces que devuelva datos inventados pero con la estructura correcta. Levantas la aplicación. Haces una petición HTTP real. El endpoint responde en menos de treinta minutos desde que comenzaste. Son datos falsos, pero el contrato de la API está validado y tienes algo tangible que puedes mostrar.
Ahora creas el caso de uso. Generas con scaffolding, reorganizas en domain/usecase/crear-pedido/, creas sus DTOs—diferentes de los de la API—y lo haces devolver también datos simulados. Creas los mapeadores en api-rest/crear-pedido-api/mapper/ que traducen entre DTOs de API y DTOs de caso de uso. Inyectas el caso de uso en el controlador y conectas el flujo.
Levantas la aplicación nuevamente. Haces una petición. Los datos fluyen: API recibe → mapea a lenguaje de dominio → caso de uso procesa → mapea a lenguaje de API → responde. Todo funciona. Siguen siendo datos simulados, pero la arquitectura de comunicación entre capas está validada. Has probado que las abstracciones encajan correctamente.
Continúas capa por capa. Si el caso de uso necesita un modelo transversal que no existe, lo creas en domain/model/pedido/ con su gateway. Si necesita lógica reutilizable, creas el servicio en domain/service/calculo-descuentos/. Cada uno inicialmente con lógica simplificada o simulada.
Implementas el adaptador de persistencia. Generas con scaffolding, organizas en jpa-repository/pedido-persistencia/ con sus entidades JPA, repositorios, implementación del gateway, mapeadores. Lo pruebas de forma aislada con tests de integración contra base de datos de prueba. Solo cuando funciona correctamente lo conectas al caso de uso. Haces una petición end-to-end y por primera vez los datos realmente se persisten y recuperan.
Agregas validadores al caso de uso, uno a la vez, en domain/usecase/crear-pedido/validator/. Pruebas que rechazan correctamente datos inválidos. Agregas enriquecedores en enricher/ que complementan información. Implementas clientes para servicios externos, cada uno en su contexto en rest-consumer/servicio-inventario/. En cada paso tienes algo funcional que puedes probar.
Este flujo outside-in con retroalimentación temprana transforma el desarrollo. Nunca estás más de un paso alejado de algo que funciona. Los problemas de integración se descubren tempranamente cuando son fáciles de resolver. Siempre tienes una versión funcional—aunque incompleta—en lugar de un sistema completo que no funciona hasta el final. Y la presión psicológica desaparece porque constantemente ves progreso tangible.
Con la estructura clara y el proceso de reorganización establecido, hay una práctica que potencia enormemente los beneficios de esta organización por contextos: el desarrollo outside-in. No es obligatorio seguir este enfoque, pero resulta extraordinariamente efectivo para avanzar con la seguridad de que cada paso está correctamente implementado antes de pasar al siguiente. Esta afirmación se entiende mejor al contrastarla con los inconvenientes de la forma tradicional de iniciar el desarrollo. En la forma tradicional normalmente se comienza desde el dominio y se trabaja hacia afuera. Esto implica que no puedes validar realmente que algo funciona hasta que todas las capas están implementadas. Pasas días o semanas escribiendo código sin poder ejecutar nada end-to-end, descubriendo problemas de integración solo al final cuando son más caros de resolver. El enfoque que mejor aprovecha esta estructura es el opuesto: comenzar desde el punto de entrada y avanzar hacia adentro, validando cada capa inmediatamente después de crearla.
Con la estructura clara y el proceso de reorganización establecido, hay una práctica que potencia enormemente los beneficios de esta organización por contextos: el desarrollo outside-in. No es obligatorio seguir este enfoque, pero resulta extraordinariamente efectivo para avanzar con la seguridad de que cada paso está correctamente implementado antes de pasar al siguiente. Esta afirmación se entiende mejor al contrastarla con los inconvenientes de la forma tradicional de iniciar el desarrollo. En la forma tradicional normalmente se comienza desde el dominio y se trabaja hacia afuera. Esto implica que no puedes validar realmente que algo funciona hasta que todas las capas están implementadas. Pasas días o semanas escribiendo código sin poder ejecutar nada end-to-end, descubriendo problemas de integración solo al final cuando son más caros de resolver. El enfoque que mejor aprovecha esta estructura es el opuesto: comenzar desde el punto de entrada y avanzar hacia adentro, validando cada capa inmediatamente después de crearla.
Las Incomodidades Reales
Seamos honestos sobre los desafíos porque existen y necesitas conocerlos antes de adoptar esta aproximación. La disciplina de reorganización después de cada generación de scaffolding es real y constante. Bajo presión de deadlines, saltarse este paso es tentador. "Lo reorganizaré después" se convierte en "nunca". La solución no es intentar automatizar la reorganización—requiere juicio humano sobre qué constituye un contexto apropiado—sino hacer de la reorganización una parte no negociable del proceso. La definición de "done" incluye código correctamente contextualizado. Las revisiones de código lo verifican. Los desarrolladores nuevos son entrenados en esto desde el día uno. Las estructuras de carpetas serán más profundas. Más niveles de anidamiento que en estructuras tradicionales. Inicialmente esto se siente lento y confuso. Los IDEs modernos ayudan significativamente con búsquedas rápidas y navegación inteligente, pero aún así hay un período de adaptación de algunas semanas. Después, la mayoría de desarrolladores encuentra que localizar código es más rápido porque saben exactamente dónde buscar: todo lo relacionado con una funcionalidad está en su contexto. Decidir qué extraer como transversal y qué mantener en contextos requiere experiencia y juicio. No hay reglas absolutas que puedas seguir mecánicamente. Un modelo de dominio usado extensamente claramente debe ser transversal. Un servicio con lógica compleja reutilizable justifica extracción. Pero un mapper usado por un solo caso de uso debe permanecer en ese contexto. Esta decisión requiere práctica, y a veces te equivocarás y necesitarás refactorizar. Eso es normal y esperado. El tamaño del código base crecerá más que en aproximaciones tradicionales debido a la duplicación intencional. Esto puede parecer problemático especialmente en equipos acostumbrados a optimizar por menos líneas de código. Pero la métrica relevante no es el tamaño absoluto sino la mantenibilidad y comprensibilidad. Un código base más grande pero bien organizado, donde cada pieza tiene su lugar claro, es infinitamente más fácil de mantener que un código base más pequeño con componentes compartidos complejos y dependencias cruzadas que hacen imposible entender el impacto de los cambios.
Haciendo la Transición en Tu Equipo
Si esto resuena contigo y quieres adoptarlo, la transición requiere más que cambiar la estructura de carpetas. Comienza solo con código nuevo. Intentar refactorizar todo un código base existente de una vez es una receta para el fracasgo: demasiado costo, demasiado riesgo, demasiada resistencia del equipo. Aplica la filosofía a nuevas funcionalidades que implementes desde cero. Refactoriza código existente solo cuando ese código necesita modificaciones significativas de todas formas—entonces aprovechar para reorganizarlo en contextos apropiados es inversión que ya estás haciendo. Esta adopción gradual permite que el equipo aprenda sin el trauma de una reescritura masiva. Por algunos meses convivirán dos estilos: código viejo en estructura tradicional, código nuevo en contextos. Está bien. Eventualmente, a medida que el código viejo se modifica, se va reorganizando. En un año, la mayoría del código activo estará contextualizado. Invierte en documentación viva con ejemplos concretos de tu código base real. Abstracciones teóricas sobre "contextos autocontenidos" no funcionan tan bien como mostrar "mira, así organizamos el caso de uso de procesar pedidos, aquí están todos sus elementos, esta es la razón por la que cada uno está donde está". Cuando los desarrolladores pueden ver ejemplos reales del propio proyecto, la comprensión es inmediata. Las sesiones de pair programming donde desarrolladores experimentados en la filosofía trabajan con nuevos miembros aplicándola en práctica valen más que cualquier documento. Ver cómo alguien genera código con scaffolding y luego inmediatamente lo reorganiza, cómo decide qué subcarpetas crear, cómo identifica qué debe ser transversal versus específico del contexto—eso se aprende haciendo, no leyendo. Las revisiones de código son críticas para mantener integridad arquitectónica. Verifica que el código está en el contexto correcto, que sigue principios de autocontención, que no está creando acoplamiento innecesario. Esta verificación debe tener el mismo peso que verificar corrección funcional. Si el código funciona pero está mal organizado, solicitar cambios no es pedantería—es proteger la mantenibilidad a largo plazo del sistema. Y mantén flexibilidad dentro del marco. No todo contexto necesita la misma estructura. Un caso de uso simple no necesita todas las subcarpetas que uno complejo requiere. Lo importante son los principios—autocontención, cohesión conceptual, independencia—no seguir rígidamente una plantilla.
Performance: La Pregunta que Todos Hacen
Eventualmente alguien preguntará: "¿Toda esta separación y múltiples traducciones entre DTOs no tiene costo de performance prohibitivo?" La respuesta pragmática: en la vasta mayoría de aplicaciones empresariales, no. El costo de mapear entre DTOs de API, DTOs de caso de uso, entidades de dominio, y entidades JPA se mide en microsegundos. Las operaciones que realmente importan—queries a base de datos, llamadas HTTP a servicios externos, procesamiento de lógica de negocio compleja—se miden en milisegundos o más. Los mapeos son ruido estadístico en comparación. Cuando la performance es genuinamente crítica—procesamiento batch de millones de registros, sistemas de alta frecuencia, servicios con SLAs de latencia extremos—la arquitectura no lo prohíbe. Un caso de uso puede saltarse algunos mapeos, trabajando más directamente con representaciones de niveles inferiores si es necesario. La clave es que esto sea una decisión consciente, documentada, y justificada por mediciones reales de performance bajo carga real, no por optimización prematura basada en suposiciones. Las optimizaciones del compilador Java y la JVM también ayudan enormemente. El inlining de métodos pequeños significa que muchos mapeos que parecen caros en el código fuente son esencialmente gratuitos en el bytecode optimizado. La eliminación de código muerto elimina paths que nunca se ejecutan. El profile-guided optimization del JIT compiler optimiza los caminos que realmente se usan frecuentemente. La guía es clara: construye con la arquitectura limpia por defecto. Mide cuando tengas dudas reales. Optimiza solo donde las mediciones bajo carga real muestren necesidad. La claridad arquitectónica facilita la optimización cuando es necesaria porque es trivial identificar dónde está el cuello de botella—está en un contexto específico—y modificar solo esa parte sin afectar el resto.
El Impacto en la Cultura del Equipo
Más allá de la estructura de carpetas, esta filosofía cambia cómo los equipos trabajan y colaboran. El ownership del código se vuelve natural y claro. Cuando todo lo relacionado con una funcionalidad está en un contexto específico, es fácil asignar ownership de ese contexto a alguien. No significa que solo esa persona puede tocarlo—eso crearía silos de conocimiento—pero hay alguien responsable de su calidad, coherencia, y evolución. Cuando surge una pregunta sobre esa funcionalidad, hay un punto de contacto claro. Cuando necesita evolucionar, hay alguien que entiende su contexto completo. La planificación de sprints se simplifica porque las historias de usuario frecuentemente se mapean directamente a casos de uso, y los casos de uso son contextos autocontenidos. Estimar el esfuerzo se vuelve más predecible: implementar un caso de uso significa crear su contexto con los elementos que necesita. La variabilidad viene de cuántos y qué tipo de elementos específicos requiere—validadores complejos versus simples, múltiples enriquecedores versus ninguno—pero el patrón general es consistente. Las estimaciones mejoran porque hay menos incertidumbre sobre alcance y dependencias. La colaboración cambia de naturaleza. En lugar de conflictos constantes por múltiples personas modificando los mismos archivos compartidos, diferentes desarrolladores trabajan en diferentes contextos con mínima interferencia. Cuando necesitan coordinación, típicamente es a través de interfaces bien definidas—un caso de uso invocando un servicio de dominio, un entry point usando un caso de uso—no modificando los mismos archivos internos simultáneamente. El testing se vuelve más natural. Cada contexto puede probarse de forma aislada con sus dependencias mockeadas apropiadamente. Los tests unitarios se enfocan en lógica específica del contexto. Los tests de integración verifican que el contexto se comunica correctamente con sus dependencias reales. Los tests end-to-end verifican que el flujo completo funciona atravesando múltiples contextos. Esta separación hace que los tests sean más simples de escribir, más rápidos de ejecutar, y más fáciles de mantener porque el alcance de cada nivel de testing es claro. La rotación de personas—tanto salidas como nuevas incorporaciones—se maneja mejor. El conocimiento no está uniformemente distribuido por un código base monolítico donde entender cualquier parte requiere entender el todo. El conocimiento está organizado por contextos. Un desarrollador saliente puede documentar y traspasar los contextos de los que tenía ownership específico. Un desarrollador entrante puede comenzar tomando ownership de contextos particulares, aprendiendo el sistema incrementalmente en lugar de necesitar una descarga masiva de conocimiento de todo desde el día uno.
Evolución y Futuro
Esta filosofía híbrida no es un destino final sino un punto en la evolución continua de cómo organizamos código complejo. Las herramientas seguirán mejorando. Los IDEs se volverán más inteligentes en entender y navegar estructuras modulares complejas. Las herramientas de scaffolding podrían eventualmente aprender a generar código ya organizado por contextos, preguntando al desarrollador a qué contexto de negocio pertenece el componente antes de generarlo. La generación de código asistida por IA podría entender patrones arquitectónicos como esta filosofía de contextos y generar código que automáticamente se organiza correctamente, reduciendo la carga de disciplina manual. Las herramientas de análisis estático podrían detectar violaciones de la organización por contextos, identificando cuando un contexto accede directamente a detalles internos de otro o cuando la estructura se está volviendo inconsistente. A medida que más sistemas evolucionan hacia arquitecturas distribuidas, la clara separación de contextos se vuelve aún más valiosa. Los bounded contexts bien definidos facilitan decisiones sobre qué debe desplegarse junto y qué podría beneficiarse de despliegue independiente como microservicios. Los módulos Gradle proporcionan las fronteras naturales para estas decisiones, y la organización por contextos asegura que cada unidad desplegable sea cohesiva y completa. Pero más allá de las herramientas futuras, los principios permanecen: autocontención facilita comprensión, cohesión conceptual facilita mantenimiento, independencia entre contextos facilita evolución. Estos principios son atemporales incluso si los detalles de implementación evolucionan con nuevas tecnologías.
Casos Reales y Lecciones Aprendidas
En equipos que han adoptado esta aproximación, ciertos patrones emergen consistentemente. La transición inicial típicamente toma entre cuatro y ocho semanas. Las primeras dos semanas son de confusión y resistencia—"esto parece más complicado", "por qué estamos duplicando código", "no entiendo dónde poner las cosas". Las siguientes dos a cuatro semanas son de adaptación—el músculo de reorganizar después de scaffolding se desarrolla, las decisiones sobre qué contextualizar versus qué extraer se vuelven más naturales. Después de seis a ocho semanas, la mayoría de desarrolladores reporta que encontrar y modificar código se siente significativamente más fácil que antes. El momento "ajá" típicamente llega cuando un desarrollador necesita modificar una funcionalidad que implementó semanas antes. Abre el contexto esperando tener que buscar piezas dispersas por todo el proyecto, y descubre sorprendido que todo está ahí. "Oh, esto realmente funciona." Los equipos exitosos típicamente desarrollan sus propias convenciones específicas sobre nombrado de contextos, cuándo crear subcarpetas adicionales, cómo documentar decisiones de diseño dentro de contextos. Estas convenciones locales complementan los principios generales, adaptando la filosofía a las necesidades específicas del dominio y la cultura del equipo. Un error común es intentar que todos los contextos tengan exactamente la misma estructura. Un caso de uso complejo puede tener ocho subcarpetas diferentes. Uno simple puede tener solo tres. Ambos están bien. La estructura sirve a la funcionalidad, no al revés. Forzar uniformidad rígida crea carpetas vacías o artificialmente pobladas que no agregan valor. Otro error es ser demasiado conservador con la duplicación, intentando extraer cualquier similitud mínima. Esto recrea el problema original de componentes compartidos con dependencias complejas. La guía que funciona: cuando dudes si extraer, espera. Duplica inicialmente. Solo extrae cuando el tercer o cuarto contexto necesita exactamente lo mismo y tienes evidencia clara de que representa un concepto verdaderamente transversal del negocio, no solo similitud técnica superficial.
Relación con Otros Patrones
Esta filosofía no existe en vacío sino que complementa y se integra con otros patrones y prácticas establecidas. Domain-Driven Design proporciona el vocabulario para identificar y organizar contextos. Los bounded contexts de DDD se mapean naturalmente a agrupaciones de contextos en esta arquitectura. Las entidades, value objects, aggregates, y domain events de DDD encuentran su lugar en los contextos de modelo. Los servicios de dominio de DDD corresponden directamente a los servicios de dominio en esta estructura. CQRS puede aplicarse dentro de la organización por contextos. Los casos de uso que modifican estado (comandos) pueden organizarse claramente separados de los que solo leen (queries), permitiendo optimizaciones diferentes para cada tipo sin sacrificar claridad organizacional. Event Sourcing se integra naturalmente. Los domain events que las entidades generan pueden persistirse como event stream. Los adaptadores de persistencia implementan event stores. Los casos de uso publican eventos que otros contextos consumen, manteniendo independencia entre bounded contexts mientras permiten coordinación. La relación con Microservicios es interesante. Cada bounded context con sus casos de uso, servicios, y adaptadores podría potencialmente extraerse como microservicio independiente. Los módulos Gradle proporcionan fronteras naturales para esta extracción. Los gateways que actualmente se implementan con adaptadores locales podrían reemplazarse con adaptadores que hacen llamadas remotas. La organización por contextos facilita esta evolución porque las dependencias entre contextos son explícitas a través de gateways, haciendo visible el acoplamiento que necesitaría convertirse en comunicación remota.
El Verdadero Valor
Al final, todo esto se reduce a una verdad simple: la arquitectura de software existe para facilitar resolver problemas de negocio de manera efectiva y sostenible en el tiempo.
Una buena arquitectura es aquella que permite a los desarrolladores entender rápidamente qué hace el código, hacer cambios con confianza, y evolucionar el sistema según las necesidades del negocio cambian. No es la que se ve más elegante en un diagrama. No es la que usa las tecnologías más nuevas. No es la que tiene menos líneas de código. Es la que funciona para el equipo que la mantiene y el negocio que la necesita.
Esta filosofía híbrida de contextos dentro de módulos técnicos busca precisamente eso. No promete eliminar toda complejidad—la complejidad es inherente a sistemas empresariales que resuelven problemas complejos—pero promete organizarla de manera que sea manejable y comprensible.
Promete que cuando necesites modificar algo, sabrás dónde buscar porque todo lo relacionado está junto. Promete que tus cambios estarán contenidos y sus efectos predecibles porque los contextos son independientes. Promete que nuevos desarrolladores pueden comenzar a contribuir sin necesitar entender todo el sistema porque pueden tomar ownership de contextos específicos.
No es la única manera de organizar código, y no será la mejor para todos los proyectos y equipos. Pero para equipos que trabajan con herramientas de scaffolding que generan estructura modular, que construyen aplicaciones empresariales complejas donde el código vive y evoluciona durante años, y que valoran tanto la disciplina arquitectónica como la productividad práctica, ofrece un balance probado entre estructura y pragmatismo.
La adopción requiere más que cambiar carpetas. Requiere cambiar cómo piensas sobre organización de código. Requiere disposición a cuestionar dogmas como "nunca duplicar código" y reconocer que la duplicación intencional es frecuentemente mejor que el acoplamiento prematuro. Requiere disciplina para mantener integridad arquitectónica incluso bajo presión. Requiere inversión en documentación, entrenamiento, y procesos de revisión que refuercen los principios.
Pero para equipos dispuestos a hacer esa inversión, los retornos son reales y duraderos. Código que seis meses después todavía puedes entender rápidamente. Cambios que implementas con confianza sabiendo que no romperás cosas no relacionadas. Sistemas que crecen en funcionalidad sin colapsar bajo su propio peso. En un mundo donde el software exitoso inevitablemente crece en complejidad, eso no es poca cosa.
Así que la próxima vez que abras un proyecto y necesites modificar cómo se procesa un pedido, no pasarás treinta minutos buscando piezas dispersas por toda la estructura. Abrirás domain/usecase/procesar-pedido/ y todo estará ahí. Esa es la promesa. Esa es la diferencia.
Tablas Normalizadas vs. JSON/JSONB en PostgreSQL
- Mauricio ECR
- Persistencia
- 11 Jul, 2025
En el diseño de bases de datos, la normalización ha sido durante mucho tiempo sinónimo de integridad, eficiencia y orden. Sin embargo, los tiempos cambian, y con ellos, las necesidades de los sistemas

Tablas Normalizadas vs. JSON/JSONB en PostgreSQL
- Mauricio ECR
- Persistencia
- 11 Jul, 2025
En el diseño de bases de datos, la normalización ha sido durante mucho tiempo sinónimo de integridad, eficiencia y orden. Sin embargo, los tiempos cambian, y con ellos, las necesidades de los sistemas modernos. Los datos semi-estructurados ganan terreno, y PostgreSQL ha sabido adaptarse integrando soporte robusto para los tipos JSON y JSONB. Esta evolución plantea una pregunta crucial: ¿seguir apostando por la rigidez de las tablas normalizadas o abrazar la elasticidad del modelo documental?
El Dilema: Estructura vs. Flexibilidad
La decisión entre un modelo relacional rígido y uno dinámico basado en documentos tiene implicaciones profundas en rendimiento, mantenibilidad y escalabilidad. Entender sus ventajas y límites es clave para construir sistemas sólidos y adaptables.
Tablas Normalizadas: Precisión con Disciplina
La normalización organiza datos para evitar duplicidades y asegurar integridad, a través de estructuras bien definidas y relaciones explícitas.
Ventajas:
- Integridad de Datos: Claves foráneas, restricciones
UNIQUEy validacionesCHECKaseguran coherencia. - Eficiencia en Escrituras: Modificaciones atómicas reducen el riesgo de anomalías.
- Ahorro de Espacio: La minimización de redundancia optimiza el almacenamiento.
- Consultas Optimizadas: Los
JOINson eficientemente resueltos por el planificador de PostgreSQL.
Desventajas:
- Cambios Costosos: Alterar la estructura requiere migraciones.
- Complejidad en Consultas: Obtener una visión completa puede implicar múltiples
JOIN. - Lecturas Pesadas: Agregaciones sobre muchas tablas pueden degradar el rendimiento.
Cuándo Usarlas: Cuando los datos tienen una estructura estable y la integridad es prioritaria. Casos típicos incluyen sistemas contables, gestión de inventarios y aplicaciones bancarias.
JSON/JSONB: Flexibilidad sin Esquema
PostgreSQL permite almacenar JSON de dos maneras:
json: Mantiene el texto original. Más rápido al insertar, pero más lento en consultas.jsonb: Almacena en formato binario. Un poco más lento al insertar, pero mucho más eficiente al consultar y permite indexación avanzada. En la mayoría de los casos, es la opción recomendada.
Ventajas:
- Esquema Dinámico: Atributos variables sin necesidad de alterar el modelo.
- Consultas Directas: Datos relacionados pueden vivir en un único documento.
- Prototipado Rápido: Ideal para iterar sin fricciones durante el desarrollo.
Desventajas:
- Sin Integridad Referencial: Las relaciones deben ser gestionadas manualmente.
- Redundancia y Consistencia: Datos duplicados son comunes, lo que implica riesgos si no se sincronizan.
- Actualizaciones Complejas: Modificar datos anidados no es tan directo como un
UPDATE.
Cuando destaca: Para casos con estructuras cambiantes, como configuraciones, eventos, integración de APIs externas o metadata variable
JSONB: Consultas, Índices y Más
Consultas y Proyecciones
PostgreSQL ofrece operadores intuitivos para navegar por estructuras JSONB:
->: Accede a un campo, devuelvejsonb.->>: Accede y devuelve texto.#>: Navega rutas anidadas, devuelvejsonb.#>>: Igual que#>, pero como texto.
Ejemplo de Uso:
CREATE TABLE productos (
    id SERIAL PRIMARY KEY,
    nombre TEXT NOT NULL,
    detalles JSONB
);

INSERT INTO productos (nombre, detalles) VALUES
('Laptop Pro', '{"precio": 1500, "fabricante": "TechCorp", "especs": {"cpu": "i7", "ram": 16, "almacenamiento": 512}}'),
('Smartphone X', '{"precio": 800, "fabricante": "MobileFirst", "especs": {"cpu": "Snapdragon 8", "ram": 8, "almacenamiento": 256}}');
Proyecciones:
SELECT nombre, detalles->>'precio' AS precio FROM productos;

SELECT nombre, detalles#>'{especs, ram}' AS ram FROM productos;
Filtrado y Búsquedas
Operadores potentes permiten extraer información fácilmente:
@>: Contiene.<@: Está contenido.?: Existe clave.?|: Existe alguna.?&: Existen todas.
Ejemplos:
SELECT * FROM productos WHERE detalles @> '{"fabricante": "TechCorp"}';

SELECT * FROM productos WHERE detalles @> '{"especs": {"ram": 16}}';

SELECT * FROM productos WHERE detalles ? 'precio';
Indexación
Las consultas sobre JSONB pueden volverse lentas sin índices adecuados. PostgreSQL ofrece:
- GIN (Generalized Inverted Index): El más recomendado. Optimiza búsquedas con
@>,?,?|,?&. - GiST: Más versátil, pero menos eficiente en general.
Ejemplo:
CREATE INDEX idx_productos_detalles_gin ON productos USING GIN (detalles);
También es posible crear índices B-tree sobre campos específicos:
CREATE INDEX idx_productos_fabricante ON productos ((detalles->>'fabricante'));
Actualizaciones Parciales
Con jsonb_set, es posible modificar datos sin reescribir todo el documento:
UPDATE productos
SET detalles = jsonb_set(detalles, '{precio}', '1450')
WHERE nombre = 'Laptop Pro';

UPDATE productos
SET detalles = jsonb_set(detalles, '{especs, ram}', '32')
WHERE nombre = 'Laptop Pro';
Modelo Híbrido: Lo Mejor de Dos Mundos
Combinar estructuras relacionales con campos JSONB permite construir sistemas flexibles, sin sacrificar integridad.
Ventajas del enfoque mixto:
- Datos críticos viven en columnas estructuradas.
- Atributos variables residen en campos JSONB.
- Menos
JOINs, más velocidad. - Menos migraciones con cada cambio de requisitos.
Casos Prácticos
1. E-commerce: Productos con atributos diversos
CREATE TABLE productos (
    id SERIAL PRIMARY KEY,
    nombre TEXT NOT NULL,
    precio DECIMAL(10, 2),
    categoria_id INT REFERENCES categorias(id),
    especificaciones JSONB
);

CREATE INDEX idx_especificaciones_gin ON productos USING GIN (especificaciones);

SELECT * FROM productos
WHERE categoria_id = 1
AND especificaciones @> '{"ram": "16GB", "almacenamiento": "SSD"}';
2. SaaS: Preferencias de usuario
ALTER TABLE usuarios ADD COLUMN preferencias JSONB DEFAULT '{}';

UPDATE usuarios
SET preferencias = jsonb_set(preferencias, '{tema}', '"claro"')
WHERE id = 123;
3. Logs y eventos con estructuras variables
CREATE INDEX idx_eventos_detalles_ip ON eventos ((detalles->>'ip'));

SELECT * FROM eventos
WHERE tipo = 'login'
AND detalles->>'ip' = '192.168.1.1';
Claves del Modelo Híbrido
- Desarrollo Ágil: Sin necesidad de migrar con cada cambio menor.
- Rendimiento: Índices GIN aceleran búsquedas complejas.
- Mantenibilidad: Las estructuras centrales permanecen estables.
- Integración Sencilla: Ideal para microservicios y respuestas JSON de APIs externas.
Conclusión: El Futuro es Híbrido
No se trata de elegir entre rigidez o flexibilidad, sino de combinarlas inteligentemente. PostgreSQL permite construir arquitecturas donde:
- Los datos estables viven en tablas relacionales.
- Los atributos cambiantes se encapsulan en JSONB.
- El SQL moderno los une con potencia y elegancia.
La evolución de jsonb —junto con el soporte creciente para SQL/JSON path— abre nuevas puertas. El enfoque híbrido no es una moda, es una estrategia para diseñar sistemas duraderos, escalables y listos para adaptarse a lo que viene.
🔗 Recursos Recomendados
Relaciones en Bases de Datos NoSQL: ¿Embeber o Referenciar? Una Guía Técnica para la Toma de Decisiones
- Mauricio ECR
- Persistencia
- 27 Apr, 2025
El auge de las bases de datos NoSQL ha redefinido la manera en que abordamos el modelado de datos, ofreciendo flexibilidad y escalabilidad que a menudo superan las limitaciones de los modelos relacion

Relaciones en Bases de Datos NoSQL: ¿Embeber o Referenciar? Una Guía Técnica para la Toma de Decisiones
- Mauricio ECR
- Persistencia
- 27 Apr, 2025
El auge de las bases de datos NoSQL ha redefinido la manera en que abordamos el modelado de datos, ofreciendo flexibilidad y escalabilidad que a menudo superan las limitaciones de los modelos relacionales tradicionales. Sin embargo, esta libertad conlleva nuevas consideraciones, especialmente a la hora de definir las relaciones entre las entidades de nuestra aplicación. A diferencia de las claves foráneas y las uniones explícitas de las bases de datos SQL, en el mundo NoSQL (particularmente en las bases de datos orientadas a documentos), debemos decidir entre embeber documentos relacionados dentro de un documento principal o referenciar documentos a través de identificadores.
Esta decisión no es trivial y tiene un impacto profundo en el rendimiento, la escalabilidad, la consistencia y la complejidad de nuestra aplicación. Este artículo profundiza en los factores clave a considerar al tomar esta elección crítica, proporcionando una base sólida para arquitectos y desarrolladores de software que trabajan con bases de datos NoSQL.
Embeber Documentos: Consolidación para el Acceso Rápido
Embeber (embedding) implica anidar un documento dentro de otro. En este modelo, la información relacionada se almacena físicamente junta en un único documento.
Ventajas:
- Mejor rendimiento de lectura: Almacenar datos relacionados juntos permite recuperarlos en una sola operación de lectura, eliminando la necesidad de múltiples consultas o "joins" a nivel de aplicación o base de datos. Esto es ideal para escenarios donde los datos relacionados se acceden con mucha frecuencia junto con el documento principal.
- Operaciones atómicas: Las actualizaciones a los datos dentro de un único documento embebido suelen ser atómicas, lo que garantiza que las operaciones se completen por completo o no se realicen en absoluto, simplificando la lógica de manejo de concurrencia para esos datos específicos.
- Menor complejidad de consultas simples: Para patrones de acceso que siempre recuperan el documento principal y sus relacionados, la consulta es directa y sencilla.
Desventajas:
- Duplicación de datos: Si un documento embebido necesita aparecer en múltiples documentos principales, la información se duplicará, lo que puede llevar a inconsistencias si los datos embebidos cambian.
- Tamaño del documento: Embeber grandes cantidades de datos o datos que crecen sin límites puede aumentar significativamente el tamaño de los documentos. Esto puede impactar el rendimiento de lectura y escritura, y muchas bases de datos NoSQL tienen límites en el tamaño máximo de un documento (por ejemplo, 16 MB en MongoDB).
- Complejidad en actualizaciones frecuentes o parciales: Si los datos embebidos cambian con mucha frecuencia o si solo se necesita actualizar una pequeña parte de ellos, modificar el documento principal completo puede ser ineficiente.
- Dificultad para consultar datos embebidos de forma independiente: Consultar o agregar datos basándose únicamente en la información dentro de los documentos embebidos puede ser menos eficiente o más complejo que si estuvieran en una colección separada.
Referenciar Documentos: Flexibilidad y Normalización Controlada
Referenciar (referencing) implica almacenar documentos relacionados en colecciones separadas y utilizar identificadores (como el _id en MongoDB) en un documento para crear un enlace a otro. Este enfoque es más similar al concepto de claves foráneas en bases de datos relacionales.
Ventajas:
- Reduce la duplicación de datos: La información se almacena una sola vez en su propia colección, lo que simplifica la gestión de actualizaciones y reduce el riesgo de inconsistencia.
- Flexibilidad para consultar datos de forma independiente: Los documentos referenciados pueden ser consultados, actualizados y gestionados de forma independiente de los documentos que los referencian.
- Manejo eficiente de datos que crecen sin límites: Colecciones separadas son más adecuadas para almacenar grandes cantidades de datos o datos que se espera que crezcan considerablemente.
- Ideal para relaciones muchos-a-muchos: Las relaciones complejas donde múltiples documentos de una colección se relacionan con múltiples documentos de otra colección se manejan más naturalmente con referencias.
Desventajas:
- Mayor complejidad en la recuperación de datos relacionados: Para obtener el documento principal y sus relacionados, se requieren múltiples consultas (una para el documento principal y luego una o más para los documentos referenciados) o el uso de funcionalidades de "lookup" proporcionadas por la base de datos (si están disponibles), lo que puede aumentar la latencia de lectura.
- Falta de atomicidad en operaciones que involucran múltiples documentos: Las actualizaciones que afectan a datos en diferentes colecciones referenciadas no son atómicas por defecto, lo que requiere una lógica a nivel de aplicación o transacciones distribuidas (si la base de datos lo soporta) para garantizar la consistencia.
- Mayor complejidad en el modelo de datos para relaciones simples: Para relaciones uno-a-uno o uno-a-pocos, el modelo referenciado puede parecer más verboso que el modelo embebido.
Factores Clave para la Decisión
La elección entre embeber y referenciar depende en gran medida de los patrones de acceso a los datos y los requisitos de la aplicación. Aquí se detallan los factores más importantes a considerar:
Patrones de Acceso a Datos:
- Lectura intensiva y datos accedidos conjuntamente: Si los datos relacionados casi siempre se leen junto con el documento principal y las lecturas son mucho más frecuentes que las escrituras, embeber suele ofrecer un mejor rendimiento.
- Acceso independiente a datos relacionados: Si los datos relacionados se consultan o actualizan con frecuencia de forma independiente del documento principal, referenciar es la opción más eficiente.
- Necesidad de consultar y agregar datos relacionados por sí solos: Si se requiere realizar consultas o agregaciones complejas sobre los datos relacionados sin pasar por el documento principal, referenciar facilita estas operaciones.
Tamaño y Crecimiento de los Datos Relacionados:
- Datos relacionados pequeños y con crecimiento limitado: Embeber es viable si la cantidad de datos relacionados es pequeña y no se espera que crezca significativamente, manteniendo el tamaño total del documento dentro de límites razonables.
- Datos relacionados grandes o con crecimiento ilimitado: Referenciar es esencial cuando los datos relacionados pueden ser extensos (por ejemplo, una larga lista de comentarios o transacciones) para evitar exceder los límites de tamaño del documento y mantener un rendimiento de escritura eficiente.
Frecuencia y Naturaleza de las Actualizaciones:
- Actualizaciones frecuentes de datos embebidos: Si los datos que se considerarían para ser embebidos cambian muy a menudo, referenciar es preferible para evitar la sobrecarga de actualizar el documento principal constantemente.
- Actualizaciones atómicas requeridas para datos relacionados: Si un conjunto de datos relacionados debe actualizarse de manera atómica junto con el documento principal, embeber simplifica la implementación.
- Actualizaciones independientes de diferentes partes de los datos relacionados: Si distintos elementos dentro de los datos relacionados se actualizan de forma independiente y frecuente, referenciar permite actualizaciones más localizadas y eficientes.
Consistencia de los Datos:
- Alta prioridad en la consistencia global de los datos relacionados: Referenciar reduce la duplicación y simplifica la garantía de que las actualizaciones a los datos se reflejen consistentemente en toda la base de datos.
- Consistencia eventual aceptable para datos embebidos: Si una ligera inconsistencia temporal es tolerable para los datos embebidos (por ejemplo, la información duplicada tarda un corto tiempo en sincronizarse si cambia el original referenciado en otro lugar), embeber puede ser aceptable.
Complejidad del Esquema y las Relaciones:
- Relaciones uno-a-uno y uno-a-pocos contenidas: Embeber a menudo resulta en un esquema más simple y consultas directas para estas relaciones, especialmente cuando los "pocos" son realmente pocos y su crecimiento es limitado.
- Relaciones uno-a-muchos y muchos-a-muchos: Referenciar es generalmente la opción más escalable y manejable para estas relaciones, evitando documentos excesivamente grandes o la complejidad de manejar listas potencialmente ilimitadas dentro de un documento.
Consideraciones Específicas de la Base de Datos NoSQL:
- Aunque los principios generales son aplicables, las características específicas de la base de datos NoSQL utilizada (MongoDB, Cassandra, Couchbase, etc.) pueden influir en la decisión. Por ejemplo, las capacidades de "lookup" o las limitaciones de tamaño de documento varían entre bases de datos.
Un Enfoque Híbrido
Es importante destacar que no siempre es una elección binaria entre embeber o referenciar. En muchos casos, un enfoque híbrido puede ser la solución óptima. Esto implica embeber los datos relacionados que se acceden con mucha frecuencia y que tienen un tamaño limitado, mientras se referencian otros datos relacionados que son más grandes, cambian con frecuencia o se consultan de forma independiente.
Por ejemplo, en un documento de "pedido", se podría embeber una lista de "ítems del pedido" (si la lista no es excesivamente larga y se accede siempre con el pedido), pero referenciar el documento de "cliente" y los documentos de "productos" para evitar duplicar información del cliente o los detalles completos de cada producto en cada pedido.
Conclusión
La decisión de si embeber o referenciar datos en una base de datos NoSQL es un pilar fundamental en el diseño de esquemas eficientes y escalables. No existe una regla única para todos los casos; la elección debe basarse en una comprensión profunda de los patrones de acceso a datos de la aplicación, los requisitos de rendimiento, las expectativas de crecimiento de los datos y las características específicas de la base de datos NoSQL empleada.
Embeber favorece el rendimiento de lectura y la atomicidad para datos accedidos conjuntamente y de tamaño limitado. Referenciar ofrece flexibilidad, reduce la duplicación y es más adecuado para datos grandes, de crecimiento ilimitado, que cambian con frecuencia o que participan en relaciones complejas. Un enfoque híbrido a menudo permite capitalizar las ventajas de ambos modelos.
Una evaluación cuidadosa de los factores discutidos y la posibilidad de realizar pruebas de rendimiento con diferentes modelos de datos son pasos cruciales para asegurar que el diseño de la base de datos NoSQL soporte eficazmente las necesidades actuales y futuras de la aplicación. La continua monitorización y adaptación del esquema a medida que evolucionan los patrones de uso también son prácticas recomendadas en el dinámico entorno NoSQL.
A continuación, se presenta un diagrama de decisión simplificado para visualizar el proceso de elección entre embeber y referenciar:

codigo mermaid
    graph TD
        A[Iniciar: Modelando Relaciones NoSQL] --> B{Datos relacionados accedidos
principalmente con el padre?}
        B -->|Sí| C{Datos relacionados pequeños
y con crecimiento limitado?}
        C -->|Sí| D{Actualizaciones frecuentes
de datos relacionados?}
        D -->|No| E[Embeber]
        D -->|Sí| F{Consistencia global alta prioridad?}
        F -->|Sí| G[Referenciar]
        F -->|No| E
        C -->|No| H{Datos relacionados grandes
o crecimiento ilimitado?}
        H -->|Sí| G
        H -->|No| I{Relación muchos-a-muchos?}
        I -->|Sí| G
        I -->|No| J{Necesidad de consultar/actualizar
datos relacionados independientemente?}
        J -->|Sí| G
        J -->|No| E
        B -->|No| K{Datos relacionados consultados/actualizados
frecuentemente de forma independiente?}
        K -->|Sí| G
        K -->|No| I
        E --> L[Implementar modelo embebido]
        G --> M[Implementar modelo referenciado]
        L --> N[Fin]
        M --> N[Fin]
¿SQL o NoSQL? Descubre la Base de Datos Ideal para tu Proyecto
- Mauricio ECR
- Persistencia
- 29 Mar, 2025
Introducción Elegir la base de datos adecuada para un proyecto es una decisión crítica que afecta la escalabilidad, el rendimiento y la facilidad de mantenimiento de una aplicación. ¿Necesitas una

¿SQL o NoSQL? Descubre la Base de Datos Ideal para tu Proyecto
- Mauricio ECR
- Persistencia
- 29 Mar, 2025
Introducción
Elegir la base de datos adecuada para un proyecto es una decisión crítica que afecta la escalabilidad, el rendimiento y la facilidad de mantenimiento de una aplicación. ¿Necesitas una base de datos relacional o una documental? Este cuestionario te ayudará a tomar la mejor decisión basada en los requisitos específicos de tu proyecto. Responde las siguientes preguntas y obtén una recomendación basada en tus necesidades técnicas y operativas.
Contexto del Proyecto
Antes de responder, defina:
- Caso de uso principal: Ej: sistema transaccional, catálogo de productos, IoT, contenido generado por usuarios.
- Velocidad de crecimiento de datos: Estimación anual (GB/TB).
- Ratio lecturas/escrituras: Ej: 80/20, 50/50.
1. Modelado de Datos
¿Los datos tienen una estructura fija y predefinida que se mantiene estable (>80% de los casos)?
- Ej: tablas de clientes con campos obligatorios vs. posts de redes sociales con metadatos variables.
¿Es crítico modelar relaciones muchos-a-muchos entre entidades principales?
- Ej: estudiantes-cursos vs. tags en un blog.
¿La normalización para evitar redundancia es prioritaria sobre la velocidad de lectura?
¿El esquema cambia menos de 2 veces/año?
¿Los registros comparten >90% de atributos comunes?
¿Los datos son principalmente planos o con anidamiento simple (≤2 niveles)?
- Ej: dirección
{calle, ciudad}vs. JSON con subdocumentos jerárquicos.
- Ej: dirección
¿La integridad referencial (FKs) es no negociable para el negocio?
¿Los datos son >70% valores escalares (números, textos cortos) vs. documentos/blobs?
¿Se pueden representar sin pérdida en tablas 2D?
- Ej: evita estructuras como arrays o árboles.
¿Prefiere almacenar documentos completos (JSON/XML) en lugar de desnormalizar?
¿Necesita consultar fragmentos específicos dentro de documentos anidados frecuentemente?
¿Los atributos varían significativamente entre registros de la misma entidad?
- Ej: productos con especificaciones técnicas heterogéneas.
2. Operaciones y Consultas
¿Las consultas frecuentes (≥30%) requieren JOINs entre ≥3 tablas?
¿Las búsquedas acceden a campos estructurados individuales (no documentos completos)?
¿Son esenciales transacciones ACID que abarcan múltiples operaciones/entidades?
- Nota: Algunas bases documentales (MongoDB 4.0+) soportan transacciones multi-documento.
¿Las consultas usan principalmente claves primarias/índices simples (no consultas ad-hoc)?
¿Se filtran datos usando ≥3 atributos simultáneamente en >50% de las consultas?
¿Prefiere consultar datos anidados directamente en lugar de desnormalizar?
¿Las escrituras implican actualizaciones parciales complejas (no reemplazos completos)?
¿Requiere agregaciones multidimensionales (OLAP) sobre >1TB de datos?
¿Las consultas acceden a ≥3 entidades relacionadas en >40% de los casos?
¿Es crítico tener un esquema fijo para validar datos en ingesta?
¿Usa consultas geoespaciales o de grafos con frecuencia?
- Nota: Ambos modelos pueden soportarlo, pero con implementaciones distintas.
¿Necesita índices compuestos sobre múltiples campos anidados?
3. Requerimientos No-Funcionales
¿El volumen total estimado en 3 años es <50TB?
- Nota: Bases relacionales distribuidas (CockroachDB) pueden manejar petabytes.
¿La alta disponibilidad requiere consistencia fuerte (no eventual)?
¿El ratio lecturas/escrituras es >70/30?
¿Puede tolerar latencias >15ms en operaciones críticas?
¿El equipo tiene ≥2 años de experiencia con SQL?
¿Es esencial compatibilidad con herramientas BI tradicionales (Power BI, Tableau)?
¿Requiere replicación transaccional cross-region?
¿Necesita escalado horizontal automático (sharding) sin downtime?
- Nota: Algunas RDBMS (Vitess) permiten sharding con límites.
¿La carga incluye >50K operaciones/segundo sostenidas?
¿Los backups deben ser incrementales con recuperación a momento específico?
¿Puede aceptar bloqueos por migraciones de esquema (>1 min de downtime)?
5 Preguntas Críticas Decisivas
¿Es no negociable la integridad referencial entre entidades?
- Sí → Relacional (a menos que use extensiones como PostgreSQL + FOREIGN KEY en JSONB).
¿Los datos son >60% documentos anidados con estructura irregular?
- Sí → Documental (pero considere híbridos como MySQL + MongoDB).
¿Requiere JOINs complejos (>3 tablas) en >25% de las consultas?
- Sí → Relacional (aunque algunas documentales tienen
$lookupsimilar a JOINs).
- Sí → Relacional (aunque algunas documentales tienen
¿Necesita escalar horizontalmente sin límites prácticos?
- Sí → Documental (pero evalúe NewSQL como YugabyteDB).
¿Requiere transacciones ACID multi-operación en >30% de los casos?
- Sí → Relacional (pero verifique si su documental soporta transacciones).
Regla decisiva
Si ≥3 respuestas clave apuntan a una categoría, priorícela. En empates (2-2), evalúe el contexto del proyecto.
Interpretación de Puntajes
| Puntos Totales | Recomendación | Tecnologías Ejemplo |
|---|---|---|
| 28-35 | Relacional Puro | PostgreSQL, MySQL, SQL Server |
| 20-27 | Relacional + Extensiones | PostgreSQL (JSONB), SQL Server (XML), Oracle (JSON) |
| 15-19 | Híbrido o Multi-Modelo | MongoDB (transacciones), Cosmos DB (modo SQL), CockroachDB |
| 8-14 | Documental Puro | MongoDB, Couchbase, Firebase Firestore |
Conclusión
Este cuestionario te ofrece un marco estructurado para evaluar qué tipo de base de datos es más adecuada para tu proyecto. Si la mayoría de tus respuestas favorecen la integridad referencial, los JOINs y la validación de esquema, una base relacional es la mejor opción. Si en cambio tu proyecto requiere flexibilidad en la estructura de datos, escalabilidad horizontal y almacenamiento de documentos, una base documental puede ser la respuesta. En casos híbridos, considera soluciones como PostgreSQL con JSONB o bases multimodelo como CosmosDB. ¡Elige sabiamente para optimizar el rendimiento y la escalabilidad de tu aplicación!