- Agile 2
- Alta disponibilidad 1
- Alternativas cloud 1
- Aop 1
- Arquitectura 3
- Arquitectura distribuida 4
- Automatizacion 3
- Aws 1
- Azure devops 1
- Base de datos 1
- Buenas practicas 22
- Cloud 1
- Colas 7
- Competing consumers 1
- Convenciones 11
- Copilot 1
- Diseno 8
- Docker 2
- Docker compose 1
- Documentacion 1
- Eda 11
- Equipos 1
- Escalabilidad 1
- Flujo de negocio 1
- Flujo de trabajo 3
- Flyway 1
- Git 4
- Gradle 3
- Herramientas digitales 1
- Ia 1
- Iam 1
- Infraestructura 2
- Java 16
- Jerarquia tecnica 1
- Jpa 1
- Jsonb 1
- Kafka 7
- Kubernetes 1
- Liderazgo en software 1
- Lineamientos 1
- Log 1
- Logging 3
- Microservicios 5
- Mongodb 1
- Monitoreo 1
- Nosql 3
- Observabilidad 4
- Open source 1
- Plugins 3
- Postgresql 2
- Privacidad 1
- Programacion funcional 1
- Programacion reactiva 4
- Rabbitmq 6
- Rotacion de talento 1
- Saga 2
- Scrum 2
- Security 1
- Seguridad 1
- Self hosting 1
- Sistemas legados 1
- Snippets 1
- Spring boot 5
- Spring mvc 2
- Sql 4
- Streams 1
- Threadlocal 1
- Trazabilidad 2
- Versionado 2
- Web 1
- Webflux 2
- Websockets 1
- Zero trust 1
Postgresql
2 artículos
Paginacion: Cuando offset ya no es suficiente
- Mauricio ECR
- Arquitectura
- 27 Sep, 2026
Te llega la tarea y parece de las fáciles: "agregar paginación al listado de artículos". Añades ?page=0&size=20, Spring te proporciona Pageable, el repositorio hereda findAll(pageable) y, en poc
Paginacion: Cuando offset ya no es suficiente
- Mauricio ECR
- Arquitectura
- 27 Sep, 2026
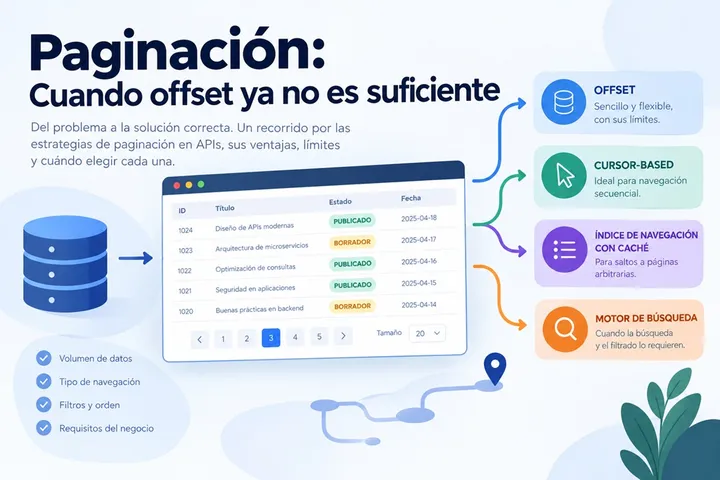
Te llega la tarea y parece de las fáciles: "agregar paginación al listado de artículos". Añades ?page=0&size=20, Spring te proporciona Pageable, el repositorio hereda findAll(pageable) y, en pocos minutos, tienes un endpoint funcionando.
En desarrollo, con mil registros, todo va bien. En staging, con diez mil, probablemente también. El problema aparece más adelante, cuando la tabla alcanza cientos de miles de filas, los filtros se vuelven más complejos y los tiempos de respuesta empiezan a crecer de una forma que ya no resulta tan fácil de explicar.
Y esa lentitud no aparece porque sí. Tiene una causa concreta, relacionada con la forma en que la base de datos resuelve la consulta internamente.
El costo invisible de OFFSET
La paginación tradicional suele apoyarse en dos cláusulas SQL: LIMIT, que determina cuántos registros devolver, y OFFSET, que indica cuántos registros deben quedar fuera antes de comenzar a devolver resultados.
SELECT * FROM articulos
ORDER BY created_at DESC
LIMIT 20 OFFSET 10000;
La consulta parece directa. Pero lo que ocurre para resolverla no siempre lo es.
Para obtener los veinte registros solicitados, el motor necesita avanzar hasta la posición indicada por el OFFSET. Los registros anteriores no forman parte del resultado final, pero el trabajo necesario para llegar hasta ellos existe.
Por eso, a medida que aumenta la profundidad de la página, puede aumentar también el trabajo que debe realizar el motor. La página 1 con tamaño 20 apenas necesita avanzar. Una página mucho más profunda tiene que recorrer una cantidad considerablemente mayor de registros antes de llegar al conjunto que finalmente devolverá.
La diferencia puede ser especialmente importante en tablas grandes. Los índices ayudan a reducir el trabajo necesario, pero no eliminan por completo la naturaleza del problema: la posición se expresa como una cantidad de registros que deben quedar atrás.
Existe además otro problema, menos visible durante las pruebas: la posición de una página puede cambiar mientras el usuario navega.
Imagina que un cliente solicita la página 3 y, antes de solicitar la página 4, se inserta un nuevo registro que queda al principio del orden.
Ese nuevo registro desplaza las posiciones siguientes. Como consecuencia, el cliente puede recibir un registro que ya había visto o dejar de recibir otro que esperaba encontrar en la siguiente página.
El mismo tipo de desplazamiento puede producirse cuando se eliminan registros o cuando una modificación cambia su posición dentro del orden.
No es necesariamente un error que aparezca durante una prueba funcional. Es un comportamiento que puede hacerse visible cuando varios usuarios navegan mientras el sistema continúa recibiendo escrituras.
Tenemos, entonces, dos problemas diferentes pero relacionados:
- El costo puede aumentar a medida que se profundiza en las páginas.
- Los resultados pueden desplazarse entre una solicitud y la siguiente cuando los datos cambian.
Estos problemas explican por qué una implementación de OFFSET que funcionaba perfectamente con una tabla pequeña puede empezar a presentar dificultades cuando cambian el volumen o la forma de utilizar el endpoint.
Pero todavía no podemos concluir que haya que reemplazar OFFSET.
La pregunta siguiente es otra: ¿qué características tiene el caso de uso que estamos intentando resolver?
Las variables que realmente determinan la solución
No existe una única solución para todos los escenarios de paginación. La estrategia adecuada depende de cómo se navegan los resultados, cómo se filtran, cómo se ordenan y cuánto crecerán los datos.
Antes de comparar alternativas, conviene responder cuatro preguntas.
La primera es probablemente la más importante:
¿El usuario navega secuencialmente o necesita saltar a páginas arbitrarias?
Navegar secuencialmente significa avanzar a partir del resultado anterior: siguiente, anterior, scroll infinito o cualquier otra interfaz en la que el usuario recorre los resultados de forma progresiva.
La navegación aleatoria es diferente. Aquí el usuario puede seleccionar directamente una página concreta, por ejemplo la 53, sin haber recorrido las anteriores.
Esta diferencia es fundamental porque algunas estrategias utilizan precisamente el resultado anterior como punto de referencia. Si el usuario necesita saltar directamente a una posición arbitraria, ese modelo deja de encajar tan bien.
La segunda pregunta aparece cuando entran en juego los filtros:
¿Los filtros utilizan valores discretos o rangos abiertos?
Un filtro discreto trabaja con un conjunto relativamente acotado de posibilidades: estado, categoría, autor o tipo.
Un rango abierto permite prácticamente cualquier combinación dentro de un continuo: una fecha entre X e Y, un precio entre A y B o una búsqueda de texto libre.
Esta diferencia se vuelve especialmente importante cuando se considera una estrategia basada en caché. Si existen pocas combinaciones posibles, una consulta puede reutilizar un resultado previamente calculado. Cuando las combinaciones son prácticamente infinitas, esa reutilización se vuelve mucho menos probable.
La tercera pregunta tiene que ver con el orden:
¿El orden de los resultados es estable o puede cambiar?
Un orden estable puede ser, por ejemplo, created_at DESC, acompañado de un identificador como desempate.
Un orden dinámico permite que el usuario cambie la columna o los criterios de orden durante la navegación. En ese caso, una referencia calculada para el orden anterior deja de representar correctamente la posición dentro del nuevo orden.
Finalmente está el volumen:
¿Cuántos registros existen hoy y cuánto se espera que crezca la tabla?
Una tabla con cincuenta mil registros presenta unas necesidades diferentes a una que puede alcanzar varios millones.
El volumen no determina por sí solo la solución, pero sí cambia el costo de las estrategias. Algo que resulta perfectamente razonable en una tabla pequeña puede dejar de serlo cuando aumentan la profundidad de las páginas, la cantidad de consultas y la concurrencia.
Con estas cuatro variables definidas, ya podemos comparar las alternativas de manera más precisa. Cada una resuelve una combinación diferente de necesidades y, al mismo tiempo, introduce sus propios límites.
Cuando OFFSET sigue siendo suficiente
La primera posibilidad es también la más sencilla: mantener OFFSET, pero controlar las condiciones en las que se utiliza.
Esto tiene sentido cuando el volumen es moderado, las páginas profundas son poco frecuentes y la navegación aleatoria forma parte de los requisitos.
En muchos sistemas, los usuarios rara vez llegan a páginas extremadamente profundas. Si una interfaz obliga a recorrer miles de páginas para encontrar un registro, probablemente el problema de fondo sea que falta una búsqueda o un mecanismo de filtrado más adecuado.
Por eso, establecer un límite máximo de profundidad puede ser una decisión razonable. Por ejemplo, se puede impedir que una API consulte páginas más allá de cierto límite y obligar al consumidor a utilizar filtros o búsqueda para localizar registros concretos.
El segundo elemento importante es el índice.
Supongamos que la consulta utiliza:
ORDER BY estado, created_at, id
Si esas columnas participan habitualmente en el orden y los filtros, un índice compuesto diseñado de acuerdo con el patrón real de consulta puede reducir considerablemente el trabajo necesario.
El costo asociado con la profundidad no desaparece por completo, pero puede disminuir de forma importante.
Aquí aparece una idea importante: no toda paginación necesita una arquitectura sofisticada.
Si el problema es pequeño y los requisitos son sencillos, introducir cursores, Redis o un motor de búsqueda puede añadir mucha más complejidad de la que realmente se necesita.
Cuándo encaja
OFFSET puede seguir siendo una buena opción cuando:
- El volumen es moderado.
- Las páginas profundas son poco frecuentes.
- El usuario necesita saltar a páginas arbitrarias.
- Los filtros y órdenes pueden cambiar dinámicamente.
- Se quiere mantener un contrato de API convencional basado en
pageysize. - La simplicidad de implementación es importante.
Qué no resuelve
El costo de las páginas profundas sigue existiendo.
Además, los cambios en los datos entre solicitudes pueden desplazar los resultados de una página a otra.
Cuando esas limitaciones dejan de ser aceptables, aparece una estrategia basada en una idea diferente: dejar de identificar la posición mediante un número y utilizar el propio orden de los datos como referencia.
Cuando la navegación es secuencial: cursor-based pagination
Aquí aparece la paginación basada en cursores, también conocida como keyset pagination.
La diferencia conceptual es sencilla.
Con OFFSET, la consulta pregunta:
"Dame los registros que están después de las primeras N posiciones."
Con un cursor, la consulta pregunta:
"Dame los registros que vienen después de este punto concreto del orden."
Por ejemplo:
SELECT * FROM articulos
WHERE (created_at, id) < (:ultima_fecha, :ultimo_id)
ORDER BY created_at DESC, id ASC
LIMIT 20;
En este caso, el último registro recibido se convierte en el punto de referencia para solicitar el siguiente conjunto.
La base de datos ya no necesita interpretar la página como una posición numérica. Puede utilizar los valores del orden para localizar el punto desde el que debe continuar.
Cuando existe un índice adecuado, esto permite evitar gran parte del trabajo asociado con recorrer posiciones profundas mediante OFFSET.
Por eso, la profundidad de la navegación deja de tener el mismo efecto que tenía en la estrategia anterior.
El cursor que recibe el cliente suele ser un token opaco. Puede contener los valores de las columnas utilizadas para determinar la posición y estar codificado, por ejemplo, mediante Base64URL.
El cliente no necesita conocer su estructura. Solo necesita conservarlo y devolverlo cuando solicite la siguiente página.
Esto permite que el backend cambie la representación interna del cursor sin obligar al cliente a interpretar sus componentes.
El requisito que hace posible un cursor
Para que este modelo funcione correctamente, el orden debe ser determinista.
Si varios registros tienen exactamente el mismo valor para el criterio principal, necesitamos una columna adicional que permita desempatar.
Por ejemplo:
ORDER BY created_at DESC, id ASC
Aquí created_at determina el orden principal y id permite distinguir registros que tienen la misma fecha.
Cuando el orden de negocio tiene varios niveles, todos ellos forman parte de la referencia.
Por ejemplo:
estado → created_at → id
El cursor deberá contener la información necesaria para reproducir esa posición dentro del orden.
El backend recibe el token, recupera esos valores y construye la condición correspondiente.
La contrapartida: la navegación deja de ser aleatoria
Aquí aparece la principal diferencia con OFFSET.
Un cursor representa un punto dentro del orden, no un número de página.
Por eso, si el usuario está recorriendo:
página 1 → página 2 → página 3 → página 4
es natural solicitar la siguiente posición.
Pero si quiere saltar directamente a la página 53, el cursor de esa página no puede calcularse simplemente a partir del número 53.
Esto significa que los cursores son especialmente adecuados cuando la navegación es secuencial.
No son simplemente una optimización de SQL: también representan un cambio en el contrato de la API y, en algunos casos, en la interfaz.
Una tabla tradicional basada en números de página no puede sustituirse por cursores manteniendo exactamente la misma semántica.
Cuándo encaja
La estrategia basada en cursores resulta especialmente apropiada para:
- Feeds.
- Historiales.
- Scroll infinito.
- Exportaciones secuenciales.
- Integraciones entre servicios.
- Tablas de gran volumen.
- Sistemas con escrituras frecuentes.
- Casos en los que el usuario no necesita saltar a una página arbitraria.
Qué no resuelve
No permite una navegación aleatoria equivalente a page=53.
Además, necesita un orden estable y determinista.
Cuando el requisito de navegación aleatoria es obligatorio, debemos buscar otra estrategia.
Cuando necesitas saltar directamente a una página
Supongamos ahora que el volumen es grande y que el usuario sí necesita ir directamente a una página concreta.
En ese caso, un cursor no encaja con el requisito principal de la interfaz.
Una posibilidad consiste en separar dos problemas que hasta ahora estaban mezclados: determinar qué registros ocupan cada posición y recuperar después los datos de esas posiciones.
La idea es construir un índice de navegación que contenga únicamente los identificadores de los registros que cumplen el filtro, en el orden correspondiente.
Por ejemplo:
SELECT id
FROM articulos
WHERE estado = :estado
  AND categoria = :categoria
ORDER BY
    CASE estado
        WHEN 'BORRADOR' THEN 1
        WHEN 'PUBLICADO' THEN 2
        ELSE 3
    END ASC,
    created_at DESC,
    id ASC;
El resultado conceptual sería:
[uuid_1, uuid_2, uuid_3, ..., uuid_N]
No estamos almacenando los artículos completos. Estamos almacenando el mapa que permite saber qué identificadores corresponden a cada posición.
Ese resultado puede guardarse en una caché utilizando como clave una representación de los filtros y del criterio de orden.
Por ejemplo:
hash(filtros + orden) → [id_1, id_2, id_3, ...]
Si la misma combinación se solicita nuevamente mientras el índice sigue siendo válido, puede reutilizarse.
Si el usuario cambia el filtro o el orden, cambia la clave y se genera otro índice.
A partir de ese mapa, solicitar la página 53 significa seleccionar las posiciones correspondientes.
Con un tamaño de página de 20:
página 53 → posiciones 1040 a 1059
Después, el sistema puede recuperar directamente los registros identificados:
SELECT *
FROM articulos
WHERE id = ANY(:ids_pagina);
Finalmente, debe reconstruir el mismo orden utilizado por el índice.
Una consecuencia importante: la consulta representa una fotografía
Esta estrategia introduce una propiedad que conviene hacer explícita.
El índice representa el conjunto de resultados en el momento en que fue construido.
Si se inserta un nuevo registro después de crear el índice, ese registro no tiene por qué aparecer en la navegación actual.
Si se elimina uno de los registros, el índice puede seguir haciendo referencia a un elemento que ya no existe y será necesario decidir cómo gestionar ese caso.
La ventaja es que el comportamiento deja de depender de desplazamientos implícitos entre solicitudes y pasa a formar parte explícita del diseño.
En otras palabras, el sistema está diciendo:
"Esta navegación corresponde a esta fotografía del conjunto de resultados."
Dependiendo del caso de uso, eso puede ser precisamente lo que se necesita.
El papel de los filtros
Aquí las características de los filtros que definimos antes adquieren importancia.
Si existen filtros discretos y relativamente acotados, es posible que diferentes usuarios soliciten repetidamente las mismas combinaciones.
Por ejemplo:
estado=PUBLICADO
categoria=TECNOLOGIA
orden=created_at
Ese tipo de consulta tiene más posibilidades de reutilizar un índice existente.
En cambio, si cada usuario puede especificar una fecha inicial, una fecha final, un precio mínimo, un precio máximo y otros parámetros arbitrarios, el número de combinaciones crece rápidamente.
En ese escenario, la caché puede tener menos oportunidades de reutilización y la generación del índice inicial puede convertirse en un costo importante.
Cuándo encaja
Este enfoque resulta especialmente interesante cuando:
- La navegación aleatoria es necesaria.
- El volumen de datos es elevado.
- Los filtros son relativamente discretos y repetibles.
- El orden de negocio es complejo.
- La misma combinación de filtros se consulta con frecuencia.
- Se dispone de infraestructura de caché.
Qué no resuelve
La generación inicial del índice sigue teniendo un costo proporcional al conjunto de resultados que debe procesar.
Además, mantener la caché introduce complejidad operacional: expiración, invalidación, memoria utilizada y comportamiento ante cambios en los datos.
Cuando los filtros dejan de ser discretos y pasan a incluir texto libre o rangos arbitrarios, puede ser necesario cambiar nuevamente de enfoque.
Cuando el problema ya es de búsqueda
Llegados a este punto, aparece un escenario diferente.
El problema ya no consiste únicamente en decidir cómo recorrer una lista grande.
Supongamos que el endpoint necesita combinar:
- Texto libre.
- Rangos arbitrarios.
- Múltiples dimensiones de filtrado.
- Orden dinámico.
- Millones de registros.
- Consultas frecuentes y concurrentes.
- Navegación sobre grandes conjuntos de resultados.
Aquí puede tener sentido utilizar un motor de búsqueda especializado.
Herramientas como Elasticsearch u OpenSearch utilizan estructuras de indexación diseñadas específicamente para búsquedas y filtrados complejos.
En lugar de depender exclusivamente del modelo de consulta de una tabla relacional, mantienen estructuras especializadas que permiten localizar documentos a partir de los términos y valores buscados.
También ofrecen mecanismos orientados a recorrer grandes conjuntos de resultados, como search_after, que permite continuar una búsqueda a partir de una posición determinada.
Esto cambia la naturaleza del problema.
Ya no estamos intentando hacer que una tabla relacional resuelva eficientemente cualquier combinación imaginable de búsqueda, filtro y orden.
Estamos utilizando una infraestructura especializada para ese patrón de acceso.
Pero esa decisión introduce un costo nuevo: ahora existe una infraestructura adicional que debe mantenerse sincronizada con la base de datos principal.
El flujo puede verse, conceptualmente, así:
Base de datos principal
        ↓
Proceso de sincronización
        ↓
Índice de búsqueda
Esto obliga a resolver preguntas que no existían con una única base de datos:
- ¿Cuándo se actualiza el índice?
- ¿Qué ocurre si la sincronización falla?
- ¿Cuánto retraso puede existir entre ambos sistemas?
- ¿Cuál es la fuente de verdad?
- ¿Cómo se reconstruye el índice?
- ¿Cómo se monitoriza?
Por eso, un motor de búsqueda no debería incorporarse simplemente porque OFFSET sea lento.
Tiene sentido cuando las necesidades de búsqueda y filtrado justifican la infraestructura adicional.
Cuándo encaja
Puede resultar adecuado cuando:
- El texto libre es una parte central del caso de uso.
- Existen rangos y filtros complejos.
- Se combinan múltiples dimensiones de búsqueda.
- El volumen de datos es elevado.
- Las consultas son frecuentes y concurrentes.
- La base de datos principal ya no ofrece una solución eficiente para el patrón de búsqueda requerido.
Qué no resuelve
No elimina la complejidad: la desplaza hacia la arquitectura.
Aparecen nuevos componentes, sincronización, monitorización, gestión de índices y una nueva forma de consultar los datos.
Si una solución más sencilla satisface los requisitos, incorporar otro sistema puede ser innecesario.
El árbol de decisión
A estas alturas, las cuatro estrategias ya no aparecen como alternativas aisladas. Cada una responde a las condiciones que acabamos de analizar.
El recorrido puede resumirse así:
flowchart TD
A([Necesito paginar una tabla])
--> B{¿Volumen moderado<br/>y páginas superficiales?}
B -->|Sí| S1[OFFSET con índices<br/>bien diseñados]
B -->|No| C{¿El usuario necesita<br/>saltar a páginas arbitrarias?}
C -->|No — navegación secuencial| D{¿El orden puede ser<br/>determinista?}
D -->|Sí| S2[Cursor-based pagination<br/>CursorRequest + CursorPage<T>]
D -->|No| D2[Añadir una columna<br/>de desempate única al orden]
D2 --> D
C -->|Sí — acceso aleatorio| E{¿Los filtros son<br/>discretos y acotados?}
E -->|Sí| S3[Índice de navegación con caché<br/>Hash del filtro → IDs en Redis]
E -->|No| F{¿La búsqueda y el volumen<br/>justifican infraestructura adicional?}
F -->|Sí| S4[Motor de búsqueda dedicado<br/>Elasticsearch / OpenSearch]
F -->|No| S1b[OFFSET con límite<br/>de profundidad]
El árbol no debe interpretarse como una fórmula rígida.
Por ejemplo, el número de registros por sí solo no determina qué estrategia utilizar. Lo que importa es cómo se combina ese volumen con la profundidad de navegación, el patrón de consulta, los filtros, el orden y la frecuencia de acceso.
El objetivo del árbol es obligarnos a formular las preguntas correctas antes de introducir complejidad.
Lo que cada solución no resuelve
Después de recorrer las alternativas, aparece una conclusión importante: ninguna estrategia elimina el costo de la paginación; cada una lo desplaza hacia un lugar diferente.
OFFSET mantiene un contrato sencillo y permite navegar directamente a páginas arbitrarias. Su costo aparece principalmente cuando la profundidad aumenta y los datos son numerosos.
Los cursores reducen el trabajo asociado con posiciones profundas y funcionan especialmente bien para navegación secuencial. A cambio, el cliente deja de trabajar con páginas numéricas y debe conservar un punto de referencia.
El índice de navegación con caché permite recuperar páginas arbitrarias a partir de un mapa previamente construido. A cambio, introduce un costo inicial y una infraestructura adicional para almacenar y gestionar ese mapa.
El motor de búsqueda permite resolver escenarios donde el problema ya no es solamente paginar, sino buscar y filtrar grandes volúmenes de información. A cambio, introduce otra pieza de infraestructura y la necesidad de mantenerla coordinada con la fuente de datos principal.
Por eso, la decisión no consiste en encontrar una solución que no tenga costos.
Consiste en decidir qué costo es aceptable para el contexto concreto del sistema.
Volver al endpoint que "simplemente funcionaba"
Cuando aquel endpoint que inicialmente "simplemente funcionaba" empieza a mostrar tiempos de respuesta cada vez mayores, es tentador concluir que OFFSET fue una mala decisión desde el principio.
Pero esa conclusión sería demasiado simple.
OFFSET puede ser una solución perfectamente válida para determinados escenarios.
El problema aparece cuando cambian las condiciones para las que fue elegido y nadie revisa la decisión.
Una tabla que comenzó con 20.000 registros puede terminar teniendo varios millones.
Una interfaz que inicialmente mostraba cinco páginas puede terminar necesitando búsqueda avanzada.
Un listado que solo se consultaba ocasionalmente puede convertirse en una de las rutas más utilizadas de la aplicación.
Y un criterio de orden sencillo puede terminar acompañado de múltiples filtros y reglas de negocio.
Por eso, la pregunta importante no es si OFFSET es bueno o malo.
La pregunta es si sigue siendo adecuado para las condiciones actuales del endpoint.
Ese cambio de perspectiva también modifica la forma de diseñar la solución desde el principio.
Antes de implementar la paginación, conviene conocer:
- cómo navegará el usuario;
- si necesita saltos arbitrarios;
- qué filtros tendrá disponibles;
- si esos filtros son discretos o abiertos;
- cómo se ordenarán los resultados;
- si ese orden es determinista;
- cuánto volumen existe actualmente;
- cuánto se espera que crezca;
- y cuánto pueden cambiar los datos mientras el usuario navega.
Con esa información, OFFSET, cursores, un índice de navegación o un motor de búsqueda dejan de ser decisiones basadas en preferencias técnicas.
Se convierten en respuestas a requisitos concretos.
Y esa es probablemente la idea más importante de todo el problema: la paginación no debería elegirse por costumbre ni por la tecnología que tenemos disponible, sino por la forma en que el endpoint realmente necesita ser utilizado.
La tarea puede seguir siendo "agregar paginación al listado de artículos".
Lo que cambia es la pregunta que hacemos antes de tocar el código.
No:
"¿Cuál es la mejor técnica de paginación?"
Sino:
"¿Qué tipo de navegación, filtrado, orden y volumen necesita realmente este endpoint?"
A partir de ahí, la implementación deja de ser una decisión aislada y pasa a formar parte del diseño técnico del sistema.
Y cuando el volumen, los filtros o la forma de navegación cambien, la estrategia puede revisarse de nuevo.
Ese punto de revisión es tan importante como la decisión inicial.
Tablas Normalizadas vs. JSON/JSONB en PostgreSQL
- Mauricio ECR
- Persistencia
- 11 Jul, 2025
En el diseño de bases de datos, la normalización ha sido durante mucho tiempo sinónimo de integridad, eficiencia y orden. Sin embargo, los tiempos cambian, y con ellos, las necesidades de los sistemas

Tablas Normalizadas vs. JSON/JSONB en PostgreSQL
- Mauricio ECR
- Persistencia
- 11 Jul, 2025
En el diseño de bases de datos, la normalización ha sido durante mucho tiempo sinónimo de integridad, eficiencia y orden. Sin embargo, los tiempos cambian, y con ellos, las necesidades de los sistemas modernos. Los datos semi-estructurados ganan terreno, y PostgreSQL ha sabido adaptarse integrando soporte robusto para los tipos JSON y JSONB. Esta evolución plantea una pregunta crucial: ¿seguir apostando por la rigidez de las tablas normalizadas o abrazar la elasticidad del modelo documental?
El Dilema: Estructura vs. Flexibilidad
La decisión entre un modelo relacional rígido y uno dinámico basado en documentos tiene implicaciones profundas en rendimiento, mantenibilidad y escalabilidad. Entender sus ventajas y límites es clave para construir sistemas sólidos y adaptables.
Tablas Normalizadas: Precisión con Disciplina
La normalización organiza datos para evitar duplicidades y asegurar integridad, a través de estructuras bien definidas y relaciones explícitas.
Ventajas:
- Integridad de Datos: Claves foráneas, restricciones
UNIQUEy validacionesCHECKaseguran coherencia. - Eficiencia en Escrituras: Modificaciones atómicas reducen el riesgo de anomalías.
- Ahorro de Espacio: La minimización de redundancia optimiza el almacenamiento.
- Consultas Optimizadas: Los
JOINson eficientemente resueltos por el planificador de PostgreSQL.
Desventajas:
- Cambios Costosos: Alterar la estructura requiere migraciones.
- Complejidad en Consultas: Obtener una visión completa puede implicar múltiples
JOIN. - Lecturas Pesadas: Agregaciones sobre muchas tablas pueden degradar el rendimiento.
Cuándo Usarlas: Cuando los datos tienen una estructura estable y la integridad es prioritaria. Casos típicos incluyen sistemas contables, gestión de inventarios y aplicaciones bancarias.
JSON/JSONB: Flexibilidad sin Esquema
PostgreSQL permite almacenar JSON de dos maneras:
json: Mantiene el texto original. Más rápido al insertar, pero más lento en consultas.jsonb: Almacena en formato binario. Un poco más lento al insertar, pero mucho más eficiente al consultar y permite indexación avanzada. En la mayoría de los casos, es la opción recomendada.
Ventajas:
- Esquema Dinámico: Atributos variables sin necesidad de alterar el modelo.
- Consultas Directas: Datos relacionados pueden vivir en un único documento.
- Prototipado Rápido: Ideal para iterar sin fricciones durante el desarrollo.
Desventajas:
- Sin Integridad Referencial: Las relaciones deben ser gestionadas manualmente.
- Redundancia y Consistencia: Datos duplicados son comunes, lo que implica riesgos si no se sincronizan.
- Actualizaciones Complejas: Modificar datos anidados no es tan directo como un
UPDATE.
Cuando destaca: Para casos con estructuras cambiantes, como configuraciones, eventos, integración de APIs externas o metadata variable
JSONB: Consultas, Índices y Más
Consultas y Proyecciones
PostgreSQL ofrece operadores intuitivos para navegar por estructuras JSONB:
->: Accede a un campo, devuelvejsonb.->>: Accede y devuelve texto.#>: Navega rutas anidadas, devuelvejsonb.#>>: Igual que#>, pero como texto.
Ejemplo de Uso:
CREATE TABLE productos (
    id SERIAL PRIMARY KEY,
    nombre TEXT NOT NULL,
    detalles JSONB
);

INSERT INTO productos (nombre, detalles) VALUES
('Laptop Pro', '{"precio": 1500, "fabricante": "TechCorp", "especs": {"cpu": "i7", "ram": 16, "almacenamiento": 512}}'),
('Smartphone X', '{"precio": 800, "fabricante": "MobileFirst", "especs": {"cpu": "Snapdragon 8", "ram": 8, "almacenamiento": 256}}');
Proyecciones:
SELECT nombre, detalles->>'precio' AS precio FROM productos;

SELECT nombre, detalles#>'{especs, ram}' AS ram FROM productos;
Filtrado y Búsquedas
Operadores potentes permiten extraer información fácilmente:
@>: Contiene.<@: Está contenido.?: Existe clave.?|: Existe alguna.?&: Existen todas.
Ejemplos:
SELECT * FROM productos WHERE detalles @> '{"fabricante": "TechCorp"}';

SELECT * FROM productos WHERE detalles @> '{"especs": {"ram": 16}}';

SELECT * FROM productos WHERE detalles ? 'precio';
Indexación
Las consultas sobre JSONB pueden volverse lentas sin índices adecuados. PostgreSQL ofrece:
- GIN (Generalized Inverted Index): El más recomendado. Optimiza búsquedas con
@>,?,?|,?&. - GiST: Más versátil, pero menos eficiente en general.
Ejemplo:
CREATE INDEX idx_productos_detalles_gin ON productos USING GIN (detalles);
También es posible crear índices B-tree sobre campos específicos:
CREATE INDEX idx_productos_fabricante ON productos ((detalles->>'fabricante'));
Actualizaciones Parciales
Con jsonb_set, es posible modificar datos sin reescribir todo el documento:
UPDATE productos
SET detalles = jsonb_set(detalles, '{precio}', '1450')
WHERE nombre = 'Laptop Pro';

UPDATE productos
SET detalles = jsonb_set(detalles, '{especs, ram}', '32')
WHERE nombre = 'Laptop Pro';
Modelo Híbrido: Lo Mejor de Dos Mundos
Combinar estructuras relacionales con campos JSONB permite construir sistemas flexibles, sin sacrificar integridad.
Ventajas del enfoque mixto:
- Datos críticos viven en columnas estructuradas.
- Atributos variables residen en campos JSONB.
- Menos
JOINs, más velocidad. - Menos migraciones con cada cambio de requisitos.
Casos Prácticos
1. E-commerce: Productos con atributos diversos
CREATE TABLE productos (
    id SERIAL PRIMARY KEY,
    nombre TEXT NOT NULL,
    precio DECIMAL(10, 2),
    categoria_id INT REFERENCES categorias(id),
    especificaciones JSONB
);

CREATE INDEX idx_especificaciones_gin ON productos USING GIN (especificaciones);

SELECT * FROM productos
WHERE categoria_id = 1
AND especificaciones @> '{"ram": "16GB", "almacenamiento": "SSD"}';
2. SaaS: Preferencias de usuario
ALTER TABLE usuarios ADD COLUMN preferencias JSONB DEFAULT '{}';

UPDATE usuarios
SET preferencias = jsonb_set(preferencias, '{tema}', '"claro"')
WHERE id = 123;
3. Logs y eventos con estructuras variables
CREATE INDEX idx_eventos_detalles_ip ON eventos ((detalles->>'ip'));

SELECT * FROM eventos
WHERE tipo = 'login'
AND detalles->>'ip' = '192.168.1.1';
Claves del Modelo Híbrido
- Desarrollo Ágil: Sin necesidad de migrar con cada cambio menor.
- Rendimiento: Índices GIN aceleran búsquedas complejas.
- Mantenibilidad: Las estructuras centrales permanecen estables.
- Integración Sencilla: Ideal para microservicios y respuestas JSON de APIs externas.
Conclusión: El Futuro es Híbrido
No se trata de elegir entre rigidez o flexibilidad, sino de combinarlas inteligentemente. PostgreSQL permite construir arquitecturas donde:
- Los datos estables viven en tablas relacionales.
- Los atributos cambiantes se encapsulan en JSONB.
- El SQL moderno los une con potencia y elegancia.
La evolución de jsonb —junto con el soporte creciente para SQL/JSON path— abre nuevas puertas. El enfoque híbrido no es una moda, es una estrategia para diseñar sistemas duraderos, escalables y listos para adaptarse a lo que viene.