- Agile 2
- Alta disponibilidad 1
- Alternativas cloud 1
- Aop 1
- Arquitectura 3
- Arquitectura distribuida 4
- Automatizacion 3
- Aws 1
- Azure devops 1
- Base de datos 1
- Buenas practicas 22
- Cloud 1
- Colas 7
- Competing consumers 1
- Convenciones 11
- Copilot 1
- Diseno 8
- Docker 2
- Docker compose 1
- Documentacion 1
- Eda 11
- Equipos 1
- Escalabilidad 1
- Flujo de negocio 1
- Flujo de trabajo 3
- Flyway 1
- Git 4
- Gradle 3
- Herramientas digitales 1
- Ia 1
- Iam 1
- Infraestructura 2
- Java 16
- Jerarquia tecnica 1
- Jpa 1
- Jsonb 1
- Kafka 7
- Kubernetes 1
- Liderazgo en software 1
- Lineamientos 1
- Log 1
- Logging 3
- Microservicios 5
- Mongodb 1
- Monitoreo 1
- Nosql 3
- Observabilidad 4
- Open source 1
- Plugins 3
- Postgresql 2
- Privacidad 1
- Programacion funcional 1
- Programacion reactiva 4
- Rabbitmq 6
- Rotacion de talento 1
- Saga 2
- Scrum 2
- Security 1
- Seguridad 1
- Self hosting 1
- Sistemas legados 1
- Snippets 1
- Spring boot 5
- Spring mvc 2
- Sql 4
- Streams 1
- Threadlocal 1
- Trazabilidad 2
- Versionado 2
- Web 1
- Webflux 2
- Websockets 1
- Zero trust 1
Sql
4 artículos
Vistas y funciones como contratos de API sobre una base unificada
- Mauricio ECR
- Arquitectura
- 29 Aug, 2026
En proyectos donde los microservicios comparten una misma base de datos, hay momentos en los que un cambio que comienza como una tarea rutinaria dentro de un equipo puede terminar en una reunión con t
Vistas y funciones como contratos de API sobre una base unificada
- Mauricio ECR
- Arquitectura
- 29 Aug, 2026
En proyectos donde los microservicios comparten una misma base de datos, hay momentos en los que un cambio que comienza como una tarea rutinaria dentro de un equipo puede terminar en una reunión con tres equipos distintos. Clientes, el servicio responsable de las cuentas de usuario, despliega una limpieza de cuentas inactivas, cambia el tipo de su identificador o renombra una columna que hasta entonces consideraba interna. Sus pruebas pasan y el despliegue parece correcto. Poco después, Pedidos empieza a fallar.
Normalmente, la situación comienza de una forma mucho más sencilla. Pedidos necesita consultar determinada información de Clientes y, como ambos servicios comparten la misma base de datos, acceder directamente a sus tablas parece una solución rápida y práctica. Con el tiempo, esa consulta puede dejar de ser algo puntual y convertirse en parte del funcionamiento habitual de Pedidos. El servicio comienza entonces a asumir que las tablas, columnas y estructuras que consulta estarán disponibles y conservarán el mismo significado.
Lo que inicialmente parecía una integración sencilla puede terminar haciendo que decisiones internas de Clientes tengan consecuencias sobre Pedidos. Clientes puede ser responsable de la identidad, el estado y las reglas de ciclo de vida de una persona, mientras que Pedidos solo necesita conservar una referencia estable al cliente y obtener determinados datos para cumplir con sus propias responsabilidades. Sin embargo, cuando Pedidos resuelve esa necesidad consultando directamente las tablas de Clientes, termina dependiendo no solo de los datos que necesita, sino también de la forma en que Clientes los almacena y organiza.
Este escenario plantea una cuestión que va más allá de una consulta concreta o de una columna que haya cambiado. Si dos microservicios comparten la misma base de datos, ¿cómo pueden relacionarse sin convertir las estructuras internas de un dominio en dependencias del otro? Y, sobre todo, ¿cómo se puede establecer una frontera clara cuando la infraestructura sigue siendo compartida?
El problema real: acoplamiento al esquema ajeno
Supongamos que Clientes es responsable de la identidad, el estado y las reglas de ciclo de vida de una persona. Pedidos, en cambio, es responsable de los pedidos y necesita conservar una referencia estable al cliente asociado.
Pedidos necesita saber quién es el cliente, pero no necesita conocer cómo Clientes organiza internamente esa información. No debería depender de si el nombre se almacena en una columna, en dos columnas, en una tabla normalizada o mediante una relación con otra entidad. Tampoco debería decidir qué significa anonimizar una cuenta ni asumir que todas las columnas existentes en clientes son datos que puede interpretar.
Sin embargo, cuando ambos servicios comparten una base de datos, es fácil terminar con algo como esto:
CREATE TABLE pedidos (
    id UUID PRIMARY KEY,
    cliente_id UUID NOT NULL,
    total NUMERIC(12, 2) NOT NULL,
    creado_en TIMESTAMPTZ NOT NULL DEFAULT NOW(),

    CONSTRAINT fk_pedidos_cliente
        FOREIGN KEY (cliente_id) REFERENCES clientes(id)
);
Al estudiar pedidos, la FOREIGN KEY deja visible una relación con clientes. Esa relación es importante, pero conviene distinguir dos conceptos que suelen mezclarse.
Una clave foránea expresa una garantía de integridad referencial. Le dice al motor que un valor de pedidos.cliente_id debe corresponder a un registro existente en clientes.id, de acuerdo con las reglas de la restricción.
Eso no significa que clientes se haya convertido en una API para Pedidos.
Tampoco significa que Pedidos tenga derecho a consultar cualquier columna de la tabla, ejecutar JOIN arbitrarios o depender de la forma en que Clientes almacena sus datos. La clave foránea hace visible una relación entre estructuras; no define una interfaz de integración entre dominios.
El verdadero acoplamiento aparece cuando Pedidos empieza a hacer algo como esto:
SELECT
    p.id,
    p.total,
    c.nombre,
    c.estado,
    c.tipo_documento
FROM pedidos p
JOIN clientes c ON c.id = p.cliente_id;
La consulta parece inocente. El problema es que convierte clientes en una interfaz accidental.
A partir de ese momento, Clientes no puede modificar libremente nombre, estado o tipo_documento porque Pedidos ha asumido que esas columnas forman parte de su contrato. Si mañana Clientes normaliza el nombre, cambia el modelo de estados o separa la información personal de la comercial, el cambio deja de ser exclusivamente suyo.
flowchart LR
    Clientes[(Clientes)]
    Pedidos[(Pedidos)]

    Pedidos -->|JOIN y acceso a tablas privadas| Clientes
La frontera se ha roto porque el consumidor depende de la estructura interna del propietario para funcionar.
Por eso, al analizar una base de datos compartida, la pregunta importante no es únicamente «¿existe una FOREIGN KEY?». La pregunta relevante es «¿qué parte de esta estructura está siendo utilizada como interfaz por otro dominio?».
Relación local o contrato entre dominios
Antes de modificar el DDL conviene clasificar la relación.
Cuando la relación protege una invariante dentro del mismo dominio, la FOREIGN KEY sigue siendo una herramienta apropiada. Si dos tablas pertenecen al mismo modelo y la existencia de una fila depende de la existencia de otra, eliminar la restricción únicamente para conseguir una apariencia de autonomía significa renunciar a una garantía que el motor puede proporcionar de forma fiable.
La situación cambia cuando la relación cruza límites de propiedad.
Pedidos puede conservar cliente_id como referencia estable al cliente. Ese identificador expresa una relación entre conceptos, pero no concede a Pedidos permiso para interpretar el modelo interno de Clientes.
Esta distinción es importante porque eliminar una FOREIGN KEY no crea automáticamente autonomía. Solo elimina una garantía de integridad referencial.
La autonomía aparece cuando cada dominio puede modificar su estructura interna sin romper a sus consumidores.
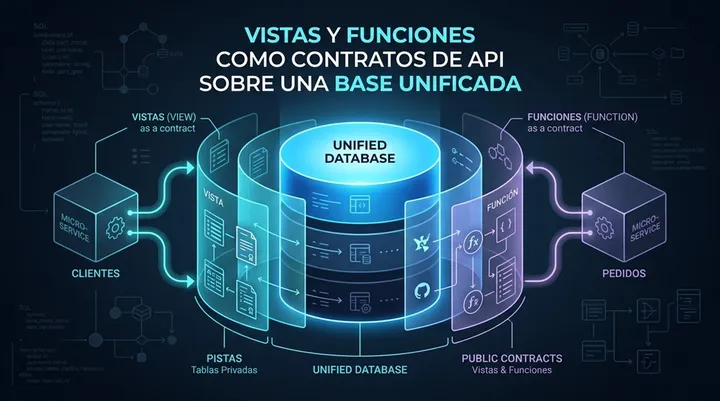
De aquí surge una estrategia especialmente útil para escenarios de transición: Database as an API. La base de datos continúa siendo compartida desde el punto de vista físico, pero sus esquemas dejan de funcionar como una superficie de acceso indiscriminado. Cada dominio mantiene sus estructuras privadas y decide explícitamente qué información publica y qué operaciones permite.
La frontera lógica aparece antes que la frontera física.
Vistas como contratos de lectura
Para las lecturas entre dominios, una de las herramientas más sencillas disponibles en una base relacional es una vista.
Clientes puede mantener sus tablas privadas y publicar únicamente la información que Pedidos necesita:
CREATE VIEW clientes_publicos_para_pedidos AS
SELECT
    id AS cliente_id,
    nombre_comercial,
    estado_comercial
FROM clientes;
Pedidos deja entonces de depender directamente de clientes:
SELECT
    cliente_id,
    nombre_comercial,
    estado_comercial
FROM clientes_publicos_para_pedidos
WHERE cliente_id = :cliente_id;
La diferencia parece pequeña desde el punto de vista de SQL, pero es significativa desde el punto de vista arquitectónico.
La tabla clientes representa el modelo interno del dominio. La vista clientes_publicos_para_pedidos representa una superficie publicada.
La vista puede funcionar conceptualmente como un DTO o como un endpoint GET: expone un conjunto definido de datos y oculta cómo se obtiene internamente.
Clientes podría, por ejemplo, pasar de una tabla monolítica a varias tablas normalizadas:
clientes
    ├── identidades
    ├── perfiles
    └── estados_comerciales
Mientras la vista conserve su contrato:
cliente_id
nombre_comercial
estado_comercial
Pedidos no necesita conocer ese cambio.
La vista, por supuesto, no hace que el contrato desaparezca. Al contrario: lo hace explícito. Cambiar el nombre de una columna publicada, eliminarla o alterar significativamente su semántica debe tratarse como un cambio contractual, aunque no exista HTTP de por medio.
Esta estrategia resulta particularmente útil cuando varios servicios ya utilizan el mismo motor de base de datos. Permite reducir el acoplamiento sin exigir inmediatamente una migración física completa.
También puede tener ventajas operativas. Una lectura que permanece dentro del mismo motor evita llamadas adicionales entre microservicios y puede evitar tráfico de red o costos de egress que aparecerían al sacar la consulta fuera de la infraestructura. Pero conviene no confundir esto con «latencia cero»: la consulta sigue consumiendo CPU, memoria, I/O y capacidad de concurrencia de la base de datos.
Además, una vista no crea independencia física. Los servicios siguen compartiendo disponibilidad, capacidad, credenciales, copias de seguridad, mantenimiento y, potencialmente, una misma condición de fallo.
La vista reduce el acoplamiento al esquema. No elimina el acoplamiento operativo a la infraestructura compartida.
Las lecturas y las escrituras necesitan fronteras diferentes
Aquí aparece una distinción fundamental. No todas las interacciones con una base de datos pueden modelarse de la misma manera.
Una lectura puede exponerse mediante una vista porque, conceptualmente, está proporcionando una representación de información. Una escritura, en cambio, puede modificar el estado del dominio y activar decisiones de negocio.
Por eso conviene distinguir entre una operación técnica y una operación que expresa una decisión de negocio.
Cuando la operación pertenece al negocio
Si una escritura necesita validar reglas, permisos, transiciones de estado, límites, invariantes o efectos secundarios, la autoridad debería permanecer en el servicio propietario.
En ese caso, REST o gRPC son canales adecuados para expresar la operación:
Pedidos
   |
   | POST /clientes/{id}/suspension
   v
Clientes
   |
   +--> valida autorización
   +--> comprueba estado actual
   +--> aplica reglas de negocio
   +--> registra auditoría
   +--> persiste el nuevo estado
Pedidos no debería ejecutar directamente una función SQL equivalente a «suspender cliente» simplemente porque ambos servicios comparten una base de datos.
La suspensión no es solamente un UPDATE. Es una decisión.
Clientes debe determinar si la transición es válida, quién puede ejecutarla, qué auditoría requiere y qué otros efectos deben producirse. Si Pedidos pudiera modificar directamente la fila, el servicio propietario perdería el control de su propio dominio.
Cuando la operación es puramente técnica
Existe otro tipo de operación que sí puede tener sentido encapsular en SQL: una operación técnica, acotada, atómica y sin decisiones de negocio.
Por ejemplo, una función podría eliminar un registro temporal identificado explícitamente:
CREATE FUNCTION purgar_registro_temporal(p_registro_id UUID)
RETURNS VOID
LANGUAGE SQL
AS $$
    DELETE FROM registros_temporales
    WHERE id = p_registro_id;
$$;
La semántica es deliberadamente limitada. Si el registro existe, se elimina; si no existe, la operación no necesita tomar una decisión adicional.
La función no determina quién tiene derecho a suspender una cuenta, qué significa que una cuenta esté inactiva ni qué transición de negocio corresponde.
Este tipo de función puede ser útil como mecanismo de infraestructura, pero existe un riesgo importante: convertir gradualmente la base de datos en una segunda capa de aplicación.
Cuando cada nueva regla termina implementada como un stored procedure, la lógica queda repartida entre el backend y la base de datos. Las pruebas, el versionado, la observabilidad y el razonamiento sobre las reglas se vuelven progresivamente más difíciles.
La regla práctica es sencilla:
La base puede encapsular acceso y operaciones técnicas; el servicio debe conservar las decisiones del dominio.
Una matriz para decidir dónde vive cada operación
Esta separación puede resumirse en una regla operativa:
| Operación | Tipo de lógica | Canal | Responsabilidad |
|---|---|---|---|
| Lectura de datos publicados | Consulta | VIEW |
El dominio propietario define el contrato |
| Escritura técnica acotada | Infraestructura | FUNCTION SQL |
La función ejecuta una operación atómica y limitada |
| Escritura con decisiones | Negocio | REST/gRPC | El servicio propietario valida y persiste |
| Lectura entre dominios | Consulta | VIEW |
Se evita el JOIN sobre tablas privadas |
La matriz no pretende convertir la base de datos en un reemplazo universal de los servicios. Su propósito es asignar cada responsabilidad al canal que puede sostenerla sin volver a abrir el acceso indiscriminado al esquema interno.
El contrato también necesita gobierno
Una vista por sí sola no resuelve el problema. Si cualquier desarrollador puede modificarla sin considerar a sus consumidores, simplemente se habrá sustituido una dependencia implícita por otra.
Cada esquema y cada tabla privada deben tener un propietario claro. Las credenciales de Pedidos no deberían disponer de escritura sobre las tablas de Clientes y, cuando sea posible, tampoco deberían tener lectura directa sobre ellas.
El acceso público debe concederse sobre objetos concretos:
clientes
    ├── tablas privadas
    ├── funciones internas
    └── vistas publicadas
            └── acceso para Pedidos
El principio de mínimo privilegio ayuda a convertir la arquitectura deseada en una restricción técnica. Si Pedidos no tiene permiso para leer clientes, un nuevo JOIN directo deja de ser una tentación que depende exclusivamente de la disciplina del equipo.
Los contratos publicados también necesitan versionado.
Si la vista expone:
cliente_id
nombre_comercial
estado_comercial
y una nueva versión requiere eliminar estado_comercial, no debería tratarse como una modificación trivial. Es un cambio de contrato.
Una estrategia puede ser crear una nueva versión:
clientes_publicos_para_pedidos_v1
clientes_publicos_para_pedidos_v2
y mantener ambas durante un período de transición.
La nomenclatura concreta puede variar. Lo importante es que exista una forma de distinguir entre cambios compatibles y cambios incompatibles y que los consumidores puedan migrar deliberadamente.
El mismo principio aplica a las funciones SQL. Su firma, parámetros, comportamiento y permisos forman parte de una interfaz. No porque exista HTTP, sino porque otro componente depende de ella.
Medir antes de retirar
Una de las dificultades prácticas de estas migraciones es descubrir quién utiliza realmente una tabla.
En sistemas maduros, la documentación rara vez contiene todas las dependencias. Puede haber consultas en servicios antiguos, procesos batch, scripts operativos, herramientas de análisis, trabajos programados o accesos manuales que nadie recuerda.
Por eso la migración debería empezar con un inventario.
No basta con buscar referencias en el código fuente. También conviene revisar permisos, consultas observables en el motor, jobs programados, procesos de integración y consumidores conocidos.
El objetivo es construir un mapa aproximado:
                 ┌── Pedidos
clientes ────────┼── Facturación
                 ├── Reportes
                 └── Batch histórico
A partir de ahí, cada dependencia puede clasificarse.
Algunas serán invariantes legítimas. Otras serán lecturas que deberían convertirse en vistas. Otras serán escrituras que necesitan regresar al servicio propietario. Y algunas serán dependencias históricas que ya pueden eliminarse.
La observabilidad también permite medir el éxito de la transición: número de consumidores, frecuencia de consultas, latencia, errores, volumen de datos y tráfico entre dominios.
El objetivo no es solamente cambiar SQL. Es poder demostrar que la frontera está funcionando.
Una migración gradual sobre la misma infraestructura
Una de las ventajas de este enfoque es que no exige separar físicamente las bases desde el primer día.
La transición puede comenzar con la infraestructura actual.
Primero se construye un inventario de JOIN, consultas directas, procesos batch y permisos entre esquemas. Después se clasifican las relaciones para distinguir invariantes locales de dependencias entre dominios.
A continuación se declara quién es propietario de cada tabla, identificador y regla de ciclo de vida. Esta definición es importante porque una arquitectura no puede establecer fronteras si no está claro quién tiene autoridad sobre aquello que queda dentro de ellas.
Las lecturas necesarias para otros dominios se trasladan a vistas públicas. Las escrituras que expresan reglas de negocio se llevan a REST o gRPC. Las funciones SQL que permanezcan se mantienen deliberadamente pequeñas y técnicas.
Después se versionan los contratos y se empieza a medir su utilización.
Solo cuando los consumidores han dejado de depender de las tablas privadas tiene sentido retirar gradualmente esos permisos y revisar las FOREIGN KEY que atraviesan límites de propiedad.
Este orden importa.
Eliminar primero las restricciones o mover físicamente las bases no resuelve las dependencias semánticas. Es posible tener dos bases de datos completamente separadas y seguir manteniendo un acoplamiento fuerte si un servicio depende de la estructura interna del otro mediante consultas, replicaciones o procesos frágiles.
La frontera lógica debe preceder a la frontera física.
Preparar una futura separación física
Este modelo también puede funcionar como una etapa intermedia hacia una arquitectura con bases independientes.
Mientras ambos dominios comparten el mismo motor, Pedidos puede consumir:
VIEW clientes_publicos_para_pedidos
Más adelante, si Clientes pasa a tener su propia base de datos, esa misma semántica puede representarse mediante:
GET /clientes/{id}
o mediante un contrato equivalente en gRPC.
El cambio de infraestructura no necesita redefinir desde cero qué información necesita Pedidos. La interfaz conceptual ya existía.
Esto permite entender Database as an API no como una arquitectura final obligatoria, sino como una técnica de transición: primero se estabiliza el contrato y después, si es necesario, se separa la infraestructura que lo implementa.
La separación física deja de ser el mecanismo que crea la frontera y pasa a ser una consecuencia posible de una frontera que ya estaba definida.
Conclusión: la frontera que realmente hay que proteger
El desafío de trabajar con microservicios sobre una base de datos compartida no está en la existencia de una relación entre tablas, sino en determinar qué parte del modelo pertenece a cada dominio y qué información puede ser utilizada por los demás. Una relación entre pedidos y clientes puede ser necesaria desde el punto de vista de los datos, pero eso no significa que Pedidos deba conocer o depender de la estructura interna con la que Clientes gestiona sus propias entidades.
La autonomía comienza cuando cada dominio puede evolucionar su modelo interno sin obligar a los demás servicios a conocer esos cambios. Para conseguirlo, la base de datos compartida necesita límites explícitos. Las vistas permiten publicar únicamente los datos que un consumidor necesita; las funciones SQL pueden encapsular operaciones técnicas acotadas; y las decisiones que contienen reglas de negocio deben permanecer bajo la responsabilidad del servicio propietario, mediante REST, gRPC u otro mecanismo de integración apropiado.
Esto convierte la base de datos en algo más que un repositorio común. Puede actuar como una infraestructura compartida que ofrece contratos de acceso definidos y gobernados, en lugar de convertirse en un espacio donde cualquier servicio puede consultar y modificar libremente las estructuras de los demás.
Para que este modelo sea sostenible, los contratos necesitan las mismas garantías que cualquier otra interfaz entre componentes: propietarios claros, permisos restringidos, versionado, compatibilidad entre cambios, observabilidad y un proceso controlado para retirar consumidores. De esta manera, una vista o una función no son simplemente objetos de base de datos, sino parte de una superficie que un dominio decide publicar y mantener.
Este enfoque también permite avanzar de forma gradual. No es necesario separar físicamente las bases de datos para comenzar a establecer límites entre los servicios. Primero pueden definirse los contratos y eliminarse las dependencias directas sobre las tablas privadas. Más adelante, si las necesidades operativas lo requieren, esos mismos contratos pueden trasladarse a una API o a otra forma de comunicación entre servicios.
La separación física, por tanto, no tiene que ser el punto de partida para conseguir autonomía. Puede ser una evolución posterior de una frontera que ya existe a nivel lógico.
La idea central es sencilla:
Compartir una base de datos no obliga a compartir el modelo interno de cada dominio.
La cuestión importante no es cuándo eliminar una relación entre tablas ni cuándo separar físicamente las bases de datos. La cuestión es qué información y qué operaciones está dispuesto a publicar cada dominio, bajo qué condiciones y con qué garantías de estabilidad.
Cuando esa frontera está claramente definida, la base de datos compartida deja de ser una fuente de dependencias accidentales y puede convertirse en una etapa controlada hacia una arquitectura con mayor independencia. El siguiente paso natural consiste en estudiar cómo versionar estos contratos, detectar automáticamente a sus consumidores y establecer mecanismos que permitan evolucionar desde una base unificada hacia servicios con almacenamiento independiente cuando la arquitectura y las necesidades operativas lo justifiquen.
Tablas Normalizadas vs. JSON/JSONB en PostgreSQL
- Mauricio ECR
- Persistencia
- 11 Jul, 2025
En el diseño de bases de datos, la normalización ha sido durante mucho tiempo sinónimo de integridad, eficiencia y orden. Sin embargo, los tiempos cambian, y con ellos, las necesidades de los sistemas

Tablas Normalizadas vs. JSON/JSONB en PostgreSQL
- Mauricio ECR
- Persistencia
- 11 Jul, 2025
En el diseño de bases de datos, la normalización ha sido durante mucho tiempo sinónimo de integridad, eficiencia y orden. Sin embargo, los tiempos cambian, y con ellos, las necesidades de los sistemas modernos. Los datos semi-estructurados ganan terreno, y PostgreSQL ha sabido adaptarse integrando soporte robusto para los tipos JSON y JSONB. Esta evolución plantea una pregunta crucial: ¿seguir apostando por la rigidez de las tablas normalizadas o abrazar la elasticidad del modelo documental?
El Dilema: Estructura vs. Flexibilidad
La decisión entre un modelo relacional rígido y uno dinámico basado en documentos tiene implicaciones profundas en rendimiento, mantenibilidad y escalabilidad. Entender sus ventajas y límites es clave para construir sistemas sólidos y adaptables.
Tablas Normalizadas: Precisión con Disciplina
La normalización organiza datos para evitar duplicidades y asegurar integridad, a través de estructuras bien definidas y relaciones explícitas.
Ventajas:
- Integridad de Datos: Claves foráneas, restricciones
UNIQUEy validacionesCHECKaseguran coherencia. - Eficiencia en Escrituras: Modificaciones atómicas reducen el riesgo de anomalías.
- Ahorro de Espacio: La minimización de redundancia optimiza el almacenamiento.
- Consultas Optimizadas: Los
JOINson eficientemente resueltos por el planificador de PostgreSQL.
Desventajas:
- Cambios Costosos: Alterar la estructura requiere migraciones.
- Complejidad en Consultas: Obtener una visión completa puede implicar múltiples
JOIN. - Lecturas Pesadas: Agregaciones sobre muchas tablas pueden degradar el rendimiento.
Cuándo Usarlas: Cuando los datos tienen una estructura estable y la integridad es prioritaria. Casos típicos incluyen sistemas contables, gestión de inventarios y aplicaciones bancarias.
JSON/JSONB: Flexibilidad sin Esquema
PostgreSQL permite almacenar JSON de dos maneras:
json: Mantiene el texto original. Más rápido al insertar, pero más lento en consultas.jsonb: Almacena en formato binario. Un poco más lento al insertar, pero mucho más eficiente al consultar y permite indexación avanzada. En la mayoría de los casos, es la opción recomendada.
Ventajas:
- Esquema Dinámico: Atributos variables sin necesidad de alterar el modelo.
- Consultas Directas: Datos relacionados pueden vivir en un único documento.
- Prototipado Rápido: Ideal para iterar sin fricciones durante el desarrollo.
Desventajas:
- Sin Integridad Referencial: Las relaciones deben ser gestionadas manualmente.
- Redundancia y Consistencia: Datos duplicados son comunes, lo que implica riesgos si no se sincronizan.
- Actualizaciones Complejas: Modificar datos anidados no es tan directo como un
UPDATE.
Cuando destaca: Para casos con estructuras cambiantes, como configuraciones, eventos, integración de APIs externas o metadata variable
JSONB: Consultas, Índices y Más
Consultas y Proyecciones
PostgreSQL ofrece operadores intuitivos para navegar por estructuras JSONB:
->: Accede a un campo, devuelvejsonb.->>: Accede y devuelve texto.#>: Navega rutas anidadas, devuelvejsonb.#>>: Igual que#>, pero como texto.
Ejemplo de Uso:
CREATE TABLE productos (
    id SERIAL PRIMARY KEY,
    nombre TEXT NOT NULL,
    detalles JSONB
);

INSERT INTO productos (nombre, detalles) VALUES
('Laptop Pro', '{"precio": 1500, "fabricante": "TechCorp", "especs": {"cpu": "i7", "ram": 16, "almacenamiento": 512}}'),
('Smartphone X', '{"precio": 800, "fabricante": "MobileFirst", "especs": {"cpu": "Snapdragon 8", "ram": 8, "almacenamiento": 256}}');
Proyecciones:
SELECT nombre, detalles->>'precio' AS precio FROM productos;

SELECT nombre, detalles#>'{especs, ram}' AS ram FROM productos;
Filtrado y Búsquedas
Operadores potentes permiten extraer información fácilmente:
@>: Contiene.<@: Está contenido.?: Existe clave.?|: Existe alguna.?&: Existen todas.
Ejemplos:
SELECT * FROM productos WHERE detalles @> '{"fabricante": "TechCorp"}';

SELECT * FROM productos WHERE detalles @> '{"especs": {"ram": 16}}';

SELECT * FROM productos WHERE detalles ? 'precio';
Indexación
Las consultas sobre JSONB pueden volverse lentas sin índices adecuados. PostgreSQL ofrece:
- GIN (Generalized Inverted Index): El más recomendado. Optimiza búsquedas con
@>,?,?|,?&. - GiST: Más versátil, pero menos eficiente en general.
Ejemplo:
CREATE INDEX idx_productos_detalles_gin ON productos USING GIN (detalles);
También es posible crear índices B-tree sobre campos específicos:
CREATE INDEX idx_productos_fabricante ON productos ((detalles->>'fabricante'));
Actualizaciones Parciales
Con jsonb_set, es posible modificar datos sin reescribir todo el documento:
UPDATE productos
SET detalles = jsonb_set(detalles, '{precio}', '1450')
WHERE nombre = 'Laptop Pro';

UPDATE productos
SET detalles = jsonb_set(detalles, '{especs, ram}', '32')
WHERE nombre = 'Laptop Pro';
Modelo Híbrido: Lo Mejor de Dos Mundos
Combinar estructuras relacionales con campos JSONB permite construir sistemas flexibles, sin sacrificar integridad.
Ventajas del enfoque mixto:
- Datos críticos viven en columnas estructuradas.
- Atributos variables residen en campos JSONB.
- Menos
JOINs, más velocidad. - Menos migraciones con cada cambio de requisitos.
Casos Prácticos
1. E-commerce: Productos con atributos diversos
CREATE TABLE productos (
    id SERIAL PRIMARY KEY,
    nombre TEXT NOT NULL,
    precio DECIMAL(10, 2),
    categoria_id INT REFERENCES categorias(id),
    especificaciones JSONB
);

CREATE INDEX idx_especificaciones_gin ON productos USING GIN (especificaciones);

SELECT * FROM productos
WHERE categoria_id = 1
AND especificaciones @> '{"ram": "16GB", "almacenamiento": "SSD"}';
2. SaaS: Preferencias de usuario
ALTER TABLE usuarios ADD COLUMN preferencias JSONB DEFAULT '{}';

UPDATE usuarios
SET preferencias = jsonb_set(preferencias, '{tema}', '"claro"')
WHERE id = 123;
3. Logs y eventos con estructuras variables
CREATE INDEX idx_eventos_detalles_ip ON eventos ((detalles->>'ip'));

SELECT * FROM eventos
WHERE tipo = 'login'
AND detalles->>'ip' = '192.168.1.1';
Claves del Modelo Híbrido
- Desarrollo Ágil: Sin necesidad de migrar con cada cambio menor.
- Rendimiento: Índices GIN aceleran búsquedas complejas.
- Mantenibilidad: Las estructuras centrales permanecen estables.
- Integración Sencilla: Ideal para microservicios y respuestas JSON de APIs externas.
Conclusión: El Futuro es Híbrido
No se trata de elegir entre rigidez o flexibilidad, sino de combinarlas inteligentemente. PostgreSQL permite construir arquitecturas donde:
- Los datos estables viven en tablas relacionales.
- Los atributos cambiantes se encapsulan en JSONB.
- El SQL moderno los une con potencia y elegancia.
La evolución de jsonb —junto con el soporte creciente para SQL/JSON path— abre nuevas puertas. El enfoque híbrido no es una moda, es una estrategia para diseñar sistemas duraderos, escalables y listos para adaptarse a lo que viene.
🔗 Recursos Recomendados
Guía Rápida de Comandos y Cláusulas SQL
- Mauricio ECR
- Persistencia
- 15 Apr, 2025
SQL (Structured Query Language) es el lenguaje estándar para gestionar y manipular bases de datos relacionales. A continuación, encontrarás una guía rápida con los comandos y cláusulas más utilizados,

Guía Rápida de Comandos y Cláusulas SQL
- Mauricio ECR
- Persistencia
- 15 Apr, 2025
SQL (Structured Query Language) es el lenguaje estándar para gestionar y manipular bases de datos relacionales. A continuación, encontrarás una guía rápida con los comandos y cláusulas más utilizados, ejemplos prácticos y el orden de ejecución en una consulta SQL.
🛠️ Comandos Básicos de SQL
- SELECT: Selecciona datos de una tabla.
- FROM: Indica la tabla desde la cual se obtendrán los datos.
- WHERE: Filtra los resultados según una condición.
- AS: Asigna un alias a una columna o tabla.
- JOIN: Combina filas de dos o más tablas.
- AND: Une condiciones, todas deben cumplirse.
- OR: Une condiciones, al menos una debe cumplirse.
- LIMIT: Limita la cantidad de filas devueltas.
- IN: Filtra por varios valores posibles en una condición.
- CASE: Devuelve un valor basado en condiciones.
- IS NULL: Devuelve solo las filas con valores nulos.
- LIKE: Busca patrones dentro de una columna.
- COMMIT: Guarda los cambios de una transacción.
- ROLLBACK: Revierte una transacción.
🔧 Modificación de Tablas
- ALTER TABLE: Agrega o elimina columnas.
- UPDATE: Modifica datos existentes.
- CREATE: Crea una tabla, base de datos, índice o vista.
- DELETE: Elimina filas de una tabla.
- INSERT: Agrega una fila nueva.
- DROP: Elimina una tabla, base de datos o índice.
📊 Funciones de Agregación
- GROUP BY: Agrupa datos en conjuntos lógicos.
- ORDER BY: Ordena los resultados (usar
DESCpara descendente). - HAVING: Similar a WHERE pero se aplica a grupos.
- COUNT(): Cuenta el número de filas.
- SUM(): Suma los valores de una columna.
- AVG(): Calcula el promedio de una columna.
- MIN(): Devuelve el valor mínimo.
- MAX(): Devuelve el valor máximo. `
🔗 Tipos de JOIN
- INNER JOIN: Devuelve solo las coincidencias en ambas tablas.
- LEFT JOIN: Devuelve todos los registros de la tabla izquierda y coincidencias de la derecha.
- RIGHT JOIN: Devuelve todos los registros de la tabla derecha y coincidencias de la izquierda.
- FULL OUTER JOIN: Devuelve todos los registros con coincidencias en cualquiera de las tablas.
🔄 Orden de Ejecución en una Consulta SQL
- FROM – Se identifican las tablas.
- WHERE – Se filtran las filas.
- GROUP BY – Se agrupan los datos.
- HAVING – Se filtran los grupos.
- SELECT – Se seleccionan las columnas.
- ORDER BY – Se ordenan los resultados.
- LIMIT – Se limita la cantidad de filas.
💡 Ejemplos de SQL
Consultas Básicas
-- Seleccionar todas las columnas con filtro
SELECT * FROM tabla WHERE columna > 5;

-- Seleccionar primeras 10 filas de dos columnas
SELECT col1, col2 FROM tabla LIMIT 10;

-- Múltiples filtros con OR
SELECT * FROM tabla WHERE col1 > 5 OR col2 < 2;

-- Ordenar resultados
SELECT col1, col2 FROM tabla ORDER BY 1;
Funciones de Agregación
-- Contar filas
SELECT COUNT(*) FROM tabla;

-- Sumar valores
SELECT SUM(col1) FROM tabla;

-- Valor máximo
SELECT MAX(col1) FROM tabla;

-- Promedio agrupado
SELECT AVG(col1) FROM tabla GROUP BY col2;
Consultas Avanzadas
-- LEFT JOIN con alias
SELECT * FROM tabla AS t1 LEFT JOIN tabla2 AS t2 ON t2.col1 = t1.col1;

-- Agregación con filtro de grupo
SELECT col1, COUNT(*) AS total FROM tabla GROUP BY col1 HAVING COUNT(*) > 10;

-- Uso de CASE
SELECT col1,
       CASE
         WHEN col1 > 10 THEN 'más de 10'
         WHEN col1 < 10 THEN 'menos de 10'
         ELSE 'es 10'
       END AS NuevaColumna
FROM tabla;
🧱 Lenguaje de Definición de Datos (DDL)
-- Crear base de datos y tabla
CREATE DATABASE MiBase;
CREATE TABLE MiTabla (id INT, nombre VARCHAR(18));

-- Crear índice
CREATE INDEX IndiceNombre ON MiTabla(col1);

-- Alterar tabla
ALTER TABLE MiTabla ADD col5 INT;
ALTER TABLE MiTabla DROP COLUMN col5;

-- Eliminar base de datos o tabla
DROP DATABASE MiBase;
DROP TABLE MiTabla;
✍️ Lenguaje de Manipulación de Datos (DML)
-- Insertar fila
INSERT INTO MiTabla (col1, col2) VALUES ('valor1', 'valor2');

-- Actualizar valores
UPDATE MiTabla SET col1 = 56 WHERE col2 = 'algo';

-- Eliminar filas
DELETE FROM MiTabla WHERE col1 = 'algo';

-- Seleccionar columnas
SELECT col1, col2 FROM MiTabla;
¿SQL o NoSQL? Descubre la Base de Datos Ideal para tu Proyecto
- Mauricio ECR
- Persistencia
- 29 Mar, 2025
Introducción Elegir la base de datos adecuada para un proyecto es una decisión crítica que afecta la escalabilidad, el rendimiento y la facilidad de mantenimiento de una aplicación. ¿Necesitas una

¿SQL o NoSQL? Descubre la Base de Datos Ideal para tu Proyecto
- Mauricio ECR
- Persistencia
- 29 Mar, 2025
Introducción
Elegir la base de datos adecuada para un proyecto es una decisión crítica que afecta la escalabilidad, el rendimiento y la facilidad de mantenimiento de una aplicación. ¿Necesitas una base de datos relacional o una documental? Este cuestionario te ayudará a tomar la mejor decisión basada en los requisitos específicos de tu proyecto. Responde las siguientes preguntas y obtén una recomendación basada en tus necesidades técnicas y operativas.
Contexto del Proyecto
Antes de responder, defina:
- Caso de uso principal: Ej: sistema transaccional, catálogo de productos, IoT, contenido generado por usuarios.
- Velocidad de crecimiento de datos: Estimación anual (GB/TB).
- Ratio lecturas/escrituras: Ej: 80/20, 50/50.
1. Modelado de Datos
¿Los datos tienen una estructura fija y predefinida que se mantiene estable (>80% de los casos)?
- Ej: tablas de clientes con campos obligatorios vs. posts de redes sociales con metadatos variables.
¿Es crítico modelar relaciones muchos-a-muchos entre entidades principales?
- Ej: estudiantes-cursos vs. tags en un blog.
¿La normalización para evitar redundancia es prioritaria sobre la velocidad de lectura?
¿El esquema cambia menos de 2 veces/año?
¿Los registros comparten >90% de atributos comunes?
¿Los datos son principalmente planos o con anidamiento simple (≤2 niveles)?
- Ej: dirección
{calle, ciudad}vs. JSON con subdocumentos jerárquicos.
- Ej: dirección
¿La integridad referencial (FKs) es no negociable para el negocio?
¿Los datos son >70% valores escalares (números, textos cortos) vs. documentos/blobs?
¿Se pueden representar sin pérdida en tablas 2D?
- Ej: evita estructuras como arrays o árboles.
¿Prefiere almacenar documentos completos (JSON/XML) en lugar de desnormalizar?
¿Necesita consultar fragmentos específicos dentro de documentos anidados frecuentemente?
¿Los atributos varían significativamente entre registros de la misma entidad?
- Ej: productos con especificaciones técnicas heterogéneas.
2. Operaciones y Consultas
¿Las consultas frecuentes (≥30%) requieren JOINs entre ≥3 tablas?
¿Las búsquedas acceden a campos estructurados individuales (no documentos completos)?
¿Son esenciales transacciones ACID que abarcan múltiples operaciones/entidades?
- Nota: Algunas bases documentales (MongoDB 4.0+) soportan transacciones multi-documento.
¿Las consultas usan principalmente claves primarias/índices simples (no consultas ad-hoc)?
¿Se filtran datos usando ≥3 atributos simultáneamente en >50% de las consultas?
¿Prefiere consultar datos anidados directamente en lugar de desnormalizar?
¿Las escrituras implican actualizaciones parciales complejas (no reemplazos completos)?
¿Requiere agregaciones multidimensionales (OLAP) sobre >1TB de datos?
¿Las consultas acceden a ≥3 entidades relacionadas en >40% de los casos?
¿Es crítico tener un esquema fijo para validar datos en ingesta?
¿Usa consultas geoespaciales o de grafos con frecuencia?
- Nota: Ambos modelos pueden soportarlo, pero con implementaciones distintas.
¿Necesita índices compuestos sobre múltiples campos anidados?
3. Requerimientos No-Funcionales
¿El volumen total estimado en 3 años es <50TB?
- Nota: Bases relacionales distribuidas (CockroachDB) pueden manejar petabytes.
¿La alta disponibilidad requiere consistencia fuerte (no eventual)?
¿El ratio lecturas/escrituras es >70/30?
¿Puede tolerar latencias >15ms en operaciones críticas?
¿El equipo tiene ≥2 años de experiencia con SQL?
¿Es esencial compatibilidad con herramientas BI tradicionales (Power BI, Tableau)?
¿Requiere replicación transaccional cross-region?
¿Necesita escalado horizontal automático (sharding) sin downtime?
- Nota: Algunas RDBMS (Vitess) permiten sharding con límites.
¿La carga incluye >50K operaciones/segundo sostenidas?
¿Los backups deben ser incrementales con recuperación a momento específico?
¿Puede aceptar bloqueos por migraciones de esquema (>1 min de downtime)?
5 Preguntas Críticas Decisivas
¿Es no negociable la integridad referencial entre entidades?
- Sí → Relacional (a menos que use extensiones como PostgreSQL + FOREIGN KEY en JSONB).
¿Los datos son >60% documentos anidados con estructura irregular?
- Sí → Documental (pero considere híbridos como MySQL + MongoDB).
¿Requiere JOINs complejos (>3 tablas) en >25% de las consultas?
- Sí → Relacional (aunque algunas documentales tienen
$lookupsimilar a JOINs).
- Sí → Relacional (aunque algunas documentales tienen
¿Necesita escalar horizontalmente sin límites prácticos?
- Sí → Documental (pero evalúe NewSQL como YugabyteDB).
¿Requiere transacciones ACID multi-operación en >30% de los casos?
- Sí → Relacional (pero verifique si su documental soporta transacciones).
Regla decisiva
Si ≥3 respuestas clave apuntan a una categoría, priorícela. En empates (2-2), evalúe el contexto del proyecto.
Interpretación de Puntajes
| Puntos Totales | Recomendación | Tecnologías Ejemplo |
|---|---|---|
| 28-35 | Relacional Puro | PostgreSQL, MySQL, SQL Server |
| 20-27 | Relacional + Extensiones | PostgreSQL (JSONB), SQL Server (XML), Oracle (JSON) |
| 15-19 | Híbrido o Multi-Modelo | MongoDB (transacciones), Cosmos DB (modo SQL), CockroachDB |
| 8-14 | Documental Puro | MongoDB, Couchbase, Firebase Firestore |
Conclusión
Este cuestionario te ofrece un marco estructurado para evaluar qué tipo de base de datos es más adecuada para tu proyecto. Si la mayoría de tus respuestas favorecen la integridad referencial, los JOINs y la validación de esquema, una base relacional es la mejor opción. Si en cambio tu proyecto requiere flexibilidad en la estructura de datos, escalabilidad horizontal y almacenamiento de documentos, una base documental puede ser la respuesta. En casos híbridos, considera soluciones como PostgreSQL con JSONB o bases multimodelo como CosmosDB. ¡Elige sabiamente para optimizar el rendimiento y la escalabilidad de tu aplicación!