- Agile 2
- Alta disponibilidad 1
- Alternativas cloud 1
- Aop 1
- Arquitectura 3
- Arquitectura distribuida 4
- Automatizacion 3
- Aws 1
- Azure devops 1
- Base de datos 1
- Buenas practicas 22
- Cloud 1
- Colas 7
- Competing consumers 1
- Convenciones 11
- Copilot 1
- Diseno 8
- Docker 2
- Docker compose 1
- Documentacion 1
- Eda 11
- Equipos 1
- Escalabilidad 1
- Flujo de negocio 1
- Flujo de trabajo 3
- Flyway 1
- Git 4
- Gradle 3
- Herramientas digitales 1
- Ia 1
- Iam 1
- Infraestructura 2
- Java 16
- Jerarquia tecnica 1
- Jpa 1
- Jsonb 1
- Kafka 7
- Kubernetes 1
- Liderazgo en software 1
- Lineamientos 1
- Log 1
- Logging 3
- Microservicios 5
- Mongodb 1
- Monitoreo 1
- Nosql 3
- Observabilidad 4
- Open source 1
- Plugins 3
- Postgresql 2
- Privacidad 1
- Programacion funcional 1
- Programacion reactiva 4
- Rabbitmq 6
- Rotacion de talento 1
- Saga 2
- Scrum 2
- Security 1
- Seguridad 1
- Self hosting 1
- Sistemas legados 1
- Snippets 1
- Spring boot 5
- Spring mvc 2
- Sql 4
- Streams 1
- Threadlocal 1
- Trazabilidad 2
- Versionado 2
- Web 1
- Webflux 2
- Websockets 1
- Zero trust 1
Java
16 artículos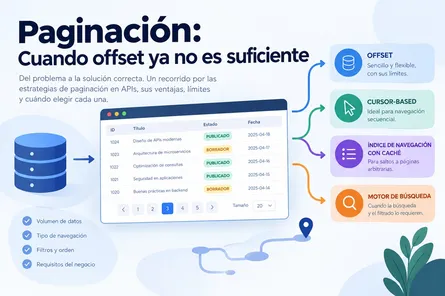
Paginacion: Cuando offset ya no es suficiente
- Mauricio ECR
- Arquitectura
- 27 Sep, 2026
Te llega la tarea y parece de las fáciles: "agregar paginación al listado de artículos". Añades ?page=0&size=20, Spring te proporciona Pageable, el repositorio hereda findAll(pageable) y, en poc
Paginacion: Cuando offset ya no es suficiente
- Mauricio ECR
- Arquitectura
- 27 Sep, 2026
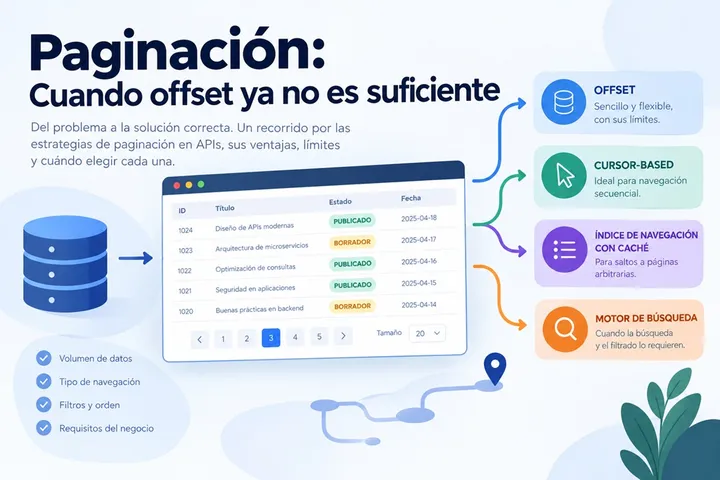
Te llega la tarea y parece de las fáciles: "agregar paginación al listado de artículos". Añades ?page=0&size=20, Spring te proporciona Pageable, el repositorio hereda findAll(pageable) y, en pocos minutos, tienes un endpoint funcionando.
En desarrollo, con mil registros, todo va bien. En staging, con diez mil, probablemente también. El problema aparece más adelante, cuando la tabla alcanza cientos de miles de filas, los filtros se vuelven más complejos y los tiempos de respuesta empiezan a crecer de una forma que ya no resulta tan fácil de explicar.
Y esa lentitud no aparece porque sí. Tiene una causa concreta, relacionada con la forma en que la base de datos resuelve la consulta internamente.
El costo invisible de OFFSET
La paginación tradicional suele apoyarse en dos cláusulas SQL: LIMIT, que determina cuántos registros devolver, y OFFSET, que indica cuántos registros deben quedar fuera antes de comenzar a devolver resultados.
SELECT * FROM articulos
ORDER BY created_at DESC
LIMIT 20 OFFSET 10000;
La consulta parece directa. Pero lo que ocurre para resolverla no siempre lo es.
Para obtener los veinte registros solicitados, el motor necesita avanzar hasta la posición indicada por el OFFSET. Los registros anteriores no forman parte del resultado final, pero el trabajo necesario para llegar hasta ellos existe.
Por eso, a medida que aumenta la profundidad de la página, puede aumentar también el trabajo que debe realizar el motor. La página 1 con tamaño 20 apenas necesita avanzar. Una página mucho más profunda tiene que recorrer una cantidad considerablemente mayor de registros antes de llegar al conjunto que finalmente devolverá.
La diferencia puede ser especialmente importante en tablas grandes. Los índices ayudan a reducir el trabajo necesario, pero no eliminan por completo la naturaleza del problema: la posición se expresa como una cantidad de registros que deben quedar atrás.
Existe además otro problema, menos visible durante las pruebas: la posición de una página puede cambiar mientras el usuario navega.
Imagina que un cliente solicita la página 3 y, antes de solicitar la página 4, se inserta un nuevo registro que queda al principio del orden.
Ese nuevo registro desplaza las posiciones siguientes. Como consecuencia, el cliente puede recibir un registro que ya había visto o dejar de recibir otro que esperaba encontrar en la siguiente página.
El mismo tipo de desplazamiento puede producirse cuando se eliminan registros o cuando una modificación cambia su posición dentro del orden.
No es necesariamente un error que aparezca durante una prueba funcional. Es un comportamiento que puede hacerse visible cuando varios usuarios navegan mientras el sistema continúa recibiendo escrituras.
Tenemos, entonces, dos problemas diferentes pero relacionados:
- El costo puede aumentar a medida que se profundiza en las páginas.
- Los resultados pueden desplazarse entre una solicitud y la siguiente cuando los datos cambian.
Estos problemas explican por qué una implementación de OFFSET que funcionaba perfectamente con una tabla pequeña puede empezar a presentar dificultades cuando cambian el volumen o la forma de utilizar el endpoint.
Pero todavía no podemos concluir que haya que reemplazar OFFSET.
La pregunta siguiente es otra: ¿qué características tiene el caso de uso que estamos intentando resolver?
Las variables que realmente determinan la solución
No existe una única solución para todos los escenarios de paginación. La estrategia adecuada depende de cómo se navegan los resultados, cómo se filtran, cómo se ordenan y cuánto crecerán los datos.
Antes de comparar alternativas, conviene responder cuatro preguntas.
La primera es probablemente la más importante:
¿El usuario navega secuencialmente o necesita saltar a páginas arbitrarias?
Navegar secuencialmente significa avanzar a partir del resultado anterior: siguiente, anterior, scroll infinito o cualquier otra interfaz en la que el usuario recorre los resultados de forma progresiva.
La navegación aleatoria es diferente. Aquí el usuario puede seleccionar directamente una página concreta, por ejemplo la 53, sin haber recorrido las anteriores.
Esta diferencia es fundamental porque algunas estrategias utilizan precisamente el resultado anterior como punto de referencia. Si el usuario necesita saltar directamente a una posición arbitraria, ese modelo deja de encajar tan bien.
La segunda pregunta aparece cuando entran en juego los filtros:
¿Los filtros utilizan valores discretos o rangos abiertos?
Un filtro discreto trabaja con un conjunto relativamente acotado de posibilidades: estado, categoría, autor o tipo.
Un rango abierto permite prácticamente cualquier combinación dentro de un continuo: una fecha entre X e Y, un precio entre A y B o una búsqueda de texto libre.
Esta diferencia se vuelve especialmente importante cuando se considera una estrategia basada en caché. Si existen pocas combinaciones posibles, una consulta puede reutilizar un resultado previamente calculado. Cuando las combinaciones son prácticamente infinitas, esa reutilización se vuelve mucho menos probable.
La tercera pregunta tiene que ver con el orden:
¿El orden de los resultados es estable o puede cambiar?
Un orden estable puede ser, por ejemplo, created_at DESC, acompañado de un identificador como desempate.
Un orden dinámico permite que el usuario cambie la columna o los criterios de orden durante la navegación. En ese caso, una referencia calculada para el orden anterior deja de representar correctamente la posición dentro del nuevo orden.
Finalmente está el volumen:
¿Cuántos registros existen hoy y cuánto se espera que crezca la tabla?
Una tabla con cincuenta mil registros presenta unas necesidades diferentes a una que puede alcanzar varios millones.
El volumen no determina por sí solo la solución, pero sí cambia el costo de las estrategias. Algo que resulta perfectamente razonable en una tabla pequeña puede dejar de serlo cuando aumentan la profundidad de las páginas, la cantidad de consultas y la concurrencia.
Con estas cuatro variables definidas, ya podemos comparar las alternativas de manera más precisa. Cada una resuelve una combinación diferente de necesidades y, al mismo tiempo, introduce sus propios límites.
Cuando OFFSET sigue siendo suficiente
La primera posibilidad es también la más sencilla: mantener OFFSET, pero controlar las condiciones en las que se utiliza.
Esto tiene sentido cuando el volumen es moderado, las páginas profundas son poco frecuentes y la navegación aleatoria forma parte de los requisitos.
En muchos sistemas, los usuarios rara vez llegan a páginas extremadamente profundas. Si una interfaz obliga a recorrer miles de páginas para encontrar un registro, probablemente el problema de fondo sea que falta una búsqueda o un mecanismo de filtrado más adecuado.
Por eso, establecer un límite máximo de profundidad puede ser una decisión razonable. Por ejemplo, se puede impedir que una API consulte páginas más allá de cierto límite y obligar al consumidor a utilizar filtros o búsqueda para localizar registros concretos.
El segundo elemento importante es el índice.
Supongamos que la consulta utiliza:
ORDER BY estado, created_at, id
Si esas columnas participan habitualmente en el orden y los filtros, un índice compuesto diseñado de acuerdo con el patrón real de consulta puede reducir considerablemente el trabajo necesario.
El costo asociado con la profundidad no desaparece por completo, pero puede disminuir de forma importante.
Aquí aparece una idea importante: no toda paginación necesita una arquitectura sofisticada.
Si el problema es pequeño y los requisitos son sencillos, introducir cursores, Redis o un motor de búsqueda puede añadir mucha más complejidad de la que realmente se necesita.
Cuándo encaja
OFFSET puede seguir siendo una buena opción cuando:
- El volumen es moderado.
- Las páginas profundas son poco frecuentes.
- El usuario necesita saltar a páginas arbitrarias.
- Los filtros y órdenes pueden cambiar dinámicamente.
- Se quiere mantener un contrato de API convencional basado en
pageysize. - La simplicidad de implementación es importante.
Qué no resuelve
El costo de las páginas profundas sigue existiendo.
Además, los cambios en los datos entre solicitudes pueden desplazar los resultados de una página a otra.
Cuando esas limitaciones dejan de ser aceptables, aparece una estrategia basada en una idea diferente: dejar de identificar la posición mediante un número y utilizar el propio orden de los datos como referencia.
Cuando la navegación es secuencial: cursor-based pagination
Aquí aparece la paginación basada en cursores, también conocida como keyset pagination.
La diferencia conceptual es sencilla.
Con OFFSET, la consulta pregunta:
"Dame los registros que están después de las primeras N posiciones."
Con un cursor, la consulta pregunta:
"Dame los registros que vienen después de este punto concreto del orden."
Por ejemplo:
SELECT * FROM articulos
WHERE (created_at, id) < (:ultima_fecha, :ultimo_id)
ORDER BY created_at DESC, id ASC
LIMIT 20;
En este caso, el último registro recibido se convierte en el punto de referencia para solicitar el siguiente conjunto.
La base de datos ya no necesita interpretar la página como una posición numérica. Puede utilizar los valores del orden para localizar el punto desde el que debe continuar.
Cuando existe un índice adecuado, esto permite evitar gran parte del trabajo asociado con recorrer posiciones profundas mediante OFFSET.
Por eso, la profundidad de la navegación deja de tener el mismo efecto que tenía en la estrategia anterior.
El cursor que recibe el cliente suele ser un token opaco. Puede contener los valores de las columnas utilizadas para determinar la posición y estar codificado, por ejemplo, mediante Base64URL.
El cliente no necesita conocer su estructura. Solo necesita conservarlo y devolverlo cuando solicite la siguiente página.
Esto permite que el backend cambie la representación interna del cursor sin obligar al cliente a interpretar sus componentes.
El requisito que hace posible un cursor
Para que este modelo funcione correctamente, el orden debe ser determinista.
Si varios registros tienen exactamente el mismo valor para el criterio principal, necesitamos una columna adicional que permita desempatar.
Por ejemplo:
ORDER BY created_at DESC, id ASC
Aquí created_at determina el orden principal y id permite distinguir registros que tienen la misma fecha.
Cuando el orden de negocio tiene varios niveles, todos ellos forman parte de la referencia.
Por ejemplo:
estado → created_at → id
El cursor deberá contener la información necesaria para reproducir esa posición dentro del orden.
El backend recibe el token, recupera esos valores y construye la condición correspondiente.
La contrapartida: la navegación deja de ser aleatoria
Aquí aparece la principal diferencia con OFFSET.
Un cursor representa un punto dentro del orden, no un número de página.
Por eso, si el usuario está recorriendo:
página 1 → página 2 → página 3 → página 4
es natural solicitar la siguiente posición.
Pero si quiere saltar directamente a la página 53, el cursor de esa página no puede calcularse simplemente a partir del número 53.
Esto significa que los cursores son especialmente adecuados cuando la navegación es secuencial.
No son simplemente una optimización de SQL: también representan un cambio en el contrato de la API y, en algunos casos, en la interfaz.
Una tabla tradicional basada en números de página no puede sustituirse por cursores manteniendo exactamente la misma semántica.
Cuándo encaja
La estrategia basada en cursores resulta especialmente apropiada para:
- Feeds.
- Historiales.
- Scroll infinito.
- Exportaciones secuenciales.
- Integraciones entre servicios.
- Tablas de gran volumen.
- Sistemas con escrituras frecuentes.
- Casos en los que el usuario no necesita saltar a una página arbitraria.
Qué no resuelve
No permite una navegación aleatoria equivalente a page=53.
Además, necesita un orden estable y determinista.
Cuando el requisito de navegación aleatoria es obligatorio, debemos buscar otra estrategia.
Cuando necesitas saltar directamente a una página
Supongamos ahora que el volumen es grande y que el usuario sí necesita ir directamente a una página concreta.
En ese caso, un cursor no encaja con el requisito principal de la interfaz.
Una posibilidad consiste en separar dos problemas que hasta ahora estaban mezclados: determinar qué registros ocupan cada posición y recuperar después los datos de esas posiciones.
La idea es construir un índice de navegación que contenga únicamente los identificadores de los registros que cumplen el filtro, en el orden correspondiente.
Por ejemplo:
SELECT id
FROM articulos
WHERE estado = :estado
  AND categoria = :categoria
ORDER BY
    CASE estado
        WHEN 'BORRADOR' THEN 1
        WHEN 'PUBLICADO' THEN 2
        ELSE 3
    END ASC,
    created_at DESC,
    id ASC;
El resultado conceptual sería:
[uuid_1, uuid_2, uuid_3, ..., uuid_N]
No estamos almacenando los artículos completos. Estamos almacenando el mapa que permite saber qué identificadores corresponden a cada posición.
Ese resultado puede guardarse en una caché utilizando como clave una representación de los filtros y del criterio de orden.
Por ejemplo:
hash(filtros + orden) → [id_1, id_2, id_3, ...]
Si la misma combinación se solicita nuevamente mientras el índice sigue siendo válido, puede reutilizarse.
Si el usuario cambia el filtro o el orden, cambia la clave y se genera otro índice.
A partir de ese mapa, solicitar la página 53 significa seleccionar las posiciones correspondientes.
Con un tamaño de página de 20:
página 53 → posiciones 1040 a 1059
Después, el sistema puede recuperar directamente los registros identificados:
SELECT *
FROM articulos
WHERE id = ANY(:ids_pagina);
Finalmente, debe reconstruir el mismo orden utilizado por el índice.
Una consecuencia importante: la consulta representa una fotografía
Esta estrategia introduce una propiedad que conviene hacer explícita.
El índice representa el conjunto de resultados en el momento en que fue construido.
Si se inserta un nuevo registro después de crear el índice, ese registro no tiene por qué aparecer en la navegación actual.
Si se elimina uno de los registros, el índice puede seguir haciendo referencia a un elemento que ya no existe y será necesario decidir cómo gestionar ese caso.
La ventaja es que el comportamiento deja de depender de desplazamientos implícitos entre solicitudes y pasa a formar parte explícita del diseño.
En otras palabras, el sistema está diciendo:
"Esta navegación corresponde a esta fotografía del conjunto de resultados."
Dependiendo del caso de uso, eso puede ser precisamente lo que se necesita.
El papel de los filtros
Aquí las características de los filtros que definimos antes adquieren importancia.
Si existen filtros discretos y relativamente acotados, es posible que diferentes usuarios soliciten repetidamente las mismas combinaciones.
Por ejemplo:
estado=PUBLICADO
categoria=TECNOLOGIA
orden=created_at
Ese tipo de consulta tiene más posibilidades de reutilizar un índice existente.
En cambio, si cada usuario puede especificar una fecha inicial, una fecha final, un precio mínimo, un precio máximo y otros parámetros arbitrarios, el número de combinaciones crece rápidamente.
En ese escenario, la caché puede tener menos oportunidades de reutilización y la generación del índice inicial puede convertirse en un costo importante.
Cuándo encaja
Este enfoque resulta especialmente interesante cuando:
- La navegación aleatoria es necesaria.
- El volumen de datos es elevado.
- Los filtros son relativamente discretos y repetibles.
- El orden de negocio es complejo.
- La misma combinación de filtros se consulta con frecuencia.
- Se dispone de infraestructura de caché.
Qué no resuelve
La generación inicial del índice sigue teniendo un costo proporcional al conjunto de resultados que debe procesar.
Además, mantener la caché introduce complejidad operacional: expiración, invalidación, memoria utilizada y comportamiento ante cambios en los datos.
Cuando los filtros dejan de ser discretos y pasan a incluir texto libre o rangos arbitrarios, puede ser necesario cambiar nuevamente de enfoque.
Cuando el problema ya es de búsqueda
Llegados a este punto, aparece un escenario diferente.
El problema ya no consiste únicamente en decidir cómo recorrer una lista grande.
Supongamos que el endpoint necesita combinar:
- Texto libre.
- Rangos arbitrarios.
- Múltiples dimensiones de filtrado.
- Orden dinámico.
- Millones de registros.
- Consultas frecuentes y concurrentes.
- Navegación sobre grandes conjuntos de resultados.
Aquí puede tener sentido utilizar un motor de búsqueda especializado.
Herramientas como Elasticsearch u OpenSearch utilizan estructuras de indexación diseñadas específicamente para búsquedas y filtrados complejos.
En lugar de depender exclusivamente del modelo de consulta de una tabla relacional, mantienen estructuras especializadas que permiten localizar documentos a partir de los términos y valores buscados.
También ofrecen mecanismos orientados a recorrer grandes conjuntos de resultados, como search_after, que permite continuar una búsqueda a partir de una posición determinada.
Esto cambia la naturaleza del problema.
Ya no estamos intentando hacer que una tabla relacional resuelva eficientemente cualquier combinación imaginable de búsqueda, filtro y orden.
Estamos utilizando una infraestructura especializada para ese patrón de acceso.
Pero esa decisión introduce un costo nuevo: ahora existe una infraestructura adicional que debe mantenerse sincronizada con la base de datos principal.
El flujo puede verse, conceptualmente, así:
Base de datos principal
        ↓
Proceso de sincronización
        ↓
Índice de búsqueda
Esto obliga a resolver preguntas que no existían con una única base de datos:
- ¿Cuándo se actualiza el índice?
- ¿Qué ocurre si la sincronización falla?
- ¿Cuánto retraso puede existir entre ambos sistemas?
- ¿Cuál es la fuente de verdad?
- ¿Cómo se reconstruye el índice?
- ¿Cómo se monitoriza?
Por eso, un motor de búsqueda no debería incorporarse simplemente porque OFFSET sea lento.
Tiene sentido cuando las necesidades de búsqueda y filtrado justifican la infraestructura adicional.
Cuándo encaja
Puede resultar adecuado cuando:
- El texto libre es una parte central del caso de uso.
- Existen rangos y filtros complejos.
- Se combinan múltiples dimensiones de búsqueda.
- El volumen de datos es elevado.
- Las consultas son frecuentes y concurrentes.
- La base de datos principal ya no ofrece una solución eficiente para el patrón de búsqueda requerido.
Qué no resuelve
No elimina la complejidad: la desplaza hacia la arquitectura.
Aparecen nuevos componentes, sincronización, monitorización, gestión de índices y una nueva forma de consultar los datos.
Si una solución más sencilla satisface los requisitos, incorporar otro sistema puede ser innecesario.
El árbol de decisión
A estas alturas, las cuatro estrategias ya no aparecen como alternativas aisladas. Cada una responde a las condiciones que acabamos de analizar.
El recorrido puede resumirse así:
flowchart TD
A([Necesito paginar una tabla])
--> B{¿Volumen moderado<br/>y páginas superficiales?}
B -->|Sí| S1[OFFSET con índices<br/>bien diseñados]
B -->|No| C{¿El usuario necesita<br/>saltar a páginas arbitrarias?}
C -->|No — navegación secuencial| D{¿El orden puede ser<br/>determinista?}
D -->|Sí| S2[Cursor-based pagination<br/>CursorRequest + CursorPage<T>]
D -->|No| D2[Añadir una columna<br/>de desempate única al orden]
D2 --> D
C -->|Sí — acceso aleatorio| E{¿Los filtros son<br/>discretos y acotados?}
E -->|Sí| S3[Índice de navegación con caché<br/>Hash del filtro → IDs en Redis]
E -->|No| F{¿La búsqueda y el volumen<br/>justifican infraestructura adicional?}
F -->|Sí| S4[Motor de búsqueda dedicado<br/>Elasticsearch / OpenSearch]
F -->|No| S1b[OFFSET con límite<br/>de profundidad]
El árbol no debe interpretarse como una fórmula rígida.
Por ejemplo, el número de registros por sí solo no determina qué estrategia utilizar. Lo que importa es cómo se combina ese volumen con la profundidad de navegación, el patrón de consulta, los filtros, el orden y la frecuencia de acceso.
El objetivo del árbol es obligarnos a formular las preguntas correctas antes de introducir complejidad.
Lo que cada solución no resuelve
Después de recorrer las alternativas, aparece una conclusión importante: ninguna estrategia elimina el costo de la paginación; cada una lo desplaza hacia un lugar diferente.
OFFSET mantiene un contrato sencillo y permite navegar directamente a páginas arbitrarias. Su costo aparece principalmente cuando la profundidad aumenta y los datos son numerosos.
Los cursores reducen el trabajo asociado con posiciones profundas y funcionan especialmente bien para navegación secuencial. A cambio, el cliente deja de trabajar con páginas numéricas y debe conservar un punto de referencia.
El índice de navegación con caché permite recuperar páginas arbitrarias a partir de un mapa previamente construido. A cambio, introduce un costo inicial y una infraestructura adicional para almacenar y gestionar ese mapa.
El motor de búsqueda permite resolver escenarios donde el problema ya no es solamente paginar, sino buscar y filtrar grandes volúmenes de información. A cambio, introduce otra pieza de infraestructura y la necesidad de mantenerla coordinada con la fuente de datos principal.
Por eso, la decisión no consiste en encontrar una solución que no tenga costos.
Consiste en decidir qué costo es aceptable para el contexto concreto del sistema.
Volver al endpoint que "simplemente funcionaba"
Cuando aquel endpoint que inicialmente "simplemente funcionaba" empieza a mostrar tiempos de respuesta cada vez mayores, es tentador concluir que OFFSET fue una mala decisión desde el principio.
Pero esa conclusión sería demasiado simple.
OFFSET puede ser una solución perfectamente válida para determinados escenarios.
El problema aparece cuando cambian las condiciones para las que fue elegido y nadie revisa la decisión.
Una tabla que comenzó con 20.000 registros puede terminar teniendo varios millones.
Una interfaz que inicialmente mostraba cinco páginas puede terminar necesitando búsqueda avanzada.
Un listado que solo se consultaba ocasionalmente puede convertirse en una de las rutas más utilizadas de la aplicación.
Y un criterio de orden sencillo puede terminar acompañado de múltiples filtros y reglas de negocio.
Por eso, la pregunta importante no es si OFFSET es bueno o malo.
La pregunta es si sigue siendo adecuado para las condiciones actuales del endpoint.
Ese cambio de perspectiva también modifica la forma de diseñar la solución desde el principio.
Antes de implementar la paginación, conviene conocer:
- cómo navegará el usuario;
- si necesita saltos arbitrarios;
- qué filtros tendrá disponibles;
- si esos filtros son discretos o abiertos;
- cómo se ordenarán los resultados;
- si ese orden es determinista;
- cuánto volumen existe actualmente;
- cuánto se espera que crezca;
- y cuánto pueden cambiar los datos mientras el usuario navega.
Con esa información, OFFSET, cursores, un índice de navegación o un motor de búsqueda dejan de ser decisiones basadas en preferencias técnicas.
Se convierten en respuestas a requisitos concretos.
Y esa es probablemente la idea más importante de todo el problema: la paginación no debería elegirse por costumbre ni por la tecnología que tenemos disponible, sino por la forma en que el endpoint realmente necesita ser utilizado.
La tarea puede seguir siendo "agregar paginación al listado de artículos".
Lo que cambia es la pregunta que hacemos antes de tocar el código.
No:
"¿Cuál es la mejor técnica de paginación?"
Sino:
"¿Qué tipo de navegación, filtrado, orden y volumen necesita realmente este endpoint?"
A partir de ahí, la implementación deja de ser una decisión aislada y pasa a formar parte del diseño técnico del sistema.
Y cuando el volumen, los filtros o la forma de navegación cambien, la estrategia puede revisarse de nuevo.
Ese punto de revisión es tan importante como la decisión inicial.
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
- Mauricio ECR
- Arquitectura
- 12 Sep, 2026
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload Seguro que alguna vez empezaste con un endpoint de listado que parecía no necesitar demasiado. Un par de fil
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
- Mauricio ECR
- Arquitectura
- 12 Sep, 2026
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
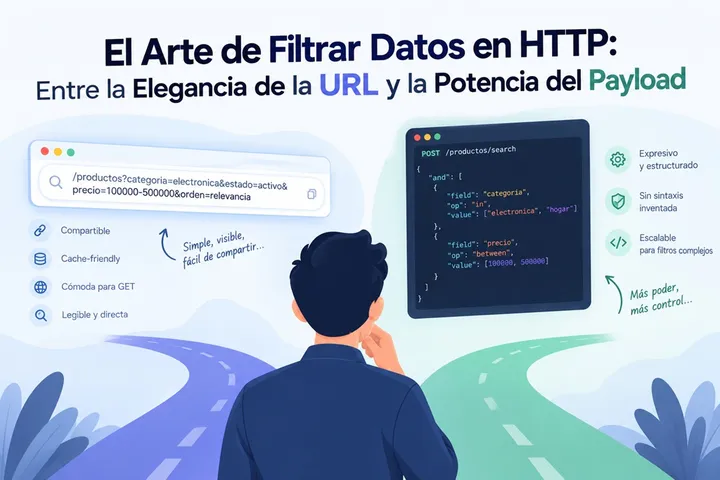
Seguro que alguna vez empezaste con un endpoint de listado que parecía no necesitar demasiado. Un par de filtros simples: nombre, categoría, quizá un estado. Todo cabía cómodamente en una URL como ?categoria=electronica&estado=activo, era fácil de leer y nadie tenía demasiadas razones para cuestionar la decisión.
El problema aparece cuando esa pantalla deja de ser simple.
Alguien de producto pide filtrar por varias categorías al mismo tiempo, añadir un rango de precios, restringir por fecha de publicación y, además, ordenar por relevancia. Nada especialmente extraño: es el tipo de evolución que termina teniendo cualquier sistema de búsqueda que crece un poco. Lo que cambia no es la necesidad funcional, sino la dificultad de representar esa necesidad dentro de HTTP.
Y es ahí donde una decisión que parecía puramente sintáctica empieza a afectar cosas bastante más importantes: la legibilidad de las URLs, su capacidad para compartirse, el caché, la infraestructura que las procesa y, finalmente, la forma en que el propio código del backend tiene que recibirlas.
Cuando los filtros dejan de caber cómodamente en una URL
La primera reacción suele ser intentar mantener el modelo que ya funciona y llevarlo un poco más lejos. Si un parámetro alcanza para un filtro, quizá varios parámetros puedan representar varios filtros.
Pronto aparece algo parecido a esto:
filter[0][field]=categoria&filter[0][op]=in&filter[0][value][]=electronica&filter[0][value][]=hogar&filter[1][field]=precio&filter[1][op]=between&filter[1][value][]=100000&filter[1][value][]=500000
El problema no es que esta representación sea imposible. El problema es que, a medida que aumenta la complejidad, empieza a depender de una sintaxis que la propia API tiene que inventar y documentar. No existe una convención universal que garantice que otro equipo, otro framework o incluso otro endpoint vaya a interpretar exactamente esa estructura de la misma manera.
Con dos condiciones todavía se puede tolerar. Con tres o cuatro, la URL deja de comunicar lo que está ocurriendo y pasa a convertirse en una estructura que hay que descifrar.
La siguiente idea parece más atractiva precisamente porque elimina esa sintaxis inventada: si el filtro es estructurado, ¿por qué no representarlo directamente como JSON?
Por ejemplo:
{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    }
  ]
}
Conceptualmente es mucho mejor. La estructura expresa exactamente lo que se quiere consultar y no hace falta inventar una notación propia para representar operadores, campos y valores.
El problema llega cuando ese JSON tiene que viajar dentro de una URL.
Después de aplicar URL encoding, una estructura que originalmente era legible termina convertida en una secuencia como esta:
%7B%22and%22%3A%5B%7B%22field%22%3A%22categoria%22%2C%22op%22%3A%22in%22%2C%22value%22%3A%5B%22electronica%22%2C%22hogar%22%5D%7D%5D%7D
La información sigue estando ahí. El problema es que dejó de ser visible.
Esto parece una molestia estética hasta que aparece un caso real de diagnóstico. Una URL así puede terminar en un mensaje de chat del equipo, en Postman, en un log de producción o en un ticket donde alguien intenta explicar por qué una búsqueda devolvió resultados inesperados. En ninguno de esos escenarios resulta evidente qué filtro representa la cadena.
Hay que decodificarla antes de poder entenderla.
Y entonces aparece una tercera posibilidad, casi inevitable: abandonar la URL y enviar el JSON en el body de un POST.
La solución fácil también cambia el contrato
La propuesta de utilizar POST tiene una ventaja evidente: el filtro vuelve a verse exactamente como lo que es.
POST /productos/search
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Desde el punto de vista de representación, es probablemente la solución más cómoda. Pero resuelve el problema de legibilidad introduciendo otro: la búsqueda ya no está contenida en una URL que pueda copiarse, pegarse y compartir como un recurso de lectura.
Además, aunque el caché de respuestas POST es posible con configuraciones específicas, no tiene la misma interoperabilidad ni la misma naturalidad que el caché de un GET. Una petición GET encaja directamente con las expectativas de navegadores, proxies, CDN y clientes HTTP para operaciones de lectura.
Esto no significa que POST sea incorrecto. Significa que, al elegirlo, se está renunciando deliberadamente a ciertas propiedades.
Y esa distinción es importante porque permite formular mejor el problema. No se trata de encontrar una opción universalmente correcta entre query params, JSON en la URL y POST. Se trata de decidir qué propiedad del contrato HTTP se necesita conservar.
Si la búsqueda debe poder compartirse como enlace y además interesa mantenerla como GET, todavía quedan alternativas que merece la pena explorar — y antes de comprometerse con una, conviene entender de qué depende cada una.
Dos caminos para conservar el GET, con distinta dependencia
Cuando la meta es mantener la búsqueda como GET compartible sin caer en URLs ilegibles, hay dos familias de solución, y no son intercambiables porque no piden lo mismo al resto del sistema.
Una es codificar el filtro tal cual el frontend lo pensó (un objeto JSON con la forma que el dominio necesite) y transportarlo como un blob opaco en un único parámetro. Esta idea no le exige nada a la capa de persistencia: el servidor recibe una cadena, la decodifica, obtiene un JSON y lo interpreta como quiera. Es agnóstica al motor de datos por completo.
La otra es expresar el filtro directamente como una gramática de texto pensada para mapear campo-operador-valor, apoyándose en que exista una capa de acceso a datos capaz de traducir esa gramática a una consulta ejecutable. Esta idea sí depende de algo externo a la propia idea: solo funciona si hay un traductor gramática→query, típicamente provisto por un ORM con soporte de construcción dinámica de condiciones (Criteria API en el mundo Java, query builders equivalentes en otros stacks).
Esa diferencia — necesitar o no una capa de traducción externa — es la que determina cuál conviene en cada caso, y conviene resolverla antes de escribir una sola línea de código.
El camino agnóstico: JSON opaco vía Base64URL
Cuando el filtro es estructurado pero sigue siendo razonablemente pequeño, una posibilidad es serializarlo como JSON y después codificar ese JSON utilizando Base64URL.
El flujo conceptual es sencillo:
- Se construye el filtro como un objeto.
- Se serializa a JSON.
- Ese JSON se codifica mediante Base64URL.
- El resultado se envía como un único parámetro de query.
- El servidor lo decodifica y recupera nuevamente el JSON.
La diferencia importante es que no se intenta hacer legible el contenido del filtro dentro de la URL. Se acepta que sea opaco, pero se consigue que la representación sea mucho más adecuada para convivir con la sintaxis de una URL.
También conviene precisar el nombre. No se trata simplemente de Base64 tradicional.
Base64 utiliza caracteres como +, / y =, que pueden requerir tratamiento adicional cuando aparecen dentro de una URL. Base64URL, definido en la sección 5 del RFC 4648, utiliza - y _ en lugar de esos caracteres y permite omitir el padding cuando el protocolo que lo utiliza lo contempla.
Tomemos el filtro completo:
{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Después de codificarlo, la petición puede quedar así:
GET /productos?filter=eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhIiwib3AiOiJpbiIsInZhbHVlIjpbImVsZWN0cm9uaWNhIiwiaG9nYXIiXX0seyJmaWVsZCI6InByZWNpbyIsIm9wIjoiYmV0d2VlbiIsInZhbHVlIjpbMTAwMDAwLDUwMDAwMF19XX0
La cadena sigue siendo opaca. No pretende ser legible para una persona. Pero ya no está dominada por secuencias %XX, y lo más importante es que la operación continúa siendo un GET.
Eso permite conservar varias propiedades útiles: la búsqueda puede copiarse, guardarse y compartirse como enlace y, cuando la infraestructura está configurada para ello, la respuesta puede aprovechar el caché asociado a una petición GET.
Hay, eso sí, una condición que no conviene esconder: el filtro debe seguir teniendo un tamaño razonable. Si la consulta contiene decenas de condiciones, listas enormes o estructuras profundamente anidadas, el problema deja de ser cómo codificarla y empieza a ser cuánto sentido tiene seguir transportándola dentro de una URL.
Pero para una búsqueda con un conjunto moderado de filtros, Base64URL puede ser un punto intermedio razonable.
Lo que queda pendiente es hacer que el backend pueda consumir esa representación sin convertir cada controlador en responsable de la decodificación.
El camino dependiente de la persistencia: RSQL
Existe otra manera de mantener el GET sin sacrificar legibilidad, pero que parte de una premisa distinta: en lugar de esconder el filtro dentro de un blob opaco, expresarlo directamente como texto legible dentro del propio query param.
RSQL es una extensión de FIQL (Feed Item Query Language) que permite escribir eso: una gramática de comparaciones encadenadas con AND/OR, pensada para mapear uno a uno contra atributos de una entidad. La URL sigue siendo un GET, sigue siendo compartible, y además no pierde legibilidad:
GET /productos?filter=categoria=in=(electronica,hogar);precio=ge=100000;precio=le=500000
El punto y coma es AND, la coma es OR, los paréntesis agrupan. Los paths de relaciones se escriben con notación de punto:
GET /productos?filter=marca.pais==Argentina;estado!=suspendido
Comparado con Base64URL, la ganancia es evidente: no hace falta decodificar nada para entender qué se está pidiendo. La cadena es el filtro.
Pero esa legibilidad no es gratis, y ahí está el punto que conviene no pasar por alto: RSQL no resuelve nada por sí mismo. Es una gramática de texto; alguien tiene que parsearla y, sobre todo, alguien tiene que traducirla a una consulta ejecutable contra el almacenamiento real. A diferencia de Base64URL — donde el servidor simplemente decodifica y deserializa un JSON con sus propias reglas —, RSQL necesita que exista, entre el parser y la base de datos, una capa capaz de convertir cada nodo de comparación en una condición de persistencia. Sin esa capa, RSQL es solo una cadena de texto sin ningún lugar donde ejecutarse.
En el ecosistema Java, esa capa la provee típicamente la Criteria API de JPA a través de una Specification, y existen librerías (no oficiales de Spring, sino de terceros) que hacen ese puente automáticamente. En otros stacks el concepto se mantiene — una gramática campo-operador-valor traducida a un query builder dinámico —, pero el mecanismo concreto cambia según el ORM disponible. Quien quiera ver cómo se ve esa integración en un proyecto Spring Boot real puede saltar directamente al anexo al final del artículo.
Esa dependencia tiene además una consecuencia de seguridad que conviene resolver antes de decidirse por este camino, no después.
El vector de seguridad que ninguna gramática resuelve por defecto
Cualquier mecanismo que traduzca texto libre a una condición de persistencia enfrenta el mismo riesgo, independientemente del lenguaje o el framework: el parser no sabe, por sí solo, qué campos del modelo deberían ser alcanzables desde afuera.
Si una entidad tiene una relación hacia otra entidad con datos sensibles, nada en la gramática impide que un consumidor intente comparar directamente contra esos campos:
GET /productos?filter=usuario.password==algo
GET /productos?filter=usuario.resetToken==abc123
El sistema no devolvería esos valores en el body, pero sí variaría el número de resultados según si la condición se cumple o no. Es suficiente para montar un ataque de oráculo e inferir, comparación a comparación, valores que nunca deberían ser accesibles desde un filtro de listado.
La mitigación es siempre la misma en cualquier stack: recorrer la estructura del filtro ya parseado (su AST) antes de ejecutar la consulta y rechazar cualquier campo que no esté en una allowlist explícita, y componer esa consulta junto con las condiciones base que el usuario nunca debería poder eludir (soft-delete, tenant, permisos).
Esto es exactamente lo que distingue este camino del de Base64URL con un DTO tipado: ahí, los campos filtrables son exactamente los que el desarrollador declaró en la clase. No hay forma de filtrar por usuario.resetToken si ese campo no existe en el tipo — la allowlist es estructural, la garantiza el propio DTO. En el camino de la gramática de texto, en cambio, la allowlist es una responsabilidad operacional: hay que construirla y mantenerla activamente, y es un paso que se puede omitir bajo presión sin que nada lo impida a nivel de compilación.
Cuándo conviene cada camino
La pregunta que separa un camino del otro no es cuál es "mejor", sino qué tan bien el filtro se mapea contra atributos simples de una entidad persistida:
- Si los filtros son AND/OR sobre atributos que existen tal cual en el modelo de datos, y se cuenta con una capa de persistencia capaz de traducir esa gramática (Specification, Criteria API o equivalente), una gramática de texto como RSQL resuelve el problema con muy poco código y conserva la legibilidad de la URL — a cambio de mantener activamente una allowlist.
- Si el contrato del filtro es propio del dominio, con operadores específicos, estructuras anidadas particulares o simplemente no hay (o no se quiere depender de) una capa de traducción gramática→persistencia, Base64URL con un DTO tipado ofrece un contrato explícito, no le pide nada al motor de datos, y su allowlist es estructural en lugar de operacional.
Esta bifurcación es la que después vuelve a aparecer, ya formalizada, en el árbol de decisión al final del artículo.
Llevar la idea de Base64URL a un endpoint real con Spring Boot
En cualquier framework aparece la misma pregunta: alguien tiene que recibir el parámetro, decodificarlo, convertir el JSON en el DTO correspondiente y manejar los errores que puedan producirse durante el proceso.
En Spring Boot, la solución más directa consiste en hacerlo dentro del controlador:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @RequestParam("filter") String filterBase64,
        ObjectMapper objectMapper) throws IOException {

    byte[] jsonBytes = Base64.getUrlDecoder().decode(filterBase64);

    FiltroProductosDto filtro =
            objectMapper.readValue(jsonBytes, FiltroProductosDto.class);

    return ResponseEntity.ok(productoService.buscar(filtro));
}
Para un solo endpoint, no hay nada especialmente problemático en este enfoque. El inconveniente aparece cuando el sistema crece.
Si existen diez endpoints de búsqueda, probablemente aparezcan diez implementaciones prácticamente iguales. Y entonces la cuestión deja de ser si podemos decodificar Base64URL y pasa a ser si queremos mantener esa lógica repartida por todos los controladores.
En ese punto aparecen problemas de consistencia bastante concretos.
¿Todos los endpoints manejan el padding de la misma forma? ¿Todos distinguen entre un Base64URL inválido y un JSON inválido? ¿Todos responden de la misma manera cuando falta el parámetro? ¿Todos deserializan el contenido con las mismas reglas? ¿Todos aplican las mismas validaciones?
La duplicación empieza a convertir una decisión de transporte en una responsabilidad del código de negocio.
Una solución más limpia consiste en hacer que el controlador reciba directamente el DTO que necesita:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(productoService.buscar(filtro));
}
El controlador ya no necesita saber que el filtro llegó codificado. Esa información pertenece a la capa que transforma la petición HTTP en los argumentos del método.
Spring MVC proporciona precisamente un mecanismo para realizar esa transformación: HandlerMethodArgumentResolver.
Sacar la infraestructura del controlador
El primer paso es definir una anotación que identifique los parámetros que deben resolverse mediante este mecanismo:
import java.lang.annotation.*;

@Target(ElementType.PARAMETER)
@Retention(RetentionPolicy.RUNTIME)
public @interface Base64Filter {

    String value() default "filter";
}
El valor permite mantener filter como nombre por defecto, pero también utilizar otro parámetro cuando el endpoint lo necesite:
@Base64Filter("criteria")
FiltroProductosDto filtro
La anotación por sí sola no hace la transformación. El trabajo lo realiza el resolver.
Aquí aparece además una cuestión importante que puede pasar desapercibida: cuando Spring construye automáticamente un objeto mediante mecanismos como @RequestBody, el ciclo de validación habitual puede ejecutarse de forma transparente. Cuando el objeto lo construimos manualmente dentro de un HandlerMethodArgumentResolver, esa validación no aparece automáticamente solo porque hayamos escrito @Valid.
Por eso el resolver tiene que encargarse también de esa parte.
Una implementación posible es:
@Component
public class Base64FilterArgumentResolver implements HandlerMethodArgumentResolver {

    private final ObjectMapper objectMapper;
    private final Validator validator;

    public Base64FilterArgumentResolver(ObjectMapper objectMapper, Validator validator) {
        this.objectMapper = objectMapper;
        this.validator = validator;
    }

    @Override
    public boolean supportsParameter(MethodParameter parameter) {
        return parameter.hasParameterAnnotation(Base64Filter.class);
    }

    @Override
    public Object resolveArgument(
            MethodParameter parameter,
            ModelAndViewContainer mavContainer,
            NativeWebRequest webRequest,
            WebDataBinderFactory binderFactory) throws Exception {

        Base64Filter annotation = parameter.getParameterAnnotation(Base64Filter.class);
        String paramName = annotation.value();
        String rawValue = webRequest.getParameter(paramName);
        Class<?> targetType = parameter.getParameterType();

        Object filtro;

        if (rawValue == null || rawValue.isBlank()) {
            filtro = targetType.getDeclaredConstructor().newInstance();
        } else {
            try {
                byte[] jsonBytes = Base64.getUrlDecoder().decode(rawValue);
                filtro = objectMapper.readValue(jsonBytes, targetType);
            } catch (IllegalArgumentException e) {
                throw new FiltroInvalidoException(
                        "El parámetro '" + paramName + "' no es Base64URL válido");
            } catch (JacksonException e) {
                throw new FiltroInvalidoException(
                        "El parámetro '" + paramName + "' no contiene un JSON de filtro válido");
            }
        }

        if (parameter.hasParameterAnnotation(Valid.class)) {
            Set<ConstraintViolation<Object>> violations = validator.validate(filtro);
            if (!violations.isEmpty()) {
                throw new FiltroInvalidoException(
                        "El filtro no cumple las validaciones: " + violations);
            }
        }

        return filtro;
    }
}
Hay varias decisiones dentro de este código que conviene entender porque son parte del contrato y no simples detalles de implementación.
El método supportsParameter hace que el resolver intervenga únicamente cuando el parámetro tiene la anotación @Base64Filter. Esto mantiene el comportamiento localizado y evita que todos los parámetros de la aplicación intenten pasar por la misma lógica.
Después se obtiene el nombre del parámetro desde la anotación y se recupera su valor desde la petición. Si no existe o está vacío, el ejemplo construye una instancia vacía del DTO. Esa decisión puede ser apropiada cuando la ausencia del filtro significa "sin restricciones", pero no debería convertirse en una regla universal. Si en el dominio la ausencia del parámetro tiene otro significado, ese comportamiento debe reflejarlo.
Cuando sí existe un valor, primero se decodifica Base64URL y después se deserializa el JSON utilizando ObjectMapper.
Las dos operaciones pueden fallar por motivos diferentes, y distinguirlas permite devolver mensajes de error más útiles. Un contenido que no es Base64URL válido no representa el mismo problema que una cadena correctamente codificada que contiene un JSON malformado.
Una vez construido el objeto, el resolver comprueba si el parámetro utiliza @Valid. Solo en ese caso ejecuta explícitamente Bean Validation.
Eso permite mantener en el DTO las reglas habituales:
public class FiltroProductosDto {

    @Size(
        max = 10,
        message = "No se permiten más de 10 categorías"
    )
    private List<String> categorias;

    @Min(0)
    private Long precioMinimo;

    @Min(0)
    private Long precioMaximo;

    // getters y setters
}
De esta manera, colocar @Valid junto con @Base64Filter activa las validaciones sintácticas habituales sin introducir lógica adicional en el controlador.
Es importante, sin embargo, no confundir validación sintáctica con validación de negocio.
Una regla como "no se permiten más de diez categorías" o "el precio mínimo no puede ser negativo" pertenece naturalmente a esta capa. En cambio, comprobar que precioMinimo sea menor que precioMaximo, que una categoría exista realmente o que determinado filtro esté permitido para un usuario concreto puede requerir información que el resolver no debería conocer.
Esas decisiones pertenecen a una capa posterior, normalmente al servicio o a la lógica de dominio.
Registrar el resolver y completar la separación
Una vez creado el resolver, hay que registrarlo en Spring MVC:
@Configuration
public class WebConfig implements WebMvcConfigurer {

    private final Base64FilterArgumentResolver resolver;

    public WebConfig(Base64FilterArgumentResolver resolver) {
        this.resolver = resolver;
    }

    @Override
    public void addArgumentResolvers(List<HandlerMethodArgumentResolver> resolvers) {
        resolvers.add(resolver);
    }
}
A partir de ahí, el controlador puede mantenerse completamente centrado en su responsabilidad:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(
            productoService.buscar(filtro)
    );
}
El beneficio real de esta arquitectura no es que Spring haya aprendido a decodificar Base64URL. El beneficio es haber separado dos decisiones que no deberían estar mezcladas.
Una decisión responde a cómo viaja el filtro por HTTP.
La otra responde a qué filtro necesita el caso de uso.
El controlador solo debería preocuparse por la segunda.
Cuando llegue el endpoint de búsqueda número once, no será necesario copiar la misma secuencia de decodificación, deserialización y validación. El mecanismo de transporte queda encapsulado en una pieza transversal y los endpoints pueden expresar únicamente el contrato que necesitan.
Pero conseguir que el código quede limpio no significa que el diseño esté terminado. Hay varias cuestiones que el resolver no puede solucionar por sí solo.
Codificar no significa proteger
La primera es seguridad.
Base64URL no cifra el contenido. Tampoco lo convierte en secreto. Cualquier persona que tenga acceso a la cadena puede decodificarla y recuperar el JSON original.
Por eso nunca debe interpretarse la codificación como una medida de protección.
Después de deserializar el filtro siguen siendo necesarias las comprobaciones correspondientes: campos permitidos, operadores válidos, tipos esperados, tamaños máximos y, cuando la estructura lo permita, profundidad máxima de anidamiento.
Esto es especialmente relevante cuando el filtro admite estructuras complejas. Una petición puede ser perfectamente válida desde el punto de vista sintáctico y, aun así, provocar un consumo excesivo de CPU o memoria si el servidor acepta estructuras arbitrariamente grandes o profundas.
La validación, por tanto, no es un accesorio que se añade después de implementar Base64URL. Forma parte del contrato de entrada.
Los errores también forman parte del diseño
El segundo punto es el manejo de errores.
El resolver puede lanzar FiltroInvalidoException, pero eso no significa que cada controlador deba capturarla individualmente. La aplicación puede centralizar la conversión de esa excepción en una respuesta HTTP uniforme:
@RestControllerAdvice
public class FiltroExceptionHandler {

    @ExceptionHandler(FiltroInvalidoException.class)
    public ResponseEntity<ErrorResponse> handleFiltroInvalido(FiltroInvalidoException ex) {
        return ResponseEntity.badRequest().body(new ErrorResponse(ex.getMessage()));
    }
}
Esto elimina otro nivel de duplicación, pero todavía conviene conservar internamente las distintas categorías de fallo.
No es lo mismo recibir un Base64URL inválido que recibir un JSON malformado. Tampoco es lo mismo un JSON válido que no puede convertirse al DTO esperado, un DTO que incumple las validaciones, o un filtro completamente válido que no está permitido para determinado usuario.
No siempre es necesario exponer todas esas diferencias al consumidor. De hecho, en algunos casos sería contraproducente. Pero mantenerlas diferenciadas internamente puede resultar decisivo cuando haya que investigar un comportamiento extraño en producción.
La uniformidad hacia fuera no debería implicar perder información hacia dentro.
Si el consumidor no sabe qué codificar, el contrato está incompleto
Hay todavía otra pieza que suele olvidarse porque no afecta directamente al funcionamiento del endpoint: la documentación.
Una anotación personalizada como @Base64Filter no necesariamente será interpretada automáticamente por herramientas como springdoc-openapi como un parámetro de query convencional. Si el consumidor no recibe una explicación explícita, terminará teniendo que averiguar por su cuenta cómo construir la cadena.
Por ejemplo:
@Operation(
    summary = "Búsqueda de productos con filtro estructurado"
)
@Parameter(
    name = "filter",
    description =
        "Filtro JSON codificado en Base64URL según RFC 4648 §5",
    example =
        "eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhIn1dfQ",
    schema = @Schema(type = "string")
)
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(
            productoService.buscar(filtro)
    );
}
Una buena documentación debería mostrar las dos representaciones.
Por un lado, el JSON conceptual que el consumidor realmente quiere expresar. Por otro, la cadena Base64URL que debe enviar.
La transformación puede ser transparente para el servidor, pero no debe ser un misterio para quien consume la API.
El coste que aparece después: una URL que ya no se puede leer
Hasta este punto, Base64URL parece haber conseguido un equilibrio bastante atractivo: mantiene GET, conserva una URL autocontenida y evita llenar el query string de secuencias de escape.
Pero ese equilibrio tiene un precio evidente.
La URL deja de ser legible.
Un log como este:
GET /productos?filter=eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhI...
no permite saber inmediatamente qué filtros se utilizaron.
Y eso importa especialmente porque las URLs aparecen en muchos lugares que no están bajo el control directo del desarrollador que diseñó el endpoint: logs de servidores, herramientas de monitoreo, historial del navegador, sistemas de analítica y mecanismos de diagnóstico.
Es exactamente el costo que, como vimos antes, RSQL evita — a cambio de pedir una capa de traducción a persistencia y una allowlist mantenida activamente. Ninguna de las dos alternativas gana en todo; cada una conserva una propiedad distinta.
Cuándo RSQL se queda corto
Incluso en el escenario donde sí conviene la gramática de texto — filtros que mapean bien a atributos y operadores relacionales estándar —, hay límites concretos donde deja de alcanzar.
El primero es semántica propia. Un operador =between= con dos valores puede registrarse como extensión del parser, pero si el dominio necesita expresar algo como un rango con extremos configurables o un operador geoespacial con parámetros propios, la gramática obliga a inventar una notación que ya no es estándar. El DTO tipado puede incluir esos campos con semántica explícita.
El segundo es correlación en colecciones. Si Producto tiene una lista de Variante y la consulta necesita encontrar productos que tengan una variante que sea simultáneamente roja y con stock mayor a cero, una traducción directa campo-operador-valor genera un JOIN que evalúa las condiciones por separado. Puede devolver un producto con una variante roja sin stock y otra variante con stock pero de distinto color. Para expresar esa correlación hace falta un subquery o un EXISTS, que la gramática no modela.
El tercero es contexto de runtime. Un score de relevancia calculado en el momento de la petición, una distancia geoespacial o un ranking de machine learning no tienen representación natural como par campo-operador-valor.
Cuando el filtro cruza alguno de esos límites, Base64URL con DTO tipado vuelve a ser la opción más honesta: el contrato es explícito, los campos posibles están acotados por el tipo y la estructura puede ser tan específica como lo exija el dominio.
Cuando el filtro crece, el problema deja de ser de codificación
Hasta aquí estamos hablando de un escenario bastante concreto: filtros estructurados pero todavía razonablemente pequeños.
La situación cambia cuando la consulta empieza a crecer.
Decenas de condiciones. Listas extensas de identificadores. Estructuras anidadas varios niveles hacia abajo. Combinaciones complejas de operadores.
En ese momento, insistir en mantener todo dentro de una URL deja de ser una cuestión de encontrar una codificación más conveniente.
Se convierte en una decisión de diseño de interfaz.
Y es precisamente ahí donde POST vuelve a tener sentido, pero esta vez por una razón diferente a la del comienzo.
No se utiliza porque no hayamos encontrado una manera suficientemente ingeniosa de meter el filtro en un GET. Se utiliza porque el contrato ha cambiado y ahora el body es un lugar más apropiado para transportar una estructura grande.
POST /productos/search
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Se gana una representación natural del filtro y se evita someterlo a las limitaciones prácticas de una URL.
A cambio, la búsqueda deja de ser un recurso autocontenido en forma de enlace y pierde la misma naturalidad para el caché que tendría un GET.
Pero si el filtro ya ha alcanzado un tamaño que hace poco razonable mantenerlo en la URL, esa pérdida probablemente sea aceptable.
Una tercera posibilidad: QUERY
Existe además una alternativa más reciente que resulta conceptualmente interesante: el método HTTP QUERY.
La motivación es precisamente separar la semántica de una operación de consulta de la necesidad de transportar una estructura compleja en el body.
En teoría, encaja muy bien con el problema: una consulta segura podría mantener una semántica específica de consulta y, al mismo tiempo, recibir contenido estructurado sin tener que comprimirlo artificialmente dentro de la URL.
El inconveniente está en el ecosistema.
Que un método esté definido mediante un estándar no significa que navegadores, proxies, firewalls, gateways y otras piezas de infraestructura lo soporten con la misma madurez que GET o POST.
Por eso puede ser una opción interesante para mantener en el radar, especialmente cuando se controla de extremo a extremo la infraestructura, pero no necesariamente es la elección más conservadora para una API pública que necesita máxima interoperabilidad.
Cuando ni siquiera el body es suficiente
Hay todavía un escenario más extremo.
Supongamos que la consulta es muy grande, pero además se reutiliza constantemente. Enviar todo el filtro en cada petición puede empezar a resultar innecesario.
En ese caso, quizá el problema ya no consista en decidir cómo transportar el filtro, sino en dejar de transportarlo.
Una alternativa es convertir la búsqueda en un recurso persistente:
POST /saved-searches
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    }
  ]
}
El servidor puede almacenar esa definición y devolver un identificador:
HTTP/1.1 201 Created

Location: /saved-searches/abc123
A partir de ahí, las peticiones posteriores pueden referirse al identificador en lugar de reenviar toda la estructura.
La decisión es diferente porque también lo es el problema.
Ya no estamos intentando representar una búsqueda compleja dentro de una URL. Estamos modelando la búsqueda como un recurso que puede persistir y reutilizarse.
Del lado del frontend
Todas estas decisiones del backend tienen una contraparte en el cliente que construye la petición.
El problema no es solo cómo codificar el filtro. Es que si el filtro vive únicamente en el estado del componente, el usuario pierde la posibilidad de compartir la búsqueda, usar el botón atrás del navegador o guardarla como favorito. La URL deja de ser el estado de la pantalla.
La solución en Angular es sincronizar el filtro con los query params del Router en ambas direcciones. Cuando el usuario aplica filtros, la URL se actualiza. Cuando alguien llega con una URL que ya tiene filtros, el formulario se rellena y la búsqueda se ejecuta automáticamente.
Para Base64URL el helper de codificación es simple:
encode(filter: object): string {
  const json = JSON.stringify(filter);
  return btoa(unescape(encodeURIComponent(json)))
    .replace(/\+/g, '-')
    .replace(/\//g, '_')
    .replace(/=+$/, '');
}
Y la sincronización con el router:
// Al cambiar filtros → actualizar la URL
this.router.navigate([], {
  relativeTo: this.route,
  queryParams: { filter: this.encode(filter) },
  queryParamsHandling: 'merge'
});

// Al inicializar → leer filtros de la URL
this.route.queryParams.pipe(
  map(params => params['filter']),
  filter(Boolean),
  map(encoded => this.decode(encoded))
).subscribe(filter => {
  this.applyToForm(filter);
  this.search(filter);
});
Para RSQL la mecánica es idéntica. Solo cambia el formato del string que viaja en el param: en lugar de Base64URL opaco viaja una cadena legible como categoria=in=(electronica,hogar);precio=ge=100000. El router no distingue entre uno y otro.
Volver a aquella URL de 400 caracteres
Aquella URL llena de %7B%22and%22%3A no era realmente un problema de sintaxis.
Era una señal.
La complejidad de la consulta había empezado a superar la comodidad del mecanismo elegido para transportarla, pero todavía no se había tomado una decisión consciente sobre qué propiedad del contrato era importante conservar.
Si los filtros se mapean bien a campos de una entidad persistida y a operadores relacionales estándar, una gramática de texto como RSQL resuelve el problema con muy poco código y conserva la legibilidad de la URL — a costa de depender de una capa de traducción a persistencia y de mantener activamente una allowlist. Si el contrato del filtro es propio del dominio, con operadores específicos o estructuras que no encajan en el modelo relacional directo, Base64URL con DTO tipado ofrece un contrato explícito, no depende de ningún motor de datos particular, y su allowlist es estructural en lugar de operacional.
flowchart TD
    A[¿Qué tipo de filtros necesitás?] --> B
    A --> C
    A --> D
    A --> E

    B["Campos simples\nsin lógica compleja"]
    --> F["QueryDSL Web Bindings\nCero código, nativo Spring Data"]

    C["AND / OR sobre atributos\nde una entidad persistida"]
    --> G{¿Existe una capa que traduzca\ngramática de texto a persistencia?}
    G -->|Sí| H["RSQL / gramática similar\nCon allowlist explícita"]
    G -->|No| D

    D["Operadores custom\nlógica de dominio\ncolecciones correlacionadas"]
    --> I{¿Necesitás URL compartible?}
    I -->|Sí, filtro moderado| J["Base64URL + HandlerMethodArgumentResolver"]
    I -->|No, o filtro grande| K["POST /search\nBody JSON estructurado"]

    E["Filtros enormes\nreutilizados entre sesiones"]
    --> L["saved-searches como recurso\nPOST para crear, GET con ID para reutilizar"]
Cuando el filtro deja de ser razonablemente pequeño, el problema cambia de naturaleza. POST con JSON puede ser un contrato mucho más apropiado. Y si la búsqueda se vuelve grande y reutilizable, puede tener más sentido convertirla en un recurso persistente y referenciarla mediante un identificador.
La decisión correcta no consiste en elegir una tecnología y aplicarla a todas las búsquedas.
Consiste en reconocer que cada representación conserva unas propiedades y sacrifica otras.
Query params simples conservan una URL muy legible, pero se vuelven incómodos cuando la estructura crece. Una gramática de texto como RSQL mantiene esa legibilidad con más expresividad, pero exige que exista una capa de traducción a persistencia y una allowlist explícita mantenida activamente, o la superficie de ataque crece silenciosamente. Base64URL mantiene la búsqueda como GET y permite un contrato de filtro completamente propio, sin depender de ningún motor de datos particular, aunque sacrifica legibilidad en logs. POST recupera la representación natural del JSON cuando la consulta ya es demasiado grande. Y una búsqueda persistente elimina directamente la necesidad de reenviar una estructura que ya existe en el servidor.
El verdadero cambio, entonces, no está en Base64URL, en RSQL, en Spring Boot ni siquiera en HTTP.
Está en dejar de pedirle al mismo mecanismo que resuelva problemas de tamaños y necesidades diferentes.
Cuando una búsqueda es pequeña, puede viajar como una consulta.
Cuando necesita estructura pero todavía cabe razonablemente en una URL, puede codificarse, con la representación que mejor encaje con el contrato.
Cuando crece demasiado, puede pasar al body.
Y cuando se convierte en algo que se reutiliza como entidad propia, puede dejar de viajar por completo y convertirse en un recurso.
Ese es el criterio que permite que la arquitectura evolucione con la complejidad real del problema, en lugar de obligar a cada nueva necesidad a encajar a la fuerza en la decisión que se tomó cuando el endpoint todavía parecía sencillo.
Anexo: RSQL en el stack Java (Spring Boot + JPA)
Todo lo dicho sobre RSQL en el cuerpo del artículo es válido para cualquier stack que cuente con una capa de traducción gramática→persistencia equivalente. Este anexo muestra cómo se ve concretamente esa integración en el ecosistema Java, donde esa capa la provee la Criteria API de JPA a través de una Specification.
La integración más difundida usa un starter de terceros (no es un proyecto oficial de Spring) que convierte directamente la cadena RSQL en una Specification:
<dependency>
    <groupId>io.github.perplexhub</groupId>
    <artifactId>rsql-jpa-spring-boot-starter</artifactId>
    <version>6.0.18</version>
</dependency>
@GetMapping("/productos")
public Page<Producto> buscar(
        @RequestParam(defaultValue = "") String filter,
        Pageable pageable) {

    return productoRepository.findAll(
        RSQLJPASupport.toSpecification(filter),
        pageable
    );
}
Eso es todo el controlador. Sin anotaciones custom, sin resolver, sin ObjectMapper — la contrapartida es la dependencia externa a un motor de persistencia relacional vía JPA, que es justamente lo que el cuerpo del artículo señala como condición de existencia de este camino.
La allowlist mencionada antes se implementa recorriendo el AST que produce el parser de RSQL, antes de convertirlo en Specification, y rechazando cualquier campo fuera de lo permitido:
private void validarCamposPermitidos(String filter, Set<String> permitidos) {
    if (filter.isBlank()) return;

    new RSQLParser().parse(filter).accept(new RSQLVisitor<Void, Void>() {
        public Void visit(AndNode node, Void p) {
            node.getChildren().forEach(c -> c.accept(this, null)); return null;
        }
        public Void visit(OrNode node, Void p) {
            node.getChildren().forEach(c -> c.accept(this, null)); return null;
        }
        public Void visit(ComparisonNode node, Void p) {
            if (!permitidos.contains(node.getSelector()))
                throw new FiltroInvalidoException(
                    "Campo no permitido: " + node.getSelector());
            return null;
        }
    });
}
Y componer la Specification resultante con los filtros base que el usuario nunca debe poder eludir:
Specification<Producto> spec = RSQLJPASupport.<Producto>toSpecification(filter)
    .and((root, query, cb) -> cb.equal(root.get("eliminado"), false))
    .and((root, query, cb) -> cb.equal(root.get("tenantId"), TenantContext.get()));
En otro stack o con otro ORM, el nombre de las piezas cambia, pero el rol de cada una se mantiene: un parser de la gramática, un traductor hacia el mecanismo de consulta dinámica del ORM disponible, y una allowlist que se aplica sobre el árbol ya parseado antes de ejecutar nada contra la base de datos.
El Arte de la Consistencia: Creando Respuestas API Predecibles en Spring MVC
- Mauricio ECR
- Snippets
- 24 Sep, 2025
El Arte de la Consistencia: Creando Respuestas API Predecibles en Spring MVC Imagina a un desarrollador frontend consumiendo tu API. En un endpoint, recibe un objeto JSON. En otro, una simple lista. S
El Arte de la Consistencia: Creando Respuestas API Predecibles en Spring MVC
- Mauricio ECR
- Snippets
- 24 Sep, 2025
El Arte de la Consistencia: Creando Respuestas API Predecibles en Spring MVC Imagina a un desarrollador frontend consumiendo tu API. En un endpoint, recibe un objeto JSON. En otro, una simple lista. Si ocurre un error de validación, obtiene una estructura compleja; si el servidor falla, recibe un texto plano. Cada variación, por pequeña que sea, introduce una nueva lógica condicional en el cliente. Rápidamente, esa falta de estándar se convierte en un caos silencioso, una deuda técnica que frena la innovación y fragiliza el sistema.
La estandarización de las respuestas de una API no es una cuestión de estética, sino una decisión de arquitectura fundamental. El verdadero desafío es cómo lograr esta uniformidad sin contaminar nuestra lógica de negocio con código repetitivo. Afortunadamente, Spring MVC nos ofrece herramientas de una elegancia sorprendente, @RestControllerAdvice y ResponseBodyAdvice, diseñadas precisamente para resolver estos problemas transversales de forma limpia y centralizada.
Este artículo te guiará en la implementación de un patrón de respuesta robusto y unificado en un entorno Spring Boot con Lombok, cubriendo tanto los casos de éxito como los de error de manera consistente y profesional.
El Contrato: La Piedra Angular de la Previsibilidad
Antes de escribir una sola línea de lógica, debemos definir nuestro objetivo: un formato de respuesta único que sirva tanto para éxitos como para errores. Esta es la base de la predictibilidad. En lugar de improvisar, diseñaremos una estructura genérica que actúe como un contrato inmutable con nuestros clientes.
La clave de nuestra estrategia es la clase ApiResponse. Este DTO (Data Transfer Object) genérico contendrá tres componentes principales:
meta: Un objeto con metadatos de la solicitud (timestamp, ID de la petición, etc.), útil para la depuración y el monitoreo.data: El payload real de la respuesta en caso de éxito. Será de tipo genérico (T).errors: Una lista de errores detallados si algo sale mal.
Una de las decisiones más importantes aquí es el uso de la anotación @JsonInclude(JsonInclude.Include.NON_NULL). Esta simple línea le indica a Jackson (el serializador JSON de Spring) que omita cualquier campo con valor nulo. ¿El resultado? Las respuestas exitosas no tendrán el campo errors y las de error no tendrán el campo data, manteniendo así los JSON limpios y relevantes sin necesidad de crear múltiples clases.
Para construir este contrato, asegúrate de tener las dependencias esenciales en tu pom.xml:
<dependencies>
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-web</artifactId>
    </dependency>
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-validation</artifactId>
    </dependency>
    <dependency>
        <groupId>org.projectlombok</groupId>
        <artifactId>lombok</artifactId>
        <optional>true</optional>
    </dependency>
</dependencies>
Y aquí está el diseño de nuestro contrato unificado:
// src/main/java/com/example/demo/common/ApiResponse.java
package com.example.demo.common;

import com.fasterxml.jackson.annotation.JsonInclude;
import lombok.Builder;
import lombok.Data;
import java.time.Instant;
import java.util.List;
import java.util.UUID;

@Data
@Builder
@JsonInclude(JsonInclude.Include.NON_NULL)
public class ApiResponse<T> {

    private Meta meta;
    private T data;
    private List<ErrorDetail> errors;

    @Data
    @Builder
    public static class Meta {
        private String timestamp = Instant.now().toString();
        @Builder.Default
        private String requestId = UUID.randomUUID().toString().substring(0, 10);
        private String path;
        private int status;
    }

    @Data
    @Builder
    public static class ErrorDetail {
        private String code;
        private String message;
    }

    public static <T> ApiResponse<T> success(T data, String path, int status) {
        return ApiResponse.<T>builder()
                .meta(Meta.builder().path(path).status(status).build())
                .data(data)
                .build();
    }

    public static ApiResponse<?> error(List<ErrorDetail> errors, String path, int status) {
        return ApiResponse.builder()
                .meta(Meta.builder().path(path).status(status).build())
                .errors(errors)
                .build();
    }
}
La Arquitectura de la Consistencia: Separando Responsabilidades
Para una solución robusta y mantenible, aplicaremos el Principio de Responsabilidad Única. En lugar de una sola clase monolítica, dividiremos nuestra lógica en dos componentes especializados, ambos anotados con @RestControllerAdvice. Spring es lo suficientemente inteligente como para detectar y aplicar ambos.
Primero, crearemos una configuración para permitirnos habilitar, deshabilitar o excluir rutas de este comportamiento, dándonos flexibilidad para casos especiales como los endpoints de Actuator o Swagger.
// src/main/java/com/example/demo/common/ResponseWrapperProperties.java
package com.example.demo.common;

import lombok.Data;
import org.springframework.boot.context.properties.ConfigurationProperties;
import org.springframework.stereotype.Component;
import java.util.ArrayList;
import java.util.List;

@Data
@Component
@ConfigurationProperties(prefix = "api.response.wrapper")
public class ResponseWrapperProperties {
    private boolean enabled = true;
    private List<String> excludedPaths = new ArrayList<>();
}
1. El Guardián de Respuestas Exitosas
Nuestra primera clase, GlobalResponseHandler, tendrá una sola misión: interceptar las respuestas exitosas de los controladores y envolverlas en nuestra estructura ApiResponse. Utiliza la interfaz ResponseBodyAdvice para modificar el cuerpo de la respuesta justo antes de que se envíe.
// src/main/java/com/example/demo/common/GlobalResponseHandler.java
package com.example.demo.common;

import jakarta.servlet.http.HttpServletRequest;
import lombok.RequiredArgsConstructor;
import org.springframework.core.MethodParameter;
import org.springframework.http.MediaType;
import org.springframework.http.converter.HttpMessageConverter;
import org.springframework.http.server.ServerHttpRequest;
import org.springframework.http.server.ServerHttpResponse;
import org.springframework.http.server.ServletServerHttpRequest;
import org.springframework.http.server.ServletServerHttpResponse;
import org.springframework.util.AntPathMatcher;
import org.springframework.web.bind.annotation.RestControllerAdvice;
import org.springframework.web.servlet.mvc.method.annotation.ResponseBodyAdvice;

@RestControllerAdvice
@RequiredArgsConstructor
public class GlobalResponseHandler implements ResponseBodyAdvice<Object> {

    private final ResponseWrapperProperties properties;
    private final AntPathMatcher pathMatcher = new AntPathMatcher();

    @Override
    public boolean supports(MethodParameter returnType, Class<? extends HttpMessageConverter<?>> converterType) {
        return true;
    }

    @Override
    public Object beforeBodyWrite(Object body, MethodParameter returnType, MediaType selectedContentType,
                                  Class<? extends HttpMessageConverter<?>> selectedConverterType,
                                  ServerHttpRequest request, ServerHttpResponse response) {

        HttpServletRequest servletRequest = ((ServletServerHttpRequest) request).getServletRequest();
        String path = servletRequest.getRequestURI();

        // Si el cuerpo ya es un ApiResponse (creado por el manejador de excepciones)
        // o la ruta está excluida, no hacemos nada.
        if (body instanceof ApiResponse || isExcluded(path)) {
            return body;
        }

        int status = ((ServletServerHttpResponse) response).getServletResponse().getStatus();
        return ApiResponse.success(body, path, status);
    }

    private boolean isExcluded(String path) {
        return !properties.isEnabled() || properties.getExcludedPaths().stream()
                .anyMatch(pattern -> pathMatcher.match(pattern, path));
    }
}
2. El Centinela Central de Errores
La segunda clase, GlobalExceptionHandler, se dedicará exclusivamente a capturar excepciones lanzadas desde cualquier controlador. Usando @ExceptionHandler, las convierte en nuestra respuesta ApiResponse estandarizada. Este aislamiento hace que el código de manejo de errores sea fácil de encontrar, mantener y extender.
// src/main/java/com/example/demo/common/GlobalExceptionHandler.java
package com.example.demo.common;

import jakarta.servlet.http.HttpServletRequest;
import lombok.extern.slf4j.Slf4j;
import org.springframework.http.HttpStatus;
import org.springframework.web.bind.MethodArgumentNotValidException;
import org.springframework.web.bind.annotation.ExceptionHandler;
import org.springframework.web.bind.annotation.ResponseStatus;
import org.springframework.web.bind.annotation.RestControllerAdvice;
import java.util.Collections;
import java.util.List;
import java.util.stream.Collectors;

@Slf4j
@RestControllerAdvice
public class GlobalExceptionHandler {

    @ExceptionHandler(MethodArgumentNotValidException.class)
    @ResponseStatus(HttpStatus.BAD_REQUEST)
    public ApiResponse<?> handleValidationExceptions(MethodArgumentNotValidException ex, HttpServletRequest request) {
        List<ApiResponse.ErrorDetail> errors = ex.getBindingResult().getFieldErrors().stream()
                .map(error -> ApiResponse.ErrorDetail.builder()
                        .code("VALIDATION_ERROR")
                        .message(String.format("'%s': %s", error.getField(), error.getDefaultMessage()))
                        .build())
                .collect(Collectors.toList());
        return ApiResponse.error(errors, request.getRequestURI(), HttpStatus.BAD_REQUEST.value());
    }

    @ExceptionHandler(Exception.class)
    @ResponseStatus(HttpStatus.INTERNAL_SERVER_ERROR)
    public ApiResponse<?> handleAllUncaughtException(Exception ex, HttpServletRequest request) {
        log.error("Error no controlado en la ruta {}: {}", request.getRequestURI(), ex.getMessage(), ex);
        ApiResponse.ErrorDetail error = ApiResponse.ErrorDetail.builder()
                .code("INTERNAL_SERVER_ERROR")
                .message("Ocurrió un error inesperado. Por favor, contacte al soporte.")
                .build();
        return ApiResponse.error(Collections.singletonList(error), request.getRequestURI(), HttpStatus.INTERNAL_SERVER_ERROR.value());
    }
}
Ganando Confianza: Pruebas que Validan la Arquitectura
Probar componentes transversales es crucial. Con @WebMvcTest, creamos un contexto de prueba ligero que se enfoca en la capa web. La clave es importar ambas clases de Advice en nuestro test para asegurar que el comportamiento combinado (formateo de éxito y manejo de errores) se verifica correctamente.
// src/test/java/com/example/demo/common/GlobalResponseHandlerTest.java
package com.example.demo.common;

import jakarta.validation.Valid;
import jakarta.validation.constraints.NotEmpty;
import lombok.AllArgsConstructor;
import lombok.Data;
import org.junit.jupiter.api.BeforeEach;
import org.junit.jupiter.api.DisplayName;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.autoconfigure.web.servlet.WebMvcTest;
import org.springframework.boot.test.mock.mockito.MockBean;
import org.springframework.context.annotation.Import;
import org.springframework.http.MediaType;
import org.springframework.test.web.servlet.MockMvc;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.PostMapping;
import org.springframework.web.bind.annotation.RequestBody;
import org.springframework.web.bind.annotation.RestController;
import java.util.List;
import static org.mockito.Mockito.when;
import static org.springframework.test.web.servlet.request.MockMvcRequestBuilders.get;
import static org.springframework.test.web.servlet.request.MockMvcRequestBuilders.post;
import static org.springframework.test.web.servlet.result.MockMvcResultMatchers.*;

@WebMvcTest(controllers = GlobalResponseHandlerTest.TestController.class)
// Importamos AMBAS clases para que el contexto de prueba refleje la configuración real.
@Import({GlobalResponseHandler.class, GlobalExceptionHandler.class})
class GlobalResponseHandlerTest {

    @Autowired
    private MockMvc mockMvc;

    @MockBean
    private ResponseWrapperProperties responseWrapperProperties;

    // ... (El resto de la clase de prueba, incluyendo setUp, TestController, TestDto y los métodos de prueba, permanece igual) ...

    @BeforeEach
    void setUp() {
        when(responseWrapperProperties.isEnabled()).thenReturn(true);
        when(responseWrapperProperties.getExcludedPaths()).thenReturn(List.of("/excluded/**"));
    }

    @RestController
    static class TestController {
        @GetMapping("/test/success")
        public TestDto getSuccess() { return new TestDto("ok"); }

        @PostMapping("/test/validation")
        public TestDto postValidation(@Valid @RequestBody TestDto dto) { return dto; }

        @GetMapping("/excluded/path")
        public TestDto getExcluded() { return new TestDto("excluded"); }
    }

    @Data
    @AllArgsConstructor
    static class TestDto {
        @NotEmpty
        private String message;
    }

    @Test
    @DisplayName("Debería envolver una respuesta exitosa en el formato ApiResponse")
    void shouldWrapSuccessResponse() throws Exception {
        mockMvc.perform(get("/test/success"))
                .andExpect(status().isOk())
                .andExpect(jsonPath("$.meta").exists())
                .andExpect(jsonPath("$.data.message").value("ok"))
                .andExpect(jsonPath("$.errors").doesNotExist());
    }

    @Test
    @DisplayName("No debería envolver una respuesta si la ruta está excluida")
    void shouldNotWrapExcludedPath() throws Exception {
        mockMvc.perform(get("/excluded/path"))
                .andExpect(status().isOk())
                .andExpect(jsonPath("$.meta").doesNotExist())
                .andExpect(jsonPath("$.message").value("excluded"));
    }

    @Test
    @DisplayName("Debería manejar un error de validación y devolver ApiResponse con detalles de error")
    void shouldHandleValidationError() throws Exception {
        String invalidDtoJson = "{\"message\":\"\"}";

        mockMvc.perform(post("/test/validation")
                        .contentType(MediaType.APPLICATION_JSON)
                        .content(invalidDtoJson))
                .andExpect(status().isBadRequest())
                .andExpect(jsonPath("$.meta").exists())
                .andExpect(jsonPath("$.data").doesNotExist())
                .andExpect(jsonPath("$.errors").isArray())
                .andExpect(jsonPath("$.errors[0].code").value("VALIDATION_ERROR"));
    }
}
Más Allá del Código: El Impacto de una Arquitectura Consistente
Hemos recorrido un camino que va más allá de un simple truco de código. Partimos de un problema real —el caos de las respuestas inconsistentes— y, en lugar de aplicar parches, diseñamos una solución arquitectónica limpia basada en la separación de responsabilidades.
El resultado es un patrón robusto y no invasivo que unifica todas las respuestas bajo un contrato predecible. La lógica está aislada, es configurable y completamente testeable. Esta inversión en diseño reduce la carga cognitiva para todos, desde los desarrolladores del backend hasta los consumidores de la API, creando sistemas más mantenibles, escalables y, en definitiva, más sencillos de razonar.
Este patrón no es un punto final, sino una base sólida. Las posibilidades futuras son claras:
- Documentación de API: El siguiente paso es asegurar que herramientas como OpenAPI/Swagger reflejen esta estructura
ApiResponseautomáticamente, proporcionando una documentación precisa del contrato real. - Trazabilidad Distribuida: El
requestIden los metadatos es la semilla para una trazabilidad completa. Integrarlo con herramientas como Micrometer Tracing permitiría seguir una petición a través de múltiples microservicios, simplificando la depuración en entornos complejos. - Observabilidad Mejorada: El bloque
metapuede enriquecerse con más datos, como el tiempo de procesamiento, para alimentar dashboards en herramientas como Grafana y Prometheus, ofreciendo una visión más profunda del rendimiento de la API.
El Arte del Contexto: Diseño Flexible en Arquitecturas DDD con Java y Spring Boot
- Mauricio ECR
- Snippets
- 23 Sep, 2025
En el universo del desarrollo de software empresarial, nos enfrentamos a un dilema constante: cómo manejar información transversal —ese rastro de datos vitales como IDs de correlación, información del
El Arte del Contexto: Diseño Flexible en Arquitecturas DDD con Java y Spring Boot
- Mauricio ECR
- Snippets
- 23 Sep, 2025
En el universo del desarrollo de software empresarial, nos enfrentamos a un dilema constante: cómo manejar información transversal —ese rastro de datos vitales como IDs de correlación, información del usuario o el tenant de un sistema multi-inquilino— sin que contamine la pureza de nuestro dominio. Estos datos son el sistema nervioso de la aplicación, esenciales para la trazabilidad, la auditoría y la seguridad, pero no son parte del lenguaje de negocio. Incluirlos como parámetros en cada método del dominio es una solución rápida que, a la larga, genera un código verboso y acoplado.
Imagina que estás construyendo un sistema complejo con Java 21, Spring Boot y una filosofía Domain-Driven Design (DDD). Tu arquitectura está elegantemente separada en capas de dominio, infraestructura y aplicación. ¿Cómo logras que ese "contexto" de ejecución fluya mágicamente a través de todas las capas, disponible cuando se necesita, pero invisible cuando no? El objetivo es crear un mecanismo que sea a la vez transparente y robusto, que funcione igual de bien para una petición REST, un proceso batch o un mensaje de una cola.
La encrucijada del diseño: ¿Parámetro o Magia?
Cuando nos enfrentamos a la propagación de contexto, hay dos caminos. El primero es el de la explicitud: si un dato es parte del lenguaje de negocio (como el "autor" de una acción), debe ser un parámetro explícito en el dominio. No hay discusión. El segundo camino es el de la transversalidad, reservado para metadatos puramente técnicos. Aquí es donde queremos un poco de "magia controlada", una forma de acceder a la información sin que ensucie nuestras interfaces de negocio.
Para esta magia, ThreadLocal se presenta como un candidato ideal en el ecosistema tradicional de Spring. Es, en esencia, una caja de almacenamiento que cada hilo de ejecución lleva consigo. Lo que un hilo guarda en su ThreadLocal, solo ese hilo puede verlo, garantizando un aislamiento perfecto en entornos concurrentes.
Nuestra herramienta será un ExecutionContext, un contenedor simple que vivirá en ese ThreadLocal. Usamos un Map<String, Object> en su interior por una razón clave: flexibilidad. Podríamos crear una clase con campos fijos (correlationId, userId, etc.), pero un mapa nos permite añadir nuevos datos al contexto en el futuro sin modificar la clase base. Es un compromiso consciente entre la seguridad de tipos y la extensibilidad.
import java.util.Map;
import java.util.concurrent.ConcurrentHashMap;

// Un contenedor simple y flexible para los datos de nuestro contexto.
public class ExecutionContext {
    private static final ThreadLocal<ExecutionContext> CONTEXT = new ThreadLocal<>();
    private final Map<String, Object> values = new ConcurrentHashMap<>();

    // ... (métodos init, current, clear, put, get)
    public static ExecutionContext current() { return CONTEXT.get(); }
    public static void set(ExecutionContext context) { CONTEXT.set(context); }
    public static void clear() { CONTEXT.remove(); }
    public static ExecutionContext init() {
        ExecutionContext ctx = new ExecutionContext();
        set(ctx);
        return ctx;
    }
    public void put(String key, Object value) { values.put(key, value); }
    @SuppressWarnings("unchecked")
    public <T> T get(String key, Class<T> type) { return (T) values.get(key); }
}
El guardián del ciclo de vida: Automatización con un Filter
Tener el ExecutionContext es solo el primer paso. El mayor riesgo de ThreadLocal es el olvido. En un servidor como Tomcat, los hilos se reciclan. Si no limpiamos el contexto al final de una petición, ese hilo reutilizado podría servir a otro usuario con los datos del anterior, una brecha de seguridad y de datos catastrófica.
Aquí es donde entra en juego el Filter de Servlet, el guardián de nuestro contexto. Un Filter es perfecto porque opera a un nivel más bajo que los controladores de Spring. Intercepta toda petición entrante, dándonos el lugar ideal para:
- Inicializar el contexto al empezar.
- Poblarlo con datos de la petición, como cabeceras.
- Garantizar su limpieza al terminar, pase lo que pase.
El bloque try...finally no es una opción, es una obligación. Es el seguro de vida que nos protege contra las fugas de memoria y la contaminación de datos. En el siguiente código, no solo capturamos un ID de correlación, sino también un token JWT, demostrando la flexibilidad del mapa.
import jakarta.servlet.*;
import jakarta.servlet.http.HttpServletRequest;
import org.apache.logging.log4j.ThreadContext;
import org.springframework.stereotype.Component;
import java.io.IOException;
import java.util.UUID;

@Component
public class ExecutionContextFilter implements Filter {
    // ... (constantes para las claves)
    private static final String CORRELATION_ID_HEADER = "X-Correlation-ID";
    private static final String AUTH_HEADER = "Authorization";
    private static final String CORRELATION_ID_KEY = "correlationId";
    private static final String JWT_KEY = "jwtToken";

    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain)
            throws IOException, ServletException {

        ExecutionContext.init(); // Nace el contexto

        try {
            // Se enriquece con datos de la petición
            if (request instanceof HttpServletRequest httpRequest) {
                String correlationId = httpRequest.getHeader(CORRELATION_ID_HEADER);
                // ... (lógica para generar correlationId si no existe)
                ExecutionContext.current().put(CORRELATION_ID_KEY, correlationId);
                ThreadContext.put(CORRELATION_ID_KEY, correlationId); // Se lo pasamos a Log4j2

                String token = httpRequest.getHeader(AUTH_HEADER);
                if (token != null) {
                    ExecutionContext.current().put(JWT_KEY, token);
                }
            }
            chain.doFilter(request, response);
        } finally {
            // Se limpia, garantizando que el hilo reciclado esté impoluto
            ThreadContext.clearMap();
            ExecutionContext.clear();
        }
    }
}
Observabilidad sin esfuerzo: El poder del Logging contextual
Depurar un problema en producción sin un ID de correlación es como buscar una aguja en un pajar. Al integrar nuestro contexto con el sistema de logging (vía el MDC de Log4j2, que es su propia versión de ThreadLocal), cada línea de log generada durante la petición quedará marcada con ese identificador único. De repente, el pajar se organiza en hilos de paja perfectamente trazables.
Solo necesitamos decirle a Log4j2 que muestre esa información en su patrón:
<Configuration status="WARN">
    <Appenders>
        <Console name="Console" target="SYSTEM_OUT">
            <PatternLayout pattern="%d{HH:mm:ss.SSS} [%t] %-5level %logger{36} - [%X{correlationId}] - %msg%n"/>
        </Console>
    </Appenders>
    </Configuration>
Un ejemplo práctico para unirlo todo
La teoría está muy bien, pero veámoslo en acción. Imaginemos un flujo simple: un controlador recibe una petición, llama a un caso de uso que a su vez depende de un repositorio para hablar con un servicio externo.
El Dominio, un oasis de pureza:
El código del dominio no sabe nada del contexto. Define los contratos (HelloWorldRepository) y orquesta la lógica (GetHelloWorldUseCase), manteniéndose limpio y enfocado.
// Caso de Uso: depende de una abstracción y no sabe de dónde saldrán los datos.
public class GetHelloWorldUseCase {
    private final HelloWorldRepository helloWorldRepository;
    // ... (constructor)

    public String execute() {
        // ... (log de inicio)
        String externalGreeting = helloWorldRepository.getGreeting();

        // ¡Aquí es donde el dominio se beneficia de la "magia"!
        // Accede al contexto de forma segura y opcional.
        String correlationId = ExecutionContext.current().get("correlationId", String.class);

        System.out.println("DESDE CASO DE USO: Mensaje del repo: '" + externalGreeting +
                           "'. Trazabilidad: " + correlationId);
        return externalGreeting;
    }
}
La Infraestructura, donde ocurre la magia:
Aquí es donde implementamos los detalles. Nuestro RestHelloWorldRepository simula ser un cliente REST. Antes de hacer su "llamada", consulta el ExecutionContext para obtener el token JWT que necesita para autenticarse. ¡El caso de uso nunca tuvo que pasárselo!
// Implementación del Repositorio: el "fontanero" que conecta con el mundo exterior.
public class RestHelloWorldRepository implements HelloWorldRepository {
    @Override
    public String getGreeting() {
        // Obtiene el token que el Filter puso en el contexto.
        String jwt = ExecutionContext.current().get("jwtToken", String.class);
        System.out.println("DESDE REPOSITORIO (CLIENTE REST): Usando el token para la llamada -> " + jwt);
        return "Hola desde el servicio externo!";
    }
}
Al ejecutar una petición con curl que incluya las cabeceras X-Correlation-ID y Authorization, la salida en la consola nos cuenta la historia completa: el log con el ID, la implementación del repositorio usando el token, y el caso de uso accediendo de nuevo al ID. Todo fluyó sin que una sola firma de método se viera alterada.
Conclusión: Un patrón poderoso con responsabilidades
Hemos construido un sistema robusto para manejar el contexto. Sin embargo, este poder conlleva responsabilidades. El patrón ThreadLocal es una herramienta fantástica para arquitecturas síncronas basadas en el modelo "un hilo por petición", pero es el enfoque incorrecto para sistemas reactivos (como WebFlux), donde la ejecución no está atada a un único hilo. Allí, la solución nativa es el Context de Project Reactor.
Además, con la llegada de los Hilos Virtuales en Java, el uso masivo de ThreadLocal puede limitar sus beneficios de escalabilidad. El futuro apunta a los Scoped Values (JEP 446), diseñados precisamente para este tipo de propagación de datos de forma más eficiente.
Entender estas fronteras es tan importante como conocer el patrón en sí. La clave del éxito es siempre la misma: mantener el dominio puro y delegar las complejidades técnicas a una capa de infraestructura bien diseñada.
Respuestas API Consistentes: Un Wrapper Transversal con Spring WebFlux y `WebFilter`
- Mauricio ECR
- Snippets
- 30 Aug, 2025
En entornos modernos de microservicios, la consistencia en las respuestas de una API es más que una cuestión de estética: es un factor crítico para la mantenibilidad, observabilidad y experiencia del
Respuestas API Consistentes: Un Wrapper Transversal con Spring WebFlux y `WebFilter`
- Mauricio ECR
- Snippets
- 30 Aug, 2025
En entornos modernos de microservicios, la consistencia en las respuestas de una API es más que una cuestión de estética: es un factor crítico para la mantenibilidad, observabilidad y experiencia del consumidor. Aplicaciones frontend, integraciones con terceros, herramientas de monitoreo y otros microservicios esperan estructuras de respuesta predecibles. Cada variación no planificada introduce fricción: más lógica en los clientes, validaciones dispersas y puntos ciegos en trazabilidad.
En este contexto, estandarizar las respuestas de manera transversal —sin ensuciar cada controlador con lógica repetitiva— no solo simplifica el desarrollo, también abre la puerta a métricas uniformes, trazabilidad distribuida y soporte para nuevas funcionalidades sin tocar el código de negocio.
Este artículo explica cómo lograrlo en aplicaciones reactivas con Spring WebFlux, donde la naturaleza streaming de la respuesta introduce desafíos distintos a los de un stack imperativo como Spring MVC.
El Contrato de Respuesta: Mucho más que Datos
Antes de modificar nada, debemos definir el destino. Una respuesta estándar debe separar claramente los datos de negocio de la información contextual que permite entender la petición en su conjunto.
Un diseño común y extensible puede lucir así:
package com.app247.api.shared.response_wrapper.model;

import lombok.Builder;
import lombok.Data;

@Data
@Builder
public class ApiResponse<T> {
    private Meta meta;
    private T data;

    @Data
    @Builder
    public static class Meta {
        private String timestamp;
        private String path;
        private int status;
        private String requestId;
    }
}
Este contrato permite:
- Consistencia: cada respuesta, sin importar el endpoint, sigue la misma forma.
- Trazabilidad: con
requestIdytimestamppodemos correlacionar logs, métricas y reportes. - Extensibilidad: podemos agregar campos en
meta(e.g., tiempos de respuesta, versión del servicio) sin afectar al cliente.
En entornos con OpenAPI/Swagger, este modelo puede documentarse fácilmente para que los consumidores conozcan el formato exacto de las respuestas.
WebFlux y el Desafío del Streaming
En aplicaciones no reactivas, ResponseBodyAdvice permite interceptar y modificar respuestas antes de serializarse. Pero en WebFlux, las respuestas son streams (Publisher<DataBuffer>), no objetos finales en memoria.
Esto implica dos retos:
- Respetar el modelo reactivo: no bloquear el flujo ni forzar materializaciones tempranas.
- Actuar en el punto correcto: cuando la respuesta está completa, pero antes de enviarla al cliente.
Aquí entra en juego el dúo WebFilter + ServerHttpResponseDecorator. El filtro decide si aplicar la transformación; el decorador define cómo hacerlo.
El Filtro: Decidiendo Cuándo Intervenir
Nuestro WebFilter actúa como middleware, excluyendo rutas (por ejemplo, Swagger o Actuator) y habilitando/deshabilitando la lógica según configuración externa:
package com.app247.api.shared.response_wrapper.filter;

import com.app247.api.shared.response_wrapper.config.ResponseWrapperProperties;
import com.app247.api.shared.response_wrapper.decorator.ResponseWrapperDecorator;
import com.fasterxml.jackson.databind.ObjectMapper;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.core.annotation.Order;
import org.springframework.http.server.reactive.ServerHttpResponseDecorator;
import org.springframework.stereotype.Component;
import org.springframework.util.AntPathMatcher;
import org.springframework.web.server.ServerWebExchange;
import org.springframework.web.server.WebFilter;
import org.springframework.web.server.WebFilterChain;
import reactor.core.publisher.Mono;


@Slf4j
@Component
@Order(-2)
@RequiredArgsConstructor
public class ResponseWrapperFilter implements WebFilter {

    private final ResponseWrapperProperties properties;
    private final ObjectMapper objectMapper;
    private final AntPathMatcher pathMatcher = new AntPathMatcher();

    @Override
    public Mono<Void> filter(ServerWebExchange exchange, WebFilterChain chain) {
        String path = exchange.getRequest().getURI().getPath();

        // Verificamos si la ruta está excluida
        boolean isExcluded = !properties.isEnabled() || properties.getExcludedPaths().stream()
                .anyMatch(pattern -> pathMatcher.match(pattern, path));

        if (isExcluded) {
            return chain.filter(exchange);
        }

        // Creamos una instancia de nuestro nuevo decorador
        ServerHttpResponseDecorator decoratedResponse = new ResponseWrapperDecorator(
                exchange.getResponse(),
                path,
                objectMapper
        );

        // Pasamos el exchange con la respuesta decorada al siguiente filtro en la cadena
        return chain.filter(exchange.mutate().response(decoratedResponse).build());
    }
}
Las rutas excluidas y la activación del wrapper se controlan con propiedades externas, evitando recompilar para cambios operativos:
package com.app247.api.shared.response_wrapper.config;

import lombok.Data;
import org.springframework.boot.context.properties.ConfigurationProperties;
import org.springframework.stereotype.Component;
import java.util.ArrayList;
import java.util.List;

/*
Ejemplo:
api:
  response:
    wrapper:
      enabled: true
      # Patrones de URL para excluir. Usa el formato Ant.
      excluded-paths:
        - "/v3/api-docs/**"
        - "/swagger-ui/**"
        - "/webjars/**"
        - "/swagger-resources/**"
        - "/actuator/**"
 */

@Data
@Component
@ConfigurationProperties(prefix = "api.response.wrapper")
public class ResponseWrapperProperties {

    private boolean enabled = true;
    private List<String> excludedPaths = new ArrayList<>();

}
El Decorador: Interviniendo sin Romper el Flujo
ServerHttpResponseDecorator nos da acceso al cuerpo de la respuesta. El método clave es writeWith, que recibe el stream de datos antes de enviarlo al cliente.
package com.app247.api.shared.response_wrapper.decorator;

import com.app247.api.shared.response_wrapper.model.ApiResponse;
import com.fasterxml.jackson.databind.ObjectMapper;
import lombok.extern.slf4j.Slf4j;
import org.reactivestreams.Publisher;
import org.springframework.core.io.buffer.DataBuffer;
import org.springframework.core.io.buffer.DataBufferUtils;
import org.springframework.core.io.buffer.DefaultDataBufferFactory;
import org.springframework.http.HttpStatus;
import org.springframework.http.HttpStatusCode;
import org.springframework.http.MediaType;
import org.springframework.http.server.reactive.ServerHttpResponse;
import org.springframework.http.server.reactive.ServerHttpResponseDecorator;
import reactor.core.publisher.Mono;

import java.nio.charset.StandardCharsets;
import java.time.Instant;
import java.util.UUID;

/**
 * Decorador para ServerHttpResponse que intercepta las respuestas exitosas
 * y las envuelve en una estructura estandarizada de ApiResponse (meta y data).
 */
@Slf4j
public class ResponseWrapperDecorator extends ServerHttpResponseDecorator {

    private final ObjectMapper objectMapper;
    private final String path;

    public ResponseWrapperDecorator(ServerHttpResponse delegate, String path, ObjectMapper objectMapper) {
        super(delegate);
        this.path = path;
        this.objectMapper = objectMapper;
    }

    /**
     * Sobrescribe el método que escribe el cuerpo de la respuesta en el flujo de salida.
     * Aquí es donde ocurre toda la magia de la intercepción y transformación.
     * @param body El publicador original del cuerpo de la respuesta.
     * @return Un Mono<Void> que representa la finalización de la operación de escritura.
     */
    @Override
    public Mono<Void> writeWith(Publisher<? extends DataBuffer> body) {
        // PASO 1: Almacenar el cuerpo completo en un búfer.
        // DataBufferUtils.join() consume tod_o el flujo del 'body' y lo une en un solo DataBuffer.
        // Esto es CRUCIAL porque crea un punto de sincronización. La lógica siguiente
        // no se ejecutará hasta que el controlador haya terminado y el cuerpo completo esté disponible.
        Mono<DataBuffer> bufferedBody = DataBufferUtils.join(body)
                .defaultIfEmpty(new DefaultDataBufferFactory().wrap(new byte[0])); // Maneja cuerpos vacíos (ej: 204 No Content)

        // PASO 2: Usar flatMap para transformar el cuerpo almacenado en búfer.
        // El código dentro de flatMap está garantizado a ejecutarse DESPUÉS de que 'bufferedBody' se complete.
        return bufferedBody.flatMap(originalBuffer -> {
            // PASO 3: Obtener el código de estado.
            // En este punto, la llamada a getStatusCode() es 100% fiable porque el controlador
            // ya ha finalizado y el framework ha establecido el estado final de la respuesta.
            HttpStatusCode statusCode = getStatusCode();

            // PASO 4: Decidir si se debe envolver la respuesta.
            // Si el estado es un error explícito (4xx o 5xx), no hacemos nada y devolvemos el cuerpo original.
            if (statusCode != null && !statusCode.is2xxSuccessful()) {
                // Se escribe el buffer original en la respuesta real.
                return getDelegate().writeWith(Mono.just(originalBuffer));
            }

            // PASO 5: Manejar el caso del entorno de pruebas.
            // En WebFluxTest, un 200 OK por defecto puede resultar en un statusCode 'null'.
            // Asumimos HttpStatus.OK si el estado es null para que las pruebas pasen.
            HttpStatusCode statusToUse = (statusCode != null) ? statusCode : HttpStatus.OK;

            // PASO 6: Procesar y envolver el cuerpo de la respuesta.
            byte[] bytes = new byte[originalBuffer.readableByteCount()];
            originalBuffer.read(bytes);
            DataBufferUtils.release(originalBuffer); // Liberar memoria del buffer original.
            String originalBodyJson = new String(bytes, StandardCharsets.UTF_8);

            // Evitar envolver una respuesta que ya tiene nuestro formato.
            if (originalBodyJson.contains("\"meta\"")) {
                return getDelegate().writeWith(Mono.just(new DefaultDataBufferFactory().wrap(bytes)));
            }

            try {
                // Deserializar el cuerpo original para poder ponerlo dentro del campo 'data'.
                // Si el cuerpo está vacío, se asigna 'null' a los datos.
                Object originalBodyObject = originalBodyJson.isEmpty() ? null : objectMapper.readValue(originalBodyJson, Object.class);

                // Construir la nueva respuesta envuelta.
                ApiResponse<?> apiResponse = buildSuccessResponse(originalBodyObject, path, statusToUse);

                // Serializar la respuesta envuelta a bytes.
                byte[] responseBytes = objectMapper.writeValueAsBytes(apiResponse);

                // Actualizar las cabeceras HTTP con la nueva longitud y tipo de contenido.
                getHeaders().setContentLength(responseBytes.length);
                getHeaders().setContentType(MediaType.APPLICATION_JSON);

                // Crear un nuevo buffer con la respuesta envuelta.
                DataBuffer wrappedBuffer = new DefaultDataBufferFactory().wrap(responseBytes);

                // Escribir el nuevo cuerpo en la respuesta real. Esta es la llamada final y única
                // que envía los datos al cliente, siguiendo las buenas prácticas reactivas.
                return getDelegate().writeWith(Mono.just(wrappedBuffer));

            } catch (Exception e) {
                log.error("Error al envolver la respuesta para la ruta {}: {}", path, e.getMessage(), e);
                return getDelegate().writeWith(Mono.just(new DefaultDataBufferFactory().wrap(bytes)));
            }
        });
    }

    /**
     * Método de ayuda para construir la estructura estandarizada de ApiResponse.
     * @param data El objeto de datos original que se incluirá en el campo 'data'.
     * @param path La ruta de la petición actual.
     * @param status El código de estado HTTP final.
     * @return Una instancia de ApiResponse.
     */
    private ApiResponse<?> buildSuccessResponse(Object data, String path, HttpStatusCode status) {
        ApiResponse.Meta meta = ApiResponse.Meta.builder()
                .timestamp(Instant.now().toString())
                .path(path)
                .requestId(UUID.randomUUID().toString().substring(0, 10))
                .status(status.value())
                .build();

        return ApiResponse.builder()
                .meta(meta)
                .data(data)
                .build();
    }
}
Consideraciones Técnicas
- Performance:
DataBufferUtils.join()carga todo en memoria; para respuestas muy grandes, conviene evaluar streaming JSON. - Idempotencia: el filtro detecta si ya existe
"meta"para evitar doble envoltura. - Trazabilidad distribuida:
requestIdpuede integrarse con Spring Cloud Sleuth o MDC para correlacionar logs entre microservicios.
Pruebas: Validando Comportamiento y Robustez
Con @WebFluxTest podemos probar controladores y filtros en un entorno aislado.
package com.app247.api.shared.response_wrapper.filter;

import com.app247.api.shared.response_wrapper.config.ResponseWrapperProperties;
import com.app247.api.shared.response_wrapper.model.ApiResponse;
import com.fasterxml.jackson.databind.ObjectMapper;
import lombok.AllArgsConstructor;
import lombok.Data;
import lombok.NoArgsConstructor;
import org.junit.jupiter.api.BeforeEach;
import org.junit.jupiter.api.DisplayName;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.autoconfigure.web.reactive.WebFluxTest;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.context.annotation.Import;
import org.springframework.http.HttpStatus;
import org.springframework.http.MediaType;
import org.springframework.test.context.bean.override.mockito.MockitoBean;
import org.springframework.test.web.reactive.server.WebTestClient;
import org.springframework.util.AntPathMatcher;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;
import reactor.core.publisher.Flux;
import reactor.core.publisher.Mono;

import java.time.Instant;
import java.util.Collections;
import java.util.List;
import java.util.Map;

import static org.mockito.Mockito.when;

/**
 * Pruebas de integración para el ResponseWrapperFilter.
 * Valida que las respuestas exitosas se envuelvan y que las de error o excluidas se ignoren.
 */
@WebFluxTest
@Import(ResponseWrapperFilterTest.TestConfig.class)
class ResponseWrapperFilterTest {

    @Autowired
    private WebTestClient webTestClient;

    @MockitoBean
    private ResponseWrapperProperties responseWrapperProperties;

    @BeforeEach
    void setUp() {
        when(responseWrapperProperties.isEnabled()).thenReturn(true);
        when(responseWrapperProperties.getExcludedPaths()).thenReturn(List.of("/excluded/**"));
    }

    @Test
    @DisplayName("Debería envolver una respuesta Mono exitosa en ApiResponse")
    void shouldWrapSuccessfulMonoResponse() {
        webTestClient.get().uri("/test/mono")
                .exchange()
                .expectStatus().isOk()
                .expectHeader().contentType(MediaType.APPLICATION_JSON)
                .expectBody()
                .jsonPath("$.meta").exists()
                .jsonPath("$.meta.status").isEqualTo(200)
                .jsonPath("$.meta.path").isEqualTo("/test/mono")
                .jsonPath("$.data").exists()
                .jsonPath("$.data.id").isEqualTo(1)
                .jsonPath("$.data.name").isEqualTo("Test Mono");
    }

    @Test
    @DisplayName("Debería envolver una respuesta Flux exitosa en ApiResponse con una lista")
    void shouldWrapSuccessfulFluxResponse() {
        webTestClient.get().uri("/test/flux")
                .exchange()
                .expectStatus().isOk()
                .expectHeader().contentType(MediaType.APPLICATION_JSON)
                .expectBody()
                .jsonPath("$.meta").exists()
                .jsonPath("$.meta.status").isEqualTo(200)
                .jsonPath("$.data").isArray()
                .jsonPath("$.data[0].id").isEqualTo(1)
                .jsonPath("$.data[0].name").isEqualTo("Test Flux 1")
                .jsonPath("$.data[1].id").isEqualTo(2)
                .jsonPath("$.data[1].name").isEqualTo("Test Flux 2");
    }

    @Test
    @DisplayName("No debería envolver una respuesta de una ruta excluida")
    void shouldNotWrapExcludedPath() {
        webTestClient.get().uri("/excluded/path")
                .exchange()
                .expectStatus().isOk()
                .expectHeader().contentType(MediaType.APPLICATION_JSON)
                .expectBody()
                .jsonPath("$.meta").doesNotExist()
                .jsonPath("$.data").doesNotExist()
                .jsonPath("$.id").isEqualTo(99)
                .jsonPath("$.name").isEqualTo("Excluded");
    }

    @Test
    @DisplayName("No debería envolver una respuesta de error (ej: 400 Bad Request)")
    void shouldNotWrapErrorResponse() {
        webTestClient.get().uri("/test/error")
                .exchange()
                .expectStatus().isBadRequest()
                .expectHeader().contentType(MediaType.APPLICATION_JSON)
                .expectBody()
                .jsonPath("$.meta").exists()
                .jsonPath("$.errors").exists()
                .jsonPath("$.errors[0].code").isEqualTo("400-CUSTOM-ERROR")
                .jsonPath("$.data").doesNotExist();
    }

    @Test
    @DisplayName("No debería envolver una respuesta que ya tiene el formato ApiResponse")
    void shouldNotDoubleWrapAlreadyFormattedResponse() {
        webTestClient.get().uri("/test/pre-wrapped")
                .exchange()
                .expectStatus().isOk()
                .expectHeader().contentType(MediaType.APPLICATION_JSON)
                .expectBody()
                .jsonPath("$.meta").exists()
                .jsonPath("$.meta.status").isEqualTo(200)
                .jsonPath("$.data.message").isEqualTo("This is already wrapped")
                .jsonPath("$.data.meta").doesNotExist(); // La comprobación clave: no hay un 'meta' dentro del 'data'.
    }

    @Test
    @DisplayName("Debería devolver un error 500 estándar si la serialización del framework falla")
    void shouldReturnStandard500ErrorOnFrameworkSerializationFailure() {
        webTestClient.get().uri("/test/unserializable")
                .exchange()
                // 1. Aserción clave: el estado DEBE ser 500 Internal Server Error.
                .expectHeader().contentType(MediaType.APPLICATION_JSON)
                .expectBody()
                // 2. Aserciones sobre el cuerpo de error estándar de Spring Boot.
                //    Este cuerpo NO es el original, sino el generado por el manejador de errores de Spring.
                .jsonPath("$.status").isEqualTo(500)
                .jsonPath("$.error").isEqualTo("Internal Server Error")
                .jsonPath("$.path").isEqualTo("/test/unserializable")
                // 3. Confirmamos que no hay rastro del cuerpo original ni de nuestra envoltura personalizada.
                .jsonPath("$.meta").doesNotExist()
                .jsonPath("$.data").doesNotExist()
                .jsonPath("$.id").doesNotExist();
    }


    // --- CONFIGURACIÓN INTERNA Y COMPONENTES DE PRUEBA ---

    @Data
    @NoArgsConstructor
    @AllArgsConstructor
    static class TestDto {
        private int id;
        private String name;
    }

    // DTO diseñado para fallar durante la serialización de Jackson debido a una referencia circular.
    @Data
    static class UnserializableDto {
        private int id = 123;
        private Object problematicField = this;
    }

    @RestController
    static class TestController {
        @GetMapping("/test/mono")
        Mono<TestDto> getMono() {
            return Mono.just(new TestDto(1, "Test Mono"));
        }

        @GetMapping("/test/flux")
        Flux<TestDto> getFlux() {
            return Flux.just(new TestDto(1, "Test Flux 1"), new TestDto(2, "Test Flux 2"));
        }

        @GetMapping("/excluded/path")
        Mono<TestDto> getExcluded() {
            return Mono.just(new TestDto(99, "Excluded"));
        }

        @GetMapping("/test/error")
        Mono<TestDto> getError() {
            return Mono.error(new BusinessException("Error forzado", "400-CUSTOM-ERROR"));
        }

        @GetMapping("/test/pre-wrapped")
        Mono<ApiResponse<Map<String, String>>> getPreWrappedResponse() {
            ApiResponse.Meta meta = ApiResponse.Meta.builder().status(200).build();
            Map<String, String> data = Collections.singletonMap("message", "This is already wrapped");
            return Mono.just(ApiResponse.<Map<String, String>>builder().meta(meta).data(data).build());
        }

        @GetMapping("/test/unserializable")
        Mono<UnserializableDto> getUnserializableObject() {
            return Mono.just(new UnserializableDto());
        }
    }

    static class BusinessException extends RuntimeException {
        private final String errorCode;
        public BusinessException(String message, String errorCode) {
            super(message);
            this.errorCode = errorCode;
        }
        public String getErrorCode() {
            return errorCode;
        }
    }

    @org.springframework.web.bind.annotation.RestControllerAdvice
    static class TestGlobalExceptionHandler {
        @org.springframework.web.bind.annotation.ExceptionHandler(BusinessException.class)
        @org.springframework.web.bind.annotation.ResponseStatus(HttpStatus.BAD_REQUEST)
        public Mono<Map<String, Object>> handleBusinessException(BusinessException ex) {
            Map<String, String> error = Map.of("code", ex.getErrorCode(), "message", ex.getMessage());
            Map<String, Object> meta = Map.of("timestamp", Instant.now().toString());
            return Mono.just(Map.of("meta", meta, "errors", List.of(error)));
        }
    }

    @Configuration
    static class TestConfig {
        @Bean
        public ObjectMapper objectMapper() {
            return new ObjectMapper();
        }

        @Bean
        public AntPathMatcher antPathMatcher() {
            return new AntPathMatcher();
        }

        @Bean
        public TestGlobalExceptionHandler testGlobalExceptionHandler() {
            return new TestGlobalExceptionHandler();
        }

        @Bean
        public ResponseWrapperFilter responseWrapperFilter(
                ResponseWrapperProperties properties, ObjectMapper objectMapper
        ) {
            return new ResponseWrapperFilter(properties, objectMapper);
        }

        @Bean
        public TestController testController() {
            return new TestController();
        }
    }
}
Podemos extender las pruebas con StepVerifier para validar que el flujo sigue siendo reactivo y no introduce bloqueos inesperados.
Próximos Pasos y Extensiones
La solución presentada puede evolucionar hacia:
- Trazabilidad distribuida: Propagando
requestIdcon Spring Cloud Sleuth, Zipkin o Jaeger. - Internacionalización: Soporte para mensajes localizados en errores o advertencias.
- Observabilidad avanzada: Tiempo de procesamiento en
meta, integración con Prometheus o Grafana. - Functional Endpoints: Adaptando la solución a APIs basadas en
RouterFunctionen lugar de anotaciones tradicionales.
Con esta base, la envoltura de respuestas deja de ser solo un detalle de formato y se convierte en una capa estratégica para consistencia, trazabilidad y mantenimiento a largo plazo.
Más Allá del `try-catch`: Diseñando un Sistema de Excepciones Robusto y Escalable 🎯
- Mauricio ECR
- Snippets
- 28 Aug, 2025
En el desarrollo de APIs, el manejo de errores suele ser un ciudadano de segunda clase. Con frecuencia, nos conformamos con respuestas de error genéricas, inconsistentes o, en el peor de los casos, co
Más Allá del `try-catch`: Diseñando un Sistema de Excepciones Robusto y Escalable 🎯
- Mauricio ECR
- Snippets
- 28 Aug, 2025
En el desarrollo de APIs, el manejo de errores suele ser un ciudadano de segunda clase. Con frecuencia, nos conformamos con respuestas de error genéricas, inconsistentes o, en el peor de los casos, con trazas de stack trace en HTML que no aportan valor al consumidor de la API. Un buen contrato de API no solo define las rutas de éxito, sino que también establece un lenguaje claro y predecible para cuando las cosas van mal.
El objetivo de este artículo es construir, paso a paso, una estrategia de manejo de excepciones que sea robusta, escalable y centralizada. Dejaremos atrás los bloques try-catch dispersos por el código de negocio para dar paso a un sistema que produce respuestas JSON consistentes y enriquecidas para cualquier tipo de error, ya sea una validación de negocio, un recurso no encontrado o un fallo inesperado del sistema. Para ello, nos apoyaremos en principios de diseño sólidos como el Patrón Strategy, el Principio de Abierto/Cerrado y un enfoque que mantiene nuestro dominio limpio de preocupaciones de infraestructura.
Definiendo un Lenguaje Común para el Error
Antes de manejar cualquier error, debemos definir cómo queremos comunicarlo. En lugar de depender de estructuras volátiles como Map<String, Object>, estableceremos un contrato sólido mediante Data Transfer Objects (DTOs). Esto nos proporciona seguridad de tipos, autocompletado en el IDE y una excelente base para la documentación automática con herramientas como OpenAPI.
Nuestra estructura de respuesta de error estándar será la siguiente:
{
  "meta": {
    "timestamp": "2025-08-28T19:12:58.123Z",
    "path": "/api/users",
    "status": 409,
    "requestId": "a1b2c3d4e5"
  },
  "errors": [
    {
      "code": "409-001",
      "message": "EMAIL ALREADY EXISTS",
      "payload": {
        "email": "[email protected]"
      }
    }
  ]
}
Para modelar esto, definimos tres clases principales. ApiErrorResponse es el contenedor principal, que incluye una sección de metadatos (Meta) y una lista de errores. El ApiError en sí mismo es flexible, con un código, un mensaje y un payload opcional para datos contextuales.
// Modelo de respuesta genérico y estandarizado
@Data
@Builder
public class ApiErrorResponse<T> {
    private Meta meta;
    private List<T> errors;

    @Data
    @Builder
    public static class Meta {
        private String timestamp;
        private String path;
        private int status;
        private String requestId;
    }
}
// DTO que representa un único error de la API
@JsonInclude(JsonInclude.Include.NON_NULL)
public record ApiError(String code, String message, Object payload) {
    public ApiError(String code, String message) {
        this(code, message, null);
    }
}
Finalmente, un pequeño DTO para encapsular el contexto de la petición que se pasará a través de nuestro sistema.
// Encapsula la información del contexto de la request
@Data
@Builder
public class RequestContextApi {
    private String path;
    private String requestId;
}
Manteniendo el Dominio Puro: La BusinessException
Una de las claves de una buena arquitectura es la separación de conceptos. La lógica de negocio no debería saber nada sobre códigos de estado HTTP o la estructura de una respuesta JSON. Para lograrlo, definimos una excepción base para nuestro dominio, BusinessException.
Esta clase abstracta es simple pero poderosa. Contiene un errorCode único para la aplicación y un payload opcional. Cualquier excepción de negocio específica (ej. InsufficientFundsException) heredará de ella, manteniendo el dominio completamente agnóstico a la tecnología.
@Getter
public abstract class BusinessException extends RuntimeException {

    private final String errorCode;
    private final Object payload;

    protected BusinessException(String message, String errorCode, Object payload) {
        super((message != null) ? message.toUpperCase() : "");
        this.errorCode = errorCode;
        this.payload = payload;
    }

    protected BusinessException(String message, String errorCode) {
        super((message != null) ? message.toUpperCase() : "");
        this.errorCode = errorCode;
        this.payload = null;
    }
}
El Cerebro de la Operación: El Patrón Strategy
Con los modelos definidos, es hora de diseñar el mecanismo central. En lugar de un gran bloque if-else o un switch para manejar diferentes tipos de excepciones, utilizaremos el Patrón Strategy. Esto nos permitirá encapsular la lógica para manejar cada tipo de excepción en su propia clase, haciendo el sistema increíblemente fácil de extender.
La piedra angular es la interfaz ExceptionHandlerStrategy. Define un contrato que cada manejador debe cumplir:
supports(Class<? extends Throwable> exceptionType): Determina si el manejador es capaz de procesar un tipo de excepción dado.getStatus(Throwable ex): Define elHttpStatusque corresponde a la excepción. Esto nos permite devolver códigos más precisos que un simple 400 o 500.handle(Throwable ex, ...): El método que procesa la excepción. Lo interesante aquí es que proveemos una implementacióndefaultque cubre los casos más comunes, de modo que muchos de nuestros manejadores serán puramente declarativos.
public interface ExceptionHandlerStrategy {

    boolean supports(Class<? extends Throwable> exceptionType);

    default HttpStatus getStatus(Throwable ex) {
        return HttpStatus.INTERNAL_SERVER_ERROR;
    }

    default ResponseEntity<ApiErrorResponse<?>> handle(Throwable ex, RequestContextApi context) {
        HttpStatus status = getStatus(ex);
        Object error = new ApiError(String.valueOf(status.value()), "INTERNAL_SERVER_ERROR");
        return buildErrorResponse(status, context, (error instanceof List<?>) ? (List<?>) error : List.of(error));
    }

    static ResponseEntity<ApiErrorResponse<?>> buildErrorResponse(
            HttpStatus status, RequestContextApi context, List<?> errors) {
        // ... Lógica para construir la respuesta final ...
    }
}
Estrategias en Acción: El Manejador Específico y el Genérico
Con la interfaz lista, crear manejadores es trivial. Para nuestras BusinessException, creamos un BusinessExceptionHandler. Este manejador sobreescribe getStatus para implementar una lógica ingeniosa que deriva el código de estado HTTP a partir del errorCode de la excepción (ej. "409-001" se convierte en HttpStatus.CONFLICT). También sobreescribe handle para asegurarse de que el payload se incluya en la respuesta.
@Component
public class BusinessExceptionHandler implements ExceptionHandlerStrategy {

    @Override
    public boolean supports(Class<? extends Throwable> exceptionType) {
        return BusinessException.class.isAssignableFrom(exceptionType);
    }

    @Override
    public HttpStatus getStatus(Throwable ex) {
        BusinessException businessException = (BusinessException) ex;
        String codeHttp = businessException.getErrorCode().split("-")[0];
        try {
            int codigo = Integer.parseInt(codeHttp);
            return HttpStatus.valueOf(codigo);
        } catch (Exception e) {
            return HttpStatus.BAD_REQUEST;
        }
    }

    @Override
    public ResponseEntity<ApiErrorResponse<?>> handle(Throwable ex, RequestContextApi context) {
        BusinessException exception = (BusinessException) ex;
        HttpStatus status = getStatus(exception);
        Object error = new ApiError(exception.getErrorCode(), exception.getMessage(), exception.getPayload());
        return ExceptionHandlerStrategy.buildErrorResponse(status, context, (error instanceof List<?>) ? (List<?>) error : List.of(error));
    }
}
Para cualquier otra excepción no controlada, tenemos el GenericExceptionStrategyHandler. Gracias a la anotación @Order(Ordered.LOWEST_PRECEDENCE) de Spring, esta estrategia solo se ejecutará si ninguna otra más específica puede manejar la excepción. Es nuestra red de seguridad, y gracias a la implementación default de la interfaz, su código es mínimo.
@Component
@Order(Ordered.LOWEST_PRECEDENCE)
public class GenericExceptionStrategyHandler implements ExceptionHandlerStrategy {

    @Override
    public boolean supports(Class<? extends Throwable> exceptionType) {
        return true;
    }
}
El Orquestador: Poniendo Todo en Marcha
Las estrategias individuales son útiles, pero necesitamos un director de orquesta. Aquí es donde entran el GlobalExceptionHandlerStrategyRegistry y el GlobalExceptionTranslator.
El Registry es una clase simple que se inyecta con una lista de todas las implementaciones de ExceptionHandlerStrategy disponibles en el contexto de Spring. Su única misión es iterar sobre ellas (respetando el @Order) y delegar el control a la primera que declare que puede manejar la excepción.
@Component
public class GlobalExceptionHandlerStrategyRegistry {

    private final List<ExceptionHandlerStrategy> strategies;

    public GlobalExceptionHandlerStrategyRegistry(List<ExceptionHandlerStrategy> strategies) {
        this.strategies = strategies;
    }

    public ResponseEntity<ApiErrorResponse<?>> handle(Throwable ex, RequestContextApi context) {
        return strategies.stream()
                .filter(s -> s.supports(ex.getClass()))
                .findFirst()
                .map(s -> s.handle(ex, context))
                .orElseThrow(() -> new IllegalStateException("No suitable exception handler found.", ex));
    }
}
Finalmente, el Translator es el punto de entrada. Es una clase anotada con @RestControllerAdvice que captura cualquier Throwable que escape de nuestros controladores. Su responsabilidad es mínima y crucial: crear el RequestContextApi y pasarle la excepción al Registry. No contiene ninguna lógica de negocio, lo que lo mantiene limpio y enfocado.
@RestControllerAdvice
@RequiredArgsConstructor
public class GlobalExceptionTranslator {

    private final GlobalExceptionHandlerStrategyRegistry registry;

    @ExceptionHandler(Throwable.class)
    public final ResponseEntity<ApiErrorResponse<?>> handleAnyException(
            Throwable ex, ServerWebExchange exchange) {

        RequestContextApi context = RequestContextApi.builder()
                .path(exchange.getRequest().getURI().getPath())
                .requestId(UUID.randomUUID().toString().substring(0, 10))
                .build();

        return registry.handle(ex, context);
    }
}
Con todas las piezas en su lugar, podemos visualizar la arquitectura completa y el flujo de una excepción a través de nuestro sistema. El siguiente diagrama ilustra cómo estos componentes colaboran, desde la captura inicial hasta la selección de la estrategia adecuada y la construcción de la respuesta final.

codigo mermaid
        classDiagram
            class DatabaseConnectionPool {
                -DatabaseEngineFactory engineFactory
                +dataSourceFromSecret(String, DatabaseConnectionPropertiesFactory) DataSource
            }
            class DatabaseConnectionPropertiesFactory {
                -GenericManager secretsManager
                +getDatabaseConnectionProperties(String) DatabaseConnectionProperties
            }
            class DatabaseConnectionProperties {
                -String dbname
                -String username
                -String password
                -String engine
                ...
            }
            class DatabaseEngineFactory {
                -Map~String, DatabaseEngineStrategy~ strategies
                +getStrategy(String) DatabaseEngineStrategy
            }
            class DatabaseEngineStrategy {
                <>
                +getName() String
                +buildJdbcUrl(...) String
                +getValidationQuery() String
            }
            class PostgresqlStrategy {
                +getName() String
                ...
            }
            class MysqlStrategy {
                +getName() String
                ...
            }
            DatabaseConnectionPool ..> DatabaseConnectionPropertiesFactory : uses
            DatabaseConnectionPool ..> DatabaseEngineFactory : uses
            DatabaseConnectionPropertiesFactory ..> DatabaseConnectionProperties : creates
            DatabaseEngineFactory ..> DatabaseEngineStrategy : uses
            PostgresqlStrategy --|> DatabaseEngineStrategy : implements
            MysqlStrategy --|> DatabaseEngineStrategy : implements
Conclusión y Futuras Mejoras
Hemos construido un sistema de manejo de excepciones que es a la vez potente y elegante. Todas las respuestas de error de nuestra API son ahora consistentes, informativas y se generan a través de un flujo centralizado y predecible. La belleza de este diseño radica en su escalabilidad: añadir soporte para un nuevo tipo de excepción es tan simple como crear una nueva clase Strategy, sin necesidad de modificar el código existente, adhiriéndonos así al Principio de Abierto/Cerrado.
Este sistema, sin embargo, es una base sólida sobre la cual se puede seguir construyendo. Algunas líneas futuras de mejora podrían incluir:
- Integración con Logging: Centralizar el registro de las excepciones completas dentro de los manejadores para un monitoreo más efectivo.
- Internacionalización (i18n): Modificar el
ApiErrory los manejadores para que puedan devolver mensajes de error en diferentes idiomas según las cabeceras de la petición. - Manejadores Específicos de Framework: Crear estrategias para excepciones comunes de frameworks como Spring Security (ej.
AccessDeniedException) para traducirlas a respuestas403 Forbiddencon un formato consistente.
Transacciones Declarativas en Arquitecturas Hexagonales con Spring WebFlux y AOP
- Mauricio ECR
- Snippets
- 27 Aug, 2025
En el desarrollo de aplicaciones reactivas modernas, especialmente bajo paradigmas como la Arquitectura Hexagonal, surgen desafíos que nos obligan a repensar cómo aplicamos conceptos transversales. Un
Transacciones Declarativas en Arquitecturas Hexagonales con Spring WebFlux y AOP
- Mauricio ECR
- Snippets
- 27 Aug, 2025
En el desarrollo de aplicaciones reactivas modernas, especialmente bajo paradigmas como la Arquitectura Hexagonal, surgen desafíos que nos obligan a repensar cómo aplicamos conceptos transversales. Uno de los interrogantes más comunes es: ¿dónde y cómo gestionamos las transacciones de base de datos sin contaminar nuestra lógica de negocio? Este artículo documenta un viaje desde esa pregunta inicial hasta una solución robusta y elegante, utilizando el poder de la Programación Orientada a Aspectos (AOP) en un entorno Spring WebFlux con R2DBC.
La Arquitectura como Punto de Partida
Antes de sumergirnos en el código, es fundamental visualizar la estructura del proyecto. Una organización clara de paquetes, que refleje las capas de la Arquitectura Hexagonal, es la base sobre la que construiremos nuestra solución. El dominio permanece en el centro, puro y sin dependencias externas, mientras que la aplicación y la infraestructura se organizan a su alrededor.
ms_auth/
├── applications/app-service/      # Módulo principal de la aplicación Spring Boot
│   ├── build.gradle
│   └── src/
│       ├── main/java/com/app247/
│       │   ├── MainApplication.java
│       │   └── config/aop/
│       │       └── TransactionalUseCaseAspect.java  # Nuestro Aspecto AOP
│       └── test/java/com/app247/config/aop/
│           ├── TransactionalUseCaseAspectTest.java  # Test unitario del Aspecto
│           └── TransactionalRollbackSelfContainedTest.java # Test de Integración
│
├── domain/
│   ├── model/
│   └── usecase/                     # Módulo de la lógica de negocio pura
│       └── src/main/java/com/app247/usecase/shared/core/usecase/
│           ├── TransactionalWrapperUseCase.java # Anotación personalizada
│           └── UseCase.java                     # Interfaz genérica
│
└── infrastructure/
    ├── r2dbc-postgresql/          # Módulo adaptador para la base de datos
    └── reactive-web/              # Módulo adaptador para los controladores REST
El Dilema Inicial: La Transacción y la Unidad de Trabajo
Todo comienza con una necesidad fundamental: asegurar la atomicidad de las operaciones. Imaginemos un caso de uso de negocio, como procesar una compra, que implica modificar el inventario de productos y crear un registro de orden. Ambas acciones deben tener éxito, o ninguna debe persistir. Esta es la definición de una unidad de trabajo, y la herramienta para garantizarla es la transacción.
La primera intuición podría ser colocar la anotación @Transactional de Spring en los métodos del repositorio. Sin embargo, esto es incorrecto. Una transacción en el repositorio solo cubriría una única operación de base de datos, rompiendo la unidad de trabajo del negocio. La transacción debe envolver la ejecución completa del caso de uso.
Esto nos lleva a la capa de servicio o caso de uso. Pero aquí nos encontramos con el primer gran obstáculo arquitectónico. En una Arquitectura Hexagonal, la capa de dominio (donde residen los casos de uso) debe ser pura. No puede, ni debe, tener dependencias de frameworks externos como Spring. Anotar un caso de uso del dominio con @Transactional viola este principio fundamental, acoplando nuestra lógica de negocio más preciada a un detalle de infraestructura.
La Solución Emerge: Programación Orientada a Aspectos
Si no podemos modificar el dominio, debemos aplicar el comportamiento transaccional desde afuera, de una manera no invasiva. Aquí es donde la Programación Orientada a Aspectos (AOP) brilla. AOP nos permite interceptar la ejecución de nuestros métodos para añadir funcionalidades transversales (como transacciones, seguridad o logging) sin alterar el código original.
La estrategia que emerge es crear un mecanismo declarativo y reutilizable que nos permita "marcar" qué casos de uso deben ser transaccionales, dejando que la magia de AOP haga el resto.
Una Anotación para Declarar la Intención
El primer paso es crear una anotación personalizada. Su único propósito es servir como una señal o marcador. Al ser parte de nuestro código de dominio (usecase), no introduce una dependencia directa de Spring, sino que define un contrato interno.
package com.app247.usecase.shared.core.usecase;

import java.lang.annotation.ElementType;
import java.lang.annotation.Retention;
import java.lang.annotation.RetentionPolicy;
import java.lang.annotation.Target;

/**
 * Anotación para marcar clases de Casos de Uso que deben ser
 * envueltas en una transacción reactiva de forma automática.
 */
@Target(ElementType.TYPE) // Se aplica a nivel de clase
@Retention(RetentionPolicy.RUNTIME) // Disponible en tiempo de ejecución para que Spring la lea
public @interface TransactionalWrapperUseCase {
}
Junto a esta, podemos definir una interfaz genérica para estandarizar nuestros casos de uso, promoviendo un diseño limpio y consistente.
package com.app247.usecase.shared.core.usecase;

// Interfaz genérica (opcional pero recomendada)
public interface UseCase<Request, Response> {
    Response execute(Request request);
}
El Aspecto: El Motor de la Transacción
Con la anotación en su lugar, construimos el componente que buscará esta marca y aplicará la lógica transaccional. Este es nuestro Aspecto, una clase de infraestructura que vive en la capa de aplicación.
Este Aspecto tiene dos partes clave:
- Pointcut: Una expresión que actúa como un selector. Le dice a Spring: "Encuentra todos los métodos públicos en cualquier clase que esté anotada con
@TransactionalWrapperUseCase". - Advice: La lógica que se ejecuta cuando el Pointcut encuentra una coincidencia. Usaremos un
advicede tipo@Around, que nos permite envolver completamente la ejecución del método original.
La lógica del advice es simple pero poderosa: toma el Mono o Flux devuelto por el caso de uso y lo compone con el TransactionalOperator reactivo de Spring. Este operador se encarga de iniciar la transacción antes de la suscripción y de realizar commit o rollback al finalizar.
package com.app247.config.aop;

import org.aspectj.lang.ProceedingJoinPoint;
import org.aspectj.lang.annotation.Around;
import org.aspectj.lang.annotation.Aspect;
import org.aspectj.lang.annotation.Pointcut;
import org.springframework.stereotype.Component;
import org.springframework.transaction.reactive.TransactionalOperator;
import reactor.core.publisher.Flux;
import reactor.core.publisher.Mono;

@Aspect
@Component
public class TransactionalUseCaseAspect {

    private final TransactionalOperator transactionalOperator;

    public TransactionalUseCaseAspect(TransactionalOperator transactionalOperator) {
        this.transactionalOperator = transactionalOperator;
    }

    @Pointcut("@within(com.app247.usecase.shared.core.usecase.TransactionalWrapperUseCase) && execution(public * *(..))")
    public void transactionalUseCase() {
        // Método vacío para nombrar el pointcut.
    }

    @Around("transactionalUseCase()")
    public Object wrapInTransaction(ProceedingJoinPoint joinPoint) throws Throwable {
        Object result = joinPoint.proceed();

        if (result instanceof Mono) {
            return ((Mono<?>) result).as(transactionalOperator::transactional);
        } else if (result instanceof Flux) {
            return ((Flux<?>) result).as(transactionalOperator::transactional);
        }

        return result;
    }
}
Con estos dos elementos, hemos creado un sistema donde simplemente anotando una clase de caso de uso con @TransactionalWrapperUseCase, garantizamos que su ejecución será atómica, sin haber escrito una sola línea de código transaccional dentro del propio caso de uso.
Probando la Solución: De la Confianza a la Certeza
Una solución no está completa hasta que se prueba rigurosamente. Para este mecanismo, necesitamos dos niveles de prueba para tener una confianza total.
Nivel 1: El Test de Cableado (Unitario)
El primer test debe responder a la pregunta: ¿Nuestro aspecto AOP está correctamente configurado para interceptar la llamada y usar el TransactionalOperator? Este test valida tanto respuestas Mono como Flux.
Este test no necesita una base de datos. Utiliza un contexto de Spring para activar el mecanismo AOP, pero reemplaza todas las dependencias externas (TransactionalOperator, repositorios) con Mocks. El objetivo no es probar el rollback, sino verificar la interacción: que el método transactional() del operador sea invocado.
package com.app247.config.aop;

import com.app247.usecase.shared.core.usecase.TransactionalWrapperUseCase;
import org.junit.jupiter.api.Test;
import org.mockito.InjectMocks;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.context.annotation.EnableAspectJAutoProxy;
import org.springframework.context.annotation.Import;
import org.springframework.test.context.bean.override.mockito.MockitoBean;
import org.springframework.transaction.reactive.TransactionalOperator;
import reactor.core.publisher.Flux;
import reactor.core.publisher.Mono;
import reactor.test.StepVerifier;

import static org.assertj.core.api.AssertionsForClassTypes.assertThat;
import static org.junit.jupiter.api.Assertions.assertDoesNotThrow;
import static org.mockito.ArgumentMatchers.any;
import static org.mockito.Mockito.*;


@SpringBootTest(classes = TransactionalUseCaseAspectTest.TestConfig.class)
class TransactionalUseCaseAspectTest {

    @Autowired
    private PurchaseProductUseCasePort purchaseUseCase;
    @Autowired
    private FindProductsUseCasePort findProductsUseCase; // Caso de uso que devuelve Flux
    @Autowired
    private NonReactiveUseCasePort nonReactiveUseCase;

    @MockitoBean
    private ProductRepository productRepository;
    @MockitoBean
    private OrderRepository orderRepository;
    @MockitoBean
    private TransactionalOperator transactionalOperator;
    @InjectMocks
    private TransactionalUseCaseAspect transactionalUseCaseAspect;

    @Test
    void whenUseCaseReturnsMono_thenItShouldBeWrappedInTransaction() {
        // ARRANGE
        Product fakeProduct = new Product("prod-123", 10);
        Order fakeOrder = new Order("user-007", "prod-123");

        when(productRepository.findById(any())).thenReturn(Mono.just(fakeProduct));
        when(orderRepository.save(any())).thenReturn(Mono.just(fakeOrder));
        when(productRepository.updateStock(any(), any(Integer.class))).thenReturn(Mono.empty());
        when(transactionalOperator.transactional(any(Mono.class)))
                .thenAnswer(invocation -> invocation.getArgument(0));

        // ACT
        Mono<Order> result = purchaseUseCase.execute("user-007", "prod-123");

        // ASSERT
        StepVerifier.create(result).expectNext(fakeOrder).verifyComplete();
        verify(transactionalOperator).transactional(any(Mono.class));
        verify(productRepository).updateStock("prod-123", 9);
    }

    @Test
    void whenUseCaseReturnsFlux_thenItShouldBeWrappedInTransaction() {
        // ARRANGE
        Product fakeProduct1 = new Product("prod-001", 5);
        Product fakeProduct2 = new Product("prod-002", 3);

        when(productRepository.findAll()).thenReturn(Flux.just(fakeProduct1, fakeProduct2));
        // Configuramos el mock para que el operador transaccional simplemente devuelva el Flux original
        when(transactionalOperator.transactional(any(Flux.class)))
                .thenAnswer(invocation -> invocation.getArgument(0));

        // ACT
        Flux<Product> result = findProductsUseCase.execute(null); // `null` porque no requiere parámetros

        // ASSERT
        StepVerifier.create(result)
                .expectNext(fakeProduct1)
                .expectNext(fakeProduct2)
                .verifyComplete();

        // La verificación clave: ¿Se llamó al operador con un Flux?
        verify(transactionalOperator).transactional(any(Flux.class));
    }

    /**
     * Test para el caso no reactivo.
     */
    @Test
    void whenUseCaseIsNotReactive_thenItShouldNotBeWrappedInTransaction() {
        // --- ARRANGE (Preparar) ---
        String expectedResult = "Este es un resultado síncrono";

        // --- ACT (Actuar) ---
        // Ejecutamos el caso de uso que devuelve un String simple.
        String actualResult = nonReactiveUseCase.execute(null);

        // --- ASSERT (Verificar) ---

        // 1. Verificamos que el resultado devuelto es el original, sin cambios.
        assertThat(actualResult).isEqualTo(expectedResult);

        // 2. La verificación MÁS IMPORTANTE: nos aseguramos de que el operador transaccional
        //    NUNCA fue invocado, ya que la respuesta no era ni Mono ni Flux.
        verify(transactionalOperator, never()).transactional(any(Mono.class));
        verify(transactionalOperator, never()).transactional(any(Flux.class));
    }

    @Test
    void transactionalUseCasePointcut_shouldExecuteForCoverage() {
        // --- ACT ---
        // Simplemente llamamos al método vacío.
        // La herramienta de cobertura registrará que se ha entrado en este método.

        // --- ASSERT ---
        // Como el método no hace nada, la única aserción posible es
        // que la llamada no lance ninguna excepción.
        assertDoesNotThrow(() -> {
            transactionalUseCaseAspect.transactionalUseCase();
        });
    }


    @Configuration
    @EnableAspectJAutoProxy
    @Import(TransactionalUseCaseAspect.class)
    static class TestConfig {
        @Bean
        public PurchaseProductUseCasePort purchaseProductUseCase(ProductRepository productRepo, OrderRepository orderRepo) {
            return new PurchaseProductUseCase(productRepo, orderRepo);
        }

        @Bean
        public FindProductsUseCasePort findProductsUseCase(ProductRepository productRepo) {
            return new FindProductsUseCase(productRepo);
        }
        @Bean
        public NonReactiveUseCasePort nonReactiveUseCase() {
            return new NonReactiveUseCase();
        }
    }

    // --- Definiciones Fakes ---
    record Product(String id, int stock) {}
    record Order(String userId, String productId) {}

    interface ProductRepository {
        Mono<Product> findById(String productId);
        Flux<Product> findAll(); // Añadido para el test de Flux
        Mono<Void> updateStock(String productId, int newStock);
    }
    interface OrderRepository { Mono<Order> save(Order order); }

    interface PurchaseProductUseCasePort { Mono<Order> execute(String userId, String productId); }
    interface FindProductsUseCasePort { Flux<Product> execute(Void request); } // Nuevo caso de uso para Flux

    interface NonReactiveUseCasePort { String execute(Void request); }

    @TransactionalWrapperUseCase
    static class PurchaseProductUseCase implements PurchaseProductUseCasePort {
        private final ProductRepository productRepository;
        private final OrderRepository orderRepository;
        public PurchaseProductUseCase(ProductRepository p, OrderRepository o) { this.productRepository = p; this.orderRepository = o; }
        public Mono<Order> execute(String userId, String productId) {
            return productRepository.findById(productId)
                    .flatMap(product -> productRepository.updateStock(product.id(), product.stock() - 1)
                            .then(orderRepository.save(new Order(userId, productId))));
        }
    }

    @TransactionalWrapperUseCase
    static class FindProductsUseCase implements FindProductsUseCasePort {
        private final ProductRepository productRepository;
        public FindProductsUseCase(ProductRepository p) { this.productRepository = p; }
        public Flux<Product> execute(Void request) {
            return productRepository.findAll();
        }
    }

    @TransactionalWrapperUseCase
    static class NonReactiveUseCase implements NonReactiveUseCasePort {
        @Override
        public String execute(Void request) {
            return "Este es un resultado síncrono";
        }
    }
}
Nivel 2: El Test de Comportamiento (Integración)
El segundo test debe responder a una pregunta más importante: si una operación falla, ¿la transacción realmente hace rollback?
Para esto, necesitamos un test de integración que utilice una base de datos real (en memoria, como H2, para velocidad y aislamiento) y el TransactionalOperator real de Spring. La clave aquí es usar @SpyBean para envolver un repositorio real y forzar un fallo en una de sus operaciones. La validación final consiste en consultar la base de datos después del fallo y verificar que el estado de los datos ha sido revertido a su estado original.
Este test es completamente autocontenido: define su propia configuración, su esquema de base de datos y sus implementaciones de dominio e infraestructura, pero lo más importante es que importa y prueba el Aspecto de AOP de producción real.
package com.app247.config.aop;

import com.app247.usecase.shared.core.usecase.TransactionalWrapperUseCase;
import io.r2dbc.spi.ConnectionFactory;
import org.junit.jupiter.api.BeforeAll;
import org.junit.jupiter.api.BeforeEach;
import org.junit.jupiter.api.Test;
import org.junit.jupiter.api.TestInstance;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.autoconfigure.ImportAutoConfiguration;
import org.springframework.boot.autoconfigure.context.PropertyPlaceholderAutoConfiguration;
import org.springframework.boot.autoconfigure.r2dbc.R2dbcAutoConfiguration;
import org.springframework.boot.autoconfigure.transaction.TransactionAutoConfiguration;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.context.annotation.EnableAspectJAutoProxy;
import org.springframework.context.annotation.Import;
import org.springframework.data.annotation.Id;
import org.springframework.data.r2dbc.core.R2dbcEntityTemplate;
import org.springframework.data.relational.core.mapping.Table;
import org.springframework.r2dbc.connection.R2dbcTransactionManager;
import org.springframework.r2dbc.core.DatabaseClient;
import org.springframework.stereotype.Repository;
import org.springframework.test.annotation.DirtiesContext;
import org.springframework.test.context.TestPropertySource;
import org.springframework.test.context.bean.override.mockito.MockitoSpyBean;
import reactor.core.publisher.Mono;
import reactor.test.StepVerifier;

import static org.assertj.core.api.Assertions.assertThat;
import static org.mockito.ArgumentMatchers.any;
import static org.mockito.Mockito.doReturn;
import static org.springframework.data.relational.core.query.Criteria.where;
import static org.springframework.data.relational.core.query.Query.query;

@SpringBootTest(classes = TransactionalRollbackSelfContainedTest.TestConfig.class)
@ImportAutoConfiguration({
        R2dbcAutoConfiguration.class,
        TransactionAutoConfiguration.class,
        PropertyPlaceholderAutoConfiguration.class
})
@TestPropertySource(properties = {
        "spring.r2dbc.url=r2dbc:h2:mem:///finaltestdb;DB_CLOSE_DELAY=-1;",
        "spring.r2dbc.username=sa",
        "spring.r2dbc.password=",
        "spring.sql.init.mode=never"
})
@DirtiesContext(classMode = DirtiesContext.ClassMode.AFTER_CLASS)
@TestInstance(TestInstance.Lifecycle.PER_CLASS)
class TransactionalRollbackSelfContainedTest {

    @Autowired private PurchaseProductUseCasePort purchaseUseCase;
    @Autowired private DatabaseClient databaseClient;
    @Autowired private R2dbcEntityTemplate template;
    @MockitoSpyBean
    private OrderRepository orderRepository;

    private final String PRODUCT_ID = "prod-123";
    private final int INITIAL_STOCK = 10;

    @BeforeAll
    void setupDatabaseSchema() {
        String createProductsTable = "CREATE TABLE PRODUCTS (id VARCHAR(255) PRIMARY KEY, name VARCHAR(255), stock INT);";
        String createOrdersTable = "CREATE TABLE ORDERS (id INT AUTO_INCREMENT PRIMARY KEY, user_id VARCHAR(255), product_id VARCHAR(255));";
        databaseClient.sql(createProductsTable).then().block();
        databaseClient.sql(createOrdersTable).then().block();
    }

    @BeforeEach
    void setupTestData() {
        databaseClient.sql("DELETE FROM PRODUCTS").then().block();
        template.insert(new ProductEntity(PRODUCT_ID, "Test Product", INITIAL_STOCK)).block();
    }

    @Test
    void whenSecondOperationFails_thenRealAspectRollsBackTransaction() {
        doReturn(Mono.error(new RuntimeException("DB Error"))).when(orderRepository).save(any());
        Mono<Void> result = purchaseUseCase.execute("user-007", PRODUCT_ID);
        StepVerifier.create(result).expectError(RuntimeException.class).verify();
        ProductEntity productAfter = template.selectOne(query(where("id").is(PRODUCT_ID)), ProductEntity.class).block();
        assertThat(productAfter.stock()).isEqualTo(INITIAL_STOCK);
    }

    @Configuration
    @EnableAspectJAutoProxy
    @Import(TransactionalUseCaseAspect.class)
    static class TestConfig {
        @Bean
        public R2dbcEntityTemplate r2dbcEntityTemplate(ConnectionFactory connectionFactory) {
            return new R2dbcEntityTemplate(connectionFactory);
        }

        @Bean
        public R2dbcTransactionManager transactionManager(ConnectionFactory connectionFactory) {
            return new R2dbcTransactionManager(connectionFactory);
        }

        @Bean
        public PurchaseProductUseCasePort purchaseProductUseCase(ProductRepository productRepo, OrderRepository orderRepo) {
            return new PurchaseProductUseCase(productRepo, orderRepo);
        }
        @Bean
        public ProductRepository productRepository(R2dbcEntityTemplate template) {
            return new R2dbcProductRepositoryAdapter(template);
        }
        @Bean
        public OrderRepository orderRepository(R2dbcEntityTemplate template) {
            return new R2dbcOrderRepositoryAdapter(template);
        }
    }

    record Product(String id, int stock) {}
    record Order(String userId, String productId) {}
    interface ProductRepository { Mono<Product> findById(String id); Mono<Void> updateStock(String id, int stock); }
    interface OrderRepository { Mono<Order> save(Order order); }
    interface PurchaseProductUseCasePort { Mono<Void> execute(String userId, String productId); }

    @Table("PRODUCTS")
    record ProductEntity(@Id String id, String name, int stock) {}
    @Table("ORDERS")
    record OrderEntity(@Id Integer id, String userId, String productId) {}

    @Repository
    static class R2dbcProductRepositoryAdapter implements ProductRepository {
        private final R2dbcEntityTemplate template;
        public R2dbcProductRepositoryAdapter(R2dbcEntityTemplate t) { this.template = t; }
        public Mono<Product> findById(String id) { return template.selectOne(query(where("id").is(id)),ProductEntity.class).map(e -> new Product(e.id(), e.stock())); }
        public Mono<Void> updateStock(String id, int stock) { return template.getDatabaseClient().sql("UPDATE PRODUCTS SET stock = :s WHERE id = :i").bind("s", stock).bind("i", id).fetch().rowsUpdated().then(); }
    }
    @Repository
    static class R2dbcOrderRepositoryAdapter implements OrderRepository {
        private final R2dbcEntityTemplate template;
        public R2dbcOrderRepositoryAdapter(R2dbcEntityTemplate t) { this.template = t; }
        public Mono<Order> save(Order o) { return template.insert(new OrderEntity(null, o.userId(), o.productId())).map(e -> o); }
    }

    @TransactionalWrapperUseCase
    static class PurchaseProductUseCase implements PurchaseProductUseCasePort {
        private final ProductRepository pRepo;
        private final OrderRepository oRepo;
        public PurchaseProductUseCase(ProductRepository p, OrderRepository o) { this.pRepo = p; this.oRepo = o; }
        public Mono<Void> execute(String userId, String productId) {
            return pRepo.findById(productId).flatMap(p -> pRepo.updateStock(p.id(), p.stock() - 1)).then(oRepo.save(new Order(userId, productId))).then();
        }
    }
}
Conclusión y Próximos Pasos
Hemos construido una solución completa, limpia y robusta para un problema complejo. Al mantener nuestro dominio puro y delegar las responsabilidades transversales a la capa de aplicación mediante AOP, logramos un código desacoplado, mantenible y altamente testeable. Las dependencias del proyecto reflejan esta arquitectura limpia, utilizando starters de Spring Boot para AOP y R2DBC, y librerías de prueba para H2 y ArchUnit.
// build.gradle
dependencies {
    implementation 'org.reactivecommons.utils:object-mapper:0.1.0'
    implementation project(':r2dbc-postgresql')
    implementation project(':reactive-web')
    implementation project(':model')
    implementation project(':usecase')
    implementation 'org.springframework.boot:spring-boot-starter'
    implementation 'org.springframework.boot:spring-boot-starter-aop'
    implementation 'org.springframework.boot:spring-boot-starter-data-r2dbc'
    runtimeOnly('org.springframework.boot:spring-boot-devtools')
    testImplementation 'com.tngtech.archunit:archunit:1.4.1'
    testImplementation 'com.fasterxml.jackson.core:jackson-databind'
    testImplementation 'com.h2database:h2'
    testImplementation 'io.r2dbc:r2dbc-h2'
}
Este patrón no se limita a las transacciones. El mismo mecanismo de anotación y aspecto puede extenderse para manejar otras responsabilidades, como la autorización de seguridad, la auditoría o el registro de métricas, consolidándose como una base sólida para el desarrollo de futuras funcionalidades en cualquier aplicación reactiva que aspire a una arquitectura limpia y escalable.
El Arte de Conectar: Forjando un DataSource Dinámico en Spring Boot
- Mauricio ECR
- Snippets
- 23 Aug, 2025
En el vertiginoso universo del desarrollo de software, donde la seguridad es un pilar innegociable y la agilidad es la moneda de cambio, nos enfrentamos a desafíos que van más allá de la simple lógica
El Arte de Conectar: Forjando un DataSource Dinámico en Spring Boot
- Mauricio ECR
- Snippets
- 23 Aug, 2025
En el vertiginoso universo del desarrollo de software, donde la seguridad es un pilar innegociable y la agilidad es la moneda de cambio, nos enfrentamos a desafíos que van más allá de la simple lógica de negocio. Uno de los más recurrentes y críticos es la gestión de las conexiones a bases de datos. ¿Cómo construimos un sistema que no solo proteja sus credenciales como si fueran las joyas de la corona, sino que también sea lo suficientemente flexible para "hablar" con distintos motores de bases de datos sin despeinarse?
La respuesta no reside en un truco de magia, sino en la elegancia de la buena arquitectura. Este artículo te llevará en un viaje a través de una solución sofisticada en Spring Boot, donde desvelaremos cómo obtener credenciales de forma segura desde un gestor de secretos y, a la vez, emplear el ingenioso patrón de diseño Strategy para crear DataSources que se adaptan dinámicamente a su entorno. Prepárate para transformar una tarea mundana en una pieza de ingeniería de software.
El Mapa de la Arquitectura
Toda gran solución comienza con un plan. Antes de sumergirnos en el código, visualicemos nuestro ecosistema. No se trata de un monolito de lógica enrevesada, sino de un conjunto de componentes especializados que colaboran en perfecta armonía, como una orquesta bien afinada.
Antes de desgranar el código, un buen mapa visual nos ayudará a navegar la solución. El siguiente diagrama de clases ilustra las relaciones y dependencias entre nuestros componentes clave. Observa cómo las fábricas (Factory) orquestan la creación de objetos, mientras que la interfaz DatabaseEngineStrategy actúa como un contrato para sus diferentes implementaciones.

codigo mermaid
        classDiagram
            class DatabaseConnectionPool {
                -DatabaseEngineFactory engineFactory
                +dataSourceFromSecret(String, DatabaseConnectionPropertiesFactory) DataSource
            }
            class DatabaseConnectionPropertiesFactory {
                -GenericManager secretsManager
                +getDatabaseConnectionProperties(String) DatabaseConnectionProperties
            }
            class DatabaseConnectionProperties {
                -String dbname
                -String username
                -String password
                -String engine
                ...
            }
            class DatabaseEngineFactory {
                -Map~String, DatabaseEngineStrategy~ strategies
                +getStrategy(String) DatabaseEngineStrategy
            }
            class DatabaseEngineStrategy {
                <>
                +getName() String
                +buildJdbcUrl(...) String
                +getValidationQuery() String
            }
            class PostgresqlStrategy {
                +getName() String
                ...
            }
            class MysqlStrategy {
                +getName() String
                ...
            }
            DatabaseConnectionPool ..> DatabaseConnectionPropertiesFactory : uses
            DatabaseConnectionPool ..> DatabaseEngineFactory : uses
            DatabaseConnectionPropertiesFactory ..> DatabaseConnectionProperties : creates
            DatabaseEngineFactory ..> DatabaseEngineStrategy : uses
            PostgresqlStrategy --|> DatabaseEngineStrategy : implements
            MysqlStrategy --|> DatabaseEngineStrategy : implements
El flujo de nuestra sinfonía es el siguiente:
- El director de orquesta (
DatabaseConnectionPool) necesita la partitura: las propiedades de conexión. Para ello, acude a nuestro "bibliotecario" (DatabaseConnectionPropertiesFactory). - El bibliotecario viaja a una bóveda segura (el gestor de secretos) para recuperar la partitura (
DatabaseConnectionProperties). - La partitura indica qué tipo de instrumento principal se necesita (el
engine, ej. "postgres"). Con esta clave, el director consulta a un "maestro de instrumentos" (DatabaseEngineFactory). - Este maestro selecciona al músico virtuoso adecuado (
DatabaseEngineStrategy) para ese instrumento. - El músico, con su maestría, interpreta la partitura y genera la melodía única: la URL JDBC.
- Finalmente, con todos los elementos en su lugar, el director da la señal y se forma la orquesta completa: un pool de conexiones
HikariDataSourcelisto para actuar.
Ahora, conozcamos a cada uno de los protagonistas de esta obra.
1. El Molde de Nuestros Secretos: DatabaseConnectionProperties
Todo sistema necesita un lenguaje común. Antes de poder manejar nuestros secretos, debemos definir su forma. Aquí es donde entra en juego DatabaseConnectionProperties, nuestro DTO (Data Transfer Object). No es más que el plano que define qué información esperamos encontrar en esa bóveda segura. Con la ayuda de Lombok, su definición es pura simpleza y elegancia.
package com.app247.mecrblog.jpa.config.datasource;

import lombok.AllArgsConstructor;
import lombok.Getter;
import lombok.NoArgsConstructor;
import lombok.Setter;

@Getter
@Setter
@NoArgsConstructor
@AllArgsConstructor
public class DatabaseConnectionProperties {

    private String dbname;
    private String schema;
    private String username;
    private String password;
    private String host;
    private Integer port;
    private String engine; // La pieza clave que define nuestra estrategia.
    private String dbClusterIdentifier;

}
Esta clase es nuestro contrato: cualquier secreto que recuperemos deberá poder amoldarse a esta estructura.
2. El Guardián de los Secretos: DatabaseConnectionPropertiesFactory
La misión de esta fábrica es simple pero crucial: aventurarse en el mundo exterior, dialogar con el gestor de secretos y volver con el botín, ya transformado en nuestro DatabaseConnectionProperties.
package com.app247.mecrblog.jpa.config.datasource;

import org.springframework.stereotype.Component;
// ... (otros imports)
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;

@Slf4j
@RequiredArgsConstructor
@Component
public class DatabaseConnectionPropertiesFactory {

    private static final String DATABASE_SCHEMA = "schema";

    // Un detalle brillante: no depende de un cliente de AWS o Vault,
    // sino de nuestra propia interfaz 'GenericManager'. Pura abstracción.
    private final GenericManager secretsManager;

    public DatabaseConnectionProperties getDatabaseConnectionProperties(String key) throws SecretException {
        var props = secretsManager.getSecret(key, DatabaseConnectionProperties.class);
        props.setSchema(DATABASE_SCHEMA);

        log.info("Creando DataSource para el motor={} en host: {}...",
                   props.getEngine(), props.getHost());

        return props;
    }
}
La verdadera magia aquí es la dependencia de GenericManager. Esta interfaz es nuestro pasaporte universal, permitiéndonos cambiar de proveedor de secretos (de AWS a HashiCorp Vault, por ejemplo) con solo cambiar una implementación, sin que el resto de nuestra aplicación se inmute. Es el arte del desacoplamiento en su máxima expresión.
3. El Arte de la Poliglotía: Adaptabilidad con el Patrón Strategy
Aquí es donde la trama se pone interesante. ¿Qué sucede cuando nuestra aplicación necesita conversar fluidamente con PostgreSQL y, mañana, con MySQL? Podríamos caer en la tentación de un pantanoso bloque if-else o switch, un camino seguro hacia un código frágil y una deuda técnica creciente.
Pero nosotros elegimos un camino más elegante: el patrón Strategy.
El Contrato del Traductor: DatabaseEngineStrategy
Primero, definimos un contrato, una serie de reglas que cualquier "traductor" de dialectos de bases de datos debe seguir.
package com.app247.mecrblog.jpa.config.datasource;

public interface DatabaseEngineStrategy {
    // ¿Cómo te llamas? (ej: "postgres", "mysql")
    String getName();

    // ¿Cómo construyes una URL de conexión en tu idioma?
    String buildJdbcUrl(String host, int port, String dbname, String schema);

    // ¿Cuál es tu forma de verificar que estás vivo? (Validation Query)
    String getValidationQuery();
}
Los Especialistas en Dialectos
Con el contrato en mano, contratamos a nuestros especialistas. Cada uno es un maestro en su propio idioma y se registra como un bean de Spring (@Component).
El experto en PostgreSQL:
package com.app247.mecrblog.jpa.config.datasource.strategy;

import org.springframework.stereotype.Component;
// ...

@Component
public class PostgresqlStrategy implements DatabaseEngineStrategy {
    @Override
    public String getName() { return "postgres"; }

    @Override
    public String buildJdbcUrl(String host, int port, String dbname, String schema) {
        return String.format("jdbc:postgresql://%s:%d/%s%s", host, port, dbname,
                ((schema != null) && (!schema.isEmpty())) ? ("?currentSchema=" + schema) : "");
    }

    @Override
    public String getValidationQuery() { return "SELECT 1"; }
}
El experto en MySQL:
package com.app247.mecrblog.jpa.config.datasource.strategy;

import org.springframework.stereotype.Component;
// ...

@Component
public class MysqlStrategy implements DatabaseEngineStrategy {
    @Override
    public String getName() { return "mysql"; }

    @Override
    public String buildJdbcUrl(String host, int port, String dbname, String schema) {
        return String.format("jdbc:mysql://%s:%d/%s?useSSL=false&serverTimezone=UTC", host, port, dbname);
    }

    @Override
    public String getValidationQuery() { return "SELECT 1"; }
}
Esta estructura es liberadora. ¿Necesitamos soportar Oracle mañana? Simplemente creamos un OracleStrategy sin tocar una sola línea del código existente. Nuestro sistema ha aprendido a crecer.
4. El Maestro de Ceremonias: DatabaseEngineFactory
Ya tenemos a nuestros músicos especialistas, pero necesitamos a alguien que sepa a quién llamar en cada momento. Ese es el rol de DatabaseEngineFactory, nuestro maestro de ceremonias.
package com.app247.mecrblog.jpa.config.datasource;

import java.util.Map;
import java.util.function.Function;
import java.util.stream.Collectors;
// ...

@Slf4j
@Service
public class DatabaseEngineFactory {

    private final Map<String, DatabaseEngineStrategy> strategies;

    // Gracias a la magia de Spring, el constructor recibe un mapa con todos
    // nuestros especialistas (beans de DatabaseEngineStrategy) disponibles.
    public DatabaseEngineFactory(Map<String, DatabaseEngineStrategy> strategiesMap) {
        this.strategies = strategiesMap.values().stream()
                .collect(Collectors.toMap(DatabaseEngineStrategy::getName, Function.identity()));
        log.info("Motores de base de datos soportados: {}", this.strategies.keySet());
    }

    // Dada una clave ("postgres"), devuelve al especialista correcto.
    public DatabaseEngineStrategy getStrategy(String engineName) {
        DatabaseEngineStrategy strategy = strategies.get(engineName.toLowerCase());
        if (strategy == null) {
            throw new IllegalArgumentException("Motor de BD no soportado: " + engineName);
        }
        return strategy;
    }
}
Esta fábrica es un ejemplo sublime de cómo el framework Spring puede simplificar nuestro código. En lugar de registrar manualmente cada estrategia, Spring las descubre y nos las entrega listas para usar. La fábrica simplemente las organiza en un mapa para un acceso instantáneo.
5. La Gran Orquesta: Sincronizando Todo en DatabaseConnectionPool
Hemos llegado al acto final. Es hora de que el director suba al podio y una todas las piezas en una sinfonía funcional. La clase DatabaseConnectionPool es nuestro @Configuration principal, el lugar donde la magia realmente ocurre.
package com.app247.mecrblog.jpa.config.datasource;

import javax.sql.DataSource;
// ...
import com.zaxxer.hikari.HikariConfig;
import com.zaxxer.hikari.HikariDataSource;
// ...

@Slf4j
@Configuration
@RequiredArgsConstructor
@Profile({ "local", "qa", "dev", "pdn" }) // Actuamos solo en los escenarios indicados
public class DatabaseConnectionPool {

    // ... (Constantes de configuración de HikariCP)

    private final DatabaseEngineFactory engineFactory;

    @Bean
    public DataSource dataSourceFromSecret(
            @Value("${aws.secrets.credentials.db-write}") String secretName,
            DatabaseConnectionPropertiesFactory connectionPropertiesFactory) throws SecretException {

        // Acto 1: El bibliotecario trae la partitura.
        var props = connectionPropertiesFactory.getDatabaseConnectionProperties(secretName);

        // Acto 2: El maestro de ceremonias elige al virtuoso.
        DatabaseEngineStrategy engine = engineFactory.getStrategy(props.getEngine());

        // Acto 3: El virtuoso crea la melodía (la URL JDBC).
        String jdbcUrl = engine.buildJdbcUrl(props.getHost(), props.getPort(), props.getDbname(), props.getSchema());
        log.info("Creando DataSource con URL: {}", jdbcUrl);

        // Gran final: Se forma la orquesta (el pool de conexiones).
        return buildHikariDataSource(jdbcUrl, props.getUsername(), props.getPassword(), engine);
    }

    private DataSource buildHikariDataSource(String jdbcUrl, String username, String password,
                                             DatabaseEngineStrategy engine) {
        var config = new HikariConfig();
        config.setJdbcUrl(jdbcUrl);
        config.setUsername(username);
        config.setPassword(password);
        config.setPoolName("jpa-" + engine.getName() + "-hikari-pool");
        config.setConnectionTestQuery(engine.getValidationQuery()); // Usamos la frase del especialista
        // ... (resto de la configuración del pool)

        return new HikariDataSource(config);
    }
}
El método dataSourceFromSecret es el corazón palpitante de nuestra aplicación. Orquesta la secuencia de llamadas de una manera tan limpia y declarativa que su lógica se lee casi como prosa.
Telón Final y Futuras Funciones
Lo que hemos creado es más que un simple configurador de DataSource. Es un testimonio de cómo los buenos principios de diseño pueden dar como resultado un sistema que respira:
- Seguro: Las credenciales viven en su fortaleza, lejos de miradas indiscretas.
- Adaptable: Es un políglota de bases de datos, listo para aprender nuevos dialectos en cualquier momento.
- Robusto y Mantenible: Cada componente tiene su lugar y su propósito, haciendo que el sistema sea un placer de mantener y extender.
¿Y qué nos depara el futuro? Esta arquitectura no es un final, sino un punto de partida para nuevas aventuras:
- Mundos Paralelos: Extender la lógica para manejar réplicas de lectura, creando un
DataSourcepara escritura y otro para lectura. - Nuevos Talentos: Incorporar estrategias para Oracle, SQL Server o incluso bases de datos NoSQL con drivers JDBC.
- Inteligencia Dinámica: Hacer que la selección del
schemasea tan dinámica como el resto de la configuración.
Hemos transformado un requisito técnico en una solución elegante, demostrando que el código, en sus mejores momentos, se acerca más al arte que a la ciencia.
Manejando el Caos: Una Guía Definitiva sobre Excepciones de Dominio 🎯
- Mauricio ECR
- Snippets
- 20 Aug, 2025
En el desarrollo de software moderno, escribir código que funciona perfectamente en escenarios ideales es solo el primer paso. La verdadera fortaleza de un sistema se manifiesta cuando debe enfrentar
Manejando el Caos: Una Guía Definitiva sobre Excepciones de Dominio 🎯
- Mauricio ECR
- Snippets
- 20 Aug, 2025
En el desarrollo de software moderno, escribir código que funciona perfectamente en escenarios ideales es solo el primer paso. La verdadera fortaleza de un sistema se manifiesta cuando debe enfrentar situaciones imprevistas, errores y desviaciones del comportamiento esperado. En este contexto, el manejo adecuado de excepciones se convierte en una disciplina fundamental.
Sin embargo, no todas las excepciones son iguales. Mientras que errores como NullPointerException o IOException señalan problemas técnicos o de infraestructura, existe una categoría más rica y expresiva: las Excepciones de Dominio. Estas no representan fallos técnicos, sino violaciones específicas de las reglas, políticas y restricciones del negocio.
Las excepciones de dominio son especialmente valiosas en arquitecturas que siguen los principios de Domain-Driven Design (DDD), ya que permiten que nuestro código comunique directamente en el lenguaje del negocio, encapsulando la lógica de forma explícita y comprensible.
Este artículo establece una base documental completa sobre el tema, explorando un catálogo exhaustivo de excepciones de dominio y presentando un patrón de implementación que mantiene la separación de responsabilidades entre las capas de dominio e infraestructura.
El Corazón del Asunto: Un Catálogo de Excepciones de Dominio
Una arquitectura robusta requiere identificar y nombrar los conceptos con precisión. Para los errores de negocio, esto significa crear una jerarquía de excepciones que comunique exactamente qué regla específica ha sido violada. El siguiente catálogo cubre una amplia gama de escenarios de negocio comunes:
| Excepción | Descripción | Ejemplo de Uso | Código HTTP | DEFAULT_MESSAGE | DEFAULT_CODE |
|---|---|---|---|---|---|
| EntityNotFoundException | La entidad o recurso solicitado no existe | Buscar un usuario con id=99 que no está en la base de datos |
404 Not Found | ENTITY_NOT_FOUND |
404-001 |
| DuplicateEntityException | Ya existe una entidad con un identificador único | Crear un usuario con un email ya registrado | 409 Conflict | DUPLICATE_ENTITY |
409-001 |
| InvalidIdentifierException | El identificador no cumple con el formato requerido | Consultar un producto con ID esperado como UUID usando valor "ABC-###" |
400 Bad Request | INVALID_IDENTIFIER |
400-001 |
| BusinessRuleViolationException | Violación de una regla de negocio fundamental | Retiro bancario que excede el saldo disponible | 422 Unprocessable Entity | BUSINESS_RULE_VIOLATION |
422-001 |
| OperationNotAllowedException | Operación no permitida en el estado actual del recurso | Intentar cancelar un pedido ya entregado | 403 Forbidden | OPERATION_NOT_ALLOWED |
403-001 |
| InconsistentStateException | Estado internamente incoherente en el modelo de dominio | Pedido marcado como "pagado" sin transacciones asociadas | 500 Internal Server Error | INCONSISTENT_STATE |
500-001 |
| ValidationException | Error genérico de validación de datos de entrada | Petición a la API sin campo obligatorio | 400 Bad Request | VALIDATION_FAILED |
400-002 |
| InvalidValueException | Valor de campo fuera de rango o inválido | Crear usuario con edad = -5 |
400 Bad Request | INVALID_VALUE |
400-003 |
| MissingMandatoryValueException | Ausencia de valor obligatorio para la operación | Crear factura sin número de serie | 400 Bad Request | MISSING_MANDATORY_VALUE |
400-004 |
| ConcurrencyException | Conflicto al modificar un recurso en paralelo | Dos usuarios editando el mismo producto simultáneamente | 409 Conflict | CONCURRENCY_CONFLICT |
409-002 |
| OptimisticLockingException | Discordancia en versión de entidad (bloqueo optimista) | Guardar cliente con version=2 cuando la BD tiene version=3 |
409 Conflict | OPTIMISTIC_LOCK_ERROR |
409-003 |
| ReferentialIntegrityException | Violación de restricción de integridad referencial | Eliminar cliente que tiene facturas asociadas | 409 Conflict | REFERENTIAL_INTEGRITY_VIOLATION |
409-004 |
| AuthenticationException | Fallo en proceso de autenticación | Iniciar sesión con contraseña incorrecta | 401 Unauthorized | AUTHENTICATION_FAILED |
401-001 |
| AuthorizationException | Usuario sin permisos necesarios para la operación | Usuario "cliente" intentando acceder a panel de administración | 403 Forbidden | AUTHORIZATION_FAILED |
403-002 |
| SessionExpiredException | Sesión expirada o token inválido | Petición con JWT expirado a endpoint protegido | 401 Unauthorized | SESSION_EXPIRED |
401-002 |
| WorkflowViolationException | Transición inválida en flujo o proceso | Intentar "aprobar" orden de compra no "validada" | 422 Unprocessable Entity | WORKFLOW_VIOLATION |
422-002 |
| TimeoutException | Operación excedió tiempo de espera máximo | Pago en pasarela externa sin respuesta a tiempo | 504 Gateway Timeout | OPERATION_TIMEOUT |
504-001 |
| ExternalSystemUnavailableException | Sistema externo dependiente no disponible | Servicio de inventario caído durante procesamiento de venta | 503 Service Unavailable | EXTERNAL_SYSTEM_UNAVAILABLE |
503-001 |
| InsufficientBalanceException | Fondos o saldo insuficientes | Pagar compra de 200€ con saldo de 100€ | 422 Unprocessable Entity | INSUFFICIENT_BALANCE |
422-003 |
| CurrencyMismatchException | Mezcla de monedas incompatibles | Pagar en USD desde cuenta que opera solo en EUR | 400 Bad Request | CURRENCY_MISMATCH |
400-005 |
| LimitExceededException | Superación de límite definido | Transferir 10.000€ con límite diario de 5.000€ | 429 Too Many Requests | LIMIT_EXCEEDED |
429-001 |
| ConfigurationException | Error o falta de configuración en el dominio | Sistema sin tipo de IVA definido para país específico | 500 Internal Server Error | CONFIGURATION_ERROR |
500-002 |
| UnsupportedOperationException | Operación no soportada o implementada | Exportar reporte a formato obsoleto no desarrollado | 501 Not Implemented | UNSUPPORTED_OPERATION |
501-001 |
Patrón de Implementación: De la Pureza del Dominio a la Realidad de la Infraestructura 💡
Tener una rica jerarquía de excepciones es valioso, pero el verdadero desafío está en manejarlas de forma elegante. El objetivo es que nuestra capa de dominio lance una InsufficientBalanceException sin conocimiento alguno sobre HTTP, mientras que nuestra capa de API REST la traduzca apropiadamente a una respuesta 422 Unprocessable Entity con formato JSON.
La solución combina el Principio de Inversión de Dependencias con el patrón Strategy, creando un sistema flexible y escalable.
1. La Base de Todo: DomainException
Creamos una clase base abstracta de la que heredarán todas nuestras excepciones de dominio. Es un POJO puro, sin dependencias de frameworks:
package com.tuempresa.dominio.excepciones;

/**
 * Excepción base del dominio.
 *
 * Todas las excepciones específicas del dominio deben heredar de esta clase.
 * No contiene ninguna referencia a frameworks ni tecnologías (HTTP, DB, etc.)
 *
 * Permite mantener un "errorCode" que facilita el mapeo en las capas de
 * aplicación/infraestructura.
 */
public abstract class DomainException extends RuntimeException {

    private final String errorCode;

    protected DomainException(String message, String errorCode) {
        super(message);
        this.errorCode = errorCode;
    }

    public String getErrorCode() {
        return errorCode;
    }
}
2. Una Excepción Concreta: EntityNotFoundException
Cada excepción de dominio es una clase simple que extiende DomainException, proporcionando sus propios códigos y mensajes por defecto:
package com.tuempresa.dominio.excepciones;

/**
 * Se lanza cuando una entidad no puede ser encontrada en el dominio.
 */
public class EntityNotFoundException extends DomainException {

    private static final String DEFAULT_MESSAGE = "ENTITY_NOT_FOUND";
    private static final String DEFAULT_CODE = "404-001";

    public EntityNotFoundException() {
        super(DEFAULT_MESSAGE, DEFAULT_CODE);
    }

    // Constructor opcional para mayor flexibilidad
    public EntityNotFoundException(String message, String errorCode) {
        super(message, errorCode);
    }
}
3. El Traductor: Patrón Strategy para el Manejo de Excepciones
En lugar de un gigantesco bloque if-else o switch, creamos una "estrategia" de manejo para cada excepción. Esto respeta el Principio de Abierto/Cerrado: podemos añadir nuevos manejadores sin modificar código existente.
3.1. La Interfaz Común (DomainExceptionHandlerStrategy)
Define el contrato que todos nuestros manejadores deben cumplir:
package com.tuempresa.infraestructura.excepciones;

import com.tuempresa.dominio.excepciones.DomainException;
import org.springframework.http.ResponseEntity;

public interface DomainExceptionHandlerStrategy<T extends DomainException> {

    /**
     * Devuelve el tipo de excepción que este manejador puede procesar.
     */
    Class<T> getExceptionType();

    /**
     * Procesa la excepción y la convierte en una respuesta HTTP.
     */
    ResponseEntity<ApiError> handle(T ex);
}
3.2. Un Manejador Específico (EntityNotFoundHandler)
Implementación concreta para EntityNotFoundException. Su única responsabilidad es traducir esta excepción de dominio en un HTTP 404 Not Found:
package com.tuempresa.infraestructura.excepciones;

import com.tuempresa.dominio.excepciones.EntityNotFoundException;
import org.springframework.http.HttpStatus;
import org.springframework.http.ResponseEntity;
import org.springframework.stereotype.Component;

@Component
public class EntityNotFoundHandler
    implements DomainExceptionHandlerStrategy<EntityNotFoundException> {

    @Override
    public Class<EntityNotFoundException> getExceptionType() {
        return EntityNotFoundException.class;
    }

    @Override
    public ResponseEntity<ApiError> handle(EntityNotFoundException ex) {
        ApiError error = new ApiError(ex.getErrorCode(), ex.getMessage());
        return new ResponseEntity<>(error, HttpStatus.NOT_FOUND);
    }
}
4. El Orquestador: DomainExceptionHandlerRegistry 🔨
Este componente central actúa como director de orquesta. Mediante inyección de dependencias de Spring, recibe un Map donde las claves son tipos de excepción y los valores son las estrategias correspondientes:
package com.tuempresa.infraestructura.excepciones;

import com.tuempresa.dominio.excepciones.DomainException;
import org.springframework.http.HttpStatus;
import org.springframework.http.ResponseEntity;
import org.springframework.stereotype.Component;
import java.util.Map;
import java.util.function.Function;
import java.util.stream.Collectors;

@Component
public class DomainExceptionHandlerRegistry {

    private final Map<Class<? extends DomainException>, DomainExceptionHandlerStrategy> strategies;

    // Spring inyectará una lista de todos los beans que implementen la interfaz
    // y nosotros la convertimos en un Map para un acceso rápido.
    public DomainExceptionHandlerRegistry(
        java.util.List<DomainExceptionHandlerStrategy> strategyList) {

        this.strategies = strategyList.stream()
            .collect(Collectors.toMap(
                DomainExceptionHandlerStrategy::getExceptionType,
                Function.identity()
            ));
    }

    @SuppressWarnings("unchecked")
    public ResponseEntity<ApiError> handle(DomainException ex) {
        // Buscamos la estrategia específica para el tipo de excepción
        DomainExceptionHandlerStrategy<DomainException> strategy =
            strategies.get(ex.getClass());

        if (strategy != null) {
            return strategy.handle(ex);
        }

        // Fallback para excepciones de dominio no mapeadas explícitamente
        return ResponseEntity
            .status(HttpStatus.INTERNAL_SERVER_ERROR)
            .body(new ApiError("500-000", "UNEXPECTED_DOMAIN_ERROR"));
    }
}
5. La Estructura de Respuesta: ApiError DTO
Un record de Java para estandarizar el formato de nuestras respuestas de error:
package com.tuempresa.infraestructura.excepciones;

// Usamos un record de Java para una clase de datos inmutable y concisa.
public record ApiError(String code, String message) {}
6. La Puerta de Entrada: @RestControllerAdvice
Finalmente, usamos @RestControllerAdvice de Spring para crear un traductor global que intercepta cualquier DomainException no capturada anteriormente:
package com.tuempresa.infraestructura.excepciones;

import com.tuempresa.dominio.excepciones.DomainException;
import org.springframework.http.ResponseEntity;
import org.springframework.web.bind.annotation.ExceptionHandler;
import org.springframework.web.bind.annotation.RestControllerAdvice;
import org.springframework.web.servlet.mvc.method.annotation.ResponseEntityExceptionHandler;

@RestControllerAdvice
public class GlobalExceptionTranslator extends ResponseEntityExceptionHandler {

    private final DomainExceptionHandlerRegistry registry;

    public GlobalExceptionTranslator(DomainExceptionHandlerRegistry registry) {
        this.registry = registry;
    }

    @ExceptionHandler(DomainException.class)
    public final ResponseEntity<ApiError> handleDomainException(DomainException ex) {
        // Toda la lógica compleja está en el registry, aquí solo delegamos.
        return registry.handle(ex);
    }
}
Beneficios del Patrón Implementado
Este enfoque proporciona múltiples ventajas significativas:
Separación de Responsabilidades: La capa de dominio permanece completamente aislada de las preocupaciones de infraestructura como códigos HTTP o formatos de respuesta.
Extensibilidad: Añadir nuevas excepciones de dominio requiere únicamente crear la excepción y su manejador correspondiente, sin modificar código existente.
Testabilidad: Cada componente puede ser probado independientemente, facilitando la escritura de pruebas unitarias y de integración.
Mantenibilidad: La lógica de manejo de errores está centralizada pero distribuida de forma lógica, evitando el antipatrón de "God Objects".
Reutilización: El mismo patrón puede adaptarse a diferentes protocolos y tecnologías más allá de HTTP/REST.
Conclusión y Futuras Líneas de Trabajo
Hemos establecido una base sólida y documentada para el manejo de errores de negocio. Las excepciones de dominio trascienden la simple gestión de errores para convertirse en una herramienta de modelado que enriquece nuestro código, haciéndolo más expresivo y alineado con las reglas del negocio.
El patrón presentado, fundamentado en Strategy y un Registro central, ofrece una solución elegante que mantiene la pureza de la capa de dominio mientras proporciona un mecanismo extensible para traducir errores de negocio en respuestas concretas de infraestructura.
Una Propuesta para Estandarizar la Seguridad en APIs REST con Arquitectura Hexagonal y Spring Security
- Mauricio ECR
- Snippets
- 03 Aug, 2025
En el desarrollo de aplicaciones empresariales modernas, la seguridad es un pilar fundamental. Sin embargo, lograr una arquitectura de seguridad que sea reutilizable, desacoplada y, al mismo t
Una Propuesta para Estandarizar la Seguridad en APIs REST con Arquitectura Hexagonal y Spring Security
- Mauricio ECR
- Snippets
- 03 Aug, 2025
En el desarrollo de aplicaciones empresariales modernas, la seguridad es un pilar fundamental. Sin embargo, lograr una arquitectura de seguridad que sea reutilizable, desacoplada y, al mismo tiempo, compatible con los estándares de la industria (como JWT y Spring Security) puede ser un reto. Este artículo explora una solución basada en la arquitectura hexagonal, que permite centralizar la lógica de autorización en el dominio, sin perder la integración con las capacidades avanzadas de Spring Security, como el uso de anotaciones (@PreAuthorize) y la inyección del usuario autenticado en los controladores.
Contexto y Desafío
La mayoría de los frameworks modernos, como Spring Boot, ofrecen mecanismos de seguridad robustos y listos para usar. Sin embargo, estos suelen acoplar la lógica de autenticación y autorización a la infraestructura, dificultando la reutilización y el testeo independiente del dominio. Por otro lado, la arquitectura hexagonal promueve la separación de responsabilidades, permitiendo que la lógica de negocio (incluida la autorización) permanezca independiente de los detalles tecnológicos.
El desafío surge cuando se requiere que la lógica de autorización, implementada en el dominio, pueda interactuar con el ecosistema de Spring Security, permitiendo el uso de anotaciones como @PreAuthorize y la inyección del usuario autenticado en los controladores. La solución propuesta en este artículo aborda este reto, permitiendo una integración fluida y flexible.
Dependencias Requeridas
Para implementar esta solución, se requieren las siguientes dependencias en el archivo build.gradle:
dependencies {
    // Spring Boot Core
    implementation 'org.springframework.boot:spring-boot-starter-web'
    implementation 'org.springframework.boot:spring-boot-starter-security'
    implementation 'org.springframework.boot:spring-boot-configuration-processor'

    // Lombok para reducir boilerplate
    compileOnly 'org.projectlombok:lombok'
    annotationProcessor 'org.projectlombok:lombok'

    // JWT (opcional, para parsing de tokens)
    implementation 'io.jsonwebtoken:jjwt-api:0.11.5'
    runtimeOnly 'io.jsonwebtoken:jjwt-impl:0.11.5'
    runtimeOnly 'io.jsonwebtoken:jjwt-jackson:0.11.5'

    // Testing
    testImplementation 'org.springframework.boot:spring-boot-starter-test'
    testImplementation 'org.springframework.security:spring-security-test'
}
Estructura de Directorios
La librería sigue una estructura de directorios que respeta los principios de la arquitectura hexagonal:
src/
├── main/
│   ├── java/
│   │   └── com/
│   │       └── tuempresa/
│   │           ├── dominio/
│   │           │   └── autorizacion/
│   │           │       ├── AuthorizationContext.java
│   │           │       ├── AuthorizationException.java
│   │           │       ├── AuthorizationService.java
│   │           │       └── AuthorizationServiceImpl.java
│   │           └── infraestructura/
│   │               ├── config/
│   │               │   ├── AuthorizationConfig.java
│   │               │   └── AuthorizationFilterConfig.java
│   │               └── filtros/
│   │                   └── StandardAuthorizationFilter.java
│   └── resources/
│       └── META-INF/
│           └── spring.factories (para auto-configuración)
└── test/
    └── java/
        └── com/
            └── tuempresa/
                ├── dominio/
                │   └── autorizacion/
                │       └── AuthorizationServiceTest.java
                └── infraestructura/
                    └── filtros/
                        └── StandardAuthorizationFilterTest.java
Solución: Librería de Seguridad Hexagonal Integrada
La solución se basa en una serie de clases y componentes que pueden ser empaquetados como una librería reutilizable. Esta librería permite:
- Centralizar la lógica de autorización en el dominio, desacoplada de la infraestructura.
- Configurar rutas excluidas, parámetros y comportamiento desde archivos de configuración.
- Integrar con Spring Security para habilitar anotaciones y acceso al usuario autenticado.
- Validar JWT y extraer roles/claims para el contexto de seguridad.
A continuación, se presentan las clases clave de la solución.
1. Contexto de Autorización (Dominio)
package com.tuempresa.dominio.autorizacion;

import lombok.Builder;
import lombok.Value;
import java.util.Map;

@Value
@Builder
public class AuthorizationContext {
    String method;
    String uri;
    Map<String, String> headers;
    Map<String, String> queryParams;
    String body;
    String remoteAddress;
}
2. Excepción de Dominio
package com.tuempresa.dominio.autorizacion;

public class AuthorizationException extends RuntimeException {
    public AuthorizationException(String message) {
        super(message);
    }
}
3. Puerto de Dominio (Interface)
package com.tuempresa.dominio.autorizacion;

public interface AuthorizationService {
    void authorize(AuthorizationContext context) throws AuthorizationException;
}
4. Implementación Base del Servicio de Dominio
package com.tuempresa.dominio.autorizacion;

public class AuthorizationServiceImpl implements AuthorizationService {
    @Override
    public void authorize(AuthorizationContext context) {
        String token = context.getHeaders().get("authorization");
        if (token == null || !token.startsWith("Bearer ")) {
            throw new AuthorizationException("Token inválido o ausente");
        }
        // Más lógica de dominio...
    }
}
5. Configuración del Filtro
package com.tuempresa.infraestructura.config;

import lombok.Data;
import org.springframework.boot.context.properties.ConfigurationProperties;
import org.springframework.stereotype.Component;
import java.util.Set;
import java.util.HashSet;

@Data
@Component
@ConfigurationProperties(prefix = "app.security.authorization")
public class AuthorizationFilterConfig {

    private Set<String> excludedPaths = new HashSet<>();
    private boolean enabled = true;
    private int order = 1;
    private boolean includeQueryParams = true;
    private boolean includeBody = false;
    private boolean enableSpringSecurityIntegration = true;

    public AuthorizationFilterConfig() {
        excludedPaths.add("/actuator/health");
        excludedPaths.add("/actuator/info");
        excludedPaths.add("/swagger-ui");
        excludedPaths.add("/v3/api-docs");
        excludedPaths.add("/error");
    }
}
6. Filtro Principal Consolidado
package com.tuempresa.infraestructura.filtros;

import com.tuempresa.dominio.autorizacion.AuthorizationContext;
import com.tuempresa.dominio.autorizacion.AuthorizationService;
import com.tuempresa.dominio.autorizacion.AuthorizationException;
import com.tuempresa.infraestructura.config.AuthorizationFilterConfig;

import lombok.RequiredArgsConstructor;
import org.springframework.boot.autoconfigure.condition.ConditionalOnProperty;
import org.springframework.core.annotation.Order;
import org.springframework.security.authentication.UsernamePasswordAuthenticationToken;
import org.springframework.security.core.authority.SimpleGrantedAuthority;
import org.springframework.security.core.context.SecurityContextHolder;
import org.springframework.stereotype.Component;
import org.springframework.web.filter.OncePerRequestFilter;
import org.springframework.web.util.ContentCachingRequestWrapper;

import javax.servlet.FilterChain;
import javax.servlet.ServletException;
import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletResponse;
import java.io.IOException;
import java.nio.charset.StandardCharsets;
import java.util.*;

@Component
@Order(1)
@ConditionalOnProperty(name = "app.security.authorization.enabled", havingValue = "true", matchIfMissing = true)
@RequiredArgsConstructor
public class StandardAuthorizationFilter extends OncePerRequestFilter {

    private final AuthorizationFilterConfig config;
    private final AuthorizationService authorizationService;

    @Override
    protected void doFilterInternal(HttpServletRequest request,
                                    HttpServletResponse response,
                                    FilterChain filterChain) throws ServletException, IOException {

        if (isExcludedPath(request.getRequestURI())) {
            filterChain.doFilter(request, response);
            return;
        }

        try {
            HttpServletRequest requestToUse = request;
            if (config.isIncludeBody()) {
                requestToUse = new ContentCachingRequestWrapper(request);
            }

            Map<String, String> headers = extractHeaders(requestToUse);
            Map<String, String> queryParams = config.isIncludeQueryParams() ? extractQueryParams(requestToUse) : Collections.emptyMap();
            String requestBody = (config.isIncludeBody() && requestToUse instanceof ContentCachingRequestWrapper)
                    ? extractRequestBody((ContentCachingRequestWrapper) requestToUse)
                    : null;

            AuthorizationContext context = AuthorizationContext.builder()
                    .method(requestToUse.getMethod())
                    .uri(requestToUse.getRequestURI())
                    .headers(headers)
                    .queryParams(queryParams)
                    .body(requestBody)
                    .remoteAddress(requestToUse.getRemoteAddr())
                    .build();

            authorizationService.authorize(context);

            // Integración con Spring Security (si está habilitada)
            if (config.isEnableSpringSecurityIntegration()) {
                setSpringSecurityContext(context);
            }

            filterChain.doFilter(requestToUse, response);

        } catch (AuthorizationException e) {
            handleSecurityException(response, e);
        } catch (Exception e) {
            logger.error("Error in authorization filter", e);
            handleGenericError(response);
        }
    }

    private Map<String, String> extractHeaders(HttpServletRequest request) {
        Map<String, String> headers = new HashMap<>();
        Enumeration<String> headerNames = request.getHeaderNames();
        while (headerNames.hasMoreElements()) {
            String headerName = headerNames.nextElement();
            String headerValue = request.getHeader(headerName);
            headers.put(headerName.toLowerCase(), headerValue);
        }
        return headers;
    }

    private Map<String, String> extractQueryParams(HttpServletRequest request) {
        Map<String, String> queryParams = new HashMap<>();
        Enumeration<String> paramNames = request.getParameterNames();
        while (paramNames.hasMoreElements()) {
            String paramName = paramNames.nextElement();
            String paramValue = request.getParameter(paramName);
            queryParams.put(paramName, paramValue);
        }
        return queryParams;
    }

    private String extractRequestBody(ContentCachingRequestWrapper request) throws IOException {
        byte[] content = request.getContentAsByteArray();
        if (content.length > 0) {
            return new String(content, StandardCharsets.UTF_8);
        }
        return null;
    }

    private void setSpringSecurityContext(AuthorizationContext context) {
        try {
            String authHeader = context.getHeaders().get("authorization");
            if (authHeader != null && authHeader.startsWith("Bearer ")) {
                String username = extractUsernameFromToken(authHeader);
                List<String> roles = extractRolesFromToken(authHeader);
                List<SimpleGrantedAuthority> authorities = roles.stream()
                        .map(role -> new SimpleGrantedAuthority("ROLE_" + role.toUpperCase()))
                        .toList();

                UsernamePasswordAuthenticationToken authentication =
                        new UsernamePasswordAuthenticationToken(username, null, authorities);

                SecurityContextHolder.getContext().setAuthentication(authentication);
            }
        } catch (Exception e) {
            logger.warn("Could not set Spring Security context", e);
        }
    }

    private String extractUsernameFromToken(String authHeader) {
        // Implementar parsing del JWT aquí
        return "user_from_jwt"; // Placeholder
    }

    private List<String> extractRolesFromToken(String authHeader) {
        // Implementar parsing del JWT aquí
        return List.of("USER"); // Placeholder
    }

    private boolean isExcludedPath(String requestURI) {
        return config.getExcludedPaths().stream()
                .anyMatch(excluded -> requestURI.startsWith(excluded));
    }

    private void handleSecurityException(HttpServletResponse response, AuthorizationException e) throws IOException {
        response.setStatus(HttpServletResponse.SC_UNAUTHORIZED);
        response.setContentType("application/json");
        response.getWriter().write(String.format(
                "{\"error\":\"Unauthorized\",\"message\":\"%s\",\"timestamp\":\"%s\"}",
                e.getMessage(), new Date()
        ));
    }

    private void handleGenericError(HttpServletResponse response) throws IOException {
        response.setStatus(HttpServletResponse.SC_INTERNAL_SERVER_ERROR);
        response.setContentType("application/json");
        response.getWriter().write(String.format(
                "{\"error\":\"Internal Server Error\",\"message\":\"Authorization check failed\",\"timestamp\":\"%s\"}",
                new Date()
        ));
    }
}
7. Configuración de Beans
package com.tuempresa.infraestructura.config;

import com.tuempresa.dominio.autorizacion.AuthorizationService;
import com.tuempresa.dominio.autorizacion.AuthorizationServiceImpl;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class AuthorizationConfig {
    @Bean
    public AuthorizationService authorizationService() {
        return new AuthorizationServiceImpl();
    }
}
8. Configuración en application.yml
app:
  security:
    authorization:
      enabled: true
      order: 1
      include-query-params: true
      include-body: false
      enable-spring-security-integration: true
      excluded-paths:
        - "/actuator/health"
        - "/actuator/info"
        - "/swagger-ui"
        - "/v3/api-docs"
        - "/public"
        - "/auth/login"
9. Ejemplo de Uso en el Proyecto Cliente
@Service
public class MyCustomAuthorizationService implements AuthorizationService {

    @Override
    public void authorize(AuthorizationContext context) throws AuthorizationException {
        String token = context.getHeaders().get("authorization");
        if (!isValidJWT(token)) {
            throw new AuthorizationException("JWT inválido");
        }
        if (context.getUri().startsWith("/admin") && !hasAdminRole(token)) {
            throw new AuthorizationException("Acceso denegado a área administrativa");
        }
    }

    private boolean isValidJWT(String token) {
        // Implementar validación JWT
        return true;
    }

    private boolean hasAdminRole(String token) {
        // Verificar roles en el JWT
        return false;
    }
}
10. Uso en Controllers
@RestController
public class MyController {

    @GetMapping("/protected")
    @PreAuthorize("hasRole('USER')")
    public String protectedEndpoint(@AuthenticationPrincipal String username) {
        return "Hello " + username + "! You are authenticated.";
    }

    @GetMapping("/admin")
    @PreAuthorize("hasRole('ADMIN')")
    public String adminEndpoint() {
        return "Admin area";
    }
}
Consideraciones Finales
- Separación de responsabilidades: El dominio se mantiene puro y desacoplado de la infraestructura.
- Integración total: Se habilita el uso de anotaciones y la inyección del usuario autenticado gracias a la integración con el contexto de Spring Security.
- Configurabilidad: La solución es fácilmente adaptable a distintos proyectos mediante configuración externa.
- Reutilización: El diseño modular permite empaquetar la solución como una librería para múltiples aplicaciones.
Conclusión
La estandarización de la seguridad bajo una arquitectura hexagonal, combinada con la integración de Spring Security y JWT, permite construir aplicaciones robustas, mantenibles y alineadas con las mejores prácticas de la industria. Esta aproximación no solo facilita la reutilización y el testeo, sino que también habilita la evolución futura del sistema, permitiendo incorporar nuevas estrategias de autenticación o autorización sin comprometer la arquitectura.
Diseñando un Wrapper de Respuesta en Java con Funcionalidades de Optional y Gestión de Estado
- Mauricio ECR
- Snippets
- 30 Jun, 2025
En el desarrollo de aplicaciones Java, el manejo de respuestas a solicitudes —especialmente aquellas que involucran operaciones asincrónicas, procesamiento de datos o comunicación con servicios extern
Diseñando un Wrapper de Respuesta en Java con Funcionalidades de Optional y Gestión de Estado
- Mauricio ECR
- Snippets
- 30 Jun, 2025
En el desarrollo de aplicaciones Java, el manejo de respuestas a solicitudes —especialmente aquellas que involucran operaciones asincrónicas, procesamiento de datos o comunicación con servicios externos— requiere estructuras robustas, claras y reutilizables. Aunque Optional<T> de Java es útil para representar valores potencialmente ausentes, su semántica está limitada a la presencia o ausencia de un valor, sin ofrecer un contexto de estado (como éxito, error, pendiente) ni información adicional como mensajes de error.
Este artículo tiene como objetivo presentar una implementación técnica detallada de una clase ResponseWrapper<T> en Java. Esta clase encapsula un valor de respuesta, un estado (Status) y una lista de errores, replicando y extendiendo las capacidades de Optional<T>. A través de esta herramienta, se busca proveer una estructura genérica que mejore la expresividad, manejabilidad y trazabilidad de las respuestas dentro de aplicaciones Java, especialmente en contextos de desarrollo backend, servicios REST, o flujos de validación de datos.
El contenido está orientado a desarrolladores de software, arquitectos de aplicaciones y diseñadores de APIs que deseen integrar una solución flexible y extensible para el manejo de respuestas estructuradas.
Implementación Técnica de ResponseWrapper
Motivación y Limitaciones de Optional<T>
El uso de Optional<T> es común para evitar null y sus efectos colaterales. Sin embargo, presenta limitaciones:
- No permite almacenar información contextual sobre por qué el valor está ausente.
- No diferencia entre un valor ausente por error y uno ausente por diseño (por ejemplo, un valor aún no calculado).
- No soporta transporte de metadatos como mensajes de error, códigos de estado, o indicadores de transición.
Por tanto, es útil extender su concepto en una clase personalizada que mantenga las siguientes características:
- Presencia opcional de un valor
- Estado de la operación (
SUCCESS,FAILURE,PENDING) - Listado de errores informativos o técnicos
- Soporte para operaciones tipo
map,flatMap,orElseyifPresent
Estructura de Código
La clase ResponseWrapper y el enum Status pueden definirse como sigue:
Archivo Status.java
public enum Status {
    SUCCESS,
    FAILURE,
    PENDING
}
Archivo ResponseWrapper.java
import java.util.ArrayList;
import java.util.List;
import java.util.NoSuchElementException;
import java.util.function.Consumer;
import java.util.function.Function;
import java.util.function.Supplier;

public class ResponseWrapper<T> {
    private final T value;
    private final Status status;
    private final List<String> errors;

    private ResponseWrapper(T value, Status status, List<String> errors) {
        this.value = value;
        this.status = status;
        this.errors = errors != null ? new ArrayList<>(errors) : new ArrayList<>();
    }

    public static <T> ResponseWrapper<T> of(T value) {
        return new ResponseWrapper<>(value, Status.SUCCESS, null);
    }

    public static <T> ResponseWrapper<T> empty() {
        return new ResponseWrapper<>(null, Status.PENDING, null);
    }

    public static <T> ResponseWrapper<T> ofError(List<String> errors) {
        return new ResponseWrapper<>(null, Status.FAILURE, errors);
    }

    public boolean isPresent() {
        return value != null;
    }

    public T get() {
        if (value == null) {
            throw new NoSuchElementException("No value present");
        }
        return value;
    }

    public T orElse(T other) {
        return value != null ? value : other;
    }

    public T orElseGet(Supplier<? extends T> other) {
        return value != null ? value : other.get();
    }

    public <X extends Throwable> T orElseThrow(Supplier<? extends X> exceptionSupplier) throws X {
        if (value != null) {
            return value;
        } else {
            throw exceptionSupplier.get();
        }
    }

    public void ifPresent(Consumer<? super T> consumer) {
        if (value != null) {
            consumer.accept(value);
        }
    }

    public <U> ResponseWrapper<U> map(Function<? super T, ? extends U> mapper) {
        if (!isPresent()) {
            return empty();
        }
        return ResponseWrapper.of(mapper.apply(value));
    }

    public <U> ResponseWrapper<U> flatMap(Function<? super T, ResponseWrapper<U>> mapper) {
        if (!isPresent()) {
            return empty();
        }
        return mapper.apply(value);
    }

    public Status getStatus() {
        return status;
    }

    public List<String> getErrors() {
        return new ArrayList<>(errors);
    }

    public boolean isSuccess() {
        return status == Status.SUCCESS;
    }

    public boolean isFailure() {
        return status == Status.FAILURE;
    }

    public boolean isPending() {
        return status == Status.PENDING;
    }

    @Override
    public String toString() {
        return value != null
            ? String.format("ResponseWrapper[%s, %s, %s]", value, status, errors)
            : String.format("ResponseWrapper.empty[%s, %s]", status, errors);
    }
}
Aplicaciones Prácticas
Caso de Uso 1: Servicio RESTful
En una API REST, ResponseWrapper puede encapsular una respuesta sin tener que lanzar excepciones para errores esperados:
@GetMapping("/usuarios/{id}")
public ResponseEntity<ResponseWrapper<Usuario>> obtenerUsuario(@PathVariable Long id) {
    Optional<Usuario> usuario = usuarioService.buscarPorId(id);
    if (usuario.isPresent()) {
        return ResponseEntity.ok(ResponseWrapper.of(usuario.get()));
    } else {
        return ResponseEntity.status(HttpStatus.NOT_FOUND)
            .body(ResponseWrapper.ofError(List.of("Usuario no encontrado")));
    }
}
Caso de Uso 2: Validación de datos
public ResponseWrapper<String> validarEntrada(String input) {
    if (input == null || input.isBlank()) {
        return ResponseWrapper.ofError(List.of("Entrada vacía o nula"));
    }
    return ResponseWrapper.of(input.trim());
}
Caso de Uso 3: Procesamiento Encadenado
ResponseWrapper<String> resultado = validarEntrada("   hola   ")
    .map(String::toUpperCase)
    .flatMap(this::procesarTexto);

if (resultado.isFailure()) {
    log.warn("Errores: {}", resultado.getErrors());
}
Conclusiones
El patrón ResponseWrapper representa una evolución práctica del uso de Optional<T> en Java, permitiendo no solo modelar valores opcionales, sino también asociar metainformación esencial como estado y errores. Esta estructura permite escribir código más legible, declarativo y resiliente ante fallos predecibles.
Su versatilidad lo hace útil en diversos escenarios: servicios web, validaciones, transformaciones funcionales y pruebas. Además, su diseño extensible admite futuras adaptaciones como códigos de error tipados, trazabilidad de auditoría o integración con frameworks de serialización JSON.
Referencias y Recursos Adicionales
Del Dicho al Hecho: Generando Proyectos Java con Plantillas y FreeMarker
- Mauricio ECR
- DevOps
- 25 Jun, 2025
En el artículo anterior, alcanzamos un hito crucial: construimos un plugin binario funcional en Java, completo con su propia configuración y tarea. Nuestro plugin "saludador" demostró que dominamos la
Del Dicho al Hecho: Generando Proyectos Java con Plantillas y FreeMarker
- Mauricio ECR
- DevOps
- 25 Jun, 2025
En el artículo anterior, alcanzamos un hito crucial: construimos un plugin binario funcional en Java, completo con su propia configuración y tarea. Nuestro plugin "saludador" demostró que dominamos la estructura, pero su utilidad era meramente académica. Hoy, transformamos ese esqueleto en una herramienta de productividad real. Vamos a convertir nuestro plugin en un generador de proyectos.
El objetivo de este capítulo es tomar la configuración del usuario (como el nombre del proyecto y el paquete base) y, con una sola tarea de Gradle, materializar un esqueleto de proyecto Java completamente funcional. Para lograr esto, dejaremos atrás la simple impresión en consola y nos adentraremos en dos áreas clave: la manipulación del sistema de archivos y, lo más importante, el uso de un motor de plantillas. Presentamos a nuestro nuevo mejor amigo: Apache FreeMarker.
1. La Herramienta Adecuada: ¿Por qué un Motor de Plantillas?
Podríamos generar archivos concatenando String en Java, pero eso sería increíblemente frágil, difícil de leer y casi imposible de mantener. Un motor de plantillas separa el "qué" (la estructura y el contenido de un archivo) del "cómo" (los datos específicos que lo rellenan).
Elegimos FreeMarker por varias razones:
- Madurez y Potencia: Es una biblioteca robusta y probada en batalla.
- Diseñado para la Generación de Texto: A diferencia de otros motores más enfocados en HTML, FreeMarker es excelente para generar cualquier tipo de archivo de texto:
.java,.xml,.properties, o nuestrobuild.gradle. - Lógica en Plantillas: Permite usar condicionales, bucles y otras lógicas directamente en los archivos de plantilla, algo que será vital cuando generemos código más complejo.
2. Integrando FreeMarker en Nuestro Plugin
El primer paso es hacer que nuestro plugin conozca FreeMarker.
a) Añadir la Dependencia
Abre el archivo build.gradle de nuestro plugin (nuestro-generador/plugin/build.gradle) y añade la dependencia de FreeMarker.
// nuestro-generador/plugin/build.gradle

plugins {
    id 'java-gradle-plugin'
}

repositories {
    mavenCentral()
}

// AÑADIMOS ESTE BLOQUE
dependencies {
    // Añadimos la implementación de FreeMarker
    implementation 'org.freemarker:freemarker:2.3.32'
}

gradlePlugin {
    plugins {
        // Renombraremos el plugin para que refleje su nuevo propósito
        projectGeneratorPlugin {
            id = 'com.miempresa.project-generator'
            implementationClass = 'com.miempresa.ProjectGeneratorPlugin'
        }
    }
}
b) Creación de las Plantillas
Las plantillas son el corazón de nuestro generador. Por convención, las colocaremos en src/main/resources/templates dentro de nuestro proyecto de plugin. Gradle las empaquetará automáticamente en el .jar final, haciéndolas accesibles desde el classpath.
Crea el directorio nuestro-generador/plugin/src/main/resources/templates/. Ahora, creemos algunas plantillas básicas. Nota el uso de la sintaxis ${...} para las variables.
templates/build.gradle.ftl:
plugins {
    id 'java'
    id 'application'
}

group = '${basePackage}'
version = '1.0-SNAPSHOT'

repositories {
    mavenCentral()
}

dependencies {
    testImplementation 'org.junit.jupiter:junit-jupiter:5.10.0'
}

application {
    mainClass = '${basePackage}.Application'
}
templates/Application.java.ftl:
package ${basePackage};

public class Application {
    public static void main(String[] args) {
        System.out.println("¡Hola desde el proyecto '${projectName}'!");
    }
}
3. Expandiendo la Configuración
Nuestra extensión actual es demasiado simple. Necesitamos que el usuario nos proporcione la información necesaria para la generación. Vamos a renombrar y expandir nuestra clase de extensión.
- Renombra
GreeterExtension.javaaGeneratorExtension.java. - Añade las nuevas propiedades.
plugin/src/main/java/com/miempresa/GeneratorExtension.java:
package com.miempresa;

public class GeneratorExtension {
    private String projectName = "mi-proyecto-generado";
    private String basePackage = "com.ejemplo.proyecto";

    public String getProjectName() {
        return projectName;
    }

    public void setProjectName(String projectName) {
        this.projectName = projectName;
    }

    public String getBasePackage() {
        return basePackage;
    }

    public void setBasePackage(String basePackage) {
        this.basePackage = basePackage;
    }
}
4. La Tarea de Generación: El Corazón de la Lógica
Aquí es donde ocurre la magia. Reemplazaremos nuestra antigua tarea greet por una nueva y potente tarea generateProject.
- Renombra
GreetingPlugin.javaaProjectGeneratorPlugin.java. - Actualiza la lógica para que use FreeMarker y cree los archivos.
plugin/src/main/java/com/miempresa/ProjectGeneratorPlugin.java:
package com.miempresa;

import freemarker.template.Configuration;
import freemarker.template.Template;
import freemarker.template.TemplateException;
import freemarker.template.TemplateExceptionHandler;
import org.gradle.api.Plugin;
import org.gradle.api.Project;

import java.io.File;
import java.io.FileWriter;
import java.io.IOException;
import java.io.Writer;
import java.util.HashMap;
import java.util.Map;

public class ProjectGeneratorPlugin implements Plugin<Project> {

    @Override
    public void apply(Project project) {
        final GeneratorExtension extension = project.getExtensions().create("generator", GeneratorExtension.class);

        project.getTasks().register("generateProject", task -> {
            task.setGroup("Generacion");
            task.setDescription("Genera un nuevo esqueleto de proyecto Java.");
            task.doLast(t -> {
                try {
                    generate(project, extension);
                } catch (IOException | TemplateException e) {
                    // Lanzamos una excepción para que el build falle si algo va mal
                    throw new RuntimeException("Fallo al generar el proyecto", e);
                }
            });
        });
    }

    private void generate(Project project, GeneratorExtension extension) throws IOException, TemplateException {
        String projectName = extension.getProjectName();
        String basePackage = extension.getBasePackage();
        project.getLogger().lifecycle("Iniciando generación del proyecto: {}", projectName);

        // 1. Configurar FreeMarker
        Configuration cfg = new Configuration(Configuration.VERSION_2_3_32);
        cfg.setClassForTemplateLoading(ProjectGeneratorPlugin.class, "/templates");
        cfg.setDefaultEncoding("UTF-8");
        cfg.setTemplateExceptionHandler(TemplateExceptionHandler.RETHROW_HANDLER);

        // 2. Crear el modelo de datos para las plantillas
        Map<String, Object> model = new HashMap<>();
        model.put("projectName", projectName);
        model.put("basePackage", basePackage);

        // 3. Crear directorios
        File projectDir = new File(project.getProjectDir(), projectName);
        File packageDir = new File(projectDir, "src/main/java/" + basePackage.replace('.', '/'));
        if (!packageDir.mkdirs()) {
            throw new IOException("No se pudieron crear los directorios base.");
        }
        new File(projectDir, "src/test/java").mkdirs();

        // 4. Procesar plantillas y generar archivos
        generateFile(cfg, model, "build.gradle.ftl", new File(projectDir, "build.gradle"));
        generateFile(cfg, model, "Application.java.ftl", new File(packageDir, "Application.java"));

        project.getLogger().lifecycle("Proyecto '{}' generado exitosamente en: {}", projectName, projectDir.getAbsolutePath());
    }

    private void generateFile(Configuration cfg, Map<String, Object> model, String templateName, File output) throws IOException, TemplateException {
        Template template = cfg.getTemplate(templateName);
        try (Writer writer = new FileWriter(output)) {
            template.process(model, writer);
        }
    }
}
5. Probándolo Todo Junto
Ya estamos listos para la prueba final.
Actualiza el
build.gradledel proyecto de prueba para usar el nuevo ID del plugin y la nueva extensióngenerator.nuestro-generador/proyecto-de-prueba/build.gradle:plugins { // Usamos el nuevo ID del plugin id 'com.miempresa.project-generator' } // Usamos la nueva extensión 'generator' generator { projectName = 'mi-primera-app' basePackage = 'com.acme.app' }Ejecuta la tarea de generación desde el directorio raíz (
nuestro-generador/)../gradlew :proyecto-de-prueba:generateProject
Si todo fue correcto, verás los mensajes de log en tu consola y, lo más importante, ¡un nuevo directorio llamado mi-primera-app habrá aparecido! Dentro, encontrarás un proyecto Gradle funcional, listo para ser importado en tu IDE y ejecutado.
nuestro-generador/
├── mi-primera-app/
│   ├── build.gradle
│   └── src/main/java/com/acme/app/Application.java
├── plugin/
└── ...
Conclusión y Siguientes Pasos
¡Hemos dado un salto cuántico! Nuestro plugin ha pasado de ser un juguete a una herramienta de productividad. Ahora puede tomar una configuración declarativa y generar un proyecto Java completo y funcional. Hemos aprendido a integrar una biblioteca de terceros, a gestionar y procesar archivos de plantillas desde el classpath y a escribir una lógica de tarea compleja que interactúa con el sistema de archivos.
Nuestro generador es potente, pero su estructura es estática. Siempre genera el mismo tipo de proyecto. ¿Y si pudiéramos llevarlo más allá? ¿Y si pudiéramos describir una entidad de negocio —como "Producto" o "Cliente"— y el plugin generara automáticamente todo el código CRUD (Crear, Leer, Actualizar, Borrar) para ella, siguiendo las mejores prácticas de la industria?
En el próximo artículo, nos adentraremos en el fascinante mundo del Domain-Driven Design (DDD) y la arquitectura hexagonal. Haremos que nuestro plugin lea una definición de modelo y genere dinámicamente todas las capas necesarias, desde la entidad de dominio hasta el controlador REST, llevando nuestra capacidad de automatización a un nivel completamente nuevo.
De Consumidor a Creador: Construyendo tu Primer Plugin Binario de Gradle
- Mauricio ECR
- DevOps
- 16 Jun, 2025
En nuestro artículo anterior, desmitificamos Gradle y sentamos las bases para entender su funcionamiento. Aprendimos a crear proyectos, ejecutar tareas y comprendimos el rol fundamental de los plugins
De Consumidor a Creador: Construyendo tu Primer Plugin Binario de Gradle
- Mauricio ECR
- DevOps
- 16 Jun, 2025
En nuestro artículo anterior, desmitificamos Gradle y sentamos las bases para entender su funcionamiento. Aprendimos a crear proyectos, ejecutar tareas y comprendimos el rol fundamental de los plugins como consumidores. Hoy, damos el salto más emocionante: pasaremos de ser meros usuarios a ser creadores. Vamos a construir nuestro propio plugin binario desde cero, utilizando Java para la lógica y el Groovy DSL para nuestros scripts de build.
¿Por qué un plugin binario? Porque es el estándar profesional. A diferencia de los scripts sueltos, un plugin binario es un artefacto compilado (.jar), versionable, fácilmente distribuible y, sobre todo, mucho más robusto y testeable. Es el vehículo perfecto para encapsular la lógica compleja que nuestro futuro generador de código necesitará.
En este capítulo, construiremos un plugin "saludador" (Greeter). Será sencillo en su función —mostrar un mensaje configurable— pero nos enseñará la anatomía completa de un plugin en un entorno Java: su estructura, su punto de entrada, cómo hacerlo configurable y, finalmente, cómo probarlo. ¡Es hora de arremangarse y empezar a programar nuestro build!
1. La Anatomía de un Plugin: Estructura del Proyecto
Para empezar, necesitamos un entorno de trabajo. La mejor manera de desarrollar y probar un plugin es con un build multi-proyecto. Crearemos una estructura que contenga tanto la lógica del plugin como un proyecto de ejemplo que lo consumirá.
Abre tu terminal y crea la siguiente estructura de directorios:
nuestro-generador/
├── plugin/                # Directorio para el código de nuestro plugin
└── proyecto-de-prueba/    # Un proyecto simple para aplicar y probar el plugin
Ahora, configuremos cada parte.
a) Configurando el Proyecto del Plugin (/plugin)
Este es el corazón de nuestro trabajo. Dentro del directorio plugin, crea un archivo build.gradle y un settings.gradle.
plugin/settings.gradle:
rootProject.name = 'mi-plugin-saludador'
plugin/build.gradle:
Este archivo es crucial. Le dice a Gradle que estamos construyendo un plugin de Gradle con código Java.
plugins {
    // Plugin esencial para desarrollar plugins de Gradle en Java
    id 'java-gradle-plugin'
}

repositories {
    mavenCentral()
}

// Este bloque configura los detalles de nuestro plugin
gradlePlugin {
    plugins {
        // "greeterPlugin" es el nombre que le damos a nuestra configuración
        greeterPlugin {
            id = 'com.miempresa.greeter' // El ID único que los usuarios usarán
            implementationClass = 'com.miempresa.GreetingPlugin' // La clase Java que implementa la lógica
        }
    }
}
b) El Código Fuente del Plugin
Gradle necesita saber dónde está el código. Con el plugin java-gradle-plugin, asumirá la estructura estándar de Java.
Crea la clase del Plugin: Dentro de
plugin/, crea la ruta de directoriossrc/main/java/com/miempresa/. Dentro, crea el archivoGreetingPlugin.java.El archivo de propiedades: El plugin
java-gradle-pluginy el bloquegradlePluginse encargan de generar automáticamente el archivo de propiedades necesario (META-INF/gradle-plugins/com.miempresa.greeter.properties). ¡Magia!
2. El Punto de Entrada: La Interfaz Plugin<Project>
Todo plugin binario debe implementar la interfaz Plugin<Project>. Su método apply(Project project) es la puerta de entrada, el equivalente al main de una aplicación. Es aquí donde toda nuestra lógica se conectará al proyecto que use el plugin.
Edita tu archivo plugin/src/main/java/com/miempresa/GreetingPlugin.java:
package com.miempresa;

import org.gradle.api.Plugin;
import org.gradle.api.Project;

public class GreetingPlugin implements Plugin<Project> {
    @Override
    public void apply(Project project) {
        // El objeto "project" es nuestra puerta de acceso al build del consumidor.
        // Aquí registraremos tareas, extensiones, etc.
        project.getLogger().lifecycle("¡Plugin 'greeter' aplicado con éxito!");
    }
}
Ya tenemos un esqueleto funcional. ¡Pero un plugin que no hace nada no es muy útil!
3. Haciendo tu Plugin Configurable con Extensiones
Rara vez querremos que un plugin se comporte siempre igual. Necesitamos una forma de que el usuario lo configure. En lugar de pasar parámetros de forma engorrosa, Gradle nos ofrece un mecanismo elegante: las Extensiones.
Una extensión no es más que un POJO (Plain Old Java Object) cuyas propiedades serán configurables desde el build.gradle del consumidor a través de sus getters y setters.
Crea la clase de la Extensión: Dentro de
com.miempresa, crea un nuevo archivoGreeterExtension.java.package com.miempresa; public class GreeterExtension { // En Java, las propiedades se modelan con campos privados y getters/setters públicos. private String message = "Hola por defecto desde el plugin Java"; public String getMessage() { return message; } public void setMessage(String message) { this.message = message; } }Registra la Extensión: Ahora, volvamos a
GreetingPlugin.javay registremos la extensión en el métodoapply.// ... en GreetingPlugin.java @Override public void apply(Project project) { // Registramos una extensión llamada "greeter" que usa nuestra clase POJO. // El usuario la configurará con un bloque `greeter { ... }` en su build.gradle GreeterExtension extension = project.getExtensions().create("greeter", GreeterExtension.class); // ... más lógica vendrá aquí }
4. Dando Vida al Plugin: Tareas Personalizadas
El objetivo final de un plugin es, generalmente, añadir nuevas tareas. Vamos a crear una tarea greet que use el mensaje de nuestra extensión.
Registra la Tarea: Dentro del método
applydeGreetingPlugin.java, después de registrar la extensión, registraremos la tarea.// ... en GreetingPlugin.java, dentro del método apply() @Override public void apply(Project project) { // La variable debe ser final (o efectivamente final) para ser usada en la lambda final GreeterExtension extension = project.getExtensions().create("greeter", GreeterExtension.class); // Registramos una nueva tarea llamada "greet" project.getTasks().register("greet", task -> { task.setGroup("Saludos"); // Agrupa la tarea en la lista de `./gradlew tasks` task.setDescription("Muestra un saludo configurable"); // La acción que se ejecutará cuando se llame a la tarea task.doLast(t -> { // Usamos la extensión capturada del scope exterior project.getLogger().lifecycle(extension.getMessage()); }); }); }
Hemos conectado todo: El plugin registra una extensión para recibir configuración y una tarea que lee esa configuración para ejecutar una acción.
5. ¡A Probar! Aplicando y Verificando el Plugin Localmente
Es el momento de la verdad. Vamos a usar nuestro proyecto-de-prueba para consumir el plugin que acabamos de crear.
Modifica el
settings.gradleprincipal: Necesitamos decirle a Gradle que nuestro build tiene dos subproyectos y que uno (plugin) es un "build incluido" que provee plugins. Crea un archivosettings.gradleen el directorio raíz (nuestro-generador/).// nuestro-generador/settings.gradle rootProject.name = 'generador-completo' // Incluye el proyecto que usará el plugin include 'proyecto-de-prueba' // Incluye el build que contiene nuestro plugin includeBuild 'plugin'Configura el
proyecto-de-prueba: Ahora, crea un archivobuild.gradledentro deproyecto-de-prueba/.// nuestro-generador/proyecto-de-prueba/build.gradle plugins { // ¡Aplicamos nuestro plugin usando el ID que definimos! id 'com.miempresa.greeter' } // Configuramos la extensión que creamos en el plugin. // El Groovy DSL llama a setMessage() automáticamente. greeter { message = '¡Mi primer plugin en Java funciona! 🎉' }Ejecuta la Tarea: Vuelve a la raíz (
nuestro-generador/) en tu terminal y ejecuta la tarea, especificando la ruta completa del proyecto:gradle :proyecto-de-prueba:greet
Si todo ha ido bien, deberías ver la salida:
Task :proyecto-de-prueba:greet ¡Mi primer plugin en Java funciona! 🎉
Y si ejecutas gradle :proyecto-de-prueba:tasks verás tu tarea listada bajo el grupo "Saludos".
Conclusión y Siguientes Pasos
¡Lo has conseguido! Has trascendido la barrera de simple usuario para convertirte en un desarrollador de plugins de Gradle usando Java. Hoy has aprendido el ciclo de vida completo de la creación de un plugin: desde la estructura del proyecto y el uso del plugin java-gradle-plugin, pasando por la implementación de la interfaz Plugin<Project>, la creación de una extensión POJO para hacerlo configurable, y el registro de una tarea personalizada que materializa su lógica.
Ya tenemos una base robusta y profesional. Nuestro plugin puede ser configurado y puede ejecutar acciones. Ahora que dominamos la estructura, el siguiente paso es hacerlo realmente útil.
En la próxima entrega de esta serie, tomaremos este esqueleto y le añadiremos músculos. Integraremos un motor de plantillas como FreeMarker, y modificaremos nuestra tarea para que, en lugar de imprimir un simple mensaje, genere una estructura completa de directorios y archivos. La aventura de nuestro generador de código está a punto de dar su paso más importante.
Desmitificando Gradle: El Primer Paso para Automatizar tu Mundo Java
- Mauricio ECR
- DevOps
- 14 Jun, 2025
En el vertiginoso universo del desarrollo de software, la eficiencia no es un lujo, es una necesidad. Dedicar tiempo a tareas repetitivas como compilar código, ejecutar pruebas, empaquetar la aplicaci
Desmitificando Gradle: El Primer Paso para Automatizar tu Mundo Java
- Mauricio ECR
- DevOps
- 14 Jun, 2025
En el vertiginoso universo del desarrollo de software, la eficiencia no es un lujo, es una necesidad. Dedicar tiempo a tareas repetitivas como compilar código, ejecutar pruebas, empaquetar la aplicación y gestionar dependencias es un lastre para la productividad. Aquí es donde entran en juego los sistemas de automatización de construcción, y hoy, nos enfocaremos en uno de los más potentes y flexibles del ecosistema Java: Gradle.
Este artículo es el punto de partida de una serie en la que no solo aprenderemos a usar Gradle, sino que construiremos nuestra propia herramienta avanzada: un plugin capaz de generar esqueletos de proyectos Java y módulos CRUD completos bajo la filosofía de Domain-Driven Design (DDD). Pero antes de correr, debemos aprender a caminar. ¡Acompáñanos en este primer paso para sentar unas bases sólidas y duraderas con Gradle!
¿Qué es Gradle y por qué Debería Importarte?
Imagina a Gradle como el director de orquesta de tu proyecto. Es un sistema de automatización de construcción de código abierto que toma tu código fuente, las librerías de las que depende, y una serie de instrucciones, y produce un artefacto final (como un archivo .jar o .war).
Si vienes del mundo de Java, es probable que hayas oído hablar de Maven o incluso del venerable Ant. ¿Qué hace diferente a Gradle?
- Frente a Maven: Mientras que Maven se rige por la "convención sobre configuración" con una estructura rígida definida en archivos
pom.xml, Gradle ofrece una flexibilidad inmensa. Su filosofía se basa en un DSL (Domain Specific Language), un lenguaje específico para el dominio de la construcción de software, que se escribe en Groovy o Kotlin. Esto transforma tus scripts de construcción de simples archivos de configuración a potentes programas. - Frente a Ant: Ant también usa scripts (XML), pero es mucho más imperativo. Le dices qué hacer y cómo hacerlo. Gradle es más declarativo; describes qué quieres lograr, y Gradle, con su modelo de grafos de dependencias, se encarga de la manera más eficiente de lograrlo.
Conceptos Clave para Empezar
Para hablar el idioma de Gradle, necesitas conocer su vocabulario esencial:
- Proyectos (Projects): Un proyecto es cualquier componente que quieres construir. Puede ser una librería (
.jar) o una aplicación web completa. Un repositorio puede contener un único proyecto o múltiples subproyectos. - Tareas (Tasks): Son las unidades de trabajo en Gradle. Una tarea puede ser compilar código (
compileJava), ejecutar pruebas (test), crear un archivo (build) o cualquier acción que definas. - Plugins: Son extensiones que añaden nuevas capacidades y tareas a tu proyecto. Por ejemplo, el plugin de Java añade tareas para compilar y probar código Java. Son el corazón de la reusabilidad en Gradle.
- Dependencias (Dependencies): Son las librerías o módulos externos que tu proyecto necesita para funcionar. Gradle se encarga de descargarlas de repositorios (como Maven Central) y hacerlas disponibles en tu proyecto.
Preparando el Terreno: Tu Entorno de Desarrollo 🛠️
Antes de escribir una sola línea, asegúrate de tener las herramientas adecuadas.
- JDK (Java Development Kit): Gradle se ejecuta sobre la JVM, por lo que necesitas un JDK instalado. La versión 17 o superior es una excelente elección para proyectos modernos.
- Instalación de Gradle: Aunque puedes descargarlo manualmente, la forma más recomendada es usar un gestor de versiones como SDKMAN! (para Linux/macOS) o simplemente usar el Gradle Wrapper, una pequeña utilidad que se incluye en los proyectos Gradle y que descarga la versión correcta automáticamente. ¡No te preocupes, lo veremos en acción ahora mismo!
- IDE (Entorno de Desarrollo Integrado): IntelliJ IDEA ofrece una integración con Gradle que es simplemente espectacular. Visual Studio Code, con la extensión "Gradle for Java", es también una alternativa fantástica y ligera.
¡Manos a la Obra! Tu Primer Proyecto con Gradle
La teoría está muy bien, pero la magia sucede en la práctica. Vamos a crear un proyecto Java desde cero. Abre tu terminal en una carpeta vacía y ejecuta:
gradle init
Gradle te hará algunas preguntas:
- Select type of project to generate: Elige
2: application. - Select implementation language: Elige
3: Java. - Split functionality across multiple subprojects?: Elige
1: no. - Select build script DSL: Elige
1: Groovy(es un excelente punto de partida, aunque también podrías elegir Kotlin). - Generate build using new APIs and behavior?: Elige
nopor ahora para mantenerlo simple. - Select test framework: Elige
4: JUnit Jupiter. - Project name y Source package: Presiona Enter para aceptar los valores por defecto.
¡Y listo! 🎉 Gradle ha creado una estructura de proyecto funcional:
.
├── build.gradle         // El script de construcción principal
├── gradle
│   └── wrapper
├── gradlew              // El ejecutable del Wrapper para Linux/macOS
├── gradlew.bat          // El ejecutable del Wrapper para Windows
├── settings.gradle      // Configuración de proyectos/subproyectos
└── src
    ├── main             // Código fuente de la aplicación
    │   └── java
    └── test             // Código fuente de las pruebas
El archivo más importante aquí es build.gradle. Ábrelo y verás algo así:
// build.gradle

plugins {
    id 'java'
    id 'application'
}

repositories {
    mavenCentral()
}

dependencies {
    testImplementation 'org.junit.jupiter:junit-jupiter:5.10.0'
    implementation 'com.google.guava:guava:32.1.3-jre' // Guava ya viene incluido
}

application {
    mainClass = 'org.example.App'
}
Puedes ver los conceptos en acción: se aplican los plugins java y application, se declara el repositorio mavenCentral() para buscar dependencias y se especifica la dependencia de JUnit para las pruebas.
Ahora, ejecutemos algunas tareas básicas desde la terminal:
./gradlew build: Compila, prueba y empaqueta tu aplicación../gradlew run: Ejecuta la aplicación../gradlew clean: Borra el directoriobuildcon todos los artefactos generados.
El Corazón de Gradle: Un Vistazo a las Tareas
Todo lo que hace Gradle es a través de tareas. Puedes definir las tuyas de forma muy sencilla. Añade esto al final de tu build.gradle:
// Tarea personalizada
task miPrimeraTarea {
    doLast {
        println '¡Hola desde mi primera tarea en Gradle!'
    }
}
Ahora ejecuta ./gradlew miPrimeraTarea y verás tu mensaje. Las tareas tienen un ciclo de vida, siendo doFirst y doLast las acciones que puedes añadir al principio o al final de su ejecución.
Más importante aún es cómo las tareas se relacionan. Puedes hacer que una tarea dependa de otra:
task tareaB {
    doLast { println 'Soy la tarea B' }
}

task tareaA(dependsOn: tareaB) {
    doLast { println 'Soy la tarea A, y me ejecuto después de la B' }
}
Esta capacidad de crear un grafo de dependencias es lo que permite a Gradle ser tan eficiente. Además, gracias a los inputs y outputs de las tareas, Gradle sabe si el trabajo ya está hecho (UP-TO-DATE) y puede saltarse la ejecución, ahorrando un tiempo valiosísimo.
El Poder de la Reutilización: Introducción a los Plugins
Escribir la misma lógica de construcción en cada proyecto es tedioso. Los plugins son la solución para encapsular y reutilizar esta lógica. Ya los has usado (id 'java'). Existen tres tipos principales:
- Script Plugins: Un script de Gradle (
otro.gradle) que importas en tubuild.gradle. Útil para lógicas simples dentro de un mismo proyecto. - Precompiled Script Plugins: Scripts
.gradle.ktso.gradleque se compilan y empaquetan, permitiendo una mejor organización. - Binary Plugins: El enfoque profesional. Son clases (en Java, Groovy o Kotlin) que implementan la interfaz
Plugin. Se distribuyen como archivos.jary son el objetivo final de nuestra serie de artículos.
Conclusión y Próximos Pasos
¡Felicidades! Has dado un paso gigante. Ahora entiendes que Gradle es un sistema de construcción programable y altamente flexible, has configurado tu entorno, has creado y ejecutado tu primer proyecto Java y has escarbado en la superficie de sus conceptos más importantes: las tareas y los plugins.
Esta base sólida es el cimiento sobre el que construiremos nuestro conocimiento. Hemos sentado las bases teóricas y prácticas para entender no solo qué hace Gradle, sino cómo piensa.
En nuestra próxima entrega, daremos el siguiente paso lógico y emocionante: comenzaremos a construir nuestro propio plugin binario desde cero. Exploraremos la estructura de un proyecto de plugin, aprenderemos a crear configuraciones personalizadas para que los usuarios puedan ajustarlo y definiremos nuestras primeras tareas encapsuladas. ¡La verdadera aventura de la automatización está a punto de comenzar!
Optimizando el Acceso a Datos: La Importancia de las Proyecciones JPA en Spring Boot
- Mauricio ECR
- Persistencia
- 23 Apr, 2025
El Costo Oculto de Traer Demasiada Información En el desarrollo de aplicaciones que interactúan con bases de datos, una tarea fundamental es la recuperación de datos. Al usar Object-Relational Map
Optimizando el Acceso a Datos: La Importancia de las Proyecciones JPA en Spring Boot
- Mauricio ECR
- Persistencia
- 23 Apr, 2025
El Costo Oculto de Traer Demasiada Información
En el desarrollo de aplicaciones que interactúan con bases de datos, una tarea fundamental es la recuperación de datos. Al usar Object-Relational Mapping (ORM) como JPA (Java Persistence API), es común y tentador mapear nuestras tablas a entidades Java completas y, por defecto, recuperar estas entidades enteras cada vez que realizamos una consulta. Por ejemplo, si tenemos una entidad Usuario con 20 atributos (id, nombre, email, dirección, fecha de registro, último login, preferencias, etc.), una consulta simple como findById(1L) o findByEmail("[email protected]") a menudo se traduce, detrás de escena, en un SELECT u.* FROM usuario u WHERE ....
Si bien esto simplifica el desarrollo inicialmente, presenta un problema significativo a medida que la aplicación crece o cuando solo necesitamos una pequeña porción de esa información: el sobrecoste de datos (over-fetching).
¿Qué problemas concretos genera esto?
- Consumo de Ancho de Banda: Transferir columnas innecesarias entre la base de datos y la aplicación consume más ancho de banda de red.
- Uso de Memoria: La aplicación necesita más memoria para mantener en el Heap objetos más grandes de lo necesario.
- Rendimiento de la Base de Datos: La base de datos tiene que leer más datos del disco (potencialmente) y procesar más información.
- Latencia: La serialización/deserialización de objetos más grandes toma más tiempo, aumentando la latencia de las respuestas.
- Carga en el Garbage Collector: Objetos más grandes y potencialmente más numerosos (si se traen listas) ponen más presión sobre el recolector de basura de la JVM.
En resumen, no seleccionar específicamente los datos que necesitamos es ineficiente y puede degradar significativamente el rendimiento y la escalabilidad de nuestras aplicaciones, especialmente en escenarios de alta concurrencia o con tablas muy anchas (muchas columnas) o largas (muchas filas).
Posibles Soluciones para Optimizar la Recuperación de Datos
Ante el problema del over-fetching, existen varias estrategias que podemos emplear:
- Recuperar Entidades Completas (El Anti-Patrón): Como ya mencionamos, es la opción por defecto pero la menos eficiente si no necesitas toda la información.
- Consultas Nativas (Native Queries): Escribir SQL directamente. Permite un control total y seleccionar exactamente las columnas deseadas. Sin embargo, se pierde la portabilidad entre bases de datos, la seguridad de tipos en tiempo de compilación (parcialmente) y puede mezclar lógica SQL con el código Java de forma menos elegante.
- Criteria API de JPA: Una forma programática y type-safe de construir consultas. Es potente y flexible, permitiendo seleccionar atributos específicos. Su principal desventaja es que puede volverse bastante verbosa y compleja para consultas sencillas.
- Proyecciones (El Enfoque Recomendado): Utilizar las características de JPA y extensiones (como las de Spring Data JPA) para definir explícitamente qué atributos de una entidad queremos recuperar. Ofrece un excelente equilibrio entre eficiencia, legibilidad y seguridad de tipos.
Nos centraremos en esta última: las proyecciones.
Proyecciones JPA al Rescate
Una proyección en el contexto de JPA y Spring Data JPA es una técnica que nos permite definir una "vista" o subconjunto de los atributos de una entidad que deseamos recuperar de la base de datos. En lugar de traer el objeto completo, le indicamos al framework que solo queremos ciertos campos.
Spring Data JPA facilita enormemente el uso de proyecciones mediante dos mecanismos principales:
Proyecciones Basadas en Interfaces (Interface-based Projections)
Defines una interfaz Java que declara métodos get() para los atributos que deseas seleccionar. Los nombres de los métodos deben coincidir con los nombres de las propiedades de la entidad.
Spring Data JPA genera automáticamente la consulta SQL necesaria (SELECT columna1, columna2 FROM ...) y crea una instancia proxy de esa interfaz en tiempo de ejecución, rellenándola con los datos recuperados.
Es la forma más común y recomendada por su simplicidad y claridad.
Proyecciones Basadas en Clases (Class-based Projections - DTOs)
Creas una clase (típicamente un DTO - Data Transfer Object) con los campos que necesitas y un constructor que acepte esos campos como parámetros.
En tu consulta (usando @Query con JPQL), utilizas la sintaxis SELECT NEW com.tu.paquete.TuDTO(e.atributo1, e.atributo2) FROM Entidad e WHERE ....
JPA ejecutará la consulta seleccionando solo las columnas necesarias y las usará para instanciar tu DTO.
Es útil cuando necesitas más lógica en el objeto proyectado o si prefieres trabajar con clases concretas.
Ventajas Clave de Usar Proyecciones
- Eficiencia: Reduce drásticamente la cantidad de datos transferidos y procesados.
- Rendimiento: Consultas más rápidas y menor consumo de memoria y CPU.
- Claridad: El código (interfaces de proyección o DTOs) documenta explícitamente qué datos se esperan para un caso de uso específico.
- Seguridad (con interfaces): Mantiene la seguridad de tipos en gran medida.
Ejemplo Práctico con Spring Boot y JPA
Imaginemos una aplicación de e-commerce con una entidad Producto.
1. Entidad Producto:
package com.miblog.proyecciones.entity;

import jakarta.persistence.Entity;
import jakarta.persistence.GeneratedValue;
import jakarta.persistence.GenerationType;
import jakarta.persistence.Id;
import jakarta.persistence.Lob; // Para campos grandes

@Entity
public class Producto {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    private String nombre;

    @Lob // Indica que puede ser un objeto grande (TEXT, CLOB, BLOB)
    private String descripcionDetallada; // Campo potencialmente pesado

    private double precio;
    private int stock;
    private String categoria;

    // Constructores, Getters y Setters (Omitidos por brevedad)
    // Lombok @Data, @NoArgsConstructor, @AllArgsConstructor puede ser útil aquí
}
Supongamos que en una vista de listado rápido solo necesitamos mostrar el nombre y el precio de los productos con stock disponible. Traer descripcionDetallada sería un desperdicio.
2. Proyección Basada en Interfaz:
Creamos una interfaz que defina la vista que necesitamos:
package com.miblog.proyecciones.projection;

public interface ProductoResumen {
    String getNombre();
    double getPrecio();
    // También puedes tener valores calculados con SpEL:
    // @Value("#{target.nombre + ' (' + target.categoria + ')'}")
    // String getNombreConCategoria();
}
3. Repositorio Spring Data JPA:
Modificamos nuestro repositorio para usar la proyección:
package com.miblog.proyecciones.repository;

import com.miblog.proyecciones.entity.Producto;
import com.miblog.proyecciones.projection.ProductoResumen;
import org.springframework.data.jpa.repository.JpaRepository;
import org.springframework.stereotype.Repository;

import java.util.List;

@Repository
public interface ProductoRepository extends JpaRepository<Producto, Long> {

    // Spring Data JPA detecta que el tipo de retorno es una interfaz
    // y automáticamente aplica la proyección.
    List<ProductoResumen> findByStockGreaterThan(int stockMinimo);

    // Ejemplo con DTO (requiere definir la clase ProductoDTO)
    /*
    @Query("SELECT NEW com.miblog.proyecciones.dto.ProductoDTO(p.nombre, p.precio) FROM Producto p WHERE p.stock > :stockMinimo")
    List<ProductoDTO> findDtoByStockGreaterThan(@Param("stockMinimo") int stockMinimo);
    */

    // También es posible usar proyecciones dinámicas:
    // <T> List<T> findByCategoria(String categoria, Class<T> type);
    // Al llamar: productoRepository.findByCategoria("Electrónicos", ProductoResumen.class);
    // O         productoRepository.findByCategoria("Electrónicos", Producto.class); // Trae la entidad completa
}
4. Uso en un Servicio (Ejemplo):
package com.miblog.proyecciones.service;

import com.miblog.proyecciones.projection.ProductoResumen;
import com.miblog.proyecciones.repository.ProductoRepository;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.stereotype.Service;

import java.util.List;

@Service
public class ProductoService {

    @Autowired
    private ProductoRepository productoRepository;

    public List<ProductoResumen> obtenerResumenProductosEnStock() {
        // Solo se traerán las columnas 'nombre' y 'precio' de la BD
        return productoRepository.findByStockGreaterThan(0);
    }
}
Al ejecutar obtenerResumenProductosEnStock(), Spring Data JPA generará una consulta SQL similar a:
SELECT p.nombre AS nombre, p.precio AS precio
FROM producto p
WHERE p.stock > 0; -- O el valor pasado como parámetro
Como puedes ver, la columna descripcionDetallada (y las demás no incluidas en ProductoResumen) ni siquiera se mencionan en el SELECT, logrando nuestro objetivo de eficiencia.
Conclusión:
No recuperar datos innecesarios de la base de datos es fundamental para construir aplicaciones performantes y escalables. Las proyecciones en JPA, especialmente con las facilidades que ofrece Spring Data JPA, son una herramienta poderosa y elegante para lograr este objetivo.
Adoptar el uso de proyecciones (ya sea basadas en interfaces o DTOs) siempre que no necesites la entidad completa debería considerarse una buena práctica estándar. Te permite:
- Minimizar la carga en la red y la base de datos.
- Reducir el consumo de memoria en tu aplicación.
- Acelerar los tiempos de respuesta.
- Escribir código más claro respecto a los datos requeridos para cada caso de uso.
La próxima vez que escribas una consulta, pregúntate: "¿Realmente necesito todos los atributos de esta entidad?". Si la respuesta es no, considera seriamente usar una proyección. Tu aplicación (y tus usuarios) te lo agradecerán.
Transformando Colecciones con Java Streams: 15 Métodos Esenciales
- Mauricio ECR
- Arquitectura
- 29 Mar, 2025
Introducción En el mundo de Java, trabajar con colecciones de datos solía ser sinónimo de bucles interminables, condicionales anidados y código repetitivo. Pero con la llegada de Java Streams
Transformando Colecciones con Java Streams: 15 Métodos Esenciales
- Mauricio ECR
- Arquitectura
- 29 Mar, 2025
Introducción
En el mundo de Java, trabajar con colecciones de datos solía ser sinónimo de bucles interminables, condicionales anidados y código repetitivo. Pero con la llegada de Java Streams (desde Java 8), todo cambió. Los Streams introdujeron un paradigma funcional y declarativo que permite manipular datos de manera eficiente, legible y elegante.
¿Imaginas poder filtrar, transformar, agrupar o reducir elementos con solo unas líneas de código? Los métodos de los Streams hacen esto posible, convirtiendo operaciones complejas en secuencias intuitivas. Pero para aprovecharlos al máximo, es clave conocer sus herramientas principales.
Aquí te presentamos un listado detallado de los métodos más poderosos de los Streams, divididos en dos categorías: métodos generales y métodos de agrupación. Descubre cómo dominarlos puede simplificar tu código, potenciar tu productividad y desbloquear nuevas posibilidades en el manejo de datos.
Listado de Métodos de Java Streams
Métodos Generales
- filter(Predicate<? super T> predicate)
Filtra los elementos que cumplen con una condición.List<Integer> numeros = Arrays.asList(5, 12, 3, 20); List<Integer> mayoresA10 = numeros.stream() .filter(x -> x > 10) .collect(Collectors.toList()); // Resultado: [12, 20] - map(Function<? super T, ? extends R> mapper)
Transforma cada elemento aplicando una función.List<String> palabras = Arrays.asList("java", "streams"); List<Integer> longitudes = palabras.stream() .map(String::length) .collect(Collectors.toList()); // Resultado: [4, 7] - flatMap(Function<? super T, ? extends Stream<? extends R>> mapper)
Aplana múltiples Streams en uno solo (útil para listas anidadas).List<List<Integer>> listaAnidada = Arrays.asList( Arrays.asList(1, 2), Arrays.asList(3, 4) ); List<Integer> listaPlana = listaAnidada.stream() .flatMap(List::stream) .collect(Collectors.toList()); // Resultado: [1, 2, 3, 4] - reduce(BinaryOperator
accumulator)
Reduce los elementos a un único valor mediante una operación (ej: suma).List<Integer> numeros = Arrays.asList(1, 2, 3, 4); Optional<Integer> suma = numeros.stream() .reduce((a, b) -> a + b); // Resultado: 10 - collect(Collector<? super T, A, R> collector)
Transforma el Stream en una colección o estructura de datos.List<String> palabras = Arrays.asList("a", "b", "c"); Set<String> set = palabras.stream() .collect(Collectors.toSet()); // Resultado: [a, b, c] (como Set) - forEach(Consumer<? super T> action)
Ejecuta una acción en cada elemento (como imprimirlo).List<String> frutas = Arrays.asList("Manzana", "Pera"); frutas.stream() .forEach(fruta -> System.out.print(fruta + " ")); // Resultado: "Manzana Pera " - sorted()
Ordena los elementos (requiere que sean comparables).List<Integer> numeros = Arrays.asList(3, 1, 4, 2); List<Integer> ordenados = numeros.stream() .sorted() .collect(Collectors.toList()); // Resultado: [1, 2, 3, 4] - distinct()
Elimina duplicados, retornando elementos únicos.List<Integer> numeros = Arrays.asList(2, 2, 5, 5); List<Integer> unicos = numeros.stream() .distinct() .collect(Collectors.toList()); // Resultado: [2, 5] - limit(long maxSize)
Limita el Stream a un número máximo de elementos.List<Integer> numeros = Arrays.asList(1, 2, 3, 4, 5); List<Integer> primeros3 = numeros.stream() .limit(3) .collect(Collectors.toList()); // Resultado: [1, 2, 3] - skip(long n)
Omite los primeros n elementos del Stream.List<Integer> numeros = Arrays.asList(1, 2, 3, 4, 5); List<Integer> sinPrimeros2 = numeros.stream() .skip(2) .collect(Collectors.toList()); // Resultado: [3, 4, 5]
Métodos para Agrupar Elementos
- Collectors.groupingBy(Function<? super T, ? extends K> classifier)
Agrupa elementos por una clave (ej: edad de una persona).List<Persona> personas = Arrays.asList( new Persona("Ana", 25), new Persona("Luis", 25) ); Map<Integer, List<Persona>> porEdad = personas.stream() .collect(Collectors.groupingBy(Persona::getEdad)); // Resultado: {25=[Ana, Luis]} - Collectors.partitioningBy(Predicate<? super T> predicate)
Divide el Stream en dos grupos: los que cumplen y no cumplen un predicado.// Agrupar por categoría + stock mayor a 5 Map<String, List<Producto>> porCategoriaYStock = productos.stream() .collect(Collectors.groupingBy(p -> p.getCategoria() + "-" + (p.getStock() > 5 ? "AltoStock" : "BajoStock") )); /* Resultado: { "Electrónica-AltoStock": [Laptop, Smartphone], "Ropa-AltoStock": [Camisa] } */ - Collectors.groupingBy(classifier, downstream)
Agrupa y luego aplica un segundo colector a cada grupo (ej: contar elementos).// Precio promedio por categoría Map<String, Double> precioPromedio = productos.stream() .collect(Collectors.groupingBy( Producto::getCategoria, Collectors.averagingDouble(Producto::getPrecio) )); /* Resultado: { "Electrónica": 1000.0, "Ropa": 40.0 } */ - Collectors.groupingBy(classifier, mapFactory, downstream)
Agrupa usando un tipo de mapa específico (ej: TreeMap).// Agrupar por rangos de precios Map<String, List<Producto>> porRangoPrecio = productos.stream() .collect(Collectors.groupingBy(p -> { if (p.getPrecio() < 100) return "Económico"; else if (p.getPrecio() < 1000) return "Medio"; else return "Premium"; })); /* Resultado: { "Premium": [Laptop], "Medio": [Smartphone], "Económico": [Camisa] } */ - Agrupar con downstream complejo (ej: contar y sumar stock)
// Por categoría: cantidad de productos y stock total
Map<String, Map<String, Object>> estadisticas = productos.stream()
    .collect(Collectors.groupingBy(
        Producto::getCategoria,
        Collectors.collectingAndThen(
            Collectors.toList(),
            lista -> {
                int cantidad = lista.size();
                int stockTotal = lista.stream().mapToInt(Producto::getStock).sum();
                return Map.of("Cantidad", cantidad, "Stock Total", stockTotal);
            }
        )
    ));
/*
Resultado:
{
  "Electrónica": {"Cantidad": 2, "Stock Total": 15},
  "Ropa": {"Cantidad": 1, "Stock Total": 20}
}
*/
Conclusión
Dominar los métodos de Java Streams no solo simplifica tu código, sino que también mejora su legibilidad y eficiencia. Al explorar y aplicar estos métodos, descubrirás nuevas formas de manipular colecciones de datos que pueden transformar tu enfoque en el desarrollo de software. ¡Sigue profundizando y experimentando con Java Streams para desbloquear todo su potencial!