El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
- Mauricio ECR
- Arquitectura
- 12 Sep, 2026
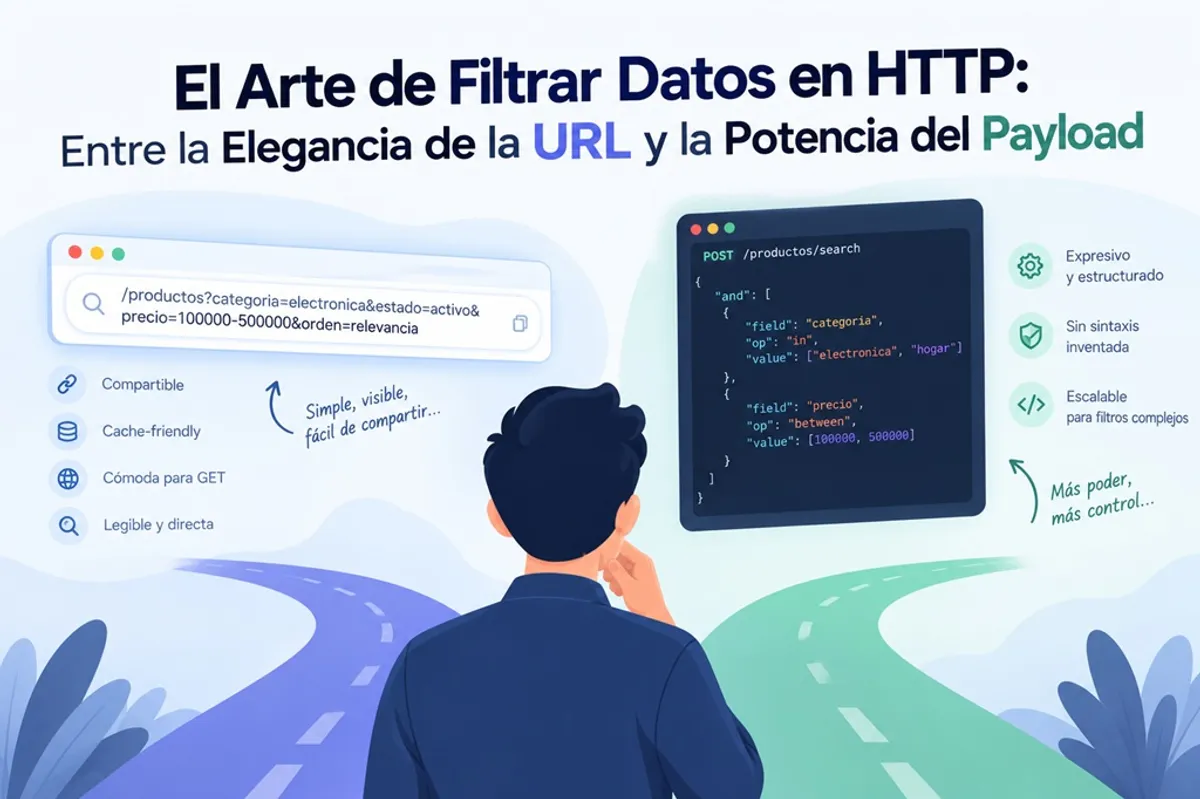
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
Seguro que alguna vez empezaste con un endpoint de listado que parecía no necesitar demasiado. Un par de filtros simples: nombre, categoría, quizá un estado. Todo cabía cómodamente en una URL como ?categoria=electronica&estado=activo, era fácil de leer y nadie tenía demasiadas razones para cuestionar la decisión.
El problema aparece cuando esa pantalla deja de ser simple.
Alguien de producto pide filtrar por varias categorías al mismo tiempo, añadir un rango de precios, restringir por fecha de publicación y, además, ordenar por relevancia. Nada especialmente extraño: es el tipo de evolución que termina teniendo cualquier sistema de búsqueda que crece un poco. Lo que cambia no es la necesidad funcional, sino la dificultad de representar esa necesidad dentro de HTTP.
Y es ahí donde una decisión que parecía puramente sintáctica empieza a afectar cosas bastante más importantes: la legibilidad de las URLs, su capacidad para compartirse, el caché, la infraestructura que las procesa y, finalmente, la forma en que el propio código del backend tiene que recibirlas.
Cuando los filtros dejan de caber cómodamente en una URL
La primera reacción suele ser intentar mantener el modelo que ya funciona y llevarlo un poco más lejos. Si un parámetro alcanza para un filtro, quizá varios parámetros puedan representar varios filtros.
Pronto aparece algo parecido a esto:
filter[0][field]=categoria&filter[0][op]=in&filter[0][value][]=electronica&filter[0][value][]=hogar&filter[1][field]=precio&filter[1][op]=between&filter[1][value][]=100000&filter[1][value][]=500000El problema no es que esta representación sea imposible. El problema es que, a medida que aumenta la complejidad, empieza a depender de una sintaxis que la propia API tiene que inventar y documentar. No existe una convención universal que garantice que otro equipo, otro framework o incluso otro endpoint vaya a interpretar exactamente esa estructura de la misma manera.
Con dos condiciones todavía se puede tolerar. Con tres o cuatro, la URL deja de comunicar lo que está ocurriendo y pasa a convertirse en una estructura que hay que descifrar.
La siguiente idea parece más atractiva precisamente porque elimina esa sintaxis inventada: si el filtro es estructurado, ¿por qué no representarlo directamente como JSON?
Por ejemplo:
{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    }
  ]
}
Conceptualmente es mucho mejor. La estructura expresa exactamente lo que se quiere consultar y no hace falta inventar una notación propia para representar operadores, campos y valores.
El problema llega cuando ese JSON tiene que viajar dentro de una URL.
Después de aplicar URL encoding, una estructura que originalmente era legible termina convertida en una secuencia como esta:
%7B%22and%22%3A%5B%7B%22field%22%3A%22categoria%22%2C%22op%22%3A%22in%22%2C%22value%22%3A%5B%22electronica%22%2C%22hogar%22%5D%7D%5D%7DLa información sigue estando ahí. El problema es que dejó de ser visible.
Esto parece una molestia estética hasta que aparece un caso real de diagnóstico. Una URL así puede terminar en un mensaje de chat del equipo, en Postman, en un log de producción o en un ticket donde alguien intenta explicar por qué una búsqueda devolvió resultados inesperados. En ninguno de esos escenarios resulta evidente qué filtro representa la cadena.
Hay que decodificarla antes de poder entenderla.
Y entonces aparece una tercera posibilidad, casi inevitable: abandonar la URL y enviar el JSON en el body de un POST.
La solución fácil también cambia el contrato
La propuesta de utilizar POST tiene una ventaja evidente: el filtro vuelve a verse exactamente como lo que es.
POST /productos/search
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Desde el punto de vista de representación, es probablemente la solución más cómoda. Pero resuelve el problema de legibilidad introduciendo otro: la búsqueda ya no está contenida en una URL que pueda copiarse, pegarse y compartir como un recurso de lectura.
Además, aunque el caché de respuestas POST es posible con configuraciones específicas, no tiene la misma interoperabilidad ni la misma naturalidad que el caché de un GET. Una petición GET encaja directamente con las expectativas de navegadores, proxies, CDN y clientes HTTP para operaciones de lectura.
Esto no significa que POST sea incorrecto. Significa que, al elegirlo, se está renunciando deliberadamente a ciertas propiedades.
Y esa distinción es importante porque permite formular mejor el problema. No se trata de encontrar una opción universalmente correcta entre query params, JSON en la URL y POST. Se trata de decidir qué propiedad del contrato HTTP se necesita conservar.
Si la búsqueda debe poder compartirse como enlace y además interesa mantenerla como GET, todavía quedan alternativas que merece la pena explorar — y antes de comprometerse con una, conviene entender de qué depende cada una.
Dos caminos para conservar el GET, con distinta dependencia
Cuando la meta es mantener la búsqueda como GET compartible sin caer en URLs ilegibles, hay dos familias de solución, y no son intercambiables porque no piden lo mismo al resto del sistema.
Una es codificar el filtro tal cual el frontend lo pensó (un objeto JSON con la forma que el dominio necesite) y transportarlo como un blob opaco en un único parámetro. Esta idea no le exige nada a la capa de persistencia: el servidor recibe una cadena, la decodifica, obtiene un JSON y lo interpreta como quiera. Es agnóstica al motor de datos por completo.
La otra es expresar el filtro directamente como una gramática de texto pensada para mapear campo-operador-valor, apoyándose en que exista una capa de acceso a datos capaz de traducir esa gramática a una consulta ejecutable. Esta idea sí depende de algo externo a la propia idea: solo funciona si hay un traductor gramática→query, típicamente provisto por un ORM con soporte de construcción dinámica de condiciones (Criteria API en el mundo Java, query builders equivalentes en otros stacks).
Esa diferencia — necesitar o no una capa de traducción externa — es la que determina cuál conviene en cada caso, y conviene resolverla antes de escribir una sola línea de código.
El camino agnóstico: JSON opaco vía Base64URL
Cuando el filtro es estructurado pero sigue siendo razonablemente pequeño, una posibilidad es serializarlo como JSON y después codificar ese JSON utilizando Base64URL.
El flujo conceptual es sencillo:
- Se construye el filtro como un objeto.
- Se serializa a JSON.
- Ese JSON se codifica mediante Base64URL.
- El resultado se envía como un único parámetro de query.
- El servidor lo decodifica y recupera nuevamente el JSON.
La diferencia importante es que no se intenta hacer legible el contenido del filtro dentro de la URL. Se acepta que sea opaco, pero se consigue que la representación sea mucho más adecuada para convivir con la sintaxis de una URL.
También conviene precisar el nombre. No se trata simplemente de Base64 tradicional.
Base64 utiliza caracteres como +, / y =, que pueden requerir tratamiento adicional cuando aparecen dentro de una URL. Base64URL, definido en la sección 5 del RFC 4648, utiliza - y _ en lugar de esos caracteres y permite omitir el padding cuando el protocolo que lo utiliza lo contempla.
Tomemos el filtro completo:
{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Después de codificarlo, la petición puede quedar así:
GET /productos?filter=eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhIiwib3AiOiJpbiIsInZhbHVlIjpbImVsZWN0cm9uaWNhIiwiaG9nYXIiXX0seyJmaWVsZCI6InByZWNpbyIsIm9wIjoiYmV0d2VlbiIsInZhbHVlIjpbMTAwMDAwLDUwMDAwMF19XX0La cadena sigue siendo opaca. No pretende ser legible para una persona. Pero ya no está dominada por secuencias %XX, y lo más importante es que la operación continúa siendo un GET.
Eso permite conservar varias propiedades útiles: la búsqueda puede copiarse, guardarse y compartirse como enlace y, cuando la infraestructura está configurada para ello, la respuesta puede aprovechar el caché asociado a una petición GET.
Hay, eso sí, una condición que no conviene esconder: el filtro debe seguir teniendo un tamaño razonable. Si la consulta contiene decenas de condiciones, listas enormes o estructuras profundamente anidadas, el problema deja de ser cómo codificarla y empieza a ser cuánto sentido tiene seguir transportándola dentro de una URL.
Pero para una búsqueda con un conjunto moderado de filtros, Base64URL puede ser un punto intermedio razonable.
Lo que queda pendiente es hacer que el backend pueda consumir esa representación sin convertir cada controlador en responsable de la decodificación.
El camino dependiente de la persistencia: RSQL
Existe otra manera de mantener el GET sin sacrificar legibilidad, pero que parte de una premisa distinta: en lugar de esconder el filtro dentro de un blob opaco, expresarlo directamente como texto legible dentro del propio query param.
RSQL es una extensión de FIQL (Feed Item Query Language) que permite escribir eso: una gramática de comparaciones encadenadas con AND/OR, pensada para mapear uno a uno contra atributos de una entidad. La URL sigue siendo un GET, sigue siendo compartible, y además no pierde legibilidad:
GET /productos?filter=categoria=in=(electronica,hogar);precio=ge=100000;precio=le=500000El punto y coma es AND, la coma es OR, los paréntesis agrupan. Los paths de relaciones se escriben con notación de punto:
GET /productos?filter=marca.pais==Argentina;estado!=suspendidoComparado con Base64URL, la ganancia es evidente: no hace falta decodificar nada para entender qué se está pidiendo. La cadena es el filtro.
Pero esa legibilidad no es gratis, y ahí está el punto que conviene no pasar por alto: RSQL no resuelve nada por sí mismo. Es una gramática de texto; alguien tiene que parsearla y, sobre todo, alguien tiene que traducirla a una consulta ejecutable contra el almacenamiento real. A diferencia de Base64URL — donde el servidor simplemente decodifica y deserializa un JSON con sus propias reglas —, RSQL necesita que exista, entre el parser y la base de datos, una capa capaz de convertir cada nodo de comparación en una condición de persistencia. Sin esa capa, RSQL es solo una cadena de texto sin ningún lugar donde ejecutarse.
En el ecosistema Java, esa capa la provee típicamente la Criteria API de JPA a través de una Specification, y existen librerías (no oficiales de Spring, sino de terceros) que hacen ese puente automáticamente. En otros stacks el concepto se mantiene — una gramática campo-operador-valor traducida a un query builder dinámico —, pero el mecanismo concreto cambia según el ORM disponible. Quien quiera ver cómo se ve esa integración en un proyecto Spring Boot real puede saltar directamente al anexo al final del artículo.
Esa dependencia tiene además una consecuencia de seguridad que conviene resolver antes de decidirse por este camino, no después.
El vector de seguridad que ninguna gramática resuelve por defecto
Cualquier mecanismo que traduzca texto libre a una condición de persistencia enfrenta el mismo riesgo, independientemente del lenguaje o el framework: el parser no sabe, por sí solo, qué campos del modelo deberían ser alcanzables desde afuera.
Si una entidad tiene una relación hacia otra entidad con datos sensibles, nada en la gramática impide que un consumidor intente comparar directamente contra esos campos:
GET /productos?filter=usuario.password==algo
GET /productos?filter=usuario.resetToken==abc123
El sistema no devolvería esos valores en el body, pero sí variaría el número de resultados según si la condición se cumple o no. Es suficiente para montar un ataque de oráculo e inferir, comparación a comparación, valores que nunca deberían ser accesibles desde un filtro de listado.
La mitigación es siempre la misma en cualquier stack: recorrer la estructura del filtro ya parseado (su AST) antes de ejecutar la consulta y rechazar cualquier campo que no esté en una allowlist explícita, y componer esa consulta junto con las condiciones base que el usuario nunca debería poder eludir (soft-delete, tenant, permisos).
Esto es exactamente lo que distingue este camino del de Base64URL con un DTO tipado: ahí, los campos filtrables son exactamente los que el desarrollador declaró en la clase. No hay forma de filtrar por usuario.resetToken si ese campo no existe en el tipo — la allowlist es estructural, la garantiza el propio DTO. En el camino de la gramática de texto, en cambio, la allowlist es una responsabilidad operacional: hay que construirla y mantenerla activamente, y es un paso que se puede omitir bajo presión sin que nada lo impida a nivel de compilación.
Cuándo conviene cada camino
La pregunta que separa un camino del otro no es cuál es “mejor”, sino qué tan bien el filtro se mapea contra atributos simples de una entidad persistida:
- Si los filtros son AND/OR sobre atributos que existen tal cual en el modelo de datos, y se cuenta con una capa de persistencia capaz de traducir esa gramática (Specification, Criteria API o equivalente), una gramática de texto como RSQL resuelve el problema con muy poco código y conserva la legibilidad de la URL — a cambio de mantener activamente una allowlist.
- Si el contrato del filtro es propio del dominio, con operadores específicos, estructuras anidadas particulares o simplemente no hay (o no se quiere depender de) una capa de traducción gramática→persistencia, Base64URL con un DTO tipado ofrece un contrato explícito, no le pide nada al motor de datos, y su allowlist es estructural en lugar de operacional.
Esta bifurcación es la que después vuelve a aparecer, ya formalizada, en el árbol de decisión al final del artículo.
Llevar la idea de Base64URL a un endpoint real con Spring Boot
En cualquier framework aparece la misma pregunta: alguien tiene que recibir el parámetro, decodificarlo, convertir el JSON en el DTO correspondiente y manejar los errores que puedan producirse durante el proceso.
En Spring Boot, la solución más directa consiste en hacerlo dentro del controlador:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @RequestParam("filter") String filterBase64,
        ObjectMapper objectMapper) throws IOException {

    byte[] jsonBytes = Base64.getUrlDecoder().decode(filterBase64);

    FiltroProductosDto filtro =
            objectMapper.readValue(jsonBytes, FiltroProductosDto.class);

    return ResponseEntity.ok(productoService.buscar(filtro));
}
Para un solo endpoint, no hay nada especialmente problemático en este enfoque. El inconveniente aparece cuando el sistema crece.
Si existen diez endpoints de búsqueda, probablemente aparezcan diez implementaciones prácticamente iguales. Y entonces la cuestión deja de ser si podemos decodificar Base64URL y pasa a ser si queremos mantener esa lógica repartida por todos los controladores.
En ese punto aparecen problemas de consistencia bastante concretos.
¿Todos los endpoints manejan el padding de la misma forma? ¿Todos distinguen entre un Base64URL inválido y un JSON inválido? ¿Todos responden de la misma manera cuando falta el parámetro? ¿Todos deserializan el contenido con las mismas reglas? ¿Todos aplican las mismas validaciones?
La duplicación empieza a convertir una decisión de transporte en una responsabilidad del código de negocio.
Una solución más limpia consiste en hacer que el controlador reciba directamente el DTO que necesita:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(productoService.buscar(filtro));
}
El controlador ya no necesita saber que el filtro llegó codificado. Esa información pertenece a la capa que transforma la petición HTTP en los argumentos del método.
Spring MVC proporciona precisamente un mecanismo para realizar esa transformación: HandlerMethodArgumentResolver.
Sacar la infraestructura del controlador
El primer paso es definir una anotación que identifique los parámetros que deben resolverse mediante este mecanismo:
import java.lang.annotation.*;

@Target(ElementType.PARAMETER)
@Retention(RetentionPolicy.RUNTIME)
public @interface Base64Filter {

    String value() default "filter";
}
El valor permite mantener filter como nombre por defecto, pero también utilizar otro parámetro cuando el endpoint lo necesite:
@Base64Filter("criteria")
FiltroProductosDto filtro
La anotación por sí sola no hace la transformación. El trabajo lo realiza el resolver.
Aquí aparece además una cuestión importante que puede pasar desapercibida: cuando Spring construye automáticamente un objeto mediante mecanismos como @RequestBody, el ciclo de validación habitual puede ejecutarse de forma transparente. Cuando el objeto lo construimos manualmente dentro de un HandlerMethodArgumentResolver, esa validación no aparece automáticamente solo porque hayamos escrito @Valid.
Por eso el resolver tiene que encargarse también de esa parte.
Una implementación posible es:
@Component
public class Base64FilterArgumentResolver implements HandlerMethodArgumentResolver {

    private final ObjectMapper objectMapper;
    private final Validator validator;

    public Base64FilterArgumentResolver(ObjectMapper objectMapper, Validator validator) {
        this.objectMapper = objectMapper;
        this.validator = validator;
    }

    @Override
    public boolean supportsParameter(MethodParameter parameter) {
        return parameter.hasParameterAnnotation(Base64Filter.class);
    }

    @Override
    public Object resolveArgument(
            MethodParameter parameter,
            ModelAndViewContainer mavContainer,
            NativeWebRequest webRequest,
            WebDataBinderFactory binderFactory) throws Exception {

        Base64Filter annotation = parameter.getParameterAnnotation(Base64Filter.class);
        String paramName = annotation.value();
        String rawValue = webRequest.getParameter(paramName);
        Class<?> targetType = parameter.getParameterType();

        Object filtro;

        if (rawValue == null || rawValue.isBlank()) {
            filtro = targetType.getDeclaredConstructor().newInstance();
        } else {
            try {
                byte[] jsonBytes = Base64.getUrlDecoder().decode(rawValue);
                filtro = objectMapper.readValue(jsonBytes, targetType);
            } catch (IllegalArgumentException e) {
                throw new FiltroInvalidoException(
                        "El parámetro '" + paramName + "' no es Base64URL válido");
            } catch (JacksonException e) {
                throw new FiltroInvalidoException(
                        "El parámetro '" + paramName + "' no contiene un JSON de filtro válido");
            }
        }

        if (parameter.hasParameterAnnotation(Valid.class)) {
            Set<ConstraintViolation<Object>> violations = validator.validate(filtro);
            if (!violations.isEmpty()) {
                throw new FiltroInvalidoException(
                        "El filtro no cumple las validaciones: " + violations);
            }
        }

        return filtro;
    }
}
Hay varias decisiones dentro de este código que conviene entender porque son parte del contrato y no simples detalles de implementación.
El método supportsParameter hace que el resolver intervenga únicamente cuando el parámetro tiene la anotación @Base64Filter. Esto mantiene el comportamiento localizado y evita que todos los parámetros de la aplicación intenten pasar por la misma lógica.
Después se obtiene el nombre del parámetro desde la anotación y se recupera su valor desde la petición. Si no existe o está vacío, el ejemplo construye una instancia vacía del DTO. Esa decisión puede ser apropiada cuando la ausencia del filtro significa “sin restricciones”, pero no debería convertirse en una regla universal. Si en el dominio la ausencia del parámetro tiene otro significado, ese comportamiento debe reflejarlo.
Cuando sí existe un valor, primero se decodifica Base64URL y después se deserializa el JSON utilizando ObjectMapper.
Las dos operaciones pueden fallar por motivos diferentes, y distinguirlas permite devolver mensajes de error más útiles. Un contenido que no es Base64URL válido no representa el mismo problema que una cadena correctamente codificada que contiene un JSON malformado.
Una vez construido el objeto, el resolver comprueba si el parámetro utiliza @Valid. Solo en ese caso ejecuta explícitamente Bean Validation.
Eso permite mantener en el DTO las reglas habituales:
public class FiltroProductosDto {

    @Size(
        max = 10,
        message = "No se permiten más de 10 categorías"
    )
    private List<String> categorias;

    @Min(0)
    private Long precioMinimo;

    @Min(0)
    private Long precioMaximo;

    // getters y setters
}
De esta manera, colocar @Valid junto con @Base64Filter activa las validaciones sintácticas habituales sin introducir lógica adicional en el controlador.
Es importante, sin embargo, no confundir validación sintáctica con validación de negocio.
Una regla como “no se permiten más de diez categorías” o “el precio mínimo no puede ser negativo” pertenece naturalmente a esta capa. En cambio, comprobar que precioMinimo sea menor que precioMaximo, que una categoría exista realmente o que determinado filtro esté permitido para un usuario concreto puede requerir información que el resolver no debería conocer.
Esas decisiones pertenecen a una capa posterior, normalmente al servicio o a la lógica de dominio.
Registrar el resolver y completar la separación
Una vez creado el resolver, hay que registrarlo en Spring MVC:
@Configuration
public class WebConfig implements WebMvcConfigurer {

    private final Base64FilterArgumentResolver resolver;

    public WebConfig(Base64FilterArgumentResolver resolver) {
        this.resolver = resolver;
    }

    @Override
    public void addArgumentResolvers(List<HandlerMethodArgumentResolver> resolvers) {
        resolvers.add(resolver);
    }
}
A partir de ahí, el controlador puede mantenerse completamente centrado en su responsabilidad:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(
            productoService.buscar(filtro)
    );
}
El beneficio real de esta arquitectura no es que Spring haya aprendido a decodificar Base64URL. El beneficio es haber separado dos decisiones que no deberían estar mezcladas.
Una decisión responde a cómo viaja el filtro por HTTP.
La otra responde a qué filtro necesita el caso de uso.
El controlador solo debería preocuparse por la segunda.
Cuando llegue el endpoint de búsqueda número once, no será necesario copiar la misma secuencia de decodificación, deserialización y validación. El mecanismo de transporte queda encapsulado en una pieza transversal y los endpoints pueden expresar únicamente el contrato que necesitan.
Pero conseguir que el código quede limpio no significa que el diseño esté terminado. Hay varias cuestiones que el resolver no puede solucionar por sí solo.
Codificar no significa proteger
La primera es seguridad.
Base64URL no cifra el contenido. Tampoco lo convierte en secreto. Cualquier persona que tenga acceso a la cadena puede decodificarla y recuperar el JSON original.
Por eso nunca debe interpretarse la codificación como una medida de protección.
Después de deserializar el filtro siguen siendo necesarias las comprobaciones correspondientes: campos permitidos, operadores válidos, tipos esperados, tamaños máximos y, cuando la estructura lo permita, profundidad máxima de anidamiento.
Esto es especialmente relevante cuando el filtro admite estructuras complejas. Una petición puede ser perfectamente válida desde el punto de vista sintáctico y, aun así, provocar un consumo excesivo de CPU o memoria si el servidor acepta estructuras arbitrariamente grandes o profundas.
La validación, por tanto, no es un accesorio que se añade después de implementar Base64URL. Forma parte del contrato de entrada.
Los errores también forman parte del diseño
El segundo punto es el manejo de errores.
El resolver puede lanzar FiltroInvalidoException, pero eso no significa que cada controlador deba capturarla individualmente. La aplicación puede centralizar la conversión de esa excepción en una respuesta HTTP uniforme:
@RestControllerAdvice
public class FiltroExceptionHandler {

    @ExceptionHandler(FiltroInvalidoException.class)
    public ResponseEntity<ErrorResponse> handleFiltroInvalido(FiltroInvalidoException ex) {
        return ResponseEntity.badRequest().body(new ErrorResponse(ex.getMessage()));
    }
}
Esto elimina otro nivel de duplicación, pero todavía conviene conservar internamente las distintas categorías de fallo.
No es lo mismo recibir un Base64URL inválido que recibir un JSON malformado. Tampoco es lo mismo un JSON válido que no puede convertirse al DTO esperado, un DTO que incumple las validaciones, o un filtro completamente válido que no está permitido para determinado usuario.
No siempre es necesario exponer todas esas diferencias al consumidor. De hecho, en algunos casos sería contraproducente. Pero mantenerlas diferenciadas internamente puede resultar decisivo cuando haya que investigar un comportamiento extraño en producción.
La uniformidad hacia fuera no debería implicar perder información hacia dentro.
Si el consumidor no sabe qué codificar, el contrato está incompleto
Hay todavía otra pieza que suele olvidarse porque no afecta directamente al funcionamiento del endpoint: la documentación.
Una anotación personalizada como @Base64Filter no necesariamente será interpretada automáticamente por herramientas como springdoc-openapi como un parámetro de query convencional. Si el consumidor no recibe una explicación explícita, terminará teniendo que averiguar por su cuenta cómo construir la cadena.
Por ejemplo:
@Operation(
    summary = "Búsqueda de productos con filtro estructurado"
)
@Parameter(
    name = "filter",
    description =
        "Filtro JSON codificado en Base64URL según RFC 4648 §5",
    example =
        "eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhIn1dfQ",
    schema = @Schema(type = "string")
)
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(
            productoService.buscar(filtro)
    );
}
Una buena documentación debería mostrar las dos representaciones.
Por un lado, el JSON conceptual que el consumidor realmente quiere expresar. Por otro, la cadena Base64URL que debe enviar.
La transformación puede ser transparente para el servidor, pero no debe ser un misterio para quien consume la API.
El coste que aparece después: una URL que ya no se puede leer
Hasta este punto, Base64URL parece haber conseguido un equilibrio bastante atractivo: mantiene GET, conserva una URL autocontenida y evita llenar el query string de secuencias de escape.
Pero ese equilibrio tiene un precio evidente.
La URL deja de ser legible.
Un log como este:
GET /productos?filter=eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhI...no permite saber inmediatamente qué filtros se utilizaron.
Y eso importa especialmente porque las URLs aparecen en muchos lugares que no están bajo el control directo del desarrollador que diseñó el endpoint: logs de servidores, herramientas de monitoreo, historial del navegador, sistemas de analítica y mecanismos de diagnóstico.
Es exactamente el costo que, como vimos antes, RSQL evita — a cambio de pedir una capa de traducción a persistencia y una allowlist mantenida activamente. Ninguna de las dos alternativas gana en todo; cada una conserva una propiedad distinta.
Cuándo RSQL se queda corto
Incluso en el escenario donde sí conviene la gramática de texto — filtros que mapean bien a atributos y operadores relacionales estándar —, hay límites concretos donde deja de alcanzar.
El primero es semántica propia. Un operador =between= con dos valores puede registrarse como extensión del parser, pero si el dominio necesita expresar algo como un rango con extremos configurables o un operador geoespacial con parámetros propios, la gramática obliga a inventar una notación que ya no es estándar. El DTO tipado puede incluir esos campos con semántica explícita.
El segundo es correlación en colecciones. Si Producto tiene una lista de Variante y la consulta necesita encontrar productos que tengan una variante que sea simultáneamente roja y con stock mayor a cero, una traducción directa campo-operador-valor genera un JOIN que evalúa las condiciones por separado. Puede devolver un producto con una variante roja sin stock y otra variante con stock pero de distinto color. Para expresar esa correlación hace falta un subquery o un EXISTS, que la gramática no modela.
El tercero es contexto de runtime. Un score de relevancia calculado en el momento de la petición, una distancia geoespacial o un ranking de machine learning no tienen representación natural como par campo-operador-valor.
Cuando el filtro cruza alguno de esos límites, Base64URL con DTO tipado vuelve a ser la opción más honesta: el contrato es explícito, los campos posibles están acotados por el tipo y la estructura puede ser tan específica como lo exija el dominio.
Cuando el filtro crece, el problema deja de ser de codificación
Hasta aquí estamos hablando de un escenario bastante concreto: filtros estructurados pero todavía razonablemente pequeños.
La situación cambia cuando la consulta empieza a crecer.
Decenas de condiciones. Listas extensas de identificadores. Estructuras anidadas varios niveles hacia abajo. Combinaciones complejas de operadores.
En ese momento, insistir en mantener todo dentro de una URL deja de ser una cuestión de encontrar una codificación más conveniente.
Se convierte en una decisión de diseño de interfaz.
Y es precisamente ahí donde POST vuelve a tener sentido, pero esta vez por una razón diferente a la del comienzo.
No se utiliza porque no hayamos encontrado una manera suficientemente ingeniosa de meter el filtro en un GET. Se utiliza porque el contrato ha cambiado y ahora el body es un lugar más apropiado para transportar una estructura grande.
POST /productos/search
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Se gana una representación natural del filtro y se evita someterlo a las limitaciones prácticas de una URL.
A cambio, la búsqueda deja de ser un recurso autocontenido en forma de enlace y pierde la misma naturalidad para el caché que tendría un GET.
Pero si el filtro ya ha alcanzado un tamaño que hace poco razonable mantenerlo en la URL, esa pérdida probablemente sea aceptable.
Una tercera posibilidad: QUERY
Existe además una alternativa más reciente que resulta conceptualmente interesante: el método HTTP QUERY.
La motivación es precisamente separar la semántica de una operación de consulta de la necesidad de transportar una estructura compleja en el body.
En teoría, encaja muy bien con el problema: una consulta segura podría mantener una semántica específica de consulta y, al mismo tiempo, recibir contenido estructurado sin tener que comprimirlo artificialmente dentro de la URL.
El inconveniente está en el ecosistema.
Que un método esté definido mediante un estándar no significa que navegadores, proxies, firewalls, gateways y otras piezas de infraestructura lo soporten con la misma madurez que GET o POST.
Por eso puede ser una opción interesante para mantener en el radar, especialmente cuando se controla de extremo a extremo la infraestructura, pero no necesariamente es la elección más conservadora para una API pública que necesita máxima interoperabilidad.
Cuando ni siquiera el body es suficiente
Hay todavía un escenario más extremo.
Supongamos que la consulta es muy grande, pero además se reutiliza constantemente. Enviar todo el filtro en cada petición puede empezar a resultar innecesario.
En ese caso, quizá el problema ya no consista en decidir cómo transportar el filtro, sino en dejar de transportarlo.
Una alternativa es convertir la búsqueda en un recurso persistente:
POST /saved-searches
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    }
  ]
}
El servidor puede almacenar esa definición y devolver un identificador:
HTTP/1.1 201 Created

Location: /saved-searches/abc123
A partir de ahí, las peticiones posteriores pueden referirse al identificador en lugar de reenviar toda la estructura.
La decisión es diferente porque también lo es el problema.
Ya no estamos intentando representar una búsqueda compleja dentro de una URL. Estamos modelando la búsqueda como un recurso que puede persistir y reutilizarse.
Del lado del frontend
Todas estas decisiones del backend tienen una contraparte en el cliente que construye la petición.
El problema no es solo cómo codificar el filtro. Es que si el filtro vive únicamente en el estado del componente, el usuario pierde la posibilidad de compartir la búsqueda, usar el botón atrás del navegador o guardarla como favorito. La URL deja de ser el estado de la pantalla.
La solución en Angular es sincronizar el filtro con los query params del Router en ambas direcciones. Cuando el usuario aplica filtros, la URL se actualiza. Cuando alguien llega con una URL que ya tiene filtros, el formulario se rellena y la búsqueda se ejecuta automáticamente.
Para Base64URL el helper de codificación es simple:
encode(filter: object): string {
  const json = JSON.stringify(filter);
  return btoa(unescape(encodeURIComponent(json)))
    .replace(/\+/g, '-')
    .replace(/\//g, '_')
    .replace(/=+$/, '');
}
Y la sincronización con el router:
// Al cambiar filtros → actualizar la URL
this.router.navigate([], {
  relativeTo: this.route,
  queryParams: { filter: this.encode(filter) },
  queryParamsHandling: 'merge'
});

// Al inicializar → leer filtros de la URL
this.route.queryParams.pipe(
  map(params => params['filter']),
  filter(Boolean),
  map(encoded => this.decode(encoded))
).subscribe(filter => {
  this.applyToForm(filter);
  this.search(filter);
});
Para RSQL la mecánica es idéntica. Solo cambia el formato del string que viaja en el param: en lugar de Base64URL opaco viaja una cadena legible como categoria=in=(electronica,hogar);precio=ge=100000. El router no distingue entre uno y otro.
Volver a aquella URL de 400 caracteres
Aquella URL llena de %7B%22and%22%3A no era realmente un problema de sintaxis.
Era una señal.
La complejidad de la consulta había empezado a superar la comodidad del mecanismo elegido para transportarla, pero todavía no se había tomado una decisión consciente sobre qué propiedad del contrato era importante conservar.
Si los filtros se mapean bien a campos de una entidad persistida y a operadores relacionales estándar, una gramática de texto como RSQL resuelve el problema con muy poco código y conserva la legibilidad de la URL — a costa de depender de una capa de traducción a persistencia y de mantener activamente una allowlist. Si el contrato del filtro es propio del dominio, con operadores específicos o estructuras que no encajan en el modelo relacional directo, Base64URL con DTO tipado ofrece un contrato explícito, no depende de ningún motor de datos particular, y su allowlist es estructural en lugar de operacional.
flowchart TD
    A[¿Qué tipo de filtros necesitás?] --> B
    A --> C
    A --> D
    A --> E

    B["Campos simples\nsin lógica compleja"]
    --> F["QueryDSL Web Bindings\nCero código, nativo Spring Data"]

    C["AND / OR sobre atributos\nde una entidad persistida"]
    --> G{¿Existe una capa que traduzca\ngramática de texto a persistencia?}
    G -->|Sí| H["RSQL / gramática similar\nCon allowlist explícita"]
    G -->|No| D

    D["Operadores custom\nlógica de dominio\ncolecciones correlacionadas"]
    --> I{¿Necesitás URL compartible?}
    I -->|Sí, filtro moderado| J["Base64URL + HandlerMethodArgumentResolver"]
    I -->|No, o filtro grande| K["POST /search\nBody JSON estructurado"]

    E["Filtros enormes\nreutilizados entre sesiones"]
    --> L["saved-searches como recurso\nPOST para crear, GET con ID para reutilizar"]
Cuando el filtro deja de ser razonablemente pequeño, el problema cambia de naturaleza. POST con JSON puede ser un contrato mucho más apropiado. Y si la búsqueda se vuelve grande y reutilizable, puede tener más sentido convertirla en un recurso persistente y referenciarla mediante un identificador.
La decisión correcta no consiste en elegir una tecnología y aplicarla a todas las búsquedas.
Consiste en reconocer que cada representación conserva unas propiedades y sacrifica otras.
Query params simples conservan una URL muy legible, pero se vuelven incómodos cuando la estructura crece. Una gramática de texto como RSQL mantiene esa legibilidad con más expresividad, pero exige que exista una capa de traducción a persistencia y una allowlist explícita mantenida activamente, o la superficie de ataque crece silenciosamente. Base64URL mantiene la búsqueda como GET y permite un contrato de filtro completamente propio, sin depender de ningún motor de datos particular, aunque sacrifica legibilidad en logs. POST recupera la representación natural del JSON cuando la consulta ya es demasiado grande. Y una búsqueda persistente elimina directamente la necesidad de reenviar una estructura que ya existe en el servidor.
El verdadero cambio, entonces, no está en Base64URL, en RSQL, en Spring Boot ni siquiera en HTTP.
Está en dejar de pedirle al mismo mecanismo que resuelva problemas de tamaños y necesidades diferentes.
Cuando una búsqueda es pequeña, puede viajar como una consulta.
Cuando necesita estructura pero todavía cabe razonablemente en una URL, puede codificarse, con la representación que mejor encaje con el contrato.
Cuando crece demasiado, puede pasar al body.
Y cuando se convierte en algo que se reutiliza como entidad propia, puede dejar de viajar por completo y convertirse en un recurso.
Ese es el criterio que permite que la arquitectura evolucione con la complejidad real del problema, en lugar de obligar a cada nueva necesidad a encajar a la fuerza en la decisión que se tomó cuando el endpoint todavía parecía sencillo.
Anexo: RSQL en el stack Java (Spring Boot + JPA)
Todo lo dicho sobre RSQL en el cuerpo del artículo es válido para cualquier stack que cuente con una capa de traducción gramática→persistencia equivalente. Este anexo muestra cómo se ve concretamente esa integración en el ecosistema Java, donde esa capa la provee la Criteria API de JPA a través de una Specification.
La integración más difundida usa un starter de terceros (no es un proyecto oficial de Spring) que convierte directamente la cadena RSQL en una Specification:
<dependency>
    <groupId>io.github.perplexhub</groupId>
    <artifactId>rsql-jpa-spring-boot-starter</artifactId>
    <version>6.0.18</version>
</dependency>@GetMapping("/productos")
public Page<Producto> buscar(
@RequestParam(defaultValue = "") String filter,
Pageable pageable) {
return productoRepository.findAll(
RSQLJPASupport.toSpecification(filter),
pageable
);
}Eso es todo el controlador. Sin anotaciones custom, sin resolver, sin ObjectMapper — la contrapartida es la dependencia externa a un motor de persistencia relacional vía JPA, que es justamente lo que el cuerpo del artículo señala como condición de existencia de este camino.
La allowlist mencionada antes se implementa recorriendo el AST que produce el parser de RSQL, antes de convertirlo en Specification, y rechazando cualquier campo fuera de lo permitido:
private void validarCamposPermitidos(String filter, Set<String> permitidos) {
    if (filter.isBlank()) return;

    new RSQLParser().parse(filter).accept(new RSQLVisitor<Void, Void>() {
        public Void visit(AndNode node, Void p) {
            node.getChildren().forEach(c -> c.accept(this, null)); return null;
        }
        public Void visit(OrNode node, Void p) {
            node.getChildren().forEach(c -> c.accept(this, null)); return null;
        }
        public Void visit(ComparisonNode node, Void p) {
            if (!permitidos.contains(node.getSelector()))
                throw new FiltroInvalidoException(
                    "Campo no permitido: " + node.getSelector());
            return null;
        }
    });
}
Y componer la Specification resultante con los filtros base que el usuario nunca debe poder eludir:
Specification<Producto> spec = RSQLJPASupport.<Producto>toSpecification(filter)
    .and((root, query, cb) -> cb.equal(root.get("eliminado"), false))
    .and((root, query, cb) -> cb.equal(root.get("tenantId"), TenantContext.get()));
En otro stack o con otro ORM, el nombre de las piezas cambia, pero el rol de cada una se mantiene: un parser de la gramática, un traductor hacia el mecanismo de consulta dinámica del ORM disponible, y una allowlist que se aplica sobre el árbol ya parseado antes de ejecutar nada contra la base de datos.