- Agile 2
- Alta disponibilidad 1
- Alternativas cloud 1
- Aop 1
- Arquitectura 3
- Arquitectura distribuida 4
- Automatizacion 3
- Aws 1
- Azure devops 1
- Base de datos 1
- Buenas practicas 22
- Cloud 1
- Colas 7
- Competing consumers 1
- Convenciones 11
- Copilot 1
- Diseno 8
- Docker 2
- Docker compose 1
- Documentacion 1
- Eda 11
- Equipos 1
- Escalabilidad 1
- Flujo de negocio 1
- Flujo de trabajo 3
- Flyway 1
- Git 4
- Gradle 3
- Herramientas digitales 1
- Ia 1
- Iam 1
- Infraestructura 2
- Java 16
- Jerarquia tecnica 1
- Jpa 1
- Jsonb 1
- Kafka 7
- Kubernetes 1
- Liderazgo en software 1
- Lineamientos 1
- Log 1
- Logging 3
- Microservicios 5
- Mongodb 1
- Monitoreo 1
- Nosql 3
- Observabilidad 4
- Open source 1
- Plugins 3
- Postgresql 2
- Privacidad 1
- Programacion funcional 1
- Programacion reactiva 4
- Rabbitmq 6
- Rotacion de talento 1
- Saga 2
- Scrum 2
- Security 1
- Seguridad 1
- Self hosting 1
- Sistemas legados 1
- Snippets 1
- Spring boot 5
- Spring mvc 2
- Sql 4
- Streams 1
- Threadlocal 1
- Trazabilidad 2
- Versionado 2
- Web 1
- Webflux 2
- Websockets 1
- Zero trust 1
Spring boot
5 artículos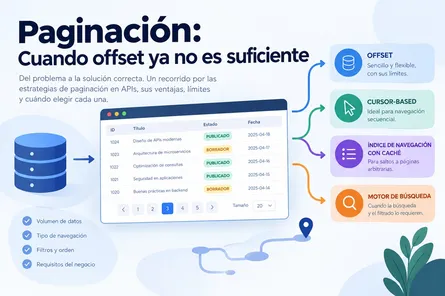
Paginacion: Cuando offset ya no es suficiente
- Mauricio ECR
- Arquitectura
- 27 Sep, 2026
Te llega la tarea y parece de las fáciles: "agregar paginación al listado de artículos". Añades ?page=0&size=20, Spring te proporciona Pageable, el repositorio hereda findAll(pageable) y, en poc
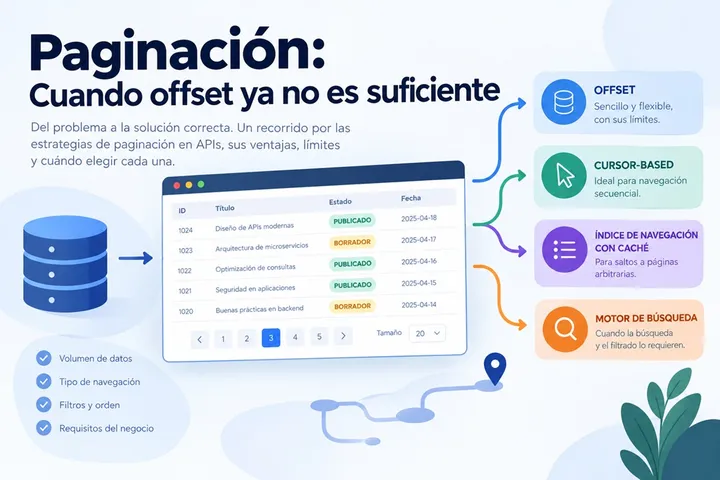
Paginacion: Cuando offset ya no es suficiente
- Mauricio ECR
- Arquitectura
- 27 Sep, 2026
Te llega la tarea y parece de las fáciles: "agregar paginación al listado de artículos". Añades ?page=0&size=20, Spring te proporciona Pageable, el repositorio hereda findAll(pageable) y, en pocos minutos, tienes un endpoint funcionando.
En desarrollo, con mil registros, todo va bien. En staging, con diez mil, probablemente también. El problema aparece más adelante, cuando la tabla alcanza cientos de miles de filas, los filtros se vuelven más complejos y los tiempos de respuesta empiezan a crecer de una forma que ya no resulta tan fácil de explicar.
Y esa lentitud no aparece porque sí. Tiene una causa concreta, relacionada con la forma en que la base de datos resuelve la consulta internamente.
El costo invisible de OFFSET
La paginación tradicional suele apoyarse en dos cláusulas SQL: LIMIT, que determina cuántos registros devolver, y OFFSET, que indica cuántos registros deben quedar fuera antes de comenzar a devolver resultados.
SELECT * FROM articulos
ORDER BY created_at DESC
LIMIT 20 OFFSET 10000;
La consulta parece directa. Pero lo que ocurre para resolverla no siempre lo es.
Para obtener los veinte registros solicitados, el motor necesita avanzar hasta la posición indicada por el OFFSET. Los registros anteriores no forman parte del resultado final, pero el trabajo necesario para llegar hasta ellos existe.
Por eso, a medida que aumenta la profundidad de la página, puede aumentar también el trabajo que debe realizar el motor. La página 1 con tamaño 20 apenas necesita avanzar. Una página mucho más profunda tiene que recorrer una cantidad considerablemente mayor de registros antes de llegar al conjunto que finalmente devolverá.
La diferencia puede ser especialmente importante en tablas grandes. Los índices ayudan a reducir el trabajo necesario, pero no eliminan por completo la naturaleza del problema: la posición se expresa como una cantidad de registros que deben quedar atrás.
Existe además otro problema, menos visible durante las pruebas: la posición de una página puede cambiar mientras el usuario navega.
Imagina que un cliente solicita la página 3 y, antes de solicitar la página 4, se inserta un nuevo registro que queda al principio del orden.
Ese nuevo registro desplaza las posiciones siguientes. Como consecuencia, el cliente puede recibir un registro que ya había visto o dejar de recibir otro que esperaba encontrar en la siguiente página.
El mismo tipo de desplazamiento puede producirse cuando se eliminan registros o cuando una modificación cambia su posición dentro del orden.
No es necesariamente un error que aparezca durante una prueba funcional. Es un comportamiento que puede hacerse visible cuando varios usuarios navegan mientras el sistema continúa recibiendo escrituras.
Tenemos, entonces, dos problemas diferentes pero relacionados:
- El costo puede aumentar a medida que se profundiza en las páginas.
- Los resultados pueden desplazarse entre una solicitud y la siguiente cuando los datos cambian.
Estos problemas explican por qué una implementación de OFFSET que funcionaba perfectamente con una tabla pequeña puede empezar a presentar dificultades cuando cambian el volumen o la forma de utilizar el endpoint.
Pero todavía no podemos concluir que haya que reemplazar OFFSET.
La pregunta siguiente es otra: ¿qué características tiene el caso de uso que estamos intentando resolver?
Las variables que realmente determinan la solución
No existe una única solución para todos los escenarios de paginación. La estrategia adecuada depende de cómo se navegan los resultados, cómo se filtran, cómo se ordenan y cuánto crecerán los datos.
Antes de comparar alternativas, conviene responder cuatro preguntas.
La primera es probablemente la más importante:
¿El usuario navega secuencialmente o necesita saltar a páginas arbitrarias?
Navegar secuencialmente significa avanzar a partir del resultado anterior: siguiente, anterior, scroll infinito o cualquier otra interfaz en la que el usuario recorre los resultados de forma progresiva.
La navegación aleatoria es diferente. Aquí el usuario puede seleccionar directamente una página concreta, por ejemplo la 53, sin haber recorrido las anteriores.
Esta diferencia es fundamental porque algunas estrategias utilizan precisamente el resultado anterior como punto de referencia. Si el usuario necesita saltar directamente a una posición arbitraria, ese modelo deja de encajar tan bien.
La segunda pregunta aparece cuando entran en juego los filtros:
¿Los filtros utilizan valores discretos o rangos abiertos?
Un filtro discreto trabaja con un conjunto relativamente acotado de posibilidades: estado, categoría, autor o tipo.
Un rango abierto permite prácticamente cualquier combinación dentro de un continuo: una fecha entre X e Y, un precio entre A y B o una búsqueda de texto libre.
Esta diferencia se vuelve especialmente importante cuando se considera una estrategia basada en caché. Si existen pocas combinaciones posibles, una consulta puede reutilizar un resultado previamente calculado. Cuando las combinaciones son prácticamente infinitas, esa reutilización se vuelve mucho menos probable.
La tercera pregunta tiene que ver con el orden:
¿El orden de los resultados es estable o puede cambiar?
Un orden estable puede ser, por ejemplo, created_at DESC, acompañado de un identificador como desempate.
Un orden dinámico permite que el usuario cambie la columna o los criterios de orden durante la navegación. En ese caso, una referencia calculada para el orden anterior deja de representar correctamente la posición dentro del nuevo orden.
Finalmente está el volumen:
¿Cuántos registros existen hoy y cuánto se espera que crezca la tabla?
Una tabla con cincuenta mil registros presenta unas necesidades diferentes a una que puede alcanzar varios millones.
El volumen no determina por sí solo la solución, pero sí cambia el costo de las estrategias. Algo que resulta perfectamente razonable en una tabla pequeña puede dejar de serlo cuando aumentan la profundidad de las páginas, la cantidad de consultas y la concurrencia.
Con estas cuatro variables definidas, ya podemos comparar las alternativas de manera más precisa. Cada una resuelve una combinación diferente de necesidades y, al mismo tiempo, introduce sus propios límites.
Cuando OFFSET sigue siendo suficiente
La primera posibilidad es también la más sencilla: mantener OFFSET, pero controlar las condiciones en las que se utiliza.
Esto tiene sentido cuando el volumen es moderado, las páginas profundas son poco frecuentes y la navegación aleatoria forma parte de los requisitos.
En muchos sistemas, los usuarios rara vez llegan a páginas extremadamente profundas. Si una interfaz obliga a recorrer miles de páginas para encontrar un registro, probablemente el problema de fondo sea que falta una búsqueda o un mecanismo de filtrado más adecuado.
Por eso, establecer un límite máximo de profundidad puede ser una decisión razonable. Por ejemplo, se puede impedir que una API consulte páginas más allá de cierto límite y obligar al consumidor a utilizar filtros o búsqueda para localizar registros concretos.
El segundo elemento importante es el índice.
Supongamos que la consulta utiliza:
ORDER BY estado, created_at, id
Si esas columnas participan habitualmente en el orden y los filtros, un índice compuesto diseñado de acuerdo con el patrón real de consulta puede reducir considerablemente el trabajo necesario.
El costo asociado con la profundidad no desaparece por completo, pero puede disminuir de forma importante.
Aquí aparece una idea importante: no toda paginación necesita una arquitectura sofisticada.
Si el problema es pequeño y los requisitos son sencillos, introducir cursores, Redis o un motor de búsqueda puede añadir mucha más complejidad de la que realmente se necesita.
Cuándo encaja
OFFSET puede seguir siendo una buena opción cuando:
- El volumen es moderado.
- Las páginas profundas son poco frecuentes.
- El usuario necesita saltar a páginas arbitrarias.
- Los filtros y órdenes pueden cambiar dinámicamente.
- Se quiere mantener un contrato de API convencional basado en
pageysize. - La simplicidad de implementación es importante.
Qué no resuelve
El costo de las páginas profundas sigue existiendo.
Además, los cambios en los datos entre solicitudes pueden desplazar los resultados de una página a otra.
Cuando esas limitaciones dejan de ser aceptables, aparece una estrategia basada en una idea diferente: dejar de identificar la posición mediante un número y utilizar el propio orden de los datos como referencia.
Cuando la navegación es secuencial: cursor-based pagination
Aquí aparece la paginación basada en cursores, también conocida como keyset pagination.
La diferencia conceptual es sencilla.
Con OFFSET, la consulta pregunta:
"Dame los registros que están después de las primeras N posiciones."
Con un cursor, la consulta pregunta:
"Dame los registros que vienen después de este punto concreto del orden."
Por ejemplo:
SELECT * FROM articulos
WHERE (created_at, id) < (:ultima_fecha, :ultimo_id)
ORDER BY created_at DESC, id ASC
LIMIT 20;
En este caso, el último registro recibido se convierte en el punto de referencia para solicitar el siguiente conjunto.
La base de datos ya no necesita interpretar la página como una posición numérica. Puede utilizar los valores del orden para localizar el punto desde el que debe continuar.
Cuando existe un índice adecuado, esto permite evitar gran parte del trabajo asociado con recorrer posiciones profundas mediante OFFSET.
Por eso, la profundidad de la navegación deja de tener el mismo efecto que tenía en la estrategia anterior.
El cursor que recibe el cliente suele ser un token opaco. Puede contener los valores de las columnas utilizadas para determinar la posición y estar codificado, por ejemplo, mediante Base64URL.
El cliente no necesita conocer su estructura. Solo necesita conservarlo y devolverlo cuando solicite la siguiente página.
Esto permite que el backend cambie la representación interna del cursor sin obligar al cliente a interpretar sus componentes.
El requisito que hace posible un cursor
Para que este modelo funcione correctamente, el orden debe ser determinista.
Si varios registros tienen exactamente el mismo valor para el criterio principal, necesitamos una columna adicional que permita desempatar.
Por ejemplo:
ORDER BY created_at DESC, id ASC
Aquí created_at determina el orden principal y id permite distinguir registros que tienen la misma fecha.
Cuando el orden de negocio tiene varios niveles, todos ellos forman parte de la referencia.
Por ejemplo:
estado → created_at → id
El cursor deberá contener la información necesaria para reproducir esa posición dentro del orden.
El backend recibe el token, recupera esos valores y construye la condición correspondiente.
La contrapartida: la navegación deja de ser aleatoria
Aquí aparece la principal diferencia con OFFSET.
Un cursor representa un punto dentro del orden, no un número de página.
Por eso, si el usuario está recorriendo:
página 1 → página 2 → página 3 → página 4
es natural solicitar la siguiente posición.
Pero si quiere saltar directamente a la página 53, el cursor de esa página no puede calcularse simplemente a partir del número 53.
Esto significa que los cursores son especialmente adecuados cuando la navegación es secuencial.
No son simplemente una optimización de SQL: también representan un cambio en el contrato de la API y, en algunos casos, en la interfaz.
Una tabla tradicional basada en números de página no puede sustituirse por cursores manteniendo exactamente la misma semántica.
Cuándo encaja
La estrategia basada en cursores resulta especialmente apropiada para:
- Feeds.
- Historiales.
- Scroll infinito.
- Exportaciones secuenciales.
- Integraciones entre servicios.
- Tablas de gran volumen.
- Sistemas con escrituras frecuentes.
- Casos en los que el usuario no necesita saltar a una página arbitraria.
Qué no resuelve
No permite una navegación aleatoria equivalente a page=53.
Además, necesita un orden estable y determinista.
Cuando el requisito de navegación aleatoria es obligatorio, debemos buscar otra estrategia.
Cuando necesitas saltar directamente a una página
Supongamos ahora que el volumen es grande y que el usuario sí necesita ir directamente a una página concreta.
En ese caso, un cursor no encaja con el requisito principal de la interfaz.
Una posibilidad consiste en separar dos problemas que hasta ahora estaban mezclados: determinar qué registros ocupan cada posición y recuperar después los datos de esas posiciones.
La idea es construir un índice de navegación que contenga únicamente los identificadores de los registros que cumplen el filtro, en el orden correspondiente.
Por ejemplo:
SELECT id
FROM articulos
WHERE estado = :estado
  AND categoria = :categoria
ORDER BY
    CASE estado
        WHEN 'BORRADOR' THEN 1
        WHEN 'PUBLICADO' THEN 2
        ELSE 3
    END ASC,
    created_at DESC,
    id ASC;
El resultado conceptual sería:
[uuid_1, uuid_2, uuid_3, ..., uuid_N]
No estamos almacenando los artículos completos. Estamos almacenando el mapa que permite saber qué identificadores corresponden a cada posición.
Ese resultado puede guardarse en una caché utilizando como clave una representación de los filtros y del criterio de orden.
Por ejemplo:
hash(filtros + orden) → [id_1, id_2, id_3, ...]
Si la misma combinación se solicita nuevamente mientras el índice sigue siendo válido, puede reutilizarse.
Si el usuario cambia el filtro o el orden, cambia la clave y se genera otro índice.
A partir de ese mapa, solicitar la página 53 significa seleccionar las posiciones correspondientes.
Con un tamaño de página de 20:
página 53 → posiciones 1040 a 1059
Después, el sistema puede recuperar directamente los registros identificados:
SELECT *
FROM articulos
WHERE id = ANY(:ids_pagina);
Finalmente, debe reconstruir el mismo orden utilizado por el índice.
Una consecuencia importante: la consulta representa una fotografía
Esta estrategia introduce una propiedad que conviene hacer explícita.
El índice representa el conjunto de resultados en el momento en que fue construido.
Si se inserta un nuevo registro después de crear el índice, ese registro no tiene por qué aparecer en la navegación actual.
Si se elimina uno de los registros, el índice puede seguir haciendo referencia a un elemento que ya no existe y será necesario decidir cómo gestionar ese caso.
La ventaja es que el comportamiento deja de depender de desplazamientos implícitos entre solicitudes y pasa a formar parte explícita del diseño.
En otras palabras, el sistema está diciendo:
"Esta navegación corresponde a esta fotografía del conjunto de resultados."
Dependiendo del caso de uso, eso puede ser precisamente lo que se necesita.
El papel de los filtros
Aquí las características de los filtros que definimos antes adquieren importancia.
Si existen filtros discretos y relativamente acotados, es posible que diferentes usuarios soliciten repetidamente las mismas combinaciones.
Por ejemplo:
estado=PUBLICADO
categoria=TECNOLOGIA
orden=created_at
Ese tipo de consulta tiene más posibilidades de reutilizar un índice existente.
En cambio, si cada usuario puede especificar una fecha inicial, una fecha final, un precio mínimo, un precio máximo y otros parámetros arbitrarios, el número de combinaciones crece rápidamente.
En ese escenario, la caché puede tener menos oportunidades de reutilización y la generación del índice inicial puede convertirse en un costo importante.
Cuándo encaja
Este enfoque resulta especialmente interesante cuando:
- La navegación aleatoria es necesaria.
- El volumen de datos es elevado.
- Los filtros son relativamente discretos y repetibles.
- El orden de negocio es complejo.
- La misma combinación de filtros se consulta con frecuencia.
- Se dispone de infraestructura de caché.
Qué no resuelve
La generación inicial del índice sigue teniendo un costo proporcional al conjunto de resultados que debe procesar.
Además, mantener la caché introduce complejidad operacional: expiración, invalidación, memoria utilizada y comportamiento ante cambios en los datos.
Cuando los filtros dejan de ser discretos y pasan a incluir texto libre o rangos arbitrarios, puede ser necesario cambiar nuevamente de enfoque.
Cuando el problema ya es de búsqueda
Llegados a este punto, aparece un escenario diferente.
El problema ya no consiste únicamente en decidir cómo recorrer una lista grande.
Supongamos que el endpoint necesita combinar:
- Texto libre.
- Rangos arbitrarios.
- Múltiples dimensiones de filtrado.
- Orden dinámico.
- Millones de registros.
- Consultas frecuentes y concurrentes.
- Navegación sobre grandes conjuntos de resultados.
Aquí puede tener sentido utilizar un motor de búsqueda especializado.
Herramientas como Elasticsearch u OpenSearch utilizan estructuras de indexación diseñadas específicamente para búsquedas y filtrados complejos.
En lugar de depender exclusivamente del modelo de consulta de una tabla relacional, mantienen estructuras especializadas que permiten localizar documentos a partir de los términos y valores buscados.
También ofrecen mecanismos orientados a recorrer grandes conjuntos de resultados, como search_after, que permite continuar una búsqueda a partir de una posición determinada.
Esto cambia la naturaleza del problema.
Ya no estamos intentando hacer que una tabla relacional resuelva eficientemente cualquier combinación imaginable de búsqueda, filtro y orden.
Estamos utilizando una infraestructura especializada para ese patrón de acceso.
Pero esa decisión introduce un costo nuevo: ahora existe una infraestructura adicional que debe mantenerse sincronizada con la base de datos principal.
El flujo puede verse, conceptualmente, así:
Base de datos principal
        ↓
Proceso de sincronización
        ↓
Índice de búsqueda
Esto obliga a resolver preguntas que no existían con una única base de datos:
- ¿Cuándo se actualiza el índice?
- ¿Qué ocurre si la sincronización falla?
- ¿Cuánto retraso puede existir entre ambos sistemas?
- ¿Cuál es la fuente de verdad?
- ¿Cómo se reconstruye el índice?
- ¿Cómo se monitoriza?
Por eso, un motor de búsqueda no debería incorporarse simplemente porque OFFSET sea lento.
Tiene sentido cuando las necesidades de búsqueda y filtrado justifican la infraestructura adicional.
Cuándo encaja
Puede resultar adecuado cuando:
- El texto libre es una parte central del caso de uso.
- Existen rangos y filtros complejos.
- Se combinan múltiples dimensiones de búsqueda.
- El volumen de datos es elevado.
- Las consultas son frecuentes y concurrentes.
- La base de datos principal ya no ofrece una solución eficiente para el patrón de búsqueda requerido.
Qué no resuelve
No elimina la complejidad: la desplaza hacia la arquitectura.
Aparecen nuevos componentes, sincronización, monitorización, gestión de índices y una nueva forma de consultar los datos.
Si una solución más sencilla satisface los requisitos, incorporar otro sistema puede ser innecesario.
El árbol de decisión
A estas alturas, las cuatro estrategias ya no aparecen como alternativas aisladas. Cada una responde a las condiciones que acabamos de analizar.
El recorrido puede resumirse así:
flowchart TD
A([Necesito paginar una tabla])
--> B{¿Volumen moderado<br/>y páginas superficiales?}
B -->|Sí| S1[OFFSET con índices<br/>bien diseñados]
B -->|No| C{¿El usuario necesita<br/>saltar a páginas arbitrarias?}
C -->|No — navegación secuencial| D{¿El orden puede ser<br/>determinista?}
D -->|Sí| S2[Cursor-based pagination<br/>CursorRequest + CursorPage<T>]
D -->|No| D2[Añadir una columna<br/>de desempate única al orden]
D2 --> D
C -->|Sí — acceso aleatorio| E{¿Los filtros son<br/>discretos y acotados?}
E -->|Sí| S3[Índice de navegación con caché<br/>Hash del filtro → IDs en Redis]
E -->|No| F{¿La búsqueda y el volumen<br/>justifican infraestructura adicional?}
F -->|Sí| S4[Motor de búsqueda dedicado<br/>Elasticsearch / OpenSearch]
F -->|No| S1b[OFFSET con límite<br/>de profundidad]
El árbol no debe interpretarse como una fórmula rígida.
Por ejemplo, el número de registros por sí solo no determina qué estrategia utilizar. Lo que importa es cómo se combina ese volumen con la profundidad de navegación, el patrón de consulta, los filtros, el orden y la frecuencia de acceso.
El objetivo del árbol es obligarnos a formular las preguntas correctas antes de introducir complejidad.
Lo que cada solución no resuelve
Después de recorrer las alternativas, aparece una conclusión importante: ninguna estrategia elimina el costo de la paginación; cada una lo desplaza hacia un lugar diferente.
OFFSET mantiene un contrato sencillo y permite navegar directamente a páginas arbitrarias. Su costo aparece principalmente cuando la profundidad aumenta y los datos son numerosos.
Los cursores reducen el trabajo asociado con posiciones profundas y funcionan especialmente bien para navegación secuencial. A cambio, el cliente deja de trabajar con páginas numéricas y debe conservar un punto de referencia.
El índice de navegación con caché permite recuperar páginas arbitrarias a partir de un mapa previamente construido. A cambio, introduce un costo inicial y una infraestructura adicional para almacenar y gestionar ese mapa.
El motor de búsqueda permite resolver escenarios donde el problema ya no es solamente paginar, sino buscar y filtrar grandes volúmenes de información. A cambio, introduce otra pieza de infraestructura y la necesidad de mantenerla coordinada con la fuente de datos principal.
Por eso, la decisión no consiste en encontrar una solución que no tenga costos.
Consiste en decidir qué costo es aceptable para el contexto concreto del sistema.
Volver al endpoint que "simplemente funcionaba"
Cuando aquel endpoint que inicialmente "simplemente funcionaba" empieza a mostrar tiempos de respuesta cada vez mayores, es tentador concluir que OFFSET fue una mala decisión desde el principio.
Pero esa conclusión sería demasiado simple.
OFFSET puede ser una solución perfectamente válida para determinados escenarios.
El problema aparece cuando cambian las condiciones para las que fue elegido y nadie revisa la decisión.
Una tabla que comenzó con 20.000 registros puede terminar teniendo varios millones.
Una interfaz que inicialmente mostraba cinco páginas puede terminar necesitando búsqueda avanzada.
Un listado que solo se consultaba ocasionalmente puede convertirse en una de las rutas más utilizadas de la aplicación.
Y un criterio de orden sencillo puede terminar acompañado de múltiples filtros y reglas de negocio.
Por eso, la pregunta importante no es si OFFSET es bueno o malo.
La pregunta es si sigue siendo adecuado para las condiciones actuales del endpoint.
Ese cambio de perspectiva también modifica la forma de diseñar la solución desde el principio.
Antes de implementar la paginación, conviene conocer:
- cómo navegará el usuario;
- si necesita saltos arbitrarios;
- qué filtros tendrá disponibles;
- si esos filtros son discretos o abiertos;
- cómo se ordenarán los resultados;
- si ese orden es determinista;
- cuánto volumen existe actualmente;
- cuánto se espera que crezca;
- y cuánto pueden cambiar los datos mientras el usuario navega.
Con esa información, OFFSET, cursores, un índice de navegación o un motor de búsqueda dejan de ser decisiones basadas en preferencias técnicas.
Se convierten en respuestas a requisitos concretos.
Y esa es probablemente la idea más importante de todo el problema: la paginación no debería elegirse por costumbre ni por la tecnología que tenemos disponible, sino por la forma en que el endpoint realmente necesita ser utilizado.
La tarea puede seguir siendo "agregar paginación al listado de artículos".
Lo que cambia es la pregunta que hacemos antes de tocar el código.
No:
"¿Cuál es la mejor técnica de paginación?"
Sino:
"¿Qué tipo de navegación, filtrado, orden y volumen necesita realmente este endpoint?"
A partir de ahí, la implementación deja de ser una decisión aislada y pasa a formar parte del diseño técnico del sistema.
Y cuando el volumen, los filtros o la forma de navegación cambien, la estrategia puede revisarse de nuevo.
Ese punto de revisión es tan importante como la decisión inicial.
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
- Mauricio ECR
- Arquitectura
- 12 Sep, 2026
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload Seguro que alguna vez empezaste con un endpoint de listado que parecía no necesitar demasiado. Un par de fil
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
- Mauricio ECR
- Arquitectura
- 12 Sep, 2026
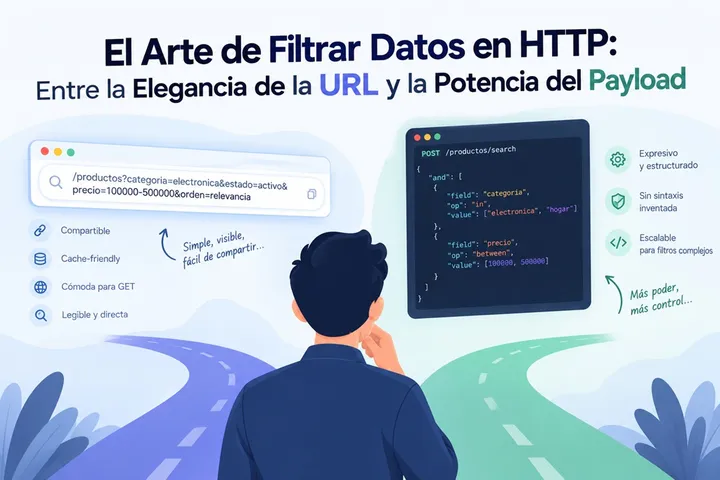
El Arte de Filtrar Datos en HTTP: Entre la Elegancia de la URL y la Potencia del Payload
Seguro que alguna vez empezaste con un endpoint de listado que parecía no necesitar demasiado. Un par de filtros simples: nombre, categoría, quizá un estado. Todo cabía cómodamente en una URL como ?categoria=electronica&estado=activo, era fácil de leer y nadie tenía demasiadas razones para cuestionar la decisión.
El problema aparece cuando esa pantalla deja de ser simple.
Alguien de producto pide filtrar por varias categorías al mismo tiempo, añadir un rango de precios, restringir por fecha de publicación y, además, ordenar por relevancia. Nada especialmente extraño: es el tipo de evolución que termina teniendo cualquier sistema de búsqueda que crece un poco. Lo que cambia no es la necesidad funcional, sino la dificultad de representar esa necesidad dentro de HTTP.
Y es ahí donde una decisión que parecía puramente sintáctica empieza a afectar cosas bastante más importantes: la legibilidad de las URLs, su capacidad para compartirse, el caché, la infraestructura que las procesa y, finalmente, la forma en que el propio código del backend tiene que recibirlas.
Cuando los filtros dejan de caber cómodamente en una URL
La primera reacción suele ser intentar mantener el modelo que ya funciona y llevarlo un poco más lejos. Si un parámetro alcanza para un filtro, quizá varios parámetros puedan representar varios filtros.
Pronto aparece algo parecido a esto:
filter[0][field]=categoria&filter[0][op]=in&filter[0][value][]=electronica&filter[0][value][]=hogar&filter[1][field]=precio&filter[1][op]=between&filter[1][value][]=100000&filter[1][value][]=500000
El problema no es que esta representación sea imposible. El problema es que, a medida que aumenta la complejidad, empieza a depender de una sintaxis que la propia API tiene que inventar y documentar. No existe una convención universal que garantice que otro equipo, otro framework o incluso otro endpoint vaya a interpretar exactamente esa estructura de la misma manera.
Con dos condiciones todavía se puede tolerar. Con tres o cuatro, la URL deja de comunicar lo que está ocurriendo y pasa a convertirse en una estructura que hay que descifrar.
La siguiente idea parece más atractiva precisamente porque elimina esa sintaxis inventada: si el filtro es estructurado, ¿por qué no representarlo directamente como JSON?
Por ejemplo:
{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    }
  ]
}
Conceptualmente es mucho mejor. La estructura expresa exactamente lo que se quiere consultar y no hace falta inventar una notación propia para representar operadores, campos y valores.
El problema llega cuando ese JSON tiene que viajar dentro de una URL.
Después de aplicar URL encoding, una estructura que originalmente era legible termina convertida en una secuencia como esta:
%7B%22and%22%3A%5B%7B%22field%22%3A%22categoria%22%2C%22op%22%3A%22in%22%2C%22value%22%3A%5B%22electronica%22%2C%22hogar%22%5D%7D%5D%7D
La información sigue estando ahí. El problema es que dejó de ser visible.
Esto parece una molestia estética hasta que aparece un caso real de diagnóstico. Una URL así puede terminar en un mensaje de chat del equipo, en Postman, en un log de producción o en un ticket donde alguien intenta explicar por qué una búsqueda devolvió resultados inesperados. En ninguno de esos escenarios resulta evidente qué filtro representa la cadena.
Hay que decodificarla antes de poder entenderla.
Y entonces aparece una tercera posibilidad, casi inevitable: abandonar la URL y enviar el JSON en el body de un POST.
La solución fácil también cambia el contrato
La propuesta de utilizar POST tiene una ventaja evidente: el filtro vuelve a verse exactamente como lo que es.
POST /productos/search
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Desde el punto de vista de representación, es probablemente la solución más cómoda. Pero resuelve el problema de legibilidad introduciendo otro: la búsqueda ya no está contenida en una URL que pueda copiarse, pegarse y compartir como un recurso de lectura.
Además, aunque el caché de respuestas POST es posible con configuraciones específicas, no tiene la misma interoperabilidad ni la misma naturalidad que el caché de un GET. Una petición GET encaja directamente con las expectativas de navegadores, proxies, CDN y clientes HTTP para operaciones de lectura.
Esto no significa que POST sea incorrecto. Significa que, al elegirlo, se está renunciando deliberadamente a ciertas propiedades.
Y esa distinción es importante porque permite formular mejor el problema. No se trata de encontrar una opción universalmente correcta entre query params, JSON en la URL y POST. Se trata de decidir qué propiedad del contrato HTTP se necesita conservar.
Si la búsqueda debe poder compartirse como enlace y además interesa mantenerla como GET, todavía quedan alternativas que merece la pena explorar — y antes de comprometerse con una, conviene entender de qué depende cada una.
Dos caminos para conservar el GET, con distinta dependencia
Cuando la meta es mantener la búsqueda como GET compartible sin caer en URLs ilegibles, hay dos familias de solución, y no son intercambiables porque no piden lo mismo al resto del sistema.
Una es codificar el filtro tal cual el frontend lo pensó (un objeto JSON con la forma que el dominio necesite) y transportarlo como un blob opaco en un único parámetro. Esta idea no le exige nada a la capa de persistencia: el servidor recibe una cadena, la decodifica, obtiene un JSON y lo interpreta como quiera. Es agnóstica al motor de datos por completo.
La otra es expresar el filtro directamente como una gramática de texto pensada para mapear campo-operador-valor, apoyándose en que exista una capa de acceso a datos capaz de traducir esa gramática a una consulta ejecutable. Esta idea sí depende de algo externo a la propia idea: solo funciona si hay un traductor gramática→query, típicamente provisto por un ORM con soporte de construcción dinámica de condiciones (Criteria API en el mundo Java, query builders equivalentes en otros stacks).
Esa diferencia — necesitar o no una capa de traducción externa — es la que determina cuál conviene en cada caso, y conviene resolverla antes de escribir una sola línea de código.
El camino agnóstico: JSON opaco vía Base64URL
Cuando el filtro es estructurado pero sigue siendo razonablemente pequeño, una posibilidad es serializarlo como JSON y después codificar ese JSON utilizando Base64URL.
El flujo conceptual es sencillo:
- Se construye el filtro como un objeto.
- Se serializa a JSON.
- Ese JSON se codifica mediante Base64URL.
- El resultado se envía como un único parámetro de query.
- El servidor lo decodifica y recupera nuevamente el JSON.
La diferencia importante es que no se intenta hacer legible el contenido del filtro dentro de la URL. Se acepta que sea opaco, pero se consigue que la representación sea mucho más adecuada para convivir con la sintaxis de una URL.
También conviene precisar el nombre. No se trata simplemente de Base64 tradicional.
Base64 utiliza caracteres como +, / y =, que pueden requerir tratamiento adicional cuando aparecen dentro de una URL. Base64URL, definido en la sección 5 del RFC 4648, utiliza - y _ en lugar de esos caracteres y permite omitir el padding cuando el protocolo que lo utiliza lo contempla.
Tomemos el filtro completo:
{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Después de codificarlo, la petición puede quedar así:
GET /productos?filter=eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhIiwib3AiOiJpbiIsInZhbHVlIjpbImVsZWN0cm9uaWNhIiwiaG9nYXIiXX0seyJmaWVsZCI6InByZWNpbyIsIm9wIjoiYmV0d2VlbiIsInZhbHVlIjpbMTAwMDAwLDUwMDAwMF19XX0
La cadena sigue siendo opaca. No pretende ser legible para una persona. Pero ya no está dominada por secuencias %XX, y lo más importante es que la operación continúa siendo un GET.
Eso permite conservar varias propiedades útiles: la búsqueda puede copiarse, guardarse y compartirse como enlace y, cuando la infraestructura está configurada para ello, la respuesta puede aprovechar el caché asociado a una petición GET.
Hay, eso sí, una condición que no conviene esconder: el filtro debe seguir teniendo un tamaño razonable. Si la consulta contiene decenas de condiciones, listas enormes o estructuras profundamente anidadas, el problema deja de ser cómo codificarla y empieza a ser cuánto sentido tiene seguir transportándola dentro de una URL.
Pero para una búsqueda con un conjunto moderado de filtros, Base64URL puede ser un punto intermedio razonable.
Lo que queda pendiente es hacer que el backend pueda consumir esa representación sin convertir cada controlador en responsable de la decodificación.
El camino dependiente de la persistencia: RSQL
Existe otra manera de mantener el GET sin sacrificar legibilidad, pero que parte de una premisa distinta: en lugar de esconder el filtro dentro de un blob opaco, expresarlo directamente como texto legible dentro del propio query param.
RSQL es una extensión de FIQL (Feed Item Query Language) que permite escribir eso: una gramática de comparaciones encadenadas con AND/OR, pensada para mapear uno a uno contra atributos de una entidad. La URL sigue siendo un GET, sigue siendo compartible, y además no pierde legibilidad:
GET /productos?filter=categoria=in=(electronica,hogar);precio=ge=100000;precio=le=500000
El punto y coma es AND, la coma es OR, los paréntesis agrupan. Los paths de relaciones se escriben con notación de punto:
GET /productos?filter=marca.pais==Argentina;estado!=suspendido
Comparado con Base64URL, la ganancia es evidente: no hace falta decodificar nada para entender qué se está pidiendo. La cadena es el filtro.
Pero esa legibilidad no es gratis, y ahí está el punto que conviene no pasar por alto: RSQL no resuelve nada por sí mismo. Es una gramática de texto; alguien tiene que parsearla y, sobre todo, alguien tiene que traducirla a una consulta ejecutable contra el almacenamiento real. A diferencia de Base64URL — donde el servidor simplemente decodifica y deserializa un JSON con sus propias reglas —, RSQL necesita que exista, entre el parser y la base de datos, una capa capaz de convertir cada nodo de comparación en una condición de persistencia. Sin esa capa, RSQL es solo una cadena de texto sin ningún lugar donde ejecutarse.
En el ecosistema Java, esa capa la provee típicamente la Criteria API de JPA a través de una Specification, y existen librerías (no oficiales de Spring, sino de terceros) que hacen ese puente automáticamente. En otros stacks el concepto se mantiene — una gramática campo-operador-valor traducida a un query builder dinámico —, pero el mecanismo concreto cambia según el ORM disponible. Quien quiera ver cómo se ve esa integración en un proyecto Spring Boot real puede saltar directamente al anexo al final del artículo.
Esa dependencia tiene además una consecuencia de seguridad que conviene resolver antes de decidirse por este camino, no después.
El vector de seguridad que ninguna gramática resuelve por defecto
Cualquier mecanismo que traduzca texto libre a una condición de persistencia enfrenta el mismo riesgo, independientemente del lenguaje o el framework: el parser no sabe, por sí solo, qué campos del modelo deberían ser alcanzables desde afuera.
Si una entidad tiene una relación hacia otra entidad con datos sensibles, nada en la gramática impide que un consumidor intente comparar directamente contra esos campos:
GET /productos?filter=usuario.password==algo
GET /productos?filter=usuario.resetToken==abc123
El sistema no devolvería esos valores en el body, pero sí variaría el número de resultados según si la condición se cumple o no. Es suficiente para montar un ataque de oráculo e inferir, comparación a comparación, valores que nunca deberían ser accesibles desde un filtro de listado.
La mitigación es siempre la misma en cualquier stack: recorrer la estructura del filtro ya parseado (su AST) antes de ejecutar la consulta y rechazar cualquier campo que no esté en una allowlist explícita, y componer esa consulta junto con las condiciones base que el usuario nunca debería poder eludir (soft-delete, tenant, permisos).
Esto es exactamente lo que distingue este camino del de Base64URL con un DTO tipado: ahí, los campos filtrables son exactamente los que el desarrollador declaró en la clase. No hay forma de filtrar por usuario.resetToken si ese campo no existe en el tipo — la allowlist es estructural, la garantiza el propio DTO. En el camino de la gramática de texto, en cambio, la allowlist es una responsabilidad operacional: hay que construirla y mantenerla activamente, y es un paso que se puede omitir bajo presión sin que nada lo impida a nivel de compilación.
Cuándo conviene cada camino
La pregunta que separa un camino del otro no es cuál es "mejor", sino qué tan bien el filtro se mapea contra atributos simples de una entidad persistida:
- Si los filtros son AND/OR sobre atributos que existen tal cual en el modelo de datos, y se cuenta con una capa de persistencia capaz de traducir esa gramática (Specification, Criteria API o equivalente), una gramática de texto como RSQL resuelve el problema con muy poco código y conserva la legibilidad de la URL — a cambio de mantener activamente una allowlist.
- Si el contrato del filtro es propio del dominio, con operadores específicos, estructuras anidadas particulares o simplemente no hay (o no se quiere depender de) una capa de traducción gramática→persistencia, Base64URL con un DTO tipado ofrece un contrato explícito, no le pide nada al motor de datos, y su allowlist es estructural en lugar de operacional.
Esta bifurcación es la que después vuelve a aparecer, ya formalizada, en el árbol de decisión al final del artículo.
Llevar la idea de Base64URL a un endpoint real con Spring Boot
En cualquier framework aparece la misma pregunta: alguien tiene que recibir el parámetro, decodificarlo, convertir el JSON en el DTO correspondiente y manejar los errores que puedan producirse durante el proceso.
En Spring Boot, la solución más directa consiste en hacerlo dentro del controlador:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @RequestParam("filter") String filterBase64,
        ObjectMapper objectMapper) throws IOException {

    byte[] jsonBytes = Base64.getUrlDecoder().decode(filterBase64);

    FiltroProductosDto filtro =
            objectMapper.readValue(jsonBytes, FiltroProductosDto.class);

    return ResponseEntity.ok(productoService.buscar(filtro));
}
Para un solo endpoint, no hay nada especialmente problemático en este enfoque. El inconveniente aparece cuando el sistema crece.
Si existen diez endpoints de búsqueda, probablemente aparezcan diez implementaciones prácticamente iguales. Y entonces la cuestión deja de ser si podemos decodificar Base64URL y pasa a ser si queremos mantener esa lógica repartida por todos los controladores.
En ese punto aparecen problemas de consistencia bastante concretos.
¿Todos los endpoints manejan el padding de la misma forma? ¿Todos distinguen entre un Base64URL inválido y un JSON inválido? ¿Todos responden de la misma manera cuando falta el parámetro? ¿Todos deserializan el contenido con las mismas reglas? ¿Todos aplican las mismas validaciones?
La duplicación empieza a convertir una decisión de transporte en una responsabilidad del código de negocio.
Una solución más limpia consiste en hacer que el controlador reciba directamente el DTO que necesita:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(productoService.buscar(filtro));
}
El controlador ya no necesita saber que el filtro llegó codificado. Esa información pertenece a la capa que transforma la petición HTTP en los argumentos del método.
Spring MVC proporciona precisamente un mecanismo para realizar esa transformación: HandlerMethodArgumentResolver.
Sacar la infraestructura del controlador
El primer paso es definir una anotación que identifique los parámetros que deben resolverse mediante este mecanismo:
import java.lang.annotation.*;

@Target(ElementType.PARAMETER)
@Retention(RetentionPolicy.RUNTIME)
public @interface Base64Filter {

    String value() default "filter";
}
El valor permite mantener filter como nombre por defecto, pero también utilizar otro parámetro cuando el endpoint lo necesite:
@Base64Filter("criteria")
FiltroProductosDto filtro
La anotación por sí sola no hace la transformación. El trabajo lo realiza el resolver.
Aquí aparece además una cuestión importante que puede pasar desapercibida: cuando Spring construye automáticamente un objeto mediante mecanismos como @RequestBody, el ciclo de validación habitual puede ejecutarse de forma transparente. Cuando el objeto lo construimos manualmente dentro de un HandlerMethodArgumentResolver, esa validación no aparece automáticamente solo porque hayamos escrito @Valid.
Por eso el resolver tiene que encargarse también de esa parte.
Una implementación posible es:
@Component
public class Base64FilterArgumentResolver implements HandlerMethodArgumentResolver {

    private final ObjectMapper objectMapper;
    private final Validator validator;

    public Base64FilterArgumentResolver(ObjectMapper objectMapper, Validator validator) {
        this.objectMapper = objectMapper;
        this.validator = validator;
    }

    @Override
    public boolean supportsParameter(MethodParameter parameter) {
        return parameter.hasParameterAnnotation(Base64Filter.class);
    }

    @Override
    public Object resolveArgument(
            MethodParameter parameter,
            ModelAndViewContainer mavContainer,
            NativeWebRequest webRequest,
            WebDataBinderFactory binderFactory) throws Exception {

        Base64Filter annotation = parameter.getParameterAnnotation(Base64Filter.class);
        String paramName = annotation.value();
        String rawValue = webRequest.getParameter(paramName);
        Class<?> targetType = parameter.getParameterType();

        Object filtro;

        if (rawValue == null || rawValue.isBlank()) {
            filtro = targetType.getDeclaredConstructor().newInstance();
        } else {
            try {
                byte[] jsonBytes = Base64.getUrlDecoder().decode(rawValue);
                filtro = objectMapper.readValue(jsonBytes, targetType);
            } catch (IllegalArgumentException e) {
                throw new FiltroInvalidoException(
                        "El parámetro '" + paramName + "' no es Base64URL válido");
            } catch (JacksonException e) {
                throw new FiltroInvalidoException(
                        "El parámetro '" + paramName + "' no contiene un JSON de filtro válido");
            }
        }

        if (parameter.hasParameterAnnotation(Valid.class)) {
            Set<ConstraintViolation<Object>> violations = validator.validate(filtro);
            if (!violations.isEmpty()) {
                throw new FiltroInvalidoException(
                        "El filtro no cumple las validaciones: " + violations);
            }
        }

        return filtro;
    }
}
Hay varias decisiones dentro de este código que conviene entender porque son parte del contrato y no simples detalles de implementación.
El método supportsParameter hace que el resolver intervenga únicamente cuando el parámetro tiene la anotación @Base64Filter. Esto mantiene el comportamiento localizado y evita que todos los parámetros de la aplicación intenten pasar por la misma lógica.
Después se obtiene el nombre del parámetro desde la anotación y se recupera su valor desde la petición. Si no existe o está vacío, el ejemplo construye una instancia vacía del DTO. Esa decisión puede ser apropiada cuando la ausencia del filtro significa "sin restricciones", pero no debería convertirse en una regla universal. Si en el dominio la ausencia del parámetro tiene otro significado, ese comportamiento debe reflejarlo.
Cuando sí existe un valor, primero se decodifica Base64URL y después se deserializa el JSON utilizando ObjectMapper.
Las dos operaciones pueden fallar por motivos diferentes, y distinguirlas permite devolver mensajes de error más útiles. Un contenido que no es Base64URL válido no representa el mismo problema que una cadena correctamente codificada que contiene un JSON malformado.
Una vez construido el objeto, el resolver comprueba si el parámetro utiliza @Valid. Solo en ese caso ejecuta explícitamente Bean Validation.
Eso permite mantener en el DTO las reglas habituales:
public class FiltroProductosDto {

    @Size(
        max = 10,
        message = "No se permiten más de 10 categorías"
    )
    private List<String> categorias;

    @Min(0)
    private Long precioMinimo;

    @Min(0)
    private Long precioMaximo;

    // getters y setters
}
De esta manera, colocar @Valid junto con @Base64Filter activa las validaciones sintácticas habituales sin introducir lógica adicional en el controlador.
Es importante, sin embargo, no confundir validación sintáctica con validación de negocio.
Una regla como "no se permiten más de diez categorías" o "el precio mínimo no puede ser negativo" pertenece naturalmente a esta capa. En cambio, comprobar que precioMinimo sea menor que precioMaximo, que una categoría exista realmente o que determinado filtro esté permitido para un usuario concreto puede requerir información que el resolver no debería conocer.
Esas decisiones pertenecen a una capa posterior, normalmente al servicio o a la lógica de dominio.
Registrar el resolver y completar la separación
Una vez creado el resolver, hay que registrarlo en Spring MVC:
@Configuration
public class WebConfig implements WebMvcConfigurer {

    private final Base64FilterArgumentResolver resolver;

    public WebConfig(Base64FilterArgumentResolver resolver) {
        this.resolver = resolver;
    }

    @Override
    public void addArgumentResolvers(List<HandlerMethodArgumentResolver> resolvers) {
        resolvers.add(resolver);
    }
}
A partir de ahí, el controlador puede mantenerse completamente centrado en su responsabilidad:
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(
            productoService.buscar(filtro)
    );
}
El beneficio real de esta arquitectura no es que Spring haya aprendido a decodificar Base64URL. El beneficio es haber separado dos decisiones que no deberían estar mezcladas.
Una decisión responde a cómo viaja el filtro por HTTP.
La otra responde a qué filtro necesita el caso de uso.
El controlador solo debería preocuparse por la segunda.
Cuando llegue el endpoint de búsqueda número once, no será necesario copiar la misma secuencia de decodificación, deserialización y validación. El mecanismo de transporte queda encapsulado en una pieza transversal y los endpoints pueden expresar únicamente el contrato que necesitan.
Pero conseguir que el código quede limpio no significa que el diseño esté terminado. Hay varias cuestiones que el resolver no puede solucionar por sí solo.
Codificar no significa proteger
La primera es seguridad.
Base64URL no cifra el contenido. Tampoco lo convierte en secreto. Cualquier persona que tenga acceso a la cadena puede decodificarla y recuperar el JSON original.
Por eso nunca debe interpretarse la codificación como una medida de protección.
Después de deserializar el filtro siguen siendo necesarias las comprobaciones correspondientes: campos permitidos, operadores válidos, tipos esperados, tamaños máximos y, cuando la estructura lo permita, profundidad máxima de anidamiento.
Esto es especialmente relevante cuando el filtro admite estructuras complejas. Una petición puede ser perfectamente válida desde el punto de vista sintáctico y, aun así, provocar un consumo excesivo de CPU o memoria si el servidor acepta estructuras arbitrariamente grandes o profundas.
La validación, por tanto, no es un accesorio que se añade después de implementar Base64URL. Forma parte del contrato de entrada.
Los errores también forman parte del diseño
El segundo punto es el manejo de errores.
El resolver puede lanzar FiltroInvalidoException, pero eso no significa que cada controlador deba capturarla individualmente. La aplicación puede centralizar la conversión de esa excepción en una respuesta HTTP uniforme:
@RestControllerAdvice
public class FiltroExceptionHandler {

    @ExceptionHandler(FiltroInvalidoException.class)
    public ResponseEntity<ErrorResponse> handleFiltroInvalido(FiltroInvalidoException ex) {
        return ResponseEntity.badRequest().body(new ErrorResponse(ex.getMessage()));
    }
}
Esto elimina otro nivel de duplicación, pero todavía conviene conservar internamente las distintas categorías de fallo.
No es lo mismo recibir un Base64URL inválido que recibir un JSON malformado. Tampoco es lo mismo un JSON válido que no puede convertirse al DTO esperado, un DTO que incumple las validaciones, o un filtro completamente válido que no está permitido para determinado usuario.
No siempre es necesario exponer todas esas diferencias al consumidor. De hecho, en algunos casos sería contraproducente. Pero mantenerlas diferenciadas internamente puede resultar decisivo cuando haya que investigar un comportamiento extraño en producción.
La uniformidad hacia fuera no debería implicar perder información hacia dentro.
Si el consumidor no sabe qué codificar, el contrato está incompleto
Hay todavía otra pieza que suele olvidarse porque no afecta directamente al funcionamiento del endpoint: la documentación.
Una anotación personalizada como @Base64Filter no necesariamente será interpretada automáticamente por herramientas como springdoc-openapi como un parámetro de query convencional. Si el consumidor no recibe una explicación explícita, terminará teniendo que averiguar por su cuenta cómo construir la cadena.
Por ejemplo:
@Operation(
    summary = "Búsqueda de productos con filtro estructurado"
)
@Parameter(
    name = "filter",
    description =
        "Filtro JSON codificado en Base64URL según RFC 4648 §5",
    example =
        "eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhIn1dfQ",
    schema = @Schema(type = "string")
)
@GetMapping("/productos")
public ResponseEntity<List<ProductoDto>> buscar(
        @Base64Filter @Valid FiltroProductosDto filtro) {

    return ResponseEntity.ok(
            productoService.buscar(filtro)
    );
}
Una buena documentación debería mostrar las dos representaciones.
Por un lado, el JSON conceptual que el consumidor realmente quiere expresar. Por otro, la cadena Base64URL que debe enviar.
La transformación puede ser transparente para el servidor, pero no debe ser un misterio para quien consume la API.
El coste que aparece después: una URL que ya no se puede leer
Hasta este punto, Base64URL parece haber conseguido un equilibrio bastante atractivo: mantiene GET, conserva una URL autocontenida y evita llenar el query string de secuencias de escape.
Pero ese equilibrio tiene un precio evidente.
La URL deja de ser legible.
Un log como este:
GET /productos?filter=eyJhbmQiOlt7ImZpZWxkIjoiY2F0ZWdvcmlhI...
no permite saber inmediatamente qué filtros se utilizaron.
Y eso importa especialmente porque las URLs aparecen en muchos lugares que no están bajo el control directo del desarrollador que diseñó el endpoint: logs de servidores, herramientas de monitoreo, historial del navegador, sistemas de analítica y mecanismos de diagnóstico.
Es exactamente el costo que, como vimos antes, RSQL evita — a cambio de pedir una capa de traducción a persistencia y una allowlist mantenida activamente. Ninguna de las dos alternativas gana en todo; cada una conserva una propiedad distinta.
Cuándo RSQL se queda corto
Incluso en el escenario donde sí conviene la gramática de texto — filtros que mapean bien a atributos y operadores relacionales estándar —, hay límites concretos donde deja de alcanzar.
El primero es semántica propia. Un operador =between= con dos valores puede registrarse como extensión del parser, pero si el dominio necesita expresar algo como un rango con extremos configurables o un operador geoespacial con parámetros propios, la gramática obliga a inventar una notación que ya no es estándar. El DTO tipado puede incluir esos campos con semántica explícita.
El segundo es correlación en colecciones. Si Producto tiene una lista de Variante y la consulta necesita encontrar productos que tengan una variante que sea simultáneamente roja y con stock mayor a cero, una traducción directa campo-operador-valor genera un JOIN que evalúa las condiciones por separado. Puede devolver un producto con una variante roja sin stock y otra variante con stock pero de distinto color. Para expresar esa correlación hace falta un subquery o un EXISTS, que la gramática no modela.
El tercero es contexto de runtime. Un score de relevancia calculado en el momento de la petición, una distancia geoespacial o un ranking de machine learning no tienen representación natural como par campo-operador-valor.
Cuando el filtro cruza alguno de esos límites, Base64URL con DTO tipado vuelve a ser la opción más honesta: el contrato es explícito, los campos posibles están acotados por el tipo y la estructura puede ser tan específica como lo exija el dominio.
Cuando el filtro crece, el problema deja de ser de codificación
Hasta aquí estamos hablando de un escenario bastante concreto: filtros estructurados pero todavía razonablemente pequeños.
La situación cambia cuando la consulta empieza a crecer.
Decenas de condiciones. Listas extensas de identificadores. Estructuras anidadas varios niveles hacia abajo. Combinaciones complejas de operadores.
En ese momento, insistir en mantener todo dentro de una URL deja de ser una cuestión de encontrar una codificación más conveniente.
Se convierte en una decisión de diseño de interfaz.
Y es precisamente ahí donde POST vuelve a tener sentido, pero esta vez por una razón diferente a la del comienzo.
No se utiliza porque no hayamos encontrado una manera suficientemente ingeniosa de meter el filtro en un GET. Se utiliza porque el contrato ha cambiado y ahora el body es un lugar más apropiado para transportar una estructura grande.
POST /productos/search
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    },
    {
      "field": "precio",
      "op": "between",
      "value": [100000, 500000]
    }
  ]
}
Se gana una representación natural del filtro y se evita someterlo a las limitaciones prácticas de una URL.
A cambio, la búsqueda deja de ser un recurso autocontenido en forma de enlace y pierde la misma naturalidad para el caché que tendría un GET.
Pero si el filtro ya ha alcanzado un tamaño que hace poco razonable mantenerlo en la URL, esa pérdida probablemente sea aceptable.
Una tercera posibilidad: QUERY
Existe además una alternativa más reciente que resulta conceptualmente interesante: el método HTTP QUERY.
La motivación es precisamente separar la semántica de una operación de consulta de la necesidad de transportar una estructura compleja en el body.
En teoría, encaja muy bien con el problema: una consulta segura podría mantener una semántica específica de consulta y, al mismo tiempo, recibir contenido estructurado sin tener que comprimirlo artificialmente dentro de la URL.
El inconveniente está en el ecosistema.
Que un método esté definido mediante un estándar no significa que navegadores, proxies, firewalls, gateways y otras piezas de infraestructura lo soporten con la misma madurez que GET o POST.
Por eso puede ser una opción interesante para mantener en el radar, especialmente cuando se controla de extremo a extremo la infraestructura, pero no necesariamente es la elección más conservadora para una API pública que necesita máxima interoperabilidad.
Cuando ni siquiera el body es suficiente
Hay todavía un escenario más extremo.
Supongamos que la consulta es muy grande, pero además se reutiliza constantemente. Enviar todo el filtro en cada petición puede empezar a resultar innecesario.
En ese caso, quizá el problema ya no consista en decidir cómo transportar el filtro, sino en dejar de transportarlo.
Una alternativa es convertir la búsqueda en un recurso persistente:
POST /saved-searches
Content-Type: application/json

{
  "and": [
    {
      "field": "categoria",
      "op": "in",
      "value": ["electronica", "hogar"]
    }
  ]
}
El servidor puede almacenar esa definición y devolver un identificador:
HTTP/1.1 201 Created

Location: /saved-searches/abc123
A partir de ahí, las peticiones posteriores pueden referirse al identificador en lugar de reenviar toda la estructura.
La decisión es diferente porque también lo es el problema.
Ya no estamos intentando representar una búsqueda compleja dentro de una URL. Estamos modelando la búsqueda como un recurso que puede persistir y reutilizarse.
Del lado del frontend
Todas estas decisiones del backend tienen una contraparte en el cliente que construye la petición.
El problema no es solo cómo codificar el filtro. Es que si el filtro vive únicamente en el estado del componente, el usuario pierde la posibilidad de compartir la búsqueda, usar el botón atrás del navegador o guardarla como favorito. La URL deja de ser el estado de la pantalla.
La solución en Angular es sincronizar el filtro con los query params del Router en ambas direcciones. Cuando el usuario aplica filtros, la URL se actualiza. Cuando alguien llega con una URL que ya tiene filtros, el formulario se rellena y la búsqueda se ejecuta automáticamente.
Para Base64URL el helper de codificación es simple:
encode(filter: object): string {
  const json = JSON.stringify(filter);
  return btoa(unescape(encodeURIComponent(json)))
    .replace(/\+/g, '-')
    .replace(/\//g, '_')
    .replace(/=+$/, '');
}
Y la sincronización con el router:
// Al cambiar filtros → actualizar la URL
this.router.navigate([], {
  relativeTo: this.route,
  queryParams: { filter: this.encode(filter) },
  queryParamsHandling: 'merge'
});

// Al inicializar → leer filtros de la URL
this.route.queryParams.pipe(
  map(params => params['filter']),
  filter(Boolean),
  map(encoded => this.decode(encoded))
).subscribe(filter => {
  this.applyToForm(filter);
  this.search(filter);
});
Para RSQL la mecánica es idéntica. Solo cambia el formato del string que viaja en el param: en lugar de Base64URL opaco viaja una cadena legible como categoria=in=(electronica,hogar);precio=ge=100000. El router no distingue entre uno y otro.
Volver a aquella URL de 400 caracteres
Aquella URL llena de %7B%22and%22%3A no era realmente un problema de sintaxis.
Era una señal.
La complejidad de la consulta había empezado a superar la comodidad del mecanismo elegido para transportarla, pero todavía no se había tomado una decisión consciente sobre qué propiedad del contrato era importante conservar.
Si los filtros se mapean bien a campos de una entidad persistida y a operadores relacionales estándar, una gramática de texto como RSQL resuelve el problema con muy poco código y conserva la legibilidad de la URL — a costa de depender de una capa de traducción a persistencia y de mantener activamente una allowlist. Si el contrato del filtro es propio del dominio, con operadores específicos o estructuras que no encajan en el modelo relacional directo, Base64URL con DTO tipado ofrece un contrato explícito, no depende de ningún motor de datos particular, y su allowlist es estructural en lugar de operacional.
flowchart TD
    A[¿Qué tipo de filtros necesitás?] --> B
    A --> C
    A --> D
    A --> E

    B["Campos simples\nsin lógica compleja"]
    --> F["QueryDSL Web Bindings\nCero código, nativo Spring Data"]

    C["AND / OR sobre atributos\nde una entidad persistida"]
    --> G{¿Existe una capa que traduzca\ngramática de texto a persistencia?}
    G -->|Sí| H["RSQL / gramática similar\nCon allowlist explícita"]
    G -->|No| D

    D["Operadores custom\nlógica de dominio\ncolecciones correlacionadas"]
    --> I{¿Necesitás URL compartible?}
    I -->|Sí, filtro moderado| J["Base64URL + HandlerMethodArgumentResolver"]
    I -->|No, o filtro grande| K["POST /search\nBody JSON estructurado"]

    E["Filtros enormes\nreutilizados entre sesiones"]
    --> L["saved-searches como recurso\nPOST para crear, GET con ID para reutilizar"]
Cuando el filtro deja de ser razonablemente pequeño, el problema cambia de naturaleza. POST con JSON puede ser un contrato mucho más apropiado. Y si la búsqueda se vuelve grande y reutilizable, puede tener más sentido convertirla en un recurso persistente y referenciarla mediante un identificador.
La decisión correcta no consiste en elegir una tecnología y aplicarla a todas las búsquedas.
Consiste en reconocer que cada representación conserva unas propiedades y sacrifica otras.
Query params simples conservan una URL muy legible, pero se vuelven incómodos cuando la estructura crece. Una gramática de texto como RSQL mantiene esa legibilidad con más expresividad, pero exige que exista una capa de traducción a persistencia y una allowlist explícita mantenida activamente, o la superficie de ataque crece silenciosamente. Base64URL mantiene la búsqueda como GET y permite un contrato de filtro completamente propio, sin depender de ningún motor de datos particular, aunque sacrifica legibilidad en logs. POST recupera la representación natural del JSON cuando la consulta ya es demasiado grande. Y una búsqueda persistente elimina directamente la necesidad de reenviar una estructura que ya existe en el servidor.
El verdadero cambio, entonces, no está en Base64URL, en RSQL, en Spring Boot ni siquiera en HTTP.
Está en dejar de pedirle al mismo mecanismo que resuelva problemas de tamaños y necesidades diferentes.
Cuando una búsqueda es pequeña, puede viajar como una consulta.
Cuando necesita estructura pero todavía cabe razonablemente en una URL, puede codificarse, con la representación que mejor encaje con el contrato.
Cuando crece demasiado, puede pasar al body.
Y cuando se convierte en algo que se reutiliza como entidad propia, puede dejar de viajar por completo y convertirse en un recurso.
Ese es el criterio que permite que la arquitectura evolucione con la complejidad real del problema, en lugar de obligar a cada nueva necesidad a encajar a la fuerza en la decisión que se tomó cuando el endpoint todavía parecía sencillo.
Anexo: RSQL en el stack Java (Spring Boot + JPA)
Todo lo dicho sobre RSQL en el cuerpo del artículo es válido para cualquier stack que cuente con una capa de traducción gramática→persistencia equivalente. Este anexo muestra cómo se ve concretamente esa integración en el ecosistema Java, donde esa capa la provee la Criteria API de JPA a través de una Specification.
La integración más difundida usa un starter de terceros (no es un proyecto oficial de Spring) que convierte directamente la cadena RSQL en una Specification:
<dependency>
    <groupId>io.github.perplexhub</groupId>
    <artifactId>rsql-jpa-spring-boot-starter</artifactId>
    <version>6.0.18</version>
</dependency>
@GetMapping("/productos")
public Page<Producto> buscar(
        @RequestParam(defaultValue = "") String filter,
        Pageable pageable) {

    return productoRepository.findAll(
        RSQLJPASupport.toSpecification(filter),
        pageable
    );
}
Eso es todo el controlador. Sin anotaciones custom, sin resolver, sin ObjectMapper — la contrapartida es la dependencia externa a un motor de persistencia relacional vía JPA, que es justamente lo que el cuerpo del artículo señala como condición de existencia de este camino.
La allowlist mencionada antes se implementa recorriendo el AST que produce el parser de RSQL, antes de convertirlo en Specification, y rechazando cualquier campo fuera de lo permitido:
private void validarCamposPermitidos(String filter, Set<String> permitidos) {
    if (filter.isBlank()) return;

    new RSQLParser().parse(filter).accept(new RSQLVisitor<Void, Void>() {
        public Void visit(AndNode node, Void p) {
            node.getChildren().forEach(c -> c.accept(this, null)); return null;
        }
        public Void visit(OrNode node, Void p) {
            node.getChildren().forEach(c -> c.accept(this, null)); return null;
        }
        public Void visit(ComparisonNode node, Void p) {
            if (!permitidos.contains(node.getSelector()))
                throw new FiltroInvalidoException(
                    "Campo no permitido: " + node.getSelector());
            return null;
        }
    });
}
Y componer la Specification resultante con los filtros base que el usuario nunca debe poder eludir:
Specification<Producto> spec = RSQLJPASupport.<Producto>toSpecification(filter)
    .and((root, query, cb) -> cb.equal(root.get("eliminado"), false))
    .and((root, query, cb) -> cb.equal(root.get("tenantId"), TenantContext.get()));
En otro stack o con otro ORM, el nombre de las piezas cambia, pero el rol de cada una se mantiene: un parser de la gramática, un traductor hacia el mecanismo de consulta dinámica del ORM disponible, y una allowlist que se aplica sobre el árbol ya parseado antes de ejecutar nada contra la base de datos.
Una Propuesta para Estandarizar la Seguridad en APIs REST con Arquitectura Hexagonal y Spring Security
- Mauricio ECR
- Snippets
- 03 Aug, 2025
En el desarrollo de aplicaciones empresariales modernas, la seguridad es un pilar fundamental. Sin embargo, lograr una arquitectura de seguridad que sea reutilizable, desacoplada y, al mismo t
Una Propuesta para Estandarizar la Seguridad en APIs REST con Arquitectura Hexagonal y Spring Security
- Mauricio ECR
- Snippets
- 03 Aug, 2025
En el desarrollo de aplicaciones empresariales modernas, la seguridad es un pilar fundamental. Sin embargo, lograr una arquitectura de seguridad que sea reutilizable, desacoplada y, al mismo tiempo, compatible con los estándares de la industria (como JWT y Spring Security) puede ser un reto. Este artículo explora una solución basada en la arquitectura hexagonal, que permite centralizar la lógica de autorización en el dominio, sin perder la integración con las capacidades avanzadas de Spring Security, como el uso de anotaciones (@PreAuthorize) y la inyección del usuario autenticado en los controladores.
Contexto y Desafío
La mayoría de los frameworks modernos, como Spring Boot, ofrecen mecanismos de seguridad robustos y listos para usar. Sin embargo, estos suelen acoplar la lógica de autenticación y autorización a la infraestructura, dificultando la reutilización y el testeo independiente del dominio. Por otro lado, la arquitectura hexagonal promueve la separación de responsabilidades, permitiendo que la lógica de negocio (incluida la autorización) permanezca independiente de los detalles tecnológicos.
El desafío surge cuando se requiere que la lógica de autorización, implementada en el dominio, pueda interactuar con el ecosistema de Spring Security, permitiendo el uso de anotaciones como @PreAuthorize y la inyección del usuario autenticado en los controladores. La solución propuesta en este artículo aborda este reto, permitiendo una integración fluida y flexible.
Dependencias Requeridas
Para implementar esta solución, se requieren las siguientes dependencias en el archivo build.gradle:
dependencies {
    // Spring Boot Core
    implementation 'org.springframework.boot:spring-boot-starter-web'
    implementation 'org.springframework.boot:spring-boot-starter-security'
    implementation 'org.springframework.boot:spring-boot-configuration-processor'

    // Lombok para reducir boilerplate
    compileOnly 'org.projectlombok:lombok'
    annotationProcessor 'org.projectlombok:lombok'

    // JWT (opcional, para parsing de tokens)
    implementation 'io.jsonwebtoken:jjwt-api:0.11.5'
    runtimeOnly 'io.jsonwebtoken:jjwt-impl:0.11.5'
    runtimeOnly 'io.jsonwebtoken:jjwt-jackson:0.11.5'

    // Testing
    testImplementation 'org.springframework.boot:spring-boot-starter-test'
    testImplementation 'org.springframework.security:spring-security-test'
}
Estructura de Directorios
La librería sigue una estructura de directorios que respeta los principios de la arquitectura hexagonal:
src/
├── main/
│   ├── java/
│   │   └── com/
│   │       └── tuempresa/
│   │           ├── dominio/
│   │           │   └── autorizacion/
│   │           │       ├── AuthorizationContext.java
│   │           │       ├── AuthorizationException.java
│   │           │       ├── AuthorizationService.java
│   │           │       └── AuthorizationServiceImpl.java
│   │           └── infraestructura/
│   │               ├── config/
│   │               │   ├── AuthorizationConfig.java
│   │               │   └── AuthorizationFilterConfig.java
│   │               └── filtros/
│   │                   └── StandardAuthorizationFilter.java
│   └── resources/
│       └── META-INF/
│           └── spring.factories (para auto-configuración)
└── test/
    └── java/
        └── com/
            └── tuempresa/
                ├── dominio/
                │   └── autorizacion/
                │       └── AuthorizationServiceTest.java
                └── infraestructura/
                    └── filtros/
                        └── StandardAuthorizationFilterTest.java
Solución: Librería de Seguridad Hexagonal Integrada
La solución se basa en una serie de clases y componentes que pueden ser empaquetados como una librería reutilizable. Esta librería permite:
- Centralizar la lógica de autorización en el dominio, desacoplada de la infraestructura.
- Configurar rutas excluidas, parámetros y comportamiento desde archivos de configuración.
- Integrar con Spring Security para habilitar anotaciones y acceso al usuario autenticado.
- Validar JWT y extraer roles/claims para el contexto de seguridad.
A continuación, se presentan las clases clave de la solución.
1. Contexto de Autorización (Dominio)
package com.tuempresa.dominio.autorizacion;

import lombok.Builder;
import lombok.Value;
import java.util.Map;

@Value
@Builder
public class AuthorizationContext {
    String method;
    String uri;
    Map<String, String> headers;
    Map<String, String> queryParams;
    String body;
    String remoteAddress;
}
2. Excepción de Dominio
package com.tuempresa.dominio.autorizacion;

public class AuthorizationException extends RuntimeException {
    public AuthorizationException(String message) {
        super(message);
    }
}
3. Puerto de Dominio (Interface)
package com.tuempresa.dominio.autorizacion;

public interface AuthorizationService {
    void authorize(AuthorizationContext context) throws AuthorizationException;
}
4. Implementación Base del Servicio de Dominio
package com.tuempresa.dominio.autorizacion;

public class AuthorizationServiceImpl implements AuthorizationService {
    @Override
    public void authorize(AuthorizationContext context) {
        String token = context.getHeaders().get("authorization");
        if (token == null || !token.startsWith("Bearer ")) {
            throw new AuthorizationException("Token inválido o ausente");
        }
        // Más lógica de dominio...
    }
}
5. Configuración del Filtro
package com.tuempresa.infraestructura.config;

import lombok.Data;
import org.springframework.boot.context.properties.ConfigurationProperties;
import org.springframework.stereotype.Component;
import java.util.Set;
import java.util.HashSet;

@Data
@Component
@ConfigurationProperties(prefix = "app.security.authorization")
public class AuthorizationFilterConfig {

    private Set<String> excludedPaths = new HashSet<>();
    private boolean enabled = true;
    private int order = 1;
    private boolean includeQueryParams = true;
    private boolean includeBody = false;
    private boolean enableSpringSecurityIntegration = true;

    public AuthorizationFilterConfig() {
        excludedPaths.add("/actuator/health");
        excludedPaths.add("/actuator/info");
        excludedPaths.add("/swagger-ui");
        excludedPaths.add("/v3/api-docs");
        excludedPaths.add("/error");
    }
}
6. Filtro Principal Consolidado
package com.tuempresa.infraestructura.filtros;

import com.tuempresa.dominio.autorizacion.AuthorizationContext;
import com.tuempresa.dominio.autorizacion.AuthorizationService;
import com.tuempresa.dominio.autorizacion.AuthorizationException;
import com.tuempresa.infraestructura.config.AuthorizationFilterConfig;

import lombok.RequiredArgsConstructor;
import org.springframework.boot.autoconfigure.condition.ConditionalOnProperty;
import org.springframework.core.annotation.Order;
import org.springframework.security.authentication.UsernamePasswordAuthenticationToken;
import org.springframework.security.core.authority.SimpleGrantedAuthority;
import org.springframework.security.core.context.SecurityContextHolder;
import org.springframework.stereotype.Component;
import org.springframework.web.filter.OncePerRequestFilter;
import org.springframework.web.util.ContentCachingRequestWrapper;

import javax.servlet.FilterChain;
import javax.servlet.ServletException;
import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletResponse;
import java.io.IOException;
import java.nio.charset.StandardCharsets;
import java.util.*;

@Component
@Order(1)
@ConditionalOnProperty(name = "app.security.authorization.enabled", havingValue = "true", matchIfMissing = true)
@RequiredArgsConstructor
public class StandardAuthorizationFilter extends OncePerRequestFilter {

    private final AuthorizationFilterConfig config;
    private final AuthorizationService authorizationService;

    @Override
    protected void doFilterInternal(HttpServletRequest request,
                                    HttpServletResponse response,
                                    FilterChain filterChain) throws ServletException, IOException {

        if (isExcludedPath(request.getRequestURI())) {
            filterChain.doFilter(request, response);
            return;
        }

        try {
            HttpServletRequest requestToUse = request;
            if (config.isIncludeBody()) {
                requestToUse = new ContentCachingRequestWrapper(request);
            }

            Map<String, String> headers = extractHeaders(requestToUse);
            Map<String, String> queryParams = config.isIncludeQueryParams() ? extractQueryParams(requestToUse) : Collections.emptyMap();
            String requestBody = (config.isIncludeBody() && requestToUse instanceof ContentCachingRequestWrapper)
                    ? extractRequestBody((ContentCachingRequestWrapper) requestToUse)
                    : null;

            AuthorizationContext context = AuthorizationContext.builder()
                    .method(requestToUse.getMethod())
                    .uri(requestToUse.getRequestURI())
                    .headers(headers)
                    .queryParams(queryParams)
                    .body(requestBody)
                    .remoteAddress(requestToUse.getRemoteAddr())
                    .build();

            authorizationService.authorize(context);

            // Integración con Spring Security (si está habilitada)
            if (config.isEnableSpringSecurityIntegration()) {
                setSpringSecurityContext(context);
            }

            filterChain.doFilter(requestToUse, response);

        } catch (AuthorizationException e) {
            handleSecurityException(response, e);
        } catch (Exception e) {
            logger.error("Error in authorization filter", e);
            handleGenericError(response);
        }
    }

    private Map<String, String> extractHeaders(HttpServletRequest request) {
        Map<String, String> headers = new HashMap<>();
        Enumeration<String> headerNames = request.getHeaderNames();
        while (headerNames.hasMoreElements()) {
            String headerName = headerNames.nextElement();
            String headerValue = request.getHeader(headerName);
            headers.put(headerName.toLowerCase(), headerValue);
        }
        return headers;
    }

    private Map<String, String> extractQueryParams(HttpServletRequest request) {
        Map<String, String> queryParams = new HashMap<>();
        Enumeration<String> paramNames = request.getParameterNames();
        while (paramNames.hasMoreElements()) {
            String paramName = paramNames.nextElement();
            String paramValue = request.getParameter(paramName);
            queryParams.put(paramName, paramValue);
        }
        return queryParams;
    }

    private String extractRequestBody(ContentCachingRequestWrapper request) throws IOException {
        byte[] content = request.getContentAsByteArray();
        if (content.length > 0) {
            return new String(content, StandardCharsets.UTF_8);
        }
        return null;
    }

    private void setSpringSecurityContext(AuthorizationContext context) {
        try {
            String authHeader = context.getHeaders().get("authorization");
            if (authHeader != null && authHeader.startsWith("Bearer ")) {
                String username = extractUsernameFromToken(authHeader);
                List<String> roles = extractRolesFromToken(authHeader);
                List<SimpleGrantedAuthority> authorities = roles.stream()
                        .map(role -> new SimpleGrantedAuthority("ROLE_" + role.toUpperCase()))
                        .toList();

                UsernamePasswordAuthenticationToken authentication =
                        new UsernamePasswordAuthenticationToken(username, null, authorities);

                SecurityContextHolder.getContext().setAuthentication(authentication);
            }
        } catch (Exception e) {
            logger.warn("Could not set Spring Security context", e);
        }
    }

    private String extractUsernameFromToken(String authHeader) {
        // Implementar parsing del JWT aquí
        return "user_from_jwt"; // Placeholder
    }

    private List<String> extractRolesFromToken(String authHeader) {
        // Implementar parsing del JWT aquí
        return List.of("USER"); // Placeholder
    }

    private boolean isExcludedPath(String requestURI) {
        return config.getExcludedPaths().stream()
                .anyMatch(excluded -> requestURI.startsWith(excluded));
    }

    private void handleSecurityException(HttpServletResponse response, AuthorizationException e) throws IOException {
        response.setStatus(HttpServletResponse.SC_UNAUTHORIZED);
        response.setContentType("application/json");
        response.getWriter().write(String.format(
                "{\"error\":\"Unauthorized\",\"message\":\"%s\",\"timestamp\":\"%s\"}",
                e.getMessage(), new Date()
        ));
    }

    private void handleGenericError(HttpServletResponse response) throws IOException {
        response.setStatus(HttpServletResponse.SC_INTERNAL_SERVER_ERROR);
        response.setContentType("application/json");
        response.getWriter().write(String.format(
                "{\"error\":\"Internal Server Error\",\"message\":\"Authorization check failed\",\"timestamp\":\"%s\"}",
                new Date()
        ));
    }
}
7. Configuración de Beans
package com.tuempresa.infraestructura.config;

import com.tuempresa.dominio.autorizacion.AuthorizationService;
import com.tuempresa.dominio.autorizacion.AuthorizationServiceImpl;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class AuthorizationConfig {
    @Bean
    public AuthorizationService authorizationService() {
        return new AuthorizationServiceImpl();
    }
}
8. Configuración en application.yml
app:
  security:
    authorization:
      enabled: true
      order: 1
      include-query-params: true
      include-body: false
      enable-spring-security-integration: true
      excluded-paths:
        - "/actuator/health"
        - "/actuator/info"
        - "/swagger-ui"
        - "/v3/api-docs"
        - "/public"
        - "/auth/login"
9. Ejemplo de Uso en el Proyecto Cliente
@Service
public class MyCustomAuthorizationService implements AuthorizationService {

    @Override
    public void authorize(AuthorizationContext context) throws AuthorizationException {
        String token = context.getHeaders().get("authorization");
        if (!isValidJWT(token)) {
            throw new AuthorizationException("JWT inválido");
        }
        if (context.getUri().startsWith("/admin") && !hasAdminRole(token)) {
            throw new AuthorizationException("Acceso denegado a área administrativa");
        }
    }

    private boolean isValidJWT(String token) {
        // Implementar validación JWT
        return true;
    }

    private boolean hasAdminRole(String token) {
        // Verificar roles en el JWT
        return false;
    }
}
10. Uso en Controllers
@RestController
public class MyController {

    @GetMapping("/protected")
    @PreAuthorize("hasRole('USER')")
    public String protectedEndpoint(@AuthenticationPrincipal String username) {
        return "Hello " + username + "! You are authenticated.";
    }

    @GetMapping("/admin")
    @PreAuthorize("hasRole('ADMIN')")
    public String adminEndpoint() {
        return "Admin area";
    }
}
Consideraciones Finales
- Separación de responsabilidades: El dominio se mantiene puro y desacoplado de la infraestructura.
- Integración total: Se habilita el uso de anotaciones y la inyección del usuario autenticado gracias a la integración con el contexto de Spring Security.
- Configurabilidad: La solución es fácilmente adaptable a distintos proyectos mediante configuración externa.
- Reutilización: El diseño modular permite empaquetar la solución como una librería para múltiples aplicaciones.
Conclusión
La estandarización de la seguridad bajo una arquitectura hexagonal, combinada con la integración de Spring Security y JWT, permite construir aplicaciones robustas, mantenibles y alineadas con las mejores prácticas de la industria. Esta aproximación no solo facilita la reutilización y el testeo, sino que también habilita la evolución futura del sistema, permitiendo incorporar nuevas estrategias de autenticación o autorización sin comprometer la arquitectura.
Gestión de Migraciones de Base de Datos con Flyway en Spring Boot"
- Mauricio ECR
- Persistencia
- 14 Apr, 2025
Introducción El desarrollo de aplicaciones modernas no solo implica escribir código de negocio, sino también gestionar la evolución de la base de datos. A medida que un proyecto crece, mantener

Gestión de Migraciones de Base de Datos con Flyway en Spring Boot"
- Mauricio ECR
- Persistencia
- 14 Apr, 2025
Introducción
El desarrollo de aplicaciones modernas no solo implica escribir código de negocio, sino también gestionar la evolución de la base de datos. A medida que un proyecto crece, mantener la coherencia del esquema entre desarrolladores, ramas y entornos puede volverse complejo.
Aquí es donde Flyway entra en juego: una herramienta de migración de base de datos ligera y poderosa que permite controlar versiones de esquemas de forma segura, repetible y automatizada.
¿Qué es Flyway?
Flyway es una herramienta de migración de base de datos que permite aplicar scripts de manera controlada y automática. Utiliza una convención de nombres para identificar versiones y aplica cambios incrementales cada vez que la aplicación se inicia.
Problemas que resuelve:
- Desincronización entre esquemas de desarrollo, prueba y producción.
- Cambios accidentales o no versionados.
- Dificultad para aplicar migraciones en equipo o CI/CD.
- Fragilidad de los esquemas generados automáticamente por JPA.
Comparación breve con alternativas:
| Herramienta | Lenguaje | Comunidad | SQL puro | Migraciones Java |
|---|---|---|---|---|
| Flyway | Java | Muy activa | ✅ Sí | ✅ Opcional |
| Liquibase | Java | Activa | ✅ Sí | ✅ Más flexible |
¿Cuándo usar Flyway?
Escenarios ideales:
- Proyectos con evolución frecuente del esquema.
- Equipos distribuidos o con múltiples entornos (dev, test, prod).
- Necesidad de auditoría o trazabilidad de cambios en el esquema.
Ventajas sobre auto-DDL de JPA (spring.jpa.hibernate.ddl-auto):
- Evita sobrescritura accidental de datos.
- Versionado explícito de cambios.
- Mayor control y trazabilidad de la evolución del esquema.
Implementación en Spring Boot
Requisitos previos:
Agrega las siguientes dependencias en tu archivo pom.xml:
<dependencies>
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-data-jpa</artifactId>
    </dependency>
    <dependency>
        <groupId>org.flywaydb</groupId>
        <artifactId>flyway-core</artifactId>
    </dependency>
</dependencies>
Para Gradle:
implementation 'org.flywaydb:flyway-core'
Configuración básica (application.properties):
spring.datasource.url=jdbc:h2:mem:testdb
spring.datasource.username=sa
spring.datasource.password=
spring.datasource.driver-class-name=org.h2.Driver

spring.jpa.hibernate.ddl-auto=none

spring.flyway.enabled=true
spring.flyway.locations=classpath:db/migration
Ejemplo Práctico: Proyecto de Gestión de Usuarios
Supongamos una aplicación con una tabla users. Vamos a construir el esquema paso a paso usando Flyway.
Estructura del proyecto:
src/
 └── main/
     └── resources/
         └── db/
             └── migration/
                 ├── V1__Create_user_table.sql
                 └── V2__Add_user_role_column.sql
Primera Iteración – Crear tabla users
Archivo: V1__Create_user_table.sql
CREATE TABLE users (
    id BIGINT PRIMARY KEY,
    username VARCHAR(50) NOT NULL,
    email VARCHAR(100) UNIQUE
);
✅ Al iniciar la aplicación, Flyway detecta este archivo y lo ejecuta. Marca la versión como aplicada en su propia tabla de control (flyway_schema_history).
Segunda Iteración – Agregar columna role
Archivo: V2__Add_user_role_column.sql
ALTER TABLE users ADD COLUMN role VARCHAR(20) DEFAULT 'USER';
✅ Flyway identifica que esta versión aún no ha sido aplicada, la ejecuta y actualiza su historial. No vuelve a aplicar la versión 1.
Visualización del Estado de la Base de Datos Tras las Migraciones
Después de ejecutar las dos migraciones (V1 y V2), Flyway deja una huella en la base de datos que te permite auditar el estado de los cambios.
Tablas creadas tras las migraciones:
1. Tabla de usuarios (users):
SELECT * FROM users;
Estructura:
| Columna | Tipo | Restricciones |
|---|---|---|
| id | BIGINT | PRIMARY KEY |
| username | VARCHAR(50) | NOT NULL |
| VARCHAR(100) | UNIQUE | |
| role | VARCHAR(20) | DEFAULT 'USER' |
2. Tabla de control de Flyway (flyway_schema_history):
SELECT * FROM flyway_schema_history;
Ejemplo de contenido:
| installed_rank | version | description | type | script | success |
|---|---|---|---|---|---|
| 1 | 1 | Create user table | SQL | V1__Create_user_table.sql | true |
| 2 | 2 | Add user role column | SQL | V2__Add_user_role_column.sql | true |
Migraciones Java-based
Aunque Flyway trabaja perfectamente con scripts SQL, en algunos casos puede ser útil definir migraciones programáticamente en Java. Esto es útil cuando:
- Necesitas lógica condicional o control de flujo.
- Quieres reutilizar servicios de Spring.
- Trabajas con bases de datos no relacionales o lógicas avanzadas.
Cómo crear una migración Java:
- Implementa la clase extendiendo
BaseJavaMigration. - Ubícala en el paquete
db.migrationo configura la ubicación. - Nómbrala con el patrón
V{n}__Descripción.
Ejemplo: Crear tabla de auditoría
package db.migration;

import org.flywaydb.core.api.migration.BaseJavaMigration;
import org.flywaydb.core.api.migration.Context;

import java.sql.Statement;

public class V3__Create_audit_table extends BaseJavaMigration {
    @Override
    public void migrate(Context context) throws Exception {
        try (Statement stmt = context.getConnection().createStatement()) {
            stmt.execute("""
                CREATE TABLE audit (
                    id BIGINT PRIMARY KEY AUTO_INCREMENT,
                    action VARCHAR(100),
                    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
                );
            """);
        }
    }
}
Configuración adicional si se cambia la ubicación:
spring.flyway.locations=classpath:db/migration
spring.flyway.java-migrations-location=com.ejemplo.migraciones
Tabla Resumen
| Concepto | Descripción |
|---|---|
| Migraciones | Archivos SQL con prefijo V{n}__ que modifican el esquema. |
| Integración con Spring | Ejecuta automáticamente migraciones al iniciar la app. |
| Ubicación por defecto | classpath:db/migration |
| Uso recomendado | Proyectos con cambios frecuentes en el esquema y colaboración en equipo. |
Conclusión
Flyway no solo gestiona migraciones de manera declarativa (con SQL), sino que también ofrece una vía programática potente para casos avanzados. Su integración con Spring Boot hace que los cambios de esquema sean seguros, trazables y consistentes.
Recomendaciones Finales:
- Nunca modifiques un script ya aplicado.
- Usa migraciones Java cuando lo SQL no sea suficiente.
- Verifica la tabla
flyway_schema_historypara diagnosticar errores o validar versiones.
Referencias

WebSockets Seguros en Spring Boot: Protege tus Conexionesen Tiempo Real
- Mauricio ECR
- Seguridad
- 04 Apr, 2025
Introducción En la era de las aplicaciones en tiempo real, los WebSockets se han convertido en una tecnología fundamental para crear experiencias interactivas. Sin embargo, su naturaleza persisten

WebSockets Seguros en Spring Boot: Protege tus Conexionesen Tiempo Real
- Mauricio ECR
- Seguridad
- 04 Apr, 2025
Introducción
En la era de las aplicaciones en tiempo real, los WebSockets se han convertido en una tecnología fundamental para crear experiencias interactivas. Sin embargo, su naturaleza persistente y bidireccional presenta desafíos únicos de seguridad.
¿Cómo garantizar que solo usuarios autenticados puedan establecer conexiones WebSocket?
¿Cómo proteger los mensajes intercambiados?
Este artículo presenta una implementación completa de WebSockets seguros en Spring Boot, con explicaciones detalladas de cada componente y su función en el sistema de seguridad.
🛠️ Implementación del Backend
1. Clase Principal de la Aplicación
Esta es la clase de entrada estándar para una aplicación Spring Boot, que inicia el contexto de la aplicación.
package com.mecr.sample.webSocketsSecurity;

@SpringBootApplication
public class WebSocketsSecurityApplication {

    public static void main(String[] args) {
        SpringApplication.run(WebSocketsSecurityApplication.class, args);
    }
}
2. Configuración de Seguridad
La clase SecurityConfig define las reglas de seguridad para la aplicación, incluyendo la protección de endpoints WebSocket, configuración CORS y autenticación básica.
package com.mecr.sample.webSocketsSecurity.security.config;

@Configuration
public class SecurityConfig {

    @Bean
    public SecurityFilterChain securityFilterChain(HttpSecurity http) throws Exception {
        http
                .cors(cors -> cors.configurationSource(corsConfigurationSource()))
                .csrf(AbstractHttpConfigurer::disable)
                .authorizeHttpRequests(auth -> auth
                        .requestMatchers("/ws/**").authenticated()
                        .anyRequest().permitAll()
                )
                .formLogin(withDefaults())
                .logout(withDefaults());

        return http.build();
    }

    @Bean
    public CorsConfigurationSource corsConfigurationSource() {
        CorsConfiguration config = new CorsConfiguration();
        config.setAllowedOrigins(List.of("http://127.0.0.1:5500", "http://localhost:5500"));
        config.setAllowedMethods(List.of("GET", "POST", "PUT", "DELETE", "OPTIONS"));
        config.setAllowCredentials(true);
        config.setAllowedHeaders(List.of("Authorization", "Content-Type", "X-Requested-With"));

        UrlBasedCorsConfigurationSource source = new UrlBasedCorsConfigurationSource();
        source.registerCorsConfiguration("/**", config);
        return source;
    }

    @Bean
    public UserDetailsService userDetailsService() {
        UserDetails user = User.withDefaultPasswordEncoder()
                .username("admin")
                .password("admin")
                .roles("USER")
                .build();

        return new InMemoryUserDetailsManager(user);
    }
}
3. Interceptor de Autenticación para WebSockets
El AuthHandshakeInterceptor verifica la autenticación del usuario antes de permitir el establecimiento de la conexión WebSocket.
package com.mecr.sample.webSocketsSecurity.webSocket.security;

public class AuthHandshakeInterceptor implements HandshakeInterceptor {

    @Override
    public boolean beforeHandshake(ServerHttpRequest request, ServerHttpResponse response,
                                   WebSocketHandler wsHandler, Map<String, Object> attributes) {
        if (request instanceof ServletServerHttpRequest servletRequest) {
            HttpSession session = servletRequest.getServletRequest().getSession(false);
            if (session != null) {
                SecurityContext context = (SecurityContext) session.getAttribute("SPRING_SECURITY_CONTEXT");
                if (context != null && context.getAuthentication() != null && context.getAuthentication().isAuthenticated()) {
                    attributes.put("AUTH", context.getAuthentication());
                    System.out.println("🔐 Usuario autenticado en interceptor: " + context.getAuthentication().getName());
                    return true;
                }
            }
        }
        System.out.println("❌ WebSocket rechazado en interceptor (no autenticado)");
        return false;
    }

    @Override
    public void afterHandshake(ServerHttpRequest request, ServerHttpResponse response,
                               WebSocketHandler wsHandler, Exception exception) {
    }
}
4. Manejador de WebSockets
MyWebSocketHandler gestiona los eventos del ciclo de vida de la conexión WebSocket y el procesamiento de mensajes.
package com.mecr.sample.webSocketsSecurity.webSocket.handler;

@Component
public class MyWebSocketHandler extends TextWebSocketHandler {

    @Override
    public void afterConnectionEstablished(WebSocketSession session) throws Exception {
        Authentication authentication = (Authentication) session.getAttributes().get("AUTH");

        if (authentication == null || !authentication.isAuthenticated()) {
            System.out.println("❌ WebSocket rechazado: Usuario no autenticado");
            session.close(CloseStatus.NOT_ACCEPTABLE);
            return;
        }

        System.out.println("✅ WebSocket conectado: " + authentication.getName());
        session.sendMessage(new TextMessage("Conexión exitosa! Bienvenido " + authentication.getName()));
    }

    @Override
    protected void handleTextMessage(WebSocketSession session, TextMessage message) throws Exception {
        Authentication authentication = (Authentication) session.getAttributes().get("AUTH");
        if (authentication == null || !authentication.isAuthenticated()) {
            session.close(CloseStatus.NOT_ACCEPTABLE);
            return;
        }

        System.out.println("📩 Mensaje recibido de " + authentication.getName() + ": " + message.getPayload());
        session.sendMessage(new TextMessage("Echo: " + message.getPayload()));
    }

    @Override
    public void handleTransportError(WebSocketSession session, Throwable exception) throws Exception {
        System.err.println("❌ Error en WebSocket: " + exception.getMessage());
    }

    @Override
    public void afterConnectionClosed(WebSocketSession session, CloseStatus status) throws Exception {
        System.out.println("🚪 WebSocket cerrado");
    }
}
5. Configuración de WebSockets
WebSocketConfig registra el manejador WebSocket y configura los interceptores necesarios.
package com.mecr.sample.webSocketsSecurity.webSocket.config;

@Configuration
@EnableWebSocket
public class WebSocketConfig implements WebSocketConfigurer {

    private final MyWebSocketHandler myWebSocketHandler;

    public WebSocketConfig(MyWebSocketHandler myWebSocketHandler) {
        this.myWebSocketHandler = myWebSocketHandler;
    }

    @Override
    public void registerWebSocketHandlers(WebSocketHandlerRegistry registry) {
        registry.addHandler(myWebSocketHandler, "/ws")
                .setAllowedOrigins("http://localhost:5500","http://127.0.0.1:5500")
                .addInterceptors(new HttpSessionHandshakeInterceptor(), new AuthHandshakeInterceptor());
    }
}
💻 Implementación del Frontend
Esta página HTML demuestra cómo interactuar con el backend seguro desde el navegador.
<!DOCTYPE html>
<html lang="es">
<head>
    <meta charset="UTF-8">
    <title>WebSocket con Seguridad</title>
</head>
<body>
    <h2>WebSocket Seguro</h2>
    <button onclick="login()">Iniciar Sesión</button>
    <button onclick="connectWebSocket()">Conectar WebSocket</button>
    <button onclick="sendMessage()">Enviar Mensaje</button>
    <p id="output"></p>

    <script>
        var socket;

        function login() {
            fetch("http://127.0.0.1:8080/login", {
                method: "POST",
                headers: {
                    "Content-Type": "application/x-www-form-urlencoded"
                },
                body: "username=admin&password=admin",
                credentials: "include"
            }).then(response => {
                if (response.ok) {
                    alert("Autenticado correctamente");
                } else {
                    alert("Error de autenticación");
                }
            }).catch(error => console.error("Error:", error));
        }

        function connectWebSocket() {
            socket = new WebSocket("ws://127.0.0.1:8080/ws");

            socket.onopen = function() {
                console.log("✅ WebSocket conectado!");
                socket.send("Hola servidor!");
            };

            socket.onmessage = function(event) {
                document.getElementById("output").innerText = "Respuesta del servidor: " + event.data;
            };

            socket.onerror = function(error) {
                console.error("❌ Error en WebSocket:", error);
            };

            socket.onclose = function() {
                console.log("🚪 WebSocket desconectado");
            };
        }

        function sendMessage() {
            if (socket) {
                socket.send("Hola desde cliente!");
            } else {
                alert("Conéctate primero!");
            }
        }
    </script>
</body>
</html>
✅ Conclusión
Esta implementación proporciona una base sólida para aplicaciones que requieren WebSockets seguros en Spring Boot. La combinación de Spring Security con interceptores personalizados garantiza que solo usuarios autenticados puedan establecer conexiones WebSocket, mientras que la configuración de CORS protege contra solicitudes no autorizadas desde otros dominios.
Los componentes clave trabajan juntos para ofrecer:
- Autenticación previa al handshake WebSocket
- Mantenimiento del contexto de seguridad durante la sesión
- Protección contra CSRF (aunque desactivada para WebSockets)
- Configuración CORS segura
- Manejo adecuado de errores y cierre de conexiones