Tags (73)
- Agile
- Alta disponibilidad
- Alternativas cloud
- Aop
- Arquitectura
- Arquitectura distribuida
- Automatizacion
- Aws
- Azure devops
- Base de datos
- Buenas practicas
- Cloud
- Colas
- Competing consumers
- Convenciones
- Copilot
- Diseno
- Docker
- Docker compose
- Documentacion
- Eda
- Equipos
- Escalabilidad
- Flujo de negocio
- Flujo de trabajo
- Flyway
- Git
- Gradle
- Herramientas digitales
- Ia
- Iam
- Infraestructura
- Java
- Jerarquia tecnica
- Jpa
- Jsonb
- Kafka
- Kubernetes
- Liderazgo en software
- Lineamientos
- Log
- Logging
- Microservicios
- Mongodb
- Monitoreo
- Nosql
- Observabilidad
- Open source
- Plugins
- Postgresql
- Privacidad
- Programacion funcional
- Programacion reactiva
- Rabbitmq
- Rotacion de talento
- Saga
- Scrum
- Security
- Seguridad
- Self hosting
- Sistemas legados
- Snippets
- Spring boot
- Spring mvc
- Sql
- Streams
- Threadlocal
- Trazabilidad
- Versionado
- Web
- Webflux
- Websockets
- Zero trust
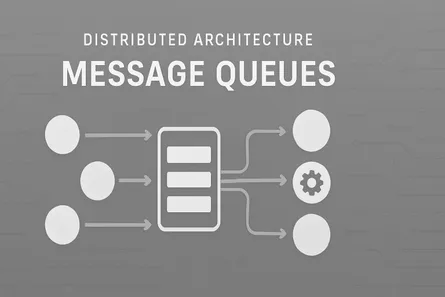
Cuándo Usar Colas de Mensajes en el Desarrollo de Software
- Mauricio ECR
- Arquitectura
- 18 Apr, 2025
Las colas de mensajes son herramientas clave para construir sistemas distribuidos, escalables y tolerantes a fallos. En este artículo te comparto una guía con situaciones comunes donde su uso es altam

Cuándo Usar Colas de Mensajes en el Desarrollo de Software
- Mauricio ECR
- Arquitectura
- 18 Apr, 2025
Las colas de mensajes son herramientas clave para construir sistemas distribuidos, escalables y tolerantes a fallos. En este artículo te comparto una guía con situaciones comunes donde su uso es altamente recomendable. Esto puede servirte como referencia rápida para decidir si una cola puede ser útil en tu arquitectura.
1. Procesamiento Asíncrono de Tareas Pesadas
Descripción de la situación
Una aplicación web necesita procesar tareas pesadas (como enviar correos, generar PDFs o hacer procesamiento de imágenes) después de una solicitud del usuario.
Dificultades
- Alta latencia si se procesa todo en la misma petición HTTP.
- Posibles timeouts en el servidor.
- Experiencia de usuario lenta y frustrante.
Por qué se solucionaría con colas de mensajes
Separar el procesamiento de la respuesta al usuario permite responder rápido y delegar la tarea a un worker. La cola actúa como puente entre el sistema que genera la tarea y el que la ejecuta.
Características típicas de la cola
- Persistencia para no perder mensajes si algo falla.
- Retries automáticos para tareas fallidas.
- Delay opcional para tareas programadas.
- Visibilidad de mensajes en procesamiento.
2. Comunicación Entre Microservicios
Descripción de la situación
Una arquitectura basada en microservicios donde varios servicios necesitan intercambiar información o coordinar acciones.
Dificultades
- El acoplamiento entre servicios crece si se comunican de forma directa (HTTP sincrónico).
- Si un servicio está caído, puede romper toda la cadena.
- Difícil escalar servicios de forma independiente.
Por qué se solucionaría con colas de mensajes
Las colas desacoplan los servicios, permitiendo que uno publique mensajes sin depender del estado del consumidor. Esto permite una comunicación más resiliente y escalable.
Características típicas de la cola
- Entrega garantizada (at-least-once).
- Soporte para múltiples consumidores.
- Escalabilidad horizontal.
- Opcional: orden garantizado de mensajes.
3. Picos de Carga Temporales
Descripción de la situación
Una aplicación recibe picos de tráfico (por ejemplo, durante una campaña de marketing o un evento en vivo).
Dificultades
- El sistema puede saturarse si intenta procesar todo al instante.
- Riesgo de perder solicitudes o fallar por falta de recursos.
Por qué se solucionaría con colas de mensajes
Las colas permiten "almacenar" las tareas y procesarlas a medida que los workers tienen capacidad. Se convierte una carga variable en una carga continua.
Características típicas de la cola
- Alta capacidad de buffer.
- Procesamiento en paralelo (workers escalables).
- Métricas para monitorear backlog.
- Integración con sistemas de auto-escalado.
4. Integración con Sistemas Externos o APIs Lentas
Descripción de la situación
Tu sistema necesita integrarse con APIs de terceros (por ejemplo, pasarelas de pago, servicios de envío, etc.) que pueden ser lentas o poco confiables.
Dificultades
- Timeouts frecuentes.
- Limitaciones de tasa (rate limiting).
- Caídas del servicio externo afectan el sistema completo.
Por qué se solucionaría con colas de mensajes
Poner las llamadas a servicios externos en una cola permite controlar el ritmo, manejar reintentos, y evitar sobrecargar al proveedor.
Características típicas de la cola
- Retries con backoff.
- Soporte para Dead Letter Queues (DLQ).
- Capacidad de definir prioridades o tasa de procesamiento.
- Persistencia y durabilidad.
5. Auditoría y Logging Centralizado
Descripción de la situación
Se requiere capturar eventos del sistema (como accesos, cambios de estado, errores) en un sistema central para auditoría o análisis.
Dificultades
- El logeo en tiempo real puede bloquear procesos principales.
- Si el sistema de auditoría cae, se pierden los eventos.
Por qué se solucionaría con colas de mensajes
Las colas permiten enviar eventos de forma asincrónica y confiable a un sistema de almacenamiento o procesamiento.
Características típicas de la cola
- Alta velocidad de escritura.
- Orden garantizado (opcional, según la necesidad).
- Múltiples consumidores (ej. para alertas, dashboards).
- Baja latencia.
6. Workflows Distribuidos (Orquestación de Procesos)
Descripción de la situación
Un proceso complejo requiere que varias acciones ocurran en orden y/o condicionalmente, como un onboarding de usuario o procesamiento de pagos.
Dificultades
- Difícil mantener el estado y coordinación entre servicios.
- Problemas de sincronización y gestión de errores.
Por qué se solucionaría con colas de mensajes
Las colas permiten implementar orquestadores que gestionan los pasos del workflow como eventos, con flexibilidad para manejar errores y lógica condicional.
Características típicas de la cola
- Soporte para enrutamiento de mensajes.
- Integración con motores de orquestación.
- Baja latencia y confiabilidad.
- Opcional: soporte para eventos tipo pub/sub.
🧪 Ejemplo: Generación Asíncrona de PDF usando una Cola
Este ejemplo representa un caso real y común: un usuario solicita la generación de un PDF. En lugar de procesarlo en la misma solicitud (lo cual puede tardar), se encola la tarea y un worker la procesa de forma asíncrona.
🧍♂️ Usuario solicita un PDF desde el Frontend
El usuario hace una solicitud para generar un PDF. Este proceso es controlado desde el frontend, donde el usuario envía su solicitud.
// Envío de solicitud desde el cliente (frontend)
// Este llamado puede estar en un botón: "Generar PDF"
fetch('/generate-pdf', {
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify({ userId: 123 })
})
  .then(res => res.json())
  .then(data => {
    // El usuario recibe un mensaje indicando que la tarea ha sido encolada.
    console.log(data.status);  // "Tarea encolada correctamente"
    console.log("ID de la tarea:", data.jobId);  // El ID para consultar el estado
  });
🧠 Backend (API) recibe la solicitud y encola la tarea
El backend recibe la solicitud del frontend y encola la tarea en una cola de trabajo para ser procesada en segundo plano. La API responde inmediatamente al usuario con la confirmación de que la tarea se ha encolado.
# Supongamos un backend en Flask (Python)

@app.route('/generate-pdf', methods=['POST'])
def generate_pdf():
    data = request.get_json()
    user_id = data['userId']

    # Genera un identificador único para la tarea
    job_id = str(uuid.uuid4())

    # Se encola una tarea para procesar luego
    enqueue_task('generate_pdf', {'user_id': user_id, 'job_id': job_id})

    # Responde al usuario con la confirmación de la tarea encolada
    return jsonify({
        'status': 'Tarea encolada correctamente',
        'jobId': job_id,  # ID de la tarea para que el usuario pueda consultar el estado
        'message': 'Te notificaremos cuando tu PDF esté listo para descargar.'
    })
¿Qué hace enqueue_task?
La función enqueue_task empuja la tarea a una cola (como Redis, RabbitMQ, AWS SQS, etc.). El jobId se guarda para poder referenciar la tarea.
def enqueue_task(task_name, data):
    task = {
        'name': task_name,
        'data': data
    }
    redis.rpush('pdf_tasks', json.dumps(task))  # Ejemplo con Redis
⚙️ Worker que consume tareas y las ejecuta
El worker es un proceso que corre en segundo plano y escucha la cola para procesar las tareas en el momento adecuado. Una vez que el PDF esté generado, puede guardarlo o enviarlo al usuario.
# Un worker que corre en segundo plano y escucha la cola

def worker():
    while True:
        raw_task = redis.blpop('pdf_tasks', timeout=0)  # Espera indefinidamente
        if raw_task:
            task = json.loads(raw_task[1])
            handle_task(task)

def handle_task(task):
    if task['name'] == 'generate_pdf':
        user_id = task['data']['user_id']
        job_id = task['data']['job_id']
        generate_pdf_for_user(user_id, job_id)

def generate_pdf_for_user(user_id, job_id):
    # Aquí iría la lógica real de generación del PDF
    print(f"Generando PDF para el usuario {user_id}")

    # Simulación: se genera el PDF y se guarda con el ID de tarea
    filename = f"{job_id}.pdf"
    with open(filename, "w") as f:
        f.write(f"PDF generado para usuario {user_id}")

    # Aquí podrías guardar el resultado en una BD o subirlo a un almacenamiento
    # Además, actualizamos el estado de la tarea en la base de datos o en el sistema de colas
    redis.set(f"job:{job_id}:status", "completado")
📥 Consulta del estado de la tarea (opcional)
El usuario puede consultar el estado de la tarea en cualquier momento utilizando el jobId que se le proporcionó cuando la tarea fue encolada. Esto permite saber si la tarea está aún en proceso o si ya ha sido completada.
@app.route('/job-status/<job_id>', methods=['GET'])
def job_status(job_id):
    status = redis.get(f"job:{job_id}:status")  # Recupera el estado desde Redis
    return jsonify({'jobId': job_id, 'status': status or 'pendiente'})
En este ejemplo, si el jobId existe en el sistema, el usuario recibirá el estado de la tarea. De lo contrario, puede devolver el estado como "pendiente" si la tarea aún no se ha completado.
📧 Notificación cuando la tarea se complete (opcional)
Además de permitir que el usuario consulte el estado, puedes configurar una notificación para cuando el trabajo esté listo. Esto podría ser una notificación en la web, un correo electrónico, o incluso un SMS.
Ejemplo de función de notificación:
def notify_user(user_id, job_id):
    # Esta función podría enviar un email, SMS o una notificación web
    # Aquí simplemente imprimimos un mensaje de ejemplo
    print(f"Notificando al usuario {user_id} que su PDF con jobId {job_id} está listo para descargar.")
Puedes llamar a esta función después de que la tarea haya sido procesada y el PDF esté disponible.
💡 Ventajas de este enfoque
- ✅ Respuesta inmediata: El usuario no espera bloqueado mientras se genera el PDF.
- 🕐 Asincronía: El trabajo pesado se maneja en segundo plano, sin afectar la experiencia del usuario.
- 🔔 Notificación opcional: El usuario puede ser notificado cuando la tarea esté lista.
- 🧱 Escalabilidad: Puedes agregar más workers si la carga aumenta, o priorizar tareas según la necesidad.
- 🔗 Desacoplamiento: El frontend no está directamente vinculado al procesamiento pesado.
Conclusión
Las colas no son solo una herramienta de "alto nivel empresarial", sino una solución práctica para muchos retos comunes en el desarrollo moderno. Identificar los síntomas típicos —como latencia, acoplamiento, o pérdida de datos— puede ayudarte a decidir cuándo usarlas.
Guía Rápida de Comandos y Cláusulas SQL
- Mauricio ECR
- Persistencia
- 15 Apr, 2025
SQL (Structured Query Language) es el lenguaje estándar para gestionar y manipular bases de datos relacionales. A continuación, encontrarás una guía rápida con los comandos y cláusulas más utilizados,

Guía Rápida de Comandos y Cláusulas SQL
- Mauricio ECR
- Persistencia
- 15 Apr, 2025
SQL (Structured Query Language) es el lenguaje estándar para gestionar y manipular bases de datos relacionales. A continuación, encontrarás una guía rápida con los comandos y cláusulas más utilizados, ejemplos prácticos y el orden de ejecución en una consulta SQL.
🛠️ Comandos Básicos de SQL
- SELECT: Selecciona datos de una tabla.
- FROM: Indica la tabla desde la cual se obtendrán los datos.
- WHERE: Filtra los resultados según una condición.
- AS: Asigna un alias a una columna o tabla.
- JOIN: Combina filas de dos o más tablas.
- AND: Une condiciones, todas deben cumplirse.
- OR: Une condiciones, al menos una debe cumplirse.
- LIMIT: Limita la cantidad de filas devueltas.
- IN: Filtra por varios valores posibles en una condición.
- CASE: Devuelve un valor basado en condiciones.
- IS NULL: Devuelve solo las filas con valores nulos.
- LIKE: Busca patrones dentro de una columna.
- COMMIT: Guarda los cambios de una transacción.
- ROLLBACK: Revierte una transacción.
🔧 Modificación de Tablas
- ALTER TABLE: Agrega o elimina columnas.
- UPDATE: Modifica datos existentes.
- CREATE: Crea una tabla, base de datos, índice o vista.
- DELETE: Elimina filas de una tabla.
- INSERT: Agrega una fila nueva.
- DROP: Elimina una tabla, base de datos o índice.
📊 Funciones de Agregación
- GROUP BY: Agrupa datos en conjuntos lógicos.
- ORDER BY: Ordena los resultados (usar
DESCpara descendente). - HAVING: Similar a WHERE pero se aplica a grupos.
- COUNT(): Cuenta el número de filas.
- SUM(): Suma los valores de una columna.
- AVG(): Calcula el promedio de una columna.
- MIN(): Devuelve el valor mínimo.
- MAX(): Devuelve el valor máximo. `
🔗 Tipos de JOIN
- INNER JOIN: Devuelve solo las coincidencias en ambas tablas.
- LEFT JOIN: Devuelve todos los registros de la tabla izquierda y coincidencias de la derecha.
- RIGHT JOIN: Devuelve todos los registros de la tabla derecha y coincidencias de la izquierda.
- FULL OUTER JOIN: Devuelve todos los registros con coincidencias en cualquiera de las tablas.
🔄 Orden de Ejecución en una Consulta SQL
- FROM – Se identifican las tablas.
- WHERE – Se filtran las filas.
- GROUP BY – Se agrupan los datos.
- HAVING – Se filtran los grupos.
- SELECT – Se seleccionan las columnas.
- ORDER BY – Se ordenan los resultados.
- LIMIT – Se limita la cantidad de filas.
💡 Ejemplos de SQL
Consultas Básicas
-- Seleccionar todas las columnas con filtro
SELECT * FROM tabla WHERE columna > 5;

-- Seleccionar primeras 10 filas de dos columnas
SELECT col1, col2 FROM tabla LIMIT 10;

-- Múltiples filtros con OR
SELECT * FROM tabla WHERE col1 > 5 OR col2 < 2;

-- Ordenar resultados
SELECT col1, col2 FROM tabla ORDER BY 1;
Funciones de Agregación
-- Contar filas
SELECT COUNT(*) FROM tabla;

-- Sumar valores
SELECT SUM(col1) FROM tabla;

-- Valor máximo
SELECT MAX(col1) FROM tabla;

-- Promedio agrupado
SELECT AVG(col1) FROM tabla GROUP BY col2;
Consultas Avanzadas
-- LEFT JOIN con alias
SELECT * FROM tabla AS t1 LEFT JOIN tabla2 AS t2 ON t2.col1 = t1.col1;

-- Agregación con filtro de grupo
SELECT col1, COUNT(*) AS total FROM tabla GROUP BY col1 HAVING COUNT(*) > 10;

-- Uso de CASE
SELECT col1,
       CASE
         WHEN col1 > 10 THEN 'más de 10'
         WHEN col1 < 10 THEN 'menos de 10'
         ELSE 'es 10'
       END AS NuevaColumna
FROM tabla;
🧱 Lenguaje de Definición de Datos (DDL)
-- Crear base de datos y tabla
CREATE DATABASE MiBase;
CREATE TABLE MiTabla (id INT, nombre VARCHAR(18));

-- Crear índice
CREATE INDEX IndiceNombre ON MiTabla(col1);

-- Alterar tabla
ALTER TABLE MiTabla ADD col5 INT;
ALTER TABLE MiTabla DROP COLUMN col5;

-- Eliminar base de datos o tabla
DROP DATABASE MiBase;
DROP TABLE MiTabla;
✍️ Lenguaje de Manipulación de Datos (DML)
-- Insertar fila
INSERT INTO MiTabla (col1, col2) VALUES ('valor1', 'valor2');

-- Actualizar valores
UPDATE MiTabla SET col1 = 56 WHERE col2 = 'algo';

-- Eliminar filas
DELETE FROM MiTabla WHERE col1 = 'algo';

-- Seleccionar columnas
SELECT col1, col2 FROM MiTabla;
Gestión de Migraciones de Base de Datos con Flyway en Spring Boot"
- Mauricio ECR
- Persistencia
- 14 Apr, 2025
Introducción El desarrollo de aplicaciones modernas no solo implica escribir código de negocio, sino también gestionar la evolución de la base de datos. A medida que un proyecto crece, mantener

Gestión de Migraciones de Base de Datos con Flyway en Spring Boot"
- Mauricio ECR
- Persistencia
- 14 Apr, 2025
Introducción
El desarrollo de aplicaciones modernas no solo implica escribir código de negocio, sino también gestionar la evolución de la base de datos. A medida que un proyecto crece, mantener la coherencia del esquema entre desarrolladores, ramas y entornos puede volverse complejo.
Aquí es donde Flyway entra en juego: una herramienta de migración de base de datos ligera y poderosa que permite controlar versiones de esquemas de forma segura, repetible y automatizada.
¿Qué es Flyway?
Flyway es una herramienta de migración de base de datos que permite aplicar scripts de manera controlada y automática. Utiliza una convención de nombres para identificar versiones y aplica cambios incrementales cada vez que la aplicación se inicia.
Problemas que resuelve:
- Desincronización entre esquemas de desarrollo, prueba y producción.
- Cambios accidentales o no versionados.
- Dificultad para aplicar migraciones en equipo o CI/CD.
- Fragilidad de los esquemas generados automáticamente por JPA.
Comparación breve con alternativas:
| Herramienta | Lenguaje | Comunidad | SQL puro | Migraciones Java |
|---|---|---|---|---|
| Flyway | Java | Muy activa | ✅ Sí | ✅ Opcional |
| Liquibase | Java | Activa | ✅ Sí | ✅ Más flexible |
¿Cuándo usar Flyway?
Escenarios ideales:
- Proyectos con evolución frecuente del esquema.
- Equipos distribuidos o con múltiples entornos (dev, test, prod).
- Necesidad de auditoría o trazabilidad de cambios en el esquema.
Ventajas sobre auto-DDL de JPA (spring.jpa.hibernate.ddl-auto):
- Evita sobrescritura accidental de datos.
- Versionado explícito de cambios.
- Mayor control y trazabilidad de la evolución del esquema.
Implementación en Spring Boot
Requisitos previos:
Agrega las siguientes dependencias en tu archivo pom.xml:
<dependencies>
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-data-jpa</artifactId>
    </dependency>
    <dependency>
        <groupId>org.flywaydb</groupId>
        <artifactId>flyway-core</artifactId>
    </dependency>
</dependencies>
Para Gradle:
implementation 'org.flywaydb:flyway-core'
Configuración básica (application.properties):
spring.datasource.url=jdbc:h2:mem:testdb
spring.datasource.username=sa
spring.datasource.password=
spring.datasource.driver-class-name=org.h2.Driver

spring.jpa.hibernate.ddl-auto=none

spring.flyway.enabled=true
spring.flyway.locations=classpath:db/migration
Ejemplo Práctico: Proyecto de Gestión de Usuarios
Supongamos una aplicación con una tabla users. Vamos a construir el esquema paso a paso usando Flyway.
Estructura del proyecto:
src/
 └── main/
     └── resources/
         └── db/
             └── migration/
                 ├── V1__Create_user_table.sql
                 └── V2__Add_user_role_column.sql
Primera Iteración – Crear tabla users
Archivo: V1__Create_user_table.sql
CREATE TABLE users (
    id BIGINT PRIMARY KEY,
    username VARCHAR(50) NOT NULL,
    email VARCHAR(100) UNIQUE
);
✅ Al iniciar la aplicación, Flyway detecta este archivo y lo ejecuta. Marca la versión como aplicada en su propia tabla de control (flyway_schema_history).
Segunda Iteración – Agregar columna role
Archivo: V2__Add_user_role_column.sql
ALTER TABLE users ADD COLUMN role VARCHAR(20) DEFAULT 'USER';
✅ Flyway identifica que esta versión aún no ha sido aplicada, la ejecuta y actualiza su historial. No vuelve a aplicar la versión 1.
Visualización del Estado de la Base de Datos Tras las Migraciones
Después de ejecutar las dos migraciones (V1 y V2), Flyway deja una huella en la base de datos que te permite auditar el estado de los cambios.
Tablas creadas tras las migraciones:
1. Tabla de usuarios (users):
SELECT * FROM users;
Estructura:
| Columna | Tipo | Restricciones |
|---|---|---|
| id | BIGINT | PRIMARY KEY |
| username | VARCHAR(50) | NOT NULL |
| VARCHAR(100) | UNIQUE | |
| role | VARCHAR(20) | DEFAULT 'USER' |
2. Tabla de control de Flyway (flyway_schema_history):
SELECT * FROM flyway_schema_history;
Ejemplo de contenido:
| installed_rank | version | description | type | script | success |
|---|---|---|---|---|---|
| 1 | 1 | Create user table | SQL | V1__Create_user_table.sql | true |
| 2 | 2 | Add user role column | SQL | V2__Add_user_role_column.sql | true |
Migraciones Java-based
Aunque Flyway trabaja perfectamente con scripts SQL, en algunos casos puede ser útil definir migraciones programáticamente en Java. Esto es útil cuando:
- Necesitas lógica condicional o control de flujo.
- Quieres reutilizar servicios de Spring.
- Trabajas con bases de datos no relacionales o lógicas avanzadas.
Cómo crear una migración Java:
- Implementa la clase extendiendo
BaseJavaMigration. - Ubícala en el paquete
db.migrationo configura la ubicación. - Nómbrala con el patrón
V{n}__Descripción.
Ejemplo: Crear tabla de auditoría
package db.migration;

import org.flywaydb.core.api.migration.BaseJavaMigration;
import org.flywaydb.core.api.migration.Context;

import java.sql.Statement;

public class V3__Create_audit_table extends BaseJavaMigration {
    @Override
    public void migrate(Context context) throws Exception {
        try (Statement stmt = context.getConnection().createStatement()) {
            stmt.execute("""
                CREATE TABLE audit (
                    id BIGINT PRIMARY KEY AUTO_INCREMENT,
                    action VARCHAR(100),
                    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
                );
            """);
        }
    }
}
Configuración adicional si se cambia la ubicación:
spring.flyway.locations=classpath:db/migration
spring.flyway.java-migrations-location=com.ejemplo.migraciones
Tabla Resumen
| Concepto | Descripción |
|---|---|
| Migraciones | Archivos SQL con prefijo V{n}__ que modifican el esquema. |
| Integración con Spring | Ejecuta automáticamente migraciones al iniciar la app. |
| Ubicación por defecto | classpath:db/migration |
| Uso recomendado | Proyectos con cambios frecuentes en el esquema y colaboración en equipo. |
Conclusión
Flyway no solo gestiona migraciones de manera declarativa (con SQL), sino que también ofrece una vía programática potente para casos avanzados. Su integración con Spring Boot hace que los cambios de esquema sean seguros, trazables y consistentes.
Recomendaciones Finales:
- Nunca modifiques un script ya aplicado.
- Usa migraciones Java cuando lo SQL no sea suficiente.
- Verifica la tabla
flyway_schema_historypara diagnosticar errores o validar versiones.
Referencias
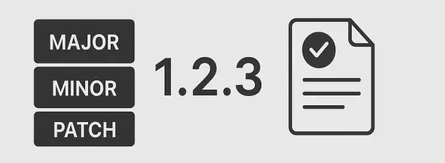
Descubre el Poder del SemVer: Optimiza el Versionado de tu Software y Mantén un CHANGELOG Excepcional
- Mauricio ECR
- Convenciones
- 08 Apr, 2025
El Versionado Semántico (SemVer) es una herramienta fundamental para comunicar de forma precisa los cambios en el software, facilitando el mantenimiento y la colaboración. Complementarlo con un **

Descubre el Poder del SemVer: Optimiza el Versionado de tu Software y Mantén un CHANGELOG Excepcional
- Mauricio ECR
- Convenciones
- 08 Apr, 2025
El Versionado Semántico (SemVer) es una herramienta fundamental para comunicar de forma precisa los cambios en el software, facilitando el mantenimiento y la colaboración. Complementarlo con un CHANGELOG bien estructurado potencia la transparencia y la trazabilidad, ofreciendo una visión detallada de la evolución de cada versión. En este artículo, exploraremos en profundidad cómo adoptar SemVer y cómo mantener un CHANGELOG que vaya de la mano para optimizar tu proceso de desarrollo.
Introducción
El control de versiones en el desarrollo de software se convierte en una ventaja competitiva cuando se implementa de forma clara y estructurada. SemVer aporta un sistema numérico que indica el alcance de los cambios (cambios mayores, menores o correcciones), mientras que el CHANGELOG documenta y narra el proceso evolutivo de tu proyecto. Esta sinergia no solo facilita la colaboración interna, sino que también mejora la comunicación con los usuarios y clientes, ayudando a identificar qué, cuándo y por qué se han realizado determinados cambios.
1. Estructura Básica de SemVer
El formato principal de SemVer se compone de tres segmentos:
MAJOR.MINOR.PATCH
- MAJOR: Se incrementa cuando se realizan cambios incompatibles con versiones anteriores (por ejemplo, la eliminación o modificación de una API pública).
- MINOR: Se aumenta cuando se agregan nuevas funcionalidades de manera compatible.
- PATCH: Se incrementa al corregir errores sin afectar las funcionalidades existentes.
Etiquetas Adicionales
- Pre-release: Indica versiones inestables, por ejemplo,
1.0.0-beta.1. - Build Metadata: Añade información adicional de compilación, como en
1.0.0+20230901.
2. Reglas para Incrementar Versiones
Al actualizar una versión, es fundamental distinguir entre los diferentes tipos de cambios:
Versión MAJOR (X.y.z → X+1.0.0):
Se utiliza cuando se introducen cambios que rompen la compatibilidad con versiones anteriores.
Ejemplo: Modificar o eliminar una API de forma incompatible.Versión MINOR (x.Y.z → x.Y+1.0):
Se incrementa al introducir nuevas funcionalidades sin afectar la compatibilidad.
Ejemplo: Agregar un método opcional a una clase.Versión PATCH (x.y.Z → x.y.Z+1):
Se utiliza para corregir errores, preservando la compatibilidad con versiones anteriores.
Ejemplo: Arreglar un error en una función de cálculo.
3. Ejemplos Prácticos
Versión Inicial:
0.1.0
Indica la fase de desarrollo inicial donde el software puede sufrir cambios drásticos.Primera Versión Estable:
1.0.0
Marca el lanzamiento oficial cuando la API es considerada estable y está documentada.Actualización con Nueva Funcionalidad:
De1.0.0a1.1.0para incorporar mejoras sin romper compatibilidad.Corrección Crítica:
De1.1.0a1.1.1para solucionar errores puntuales.Cambio Incompatible:
De1.1.1a2.0.0cuando se realizan modificaciones que requieren cambios en el código del consumidor.
4. La Importancia de Mantener un CHANGELOG
Un CHANGELOG es un registro sistemático y estructurado que documenta de manera cronológica cada cambio, mejora y corrección en el software. Su incorporación al proceso de SemVer proporciona un contexto narrativo, detallando el "porqué" y el "cómo" detrás de cada versión.
Beneficios Clave del CHANGELOG
Claridad en la Comunicación:
Complementa los números de versión de SemVer con descripciones detalladas de los cambios implementados.Trazabilidad y Historial:
Permite rastrear la evolución del software a lo largo del tiempo, facilitando la depuración y la revisión histórica.Transparencia Interna y Externa:
Informa tanto a los desarrolladores como a los usuarios finales sobre las mejoras y cambios realizados, fortaleciendo la confianza en el proceso de actualización.Soporte a la Automatización:
Herramientas integradas pueden actualizar el CHANGELOG de forma automática al seguir convenciones de commits, como Conventional Commits.
Mejores Prácticas para un CHANGELOG Efectivo
Estructuración Clara:
Organiza el CHANGELOG por versiones, empezando por la más reciente. Dentro de cada versión, clasifica los cambios en secciones como "Añadido", "Modificado", "Corregido" y "Notas de Deprecación".Actualización Continua:
Registra los cambios a medida que se van implementando para capturar detalles precisos y evitar omisiones.Integración con el Proceso de Versionado:
Vincula cada entrada del CHANGELOG con commits específicos y números de versión, facilitando la sincronización entre lo que se comunica y lo que se versiona.Comunicación Externa:
Publica el CHANGELOG en el repositorio del proyecto y en las notas de lanzamiento para que usuarios y colaboradores comprendan la evolución del software.
Ejemplo Básico de CHANGELOG
# CHANGELOG

## [2.0.0] - 2025-04-01
### Añadido
- Nueva función para exportación de datos.
### Modificado
- Actualización del sistema de autenticación (rompe compatibilidad con versiones anteriores).
### Corregido
- Error en el módulo de notificaciones.

## [1.2.1] - 2025-03-15
### Corregido
- Solucionado el error en la actualización automática del perfil del usuario.
5. Herramientas para Generar CHANGELOG Automáticamente
Usar herramientas automatizadas facilita enormemente el mantenimiento de un CHANGELOG claro y actualizado. A continuación, se presentan algunas opciones destacadas:
Conventional Changelog
- Base de muchas herramientas automatizadas.
- Genera el
CHANGELOG.mda partir de commits con formato estándar. - Ejemplo:
npx conventional-changelog -p angular -i CHANGELOG.md -s
standard-version
- Automatiza el versionado y el changelog sin publicar a npm.
- Ideal para control manual con automatización parcial.
npm install --save-dev standard-version
npx standard-version
semantic-release
- Automatiza TODO: changelog, versionado, publicación en npm o GitHub.
- Requiere entorno CI/CD (ej: GitHub Actions).
npm install --save-dev semantic-release
release-it
- Personalizable, ideal para flujos mixtos.
npm install --save-dev release-it
npx release-it
6. Convenciones de Commit (Conventional Commits)
Estas convenciones estructuran los mensajes de commit para que puedan ser procesados automáticamente:
<tipo>(opcional: alcance): descripción

[opcional] cuerpo del mensaje
[opcional] notas de ruptura (BREAKING CHANGE)
Ejemplos:
feat(auth): agregar login con Google
fix(api): corregir error de serialización
docs(readme): actualizar instrucciones de uso
BREAKING CHANGE: se eliminó el endpoint /v1/user
Tipos más comunes:
| Tipo | Uso |
|---|---|
feat |
Nueva funcionalidad |
fix |
Corrección de errores |
docs |
Cambios en la documentación |
style |
Cambios de formato (espacios, comas, etc.) |
refactor |
Refactorización del código sin cambios de funcionalidad |
test |
Cambios relacionados a pruebas |
chore |
Tareas menores de mantenimiento |
7. Gestión de Dependencias
El versionado semántico también afecta cómo se definen y gestionan las dependencias en los proyectos:
Caret ( ^ ):
Permite actualizaciones de versiones MINOR y PATCH. Por ejemplo,^1.2.3abarca versiones de la serie1.x.x.Tilde ( ~ ):
Restringe las actualizaciones a parches solamente. Por ejemplo,~1.2.3asegura que se mantenga la versión1.2.x.
8. Herramientas Recomendadas
- semver: Librería para comparar y validar versiones.
- Conventional Commits: Estándar de mensajes para facilitar changelogs automáticos.
- GitHub Actions/GitLab CI: Automatiza versiones y publicaciones.
- semantic-release / standard-version / release-it: Para generar changelogs y manejar versiones automáticamente.
Tabla Resumen
| Aspecto | Descripción | Ejemplo |
|---|---|---|
| Formato Básico de SemVer | MAJOR.MINOR.PATCH | 2.4.1 |
| Versión MAJOR | Cambios incompatibles que rompen versiones anteriores | 1.1.1 → 2.0.0 |
| Versión MINOR | Nuevas funcionalidades sin romper compatibilidad | 1.0.0 → 1.1.0 |
| Versión PATCH | Correcciones de errores sin afectar la funcionalidad | 1.1.0 → 1.1.1 |
| Pre-release | Versión inestable para pruebas | 1.0.0-beta.1 |
| Build Metadata | Información adicional de compilación | 1.0.0+20230901 |
| Gestión de Dependencias | Uso de caret (^) para permitir MINOR y PATCH; tilde (~) para solo PATCH | ^1.2.3 y ~1.2.3 |
| CHANGELOG | Registro detallado de cambios, organizado por versiones y secciones claras | Ver ejemplo en el artículo |
| Convenciones de Commit | Estilo estructurado que facilita la generación automática de changelog | feat, fix, chore, etc. |
| Herramientas de Automatización | Facilitan la gestión de versiones y changelog | semantic-release, standard-version, release-it |
Conclusión
Integrar el Versionado Semántico con un CHANGELOG completo y bien documentado garantiza un proceso de actualización y mantenimiento de software más transparente y predecible. Adoptar ambas prácticas no solo mejora la organización interna y el flujo de trabajo, sino que también fortalece la comunicación con los usuarios al explicar de forma detallada cada cambio realizado. Utiliza esta guía para transformar tu estrategia de versionado y construir una base sólida para el crecimiento y la evolución de tu proyecto de software.
Explorando las Topologías de Infraestructura en la Nube: Desde el Monolito hasta la Inteligencia Artificial Distribuida
- Mauricio ECR
- DevOps
- 05 Apr, 2025
Introducción El crecimiento exponencial de las soluciones en la nube ha transformado la manera en que diseñamos, desplegamos y mantenemos nuestras aplicaciones. Ya no hablamos solo de servidores y
Explorando las Topologías de Infraestructura en la Nube: Desde el Monolito hasta la Inteligencia Artificial Distribuida
- Mauricio ECR
- DevOps
- 05 Apr, 2025
Introducción
El crecimiento exponencial de las soluciones en la nube ha transformado la manera en que diseñamos, desplegamos y mantenemos nuestras aplicaciones. Ya no hablamos solo de servidores y bases de datos, sino de arquitecturas complejas y adaptativas que responden a necesidades específicas de negocio, escalabilidad y resiliencia. En este artículo, exploramos las principales topologías de infraestructura en la nube, categorizadas según su propósito principal. Para cada subcategoría se describe de manera fluida sus componentes clave, casos de uso comunes y ejemplos concretos. Finalizamos con un cuadro resumen que compara escalabilidad, resiliencia y elasticidad entre ellas.
Categoría 1: Aplicaciones Web y Backend
• Monolito en una sola instancia
Una única unidad que contiene toda la lógica de negocio y presentación. Suele usarse cuando se prioriza velocidad de desarrollo y simplicidad.
- Componentes: Servidor de aplicaciones, base de datos, DNS, logs.
- Caso de uso: Ideal para MVPs o aplicaciones internas simples donde se necesita rapidez de desarrollo.
- Ejemplo: App de reservas de un coworking local sin alta demanda.
• Arquitectura 2-tier
Separación básica entre presentación y lógica/datos. Aumenta ligeramente la modularidad y seguridad.
- Componentes: Frontend, backend, base de datos, red privada (VPC).
- Caso de uso: Aplicaciones CRUD sin requerimientos complejos.
- Ejemplo: Sistema de inventario de una tienda de barrio.
• Arquitectura 3-tier
División clara entre presentación, lógica de negocio y almacenamiento. Facilita escalabilidad y mantenimiento.
- Componentes: Web UI, capa de negocio/API, base de datos, cache, WAF, balanceador de carga.
- Caso de uso: Aplicaciones con múltiples usuarios y procesos críticos.
- Ejemplo: Portal de empleados de una empresa con 500+ usuarios.
• Microservicios
División modular del sistema en servicios independientes. Facilita despliegue continuo y escalado específico.
- Componentes: API Gateway, servicios desacoplados, base de datos por servicio, orquestador, service mesh.
- Caso de uso: Aplicaciones con alta demanda de escalabilidad y despliegue continuo.
- Ejemplo: Plataforma de e-commerce como Amazon.
• Serverless (FaaS)
Funcionalidad sin gestión directa de servidores. Excelente para eventos aislados y costos por uso.
- Componentes: Funciones (Lambda), API Gateway, triggers, S3/DynamoDB.
- Caso de uso: Ejecuciones bajo demanda o respuestas rápidas sin infraestructura constante.
- Ejemplo: Formulario web con almacenamiento directo en DynamoDB.
• Contenerizada
Uso de contenedores para portabilidad y consistencia. Ideal para equipos DevOps maduros.
- Componentes: Contenedores, orquestador (Kubernetes/ECS), ingress, config maps, monitoreo.
- Caso de uso: Apps modernas con despliegues ágiles.
- Ejemplo: Backend de servicios para una fintech.
• Edge / CDN-based
Distribución de contenido y funciones lo más cerca posible del usuario. Reduce latencia significativamente.
- Componentes: CDN, funciones en el edge, almacenamiento estático, DNS.
- Caso de uso: Sitios globales, rápidos y ligeros.
- Ejemplo: Página de campaña para Spotify con alto tráfico mundial.
Categoría 2: Procesamiento de Datos
• Batch Processing
Ejecución por lotes en horarios programados. Óptimo para procesos no críticos en tiempo real.
- Componentes: Orquestador, Spark/Glue, almacenamiento, data warehouse.
- Caso de uso: Procesos intensivos pero no urgentes.
- Ejemplo: Generación de reportes contables semanales.
• Streaming Processing
Procesamiento en tiempo real de eventos. Permite reacciones inmediatas.
- Componentes: Kafka, Flink, almacenamiento rápido, alertas.
- Caso de uso: Monitoreo o reacción instantánea.
- Ejemplo: Sistema de detección de fraudes financieros.
• ETL / ELT
Extracción, transformación y carga de datos. Clave para flujos de datos confiables.
- Componentes: Extractores, transformadores (dbt), destino (DW), scheduler.
- Caso de uso: Consolidación de fuentes de datos.
- Ejemplo: Integración entre sistema de ventas y CRM.
• Data Warehouse
Sistema analítico estructurado. Usado para análisis de negocio y reporting.
- Componentes: Redshift, Snowflake, BigQuery, herramientas BI.
- Caso de uso: Análisis de KPIs, dashboards.
- Ejemplo: Reportes de ventas mensuales para dirección comercial.
• Data Lake / Lakehouse
Almacenamiento de grandes volúmenes en múltiples formatos. Flexible y económico.
- Componentes: S3, Glue/Athena, catálogos de datos, seguridad.
- Caso de uso: Escenarios con datos semi/no estructurados.
- Ejemplo: Logs masivos de navegación en web.
• Data Mesh
Modelo distribuido y federado de datos. Favorece la autonomía por dominio.
- Componentes: Dominios de datos, APIs, gobernanza, interoperabilidad.
- Caso de uso: Independencia de equipos para publicar/consumir datos.
- Ejemplo: Multinacional con unidades de negocio autónomas.
Categoría 3: Machine Learning / Inteligencia Artificial
• Entrenamiento simple/local
Ejecutado en entornos personales o educativos. Bajo costo y accesibilidad.
- Componentes: Notebooks (Colab, Jupyter), datasets, librerías ML.
- Caso de uso: Prototipos y aprendizaje.
- Ejemplo: Clasificador de sentimientos en Google Colab.
• Entrenamiento distribuido
Requiere potencia de cómputo alto y paralelización. Usado en proyectos avanzados.
- Componentes: Clúster de GPUs, datasets, framework (TensorFlow/PyTorch).
- Caso de uso: Modelos de lenguaje o visión a gran escala.
- Ejemplo: Modelo LLM para sector salud.
• Inferencia batch
Aplicación del modelo a conjuntos de datos no urgentes. Utilizado en análisis periódicos.
- Componentes: Modelo, job programado, input/output, auditoría.
- Caso de uso: Predicciones acumuladas.
- Ejemplo: Scoring de riesgo semanal para cartera de clientes.
• Inferencia en tiempo real
Predicciones inmediatas vía API. Fundamental para experiencias personalizadas.
- Componentes: API, modelo cargado en memoria, balanceador.
- Caso de uso: Recomendaciones o respuestas interactivas.
- Ejemplo: Recomendador de productos online.
• MLOps Pipelines
Automatización del ciclo de vida ML. Mejora confiabilidad y trazabilidad.
- Componentes: CI/CD, versionado de datos/modelos, feature store.
- Caso de uso: Iteración y despliegue continuo de modelos.
- Ejemplo: Monitoreo y redeploy de modelo de anomalías.
• AutoML
Modelado automatizado con herramientas visuales. Democratiza el uso del ML.
- Componentes: Plataforma visual, datasets, API.
- Caso de uso: Democratización del ML.
- Ejemplo: Clasificador usando Google Vertex AI.
Categoría 4: DevOps y Entornos de Desarrollo
• CI/CD básico
Automatización del flujo de despliegue. Mejora velocidad y calidad.
- Componentes: Repositorio, pipelines, build/test/deploy.
- Caso de uso: Flujos simples de desarrollo continuo.
- Ejemplo: GitHub Actions para app Node.js.
• Entornos efímeros
Instancias temporales por cambios en código. Perfecto para validación rápida.
- Componentes: IaC, previsualizaciones por rama o PR.
- Caso de uso: Validación visual antes de merge.
- Ejemplo: Landing page preview con Vercel.
• Entornos dedicados
Separación de ambientes según etapa de desarrollo. Facilita pruebas seguras.
- Componentes: Dev, QA, Staging, Prod, variables.
- Caso de uso: Flujo robusto de pruebas.
- Ejemplo: Pipeline de pagos con pruebas por entorno.
• Infraestructura como Código (IaC)
Infra reproducible y versionada. Ideal para automatización multicloud.
- Componentes: Terraform/Pulumi, módulos, backends de estado.
- Caso de uso: Gestión multicloud declarativa.
- Ejemplo: Infraestructura de microservicios con Terraform.
• DevSecOps
Seguridad integrada al ciclo de desarrollo. Reduce riesgos desde el origen.
- Componentes: SAST, control de secretos, validación de seguridad.
- Caso de uso: Garantizar seguridad desde el código.
- Ejemplo: Validación de secretos y código con Vault y SonarQube.
Resumen General
A continuación, un resumen de las topologías abordadas, con sus propiedades clave:
| Grupo | Subcategoría | Escalabilidad | Resiliencia | Elasticidad | Componentes Principales | Caso de Uso / Ejemplo |
|---|---|---|---|---|---|---|
| Web/Backend | Monolito | Baja | Baja | Nula | Servidor, BD, DNS, logs | App reservas coworking |
| Web/Backend | 2-tier | Media | Media | Baja | Frontend, backend, BD | Inventario de tienda |
| Web/Backend | 3-tier | Alta | Alta | Media | UI, API, BD, cache, WAF | Portal empleados |
| Web/Backend | Microservicios | Muy Alta | Muy Alta | Alta | API GW, servicios, BD, mesh | E-commerce estilo Amazon |
| Web/Backend | Serverless | Muy Alta | Alta | Muy Alta | Lambda, S3, triggers | Formulario Lambda |
| Web/Backend | Contenerizada | Alta | Alta | Alta | K8s/ECS, contenedores | Backend fintech |
| Web/Backend | Edge/CDN | Alta | Alta | Alta | CDN, edge functions | Landing global Spotify |
| Datos | Batch | Media | Alta | Baja | Orquestador, Glue, DW | Reportes contables |
| Datos | Streaming | Alta | Alta | Alta | Kafka, Flink, alertas | Fraudes bancarios |
| Datos | ETL/ELT | Alta | Media | Media | Extractores, DBT, DW | Datos ventas y CRM |
| Datos | DW | Alta | Alta | Media | Redshift, BI | KPI dirección comercial |
| Datos | Lakehouse | Muy Alta | Alta | Alta | S3, Athena, catálogo | Logs web |
| Datos | Data Mesh | Alta | Alta | Media | APIs, dominios, gov | Datos en multinacional |
| IA/ML | Entrenamiento local | Baja | Baja | Nula | Notebooks, datasets | Clasificador Colab |
| IA/ML | Entrenamiento distribuido | Alta | Alta | Media | GPUs, TF/PT, dataset | LLM salud |
| IA/ML | Inferencia batch | Media | Alta | Baja | Job, modelo, IO | Scoring clientes |
| IA/ML | Inferencia tiempo real | Alta | Alta | Alta | API, modelo, load balancer | Recomendador productos |
| IA/ML | MLOps | Alta | Alta | Alta | CI/CD, feature store | Modelo de anomalías |
| IA/ML | AutoML | Media | Alta | Alta | Vertex AI, API | Vertex AI |
| DevOps | CI/CD | Media | Media | Media | GitHub, pipelines | GitHub Actions |
| DevOps | Entornos efímeros | Alta | Media | Alta | IaC, previews | Preview en Vercel |
| DevOps | Entornos dedicados | Media | Alta | Baja | QA, Staging, Prod | Validación por ambiente |
| DevOps | IaC | Alta | Alta | Alta | Terraform, módulos | Terraform multicloud |
| DevOps | DevSecOps | Alta | Alta | Alta | SAST, secretos, Vault | Pipeline seguro + Vault |
Este análisis puede servirte como hoja de ruta para diseñar arquitecturas eficientes, seguras y adaptadas al crecimiento de tu organización. Cada topología tiene su momento ideal de uso, y comprenderlas te permite tomar decisiones informadas en tu estrategia de nube.
Conclusión: Hacia una Elección Informada
Elegir la topología de infraestructura adecuada en la nube no es solo una cuestión técnica, sino una decisión estratégica que impacta directamente en la eficiencia, escalabilidad y competitividad de una organización. Como hemos visto, cada enfoque —desde un monolito sencillo hasta una arquitectura de MLOps distribuida— tiene fortalezas y compromisos que deben alinearse con el contexto del negocio, la madurez tecnológica del equipo y los objetivos a corto y largo plazo.
Al evaluar cuál topología adoptar, considera las siguientes preguntas clave:
- ¿Cuál es la etapa de madurez de tu producto o servicio?
- ¿Qué tan crítico es el tiempo de respuesta o la resiliencia para tu operación?
- ¿Tu equipo está preparado para gestionar la complejidad que implica escalar?
- ¿Qué tanto valor aportaría la automatización y observabilidad en tu flujo de trabajo?
Comenzar con una solución simple y evolucionar progresivamente hacia arquitecturas más sofisticadas es una estrategia válida y, en muchos casos, recomendable. Lo esencial es tener claridad en el propósito y una visión arquitectónica que te permita crecer sin reescribir desde cero cada vez que el negocio escale.
En definitiva, la nube no es solo infraestructura: es una plataforma para innovar con agilidad. Entender sus topologías es el primer paso para diseñar soluciones más robustas, eficientes y orientadas al futuro.
Gitea: Cómo Montar tu Propio Servidor Git en Minutos
- Mauricio ECR
- DevOps
- 04 Apr, 2025
A medida que los proyectos crecen y se diversifican, muchos desarrolladores empiezan a preguntarse si realmente necesitan depender de plataformas como GitHub o GitLab para gestionar su código. No es q
Gitea: Cómo Montar tu Propio Servidor Git en Minutos
- Mauricio ECR
- DevOps
- 04 Apr, 2025
A medida que los proyectos crecen y se diversifican, muchos desarrolladores empiezan a preguntarse si realmente necesitan depender de plataformas como GitHub o GitLab para gestionar su código. No es que esas herramientas estén mal, pero hay escenarios donde una alternativa más simple y autoalojada tiene mucho sentido.
Este artículo no es para convencerte de abandonar nada, sino para mostrarte una opción: Gitea, una plataforma ligera y fácil de montar para tener tu propio servidor Git.
¿Por Qué Considerar Gitea?
Si trabajas en proyectos personales, con un equipo pequeño, o simplemente te interesa aprender a montar tu propia infraestructura, hay algunas razones por las que podrías querer probar Gitea:
- Autonomía: No dependes de servidores externos.
- Simplicidad: La instalación es directa, sin configuraciones complejas.
- Control: Tú decides cómo se almacenan y gestionan los datos.
No es una solución perfecta para todos los casos, pero vale la pena conocerla. A veces lo que uno necesita es justamente eso: algo sencillo que funcione.
Cómo Instalar Gitea con Docker
Una de las formas más rápidas de poner Gitea en marcha es con Docker. Aquí va una guía paso a paso, sin adornos.
1. Crea un directorio para el proyecto
mkdir gitea && cd gitea
2. Crea un archivo docker-compose.yml
version: "3"

services:
  server:
    image: gitea/gitea:latest
    container_name: gitea
    environment:
      - USER_UID=1000
      - USER_GID=1000
    restart: unless-stopped
    volumes:
      - ./data:/data
    ports:
      - "3000:3000"   # Web
      - "2222:22"     # SSH
3. Levanta el contenedor
docker-compose up -d
4. Abre el navegador
Accede a http://localhost:3000 y completa la configuración inicial. No toma más de un par de minutos.
Subir un Repositorio a Gitea
Una vez que el servidor está funcionando, puedes empezar a usarlo como cualquier otro servicio Git.
- Crea un nuevo repositorio desde la interfaz web de Gitea.
- En tu máquina local, añade ese repositorio como remoto:
git remote add gitea http://localhost:3000/usuario/repositorio.git
git push -u gitea main
Y eso es todo. Estás trabajando con Git como siempre, pero ahora en tu propio servidor.
🔐 Autenticación por SSH
Subir y clonar repositorios por HTTP está bien para empezar, pero si planeas trabajar frecuentemente con tu servidor Gitea, usar SSH es mucho más seguro y cómodo.
1. Genera tu clave SSH (si no tienes una)
ssh-keygen -t ed25519 -C "[email protected]"
Esto creará dos archivos en ~/.ssh: una clave privada (id_ed25519) y una pública (id_ed25519.pub).
2. Agrega tu clave pública a Gitea
- En la interfaz web de Gitea, ve a "Tu Perfil" > "SSH Keys"
- Pega el contenido de
~/.ssh/id_ed25519.pub
3. Usa el remoto por SSH
Ahora puedes clonar así:
git clone ssh://git@localhost:2222/usuario/repositorio.git
Y también hacer push/pull sin tener que escribir tu contraseña.
⚙️ Integración de CI/CD con Drone
Aunque Gitea no incluye un sistema de CI/CD por defecto, es compatible con herramientas externas como Drone CI. Vamos a ver cómo integrarlo.
Docker Compose con Gitea + Drone
version: '3'

services:
  gitea:
    image: gitea/gitea:latest
    container_name: gitea
    restart: always
    environment:
      - USER_UID=1000
      - USER_GID=1000
    volumes:
      - ./gitea:/data
    ports:
      - "3000:3000"
      - "2222:22"
    networks:
      - cicd-net

  drone:
    image: drone/drone:latest
    container_name: drone
    restart: always
    ports:
      - "8080:80"
    volumes:
      - ./drone:/data
    environment:
      - DRONE_GITEA_SERVER=http://gitea:3000
      - DRONE_GITEA_CLIENT_ID=tu-client-id
      - DRONE_GITEA_CLIENT_SECRET=tu-client-secret
      - DRONE_RPC_SECRET=una-clave-secreta
      - DRONE_SERVER_HOST=localhost:8080
      - DRONE_SERVER_PROTO=http
      - DRONE_USER_CREATE=username:tu-usuario,admin:true
    networks:
      - cicd-net

networks:
  cicd-net:
    driver: bridge
Pasos Adicionales
Registra una aplicación OAuth en Gitea desde
http://localhost:3000/user/settings/applications.Usa
http://localhost:8080/logincomo Redirect URI.Copia el
Client IDyClient Secreten eldocker-compose.yml.Levanta los servicios:
docker-compose up -d
- Accede a Drone en
http://localhost:8080y conecta tu cuenta de Gitea. - Agrega un archivo
.drone.ymlen tu repositorio:
kind: pipeline
type: docker
name: default

steps:
  - name: test
    image: node:18
    commands:
      - npm install
      - npm test
- Activa el repositorio desde la interfaz de Drone.
🧭 Reflexión Final
Gitea es más que una curiosidad para quienes prefieren el control. Es una herramienta real, funcional y mantenida activamente. No está diseñada para reemplazar gigantes, pero sí para darte una alternativa cuando quieres aprender, experimentar o simplemente no depender de nadie más.
Con unos pocos comandos puedes levantar tu propio servidor Git, usar autenticación SSH, y hasta conectar una pipeline de CI/CD.
Y eso, en ciertos contextos, es todo lo que necesitas.