Tags (73)
- Agile
- Alta disponibilidad
- Alternativas cloud
- Aop
- Arquitectura
- Arquitectura distribuida
- Automatizacion
- Aws
- Azure devops
- Base de datos
- Buenas practicas
- Cloud
- Colas
- Competing consumers
- Convenciones
- Copilot
- Diseno
- Docker
- Docker compose
- Documentacion
- Eda
- Equipos
- Escalabilidad
- Flujo de negocio
- Flujo de trabajo
- Flyway
- Git
- Gradle
- Herramientas digitales
- Ia
- Iam
- Infraestructura
- Java
- Jerarquia tecnica
- Jpa
- Jsonb
- Kafka
- Kubernetes
- Liderazgo en software
- Lineamientos
- Log
- Logging
- Microservicios
- Mongodb
- Monitoreo
- Nosql
- Observabilidad
- Open source
- Plugins
- Postgresql
- Privacidad
- Programacion funcional
- Programacion reactiva
- Rabbitmq
- Rotacion de talento
- Saga
- Scrum
- Security
- Seguridad
- Self hosting
- Sistemas legados
- Snippets
- Spring boot
- Spring mvc
- Sql
- Streams
- Threadlocal
- Trazabilidad
- Versionado
- Web
- Webflux
- Websockets
- Zero trust

WebSockets Seguros en Spring Boot: Protege tus Conexionesen Tiempo Real
- Mauricio ECR
- Seguridad
- 04 Apr, 2025
Introducción En la era de las aplicaciones en tiempo real, los WebSockets se han convertido en una tecnología fundamental para crear experiencias interactivas. Sin embargo, su naturaleza persisten

WebSockets Seguros en Spring Boot: Protege tus Conexionesen Tiempo Real
- Mauricio ECR
- Seguridad
- 04 Apr, 2025
Introducción
En la era de las aplicaciones en tiempo real, los WebSockets se han convertido en una tecnología fundamental para crear experiencias interactivas. Sin embargo, su naturaleza persistente y bidireccional presenta desafíos únicos de seguridad.
¿Cómo garantizar que solo usuarios autenticados puedan establecer conexiones WebSocket?
¿Cómo proteger los mensajes intercambiados?
Este artículo presenta una implementación completa de WebSockets seguros en Spring Boot, con explicaciones detalladas de cada componente y su función en el sistema de seguridad.
🛠️ Implementación del Backend
1. Clase Principal de la Aplicación
Esta es la clase de entrada estándar para una aplicación Spring Boot, que inicia el contexto de la aplicación.
package com.mecr.sample.webSocketsSecurity;

@SpringBootApplication
public class WebSocketsSecurityApplication {

    public static void main(String[] args) {
        SpringApplication.run(WebSocketsSecurityApplication.class, args);
    }
}
2. Configuración de Seguridad
La clase SecurityConfig define las reglas de seguridad para la aplicación, incluyendo la protección de endpoints WebSocket, configuración CORS y autenticación básica.
package com.mecr.sample.webSocketsSecurity.security.config;

@Configuration
public class SecurityConfig {

    @Bean
    public SecurityFilterChain securityFilterChain(HttpSecurity http) throws Exception {
        http
                .cors(cors -> cors.configurationSource(corsConfigurationSource()))
                .csrf(AbstractHttpConfigurer::disable)
                .authorizeHttpRequests(auth -> auth
                        .requestMatchers("/ws/**").authenticated()
                        .anyRequest().permitAll()
                )
                .formLogin(withDefaults())
                .logout(withDefaults());

        return http.build();
    }

    @Bean
    public CorsConfigurationSource corsConfigurationSource() {
        CorsConfiguration config = new CorsConfiguration();
        config.setAllowedOrigins(List.of("http://127.0.0.1:5500", "http://localhost:5500"));
        config.setAllowedMethods(List.of("GET", "POST", "PUT", "DELETE", "OPTIONS"));
        config.setAllowCredentials(true);
        config.setAllowedHeaders(List.of("Authorization", "Content-Type", "X-Requested-With"));

        UrlBasedCorsConfigurationSource source = new UrlBasedCorsConfigurationSource();
        source.registerCorsConfiguration("/**", config);
        return source;
    }

    @Bean
    public UserDetailsService userDetailsService() {
        UserDetails user = User.withDefaultPasswordEncoder()
                .username("admin")
                .password("admin")
                .roles("USER")
                .build();

        return new InMemoryUserDetailsManager(user);
    }
}
3. Interceptor de Autenticación para WebSockets
El AuthHandshakeInterceptor verifica la autenticación del usuario antes de permitir el establecimiento de la conexión WebSocket.
package com.mecr.sample.webSocketsSecurity.webSocket.security;

public class AuthHandshakeInterceptor implements HandshakeInterceptor {

    @Override
    public boolean beforeHandshake(ServerHttpRequest request, ServerHttpResponse response,
                                   WebSocketHandler wsHandler, Map<String, Object> attributes) {
        if (request instanceof ServletServerHttpRequest servletRequest) {
            HttpSession session = servletRequest.getServletRequest().getSession(false);
            if (session != null) {
                SecurityContext context = (SecurityContext) session.getAttribute("SPRING_SECURITY_CONTEXT");
                if (context != null && context.getAuthentication() != null && context.getAuthentication().isAuthenticated()) {
                    attributes.put("AUTH", context.getAuthentication());
                    System.out.println("🔐 Usuario autenticado en interceptor: " + context.getAuthentication().getName());
                    return true;
                }
            }
        }
        System.out.println("❌ WebSocket rechazado en interceptor (no autenticado)");
        return false;
    }

    @Override
    public void afterHandshake(ServerHttpRequest request, ServerHttpResponse response,
                               WebSocketHandler wsHandler, Exception exception) {
    }
}
4. Manejador de WebSockets
MyWebSocketHandler gestiona los eventos del ciclo de vida de la conexión WebSocket y el procesamiento de mensajes.
package com.mecr.sample.webSocketsSecurity.webSocket.handler;

@Component
public class MyWebSocketHandler extends TextWebSocketHandler {

    @Override
    public void afterConnectionEstablished(WebSocketSession session) throws Exception {
        Authentication authentication = (Authentication) session.getAttributes().get("AUTH");

        if (authentication == null || !authentication.isAuthenticated()) {
            System.out.println("❌ WebSocket rechazado: Usuario no autenticado");
            session.close(CloseStatus.NOT_ACCEPTABLE);
            return;
        }

        System.out.println("✅ WebSocket conectado: " + authentication.getName());
        session.sendMessage(new TextMessage("Conexión exitosa! Bienvenido " + authentication.getName()));
    }

    @Override
    protected void handleTextMessage(WebSocketSession session, TextMessage message) throws Exception {
        Authentication authentication = (Authentication) session.getAttributes().get("AUTH");
        if (authentication == null || !authentication.isAuthenticated()) {
            session.close(CloseStatus.NOT_ACCEPTABLE);
            return;
        }

        System.out.println("📩 Mensaje recibido de " + authentication.getName() + ": " + message.getPayload());
        session.sendMessage(new TextMessage("Echo: " + message.getPayload()));
    }

    @Override
    public void handleTransportError(WebSocketSession session, Throwable exception) throws Exception {
        System.err.println("❌ Error en WebSocket: " + exception.getMessage());
    }

    @Override
    public void afterConnectionClosed(WebSocketSession session, CloseStatus status) throws Exception {
        System.out.println("🚪 WebSocket cerrado");
    }
}
5. Configuración de WebSockets
WebSocketConfig registra el manejador WebSocket y configura los interceptores necesarios.
package com.mecr.sample.webSocketsSecurity.webSocket.config;

@Configuration
@EnableWebSocket
public class WebSocketConfig implements WebSocketConfigurer {

    private final MyWebSocketHandler myWebSocketHandler;

    public WebSocketConfig(MyWebSocketHandler myWebSocketHandler) {
        this.myWebSocketHandler = myWebSocketHandler;
    }

    @Override
    public void registerWebSocketHandlers(WebSocketHandlerRegistry registry) {
        registry.addHandler(myWebSocketHandler, "/ws")
                .setAllowedOrigins("http://localhost:5500","http://127.0.0.1:5500")
                .addInterceptors(new HttpSessionHandshakeInterceptor(), new AuthHandshakeInterceptor());
    }
}
💻 Implementación del Frontend
Esta página HTML demuestra cómo interactuar con el backend seguro desde el navegador.
<!DOCTYPE html>
<html lang="es">
<head>
    <meta charset="UTF-8">
    <title>WebSocket con Seguridad</title>
</head>
<body>
    <h2>WebSocket Seguro</h2>
    <button onclick="login()">Iniciar Sesión</button>
    <button onclick="connectWebSocket()">Conectar WebSocket</button>
    <button onclick="sendMessage()">Enviar Mensaje</button>
    <p id="output"></p>

    <script>
        var socket;

        function login() {
            fetch("http://127.0.0.1:8080/login", {
                method: "POST",
                headers: {
                    "Content-Type": "application/x-www-form-urlencoded"
                },
                body: "username=admin&password=admin",
                credentials: "include"
            }).then(response => {
                if (response.ok) {
                    alert("Autenticado correctamente");
                } else {
                    alert("Error de autenticación");
                }
            }).catch(error => console.error("Error:", error));
        }

        function connectWebSocket() {
            socket = new WebSocket("ws://127.0.0.1:8080/ws");

            socket.onopen = function() {
                console.log("✅ WebSocket conectado!");
                socket.send("Hola servidor!");
            };

            socket.onmessage = function(event) {
                document.getElementById("output").innerText = "Respuesta del servidor: " + event.data;
            };

            socket.onerror = function(error) {
                console.error("❌ Error en WebSocket:", error);
            };

            socket.onclose = function() {
                console.log("🚪 WebSocket desconectado");
            };
        }

        function sendMessage() {
            if (socket) {
                socket.send("Hola desde cliente!");
            } else {
                alert("Conéctate primero!");
            }
        }
    </script>
</body>
</html>
✅ Conclusión
Esta implementación proporciona una base sólida para aplicaciones que requieren WebSockets seguros en Spring Boot. La combinación de Spring Security con interceptores personalizados garantiza que solo usuarios autenticados puedan establecer conexiones WebSocket, mientras que la configuración de CORS protege contra solicitudes no autorizadas desde otros dominios.
Los componentes clave trabajan juntos para ofrecer:
- Autenticación previa al handshake WebSocket
- Mantenimiento del contexto de seguridad durante la sesión
- Protección contra CSRF (aunque desactivada para WebSockets)
- Configuración CORS segura
- Manejo adecuado de errores y cierre de conexiones
Explorando las Bases de Datos NoSQL: Introducción a MongoDB
- Mauricio ECR
- Persistencia
- 30 Mar, 2025
📚 Introducción En un mundo donde el volumen y la variedad de los datos crecen exponencialmente, las bases de datos NoSQL se han convertido en una alternativa esencial frente a las tradicionales

Explorando las Bases de Datos NoSQL: Introducción a MongoDB
- Mauricio ECR
- Persistencia
- 30 Mar, 2025
📚 Introducción
En un mundo donde el volumen y la variedad de los datos crecen exponencialmente, las bases de datos NoSQL se han convertido en una alternativa esencial frente a las tradicionales bases de datos relacionales. Desde aplicaciones web modernas hasta análisis masivos de datos, las soluciones NoSQL ofrecen flexibilidad, escalabilidad y eficiencia en el manejo de datos estructurados y no estructurados.
En este documento, nos centraremos en las bases de datos documentales, específicamente en MongoDB. Exploraremos sus características principales, el modelo de almacenamiento basado en documentos y las operaciones básicas de manejo de datos (CRUD). Además, hablaremos brevemente sobre conceptos como el escalamiento horizontal y vertical. ¡Acompáñanos a descubrir cómo MongoDB facilita la gestión de datos en el mundo digital!.
TipoDB
Las bases de datos NoSQL se clasifican según su modelo de datos. Las principales categorías son:
1. Base de Datos Documentales
Almacenan datos en formato de documentos (generalmente JSON o BSON). Son flexibles y escalables.
MongoDB
- Características:
- Orientada a documentos.
- Alta disponibilidad mediante réplicas.
- Escalabilidad horizontal con sharding.
- Uso común: Aplicaciones web modernas, análisis de datos.
Cloud Firestore
- Características:
- Propiedad de Google Cloud.
- Basada en documentos jerárquicos.
- Integración nativa con Firebase.
- Uso común: Desarrollo móvil y web en tiempo real.
2. Grafos
Almacenan datos en nodos y relaciones entre ellos. Son ideales para consultas complejas y redes.
Neo4j
- Características:
- Modelo basado en grafos.
- Consultas eficientes con Cypher Query Language.
- Ideal para redes sociales, recomendaciones y fraudes.
- Uso común: Análisis de redes, sistemas de recomendación.
3. Clave-Valor
Almacenan datos como pares clave-valor. Son simples y extremadamente rápidas.
Redis
- Características:
- Almacenamiento en memoria (in-memory).
- Soporta estructuras de datos como listas, conjuntos y hashes.
- Persistencia opcional.
- Uso común: Caching, colas de mensajes, sesiones de usuario.
4. Columnas
Almacenan datos en columnas en lugar de filas. Son eficientes para grandes volúmenes de datos.
Cassandra
- Características:
- Sin punto único de fallo.
- Escalabilidad horizontal.
- Modelo de consistencia ajustable.
- Uso común: IoT, análisis de datos masivos.
HBase
- Características:
- Construida sobre Hadoop.
- Alta disponibilidad y tolerancia a fallos.
- Ideal para big data.
- Uso común: Procesamiento de grandes volúmenes de datos.
Escalamiento
Vertical
- Descripción: Aumentar la capacidad de un solo servidor (CPU, RAM, almacenamiento).
- Ventajas: Fácil de implementar.
- Desventajas: Limitado por el hardware disponible.
Horizontal
- Descripción: Agregar más servidores para distribuir la carga.
- Ventajas: Altamente escalable.
- Desventajas: Mayor complejidad en la gestión.
Base de Datos Documentales
Estructura
- Base de datos: Contenedor principal de datos.
- Colecciones: Grupos de documentos relacionados.
- Documentos: Unidades individuales de datos (JSON/BSON).
Implementación
- On-premises: Instalación local.
- Mongo Compass: Interfaz gráfica para MongoDB.
- Cluster: Conjunto de servidores MongoDB trabajando juntos.
Tipos de Datos
- JSON: Formato ligero para intercambio de datos.
- BSON: Extensión binaria de JSON usada internamente por MongoDB.
CRUD (Create, Read, Update, Delete)
| Operación | Descripción | Ejemplo |
|---|---|---|
insertOne |
Inserta un solo documento. | db.collection.insertOne({ name: "Alice" }) |
insertMany |
Inserta múltiples documentos. | db.collection.insertMany([{ name: "Bob" }, { name: "Charlie" }]) |
updateOne |
Actualiza un solo documento. | db.collection.updateOne({ name: "Alice" }, { $set: { age: 25 } }) |
updateMany |
Actualiza múltiples documentos. | db.collection.updateMany({}, { $inc: { age: 1 } }) |
deleteOne |
Elimina un solo documento. | db.collection.deleteOne({ name: "Alice" }) |
deleteMany |
Elimina múltiples documentos. | db.collection.deleteMany({ age: { $gt: 30 } }) |
drop |
Elimina una colección completa. | db.collection.drop() |
find |
Busca documentos que coincidan con un filtro. | db.collection.find({ age: { $gt: 20 } }) |
aggregate |
Realiza operaciones avanzadas como agrupaciones. | db.collection.aggregate([{ $group: { _id: "$age", count: { $sum: 1 } } }]) |
sort, limit, skip |
Ordena, limita y omite documentos en una consulta. | db.collection.find().sort({ age: 1 }).limit(10).skip(5) |
Operadores
| Operador | Descripción | Ejemplo |
|---|---|---|
$set |
Establece el valor de un campo. | db.collection.updateOne({ name: "Alice" }, { $set: { age: 25 } }) |
$inc |
Incrementa el valor de un campo numérico. | db.collection.updateOne({ name: "Alice" }, { $inc: { age: 1 } }) |
$rename |
Cambia el nombre de un campo. | db.collection.updateOne({}, { $rename: { oldField: "newField" } }) |
$unset |
Elimina un campo. | db.collection.updateOne({}, { $unset: { age: "" } }) |
$push |
Agrega un elemento a un array. | db.collection.updateOne({}, { $push: { hobbies: "reading" } }) |
$pull |
Elimina un elemento de un array. | db.collection.updateOne({}, { $pull: { hobbies: "reading" } }) |
$in |
Coincide si el campo tiene uno de los valores especificados. | db.collection.find({ age: { $in: [20, 25, 30] } }) |
$nin |
Coincide si el campo no tiene ninguno de los valores especificados. | db.collection.find({ age: { $nin: [20, 25, 30] } }) |
$all |
Coincide si el array contiene todos los valores especificados. | db.collection.find({ hobbies: { $all: ["reading", "writing"] } }) |
$size |
Coincide si el array tiene un tamaño específico. | db.collection.find({ hobbies: { $size: 3 } }) |
$elemMatch |
Coincide si al menos un elemento del array cumple todas las condiciones. | db.collection.find({ scores: { $elemMatch: { $gt: 80, $lt: 90 } } }) |
$regex |
Coincide con patrones de texto. | db.collection.find({ name: { $regex: "^A" } }) |
$eq y $ne |
Igualdad y desigualdad. | db.collection.find({ age: { $eq: 25 } }) |
$gt, $gte |
Mayor que y mayor o igual que. | db.collection.find({ age: { $gt: 20 } }) |
Operadores Lógicos
| Operador | Descripción | Ejemplo |
|---|---|---|
$and |
Coincide si todas las condiciones son verdaderas. | db.collection.find({ $and: [{ age: { $gt: 20 } }, { age: { $lt: 30 } }] }) |
$or |
Coincide si al menos una condición es verdadera. | db.collection.find({ $or: [{ age: { $gt: 20 } }, { name: "Alice" }] }) |
$not |
Niega una expresión. | db.collection.find({ age: { $not: { $gt: 20 } } }) |
$nor |
Coincide si ninguna de las condiciones es verdadera. | db.collection.find({ $nor: [{ age: { $gt: 20 } }, { name: "Alice" }] }) |
Aggregation Framework
Permite realizar transformaciones y análisis complejos en los datos.
Ejemplo de Pipeline
db.collection.aggregate([
  { $match: { age: { $gt: 20 } } }, // Filtra documentos
  { $group: { _id: "$city", total: { $sum: 1 } } }, // Agrupa por ciudad
  { $sort: { total: -1 } } // Ordena por total descendente
]);
📝 Conclusión
Las bases de datos NoSQL representan una evolución en la gestión de datos que responde a las necesidades actuales de escalabilidad y flexibilidad. Comprender su arquitectura, funcionamiento y aplicaciones prácticas es fundamental para cualquier profesional del ámbito tecnológico.
Si deseas profundizar aún más, explora casos de uso específicos y realiza experimentos prácticos con plataformas como MongoDB, Redis o Neo4j. La adopción y el dominio de estas tecnologías pueden marcar la diferencia en proyectos que manejan grandes volúmenes de datos o requieren consultas complejas en tiempo real. ¡Atrévete a sumergirte en el fascinante mundo NoSQL y lleva tus habilidades de manejo de datos al siguiente nivel!
Transformando Colecciones con Java Streams: 15 Métodos Esenciales
- Mauricio ECR
- Arquitectura
- 29 Mar, 2025
Introducción En el mundo de Java, trabajar con colecciones de datos solía ser sinónimo de bucles interminables, condicionales anidados y código repetitivo. Pero con la llegada de Java Streams
Transformando Colecciones con Java Streams: 15 Métodos Esenciales
- Mauricio ECR
- Arquitectura
- 29 Mar, 2025
Introducción
En el mundo de Java, trabajar con colecciones de datos solía ser sinónimo de bucles interminables, condicionales anidados y código repetitivo. Pero con la llegada de Java Streams (desde Java 8), todo cambió. Los Streams introdujeron un paradigma funcional y declarativo que permite manipular datos de manera eficiente, legible y elegante.
¿Imaginas poder filtrar, transformar, agrupar o reducir elementos con solo unas líneas de código? Los métodos de los Streams hacen esto posible, convirtiendo operaciones complejas en secuencias intuitivas. Pero para aprovecharlos al máximo, es clave conocer sus herramientas principales.
Aquí te presentamos un listado detallado de los métodos más poderosos de los Streams, divididos en dos categorías: métodos generales y métodos de agrupación. Descubre cómo dominarlos puede simplificar tu código, potenciar tu productividad y desbloquear nuevas posibilidades en el manejo de datos.
Listado de Métodos de Java Streams
Métodos Generales
- filter(Predicate<? super T> predicate)
Filtra los elementos que cumplen con una condición.List<Integer> numeros = Arrays.asList(5, 12, 3, 20); List<Integer> mayoresA10 = numeros.stream() .filter(x -> x > 10) .collect(Collectors.toList()); // Resultado: [12, 20] - map(Function<? super T, ? extends R> mapper)
Transforma cada elemento aplicando una función.List<String> palabras = Arrays.asList("java", "streams"); List<Integer> longitudes = palabras.stream() .map(String::length) .collect(Collectors.toList()); // Resultado: [4, 7] - flatMap(Function<? super T, ? extends Stream<? extends R>> mapper)
Aplana múltiples Streams en uno solo (útil para listas anidadas).List<List<Integer>> listaAnidada = Arrays.asList( Arrays.asList(1, 2), Arrays.asList(3, 4) ); List<Integer> listaPlana = listaAnidada.stream() .flatMap(List::stream) .collect(Collectors.toList()); // Resultado: [1, 2, 3, 4] - reduce(BinaryOperator
accumulator)
Reduce los elementos a un único valor mediante una operación (ej: suma).List<Integer> numeros = Arrays.asList(1, 2, 3, 4); Optional<Integer> suma = numeros.stream() .reduce((a, b) -> a + b); // Resultado: 10 - collect(Collector<? super T, A, R> collector)
Transforma el Stream en una colección o estructura de datos.List<String> palabras = Arrays.asList("a", "b", "c"); Set<String> set = palabras.stream() .collect(Collectors.toSet()); // Resultado: [a, b, c] (como Set) - forEach(Consumer<? super T> action)
Ejecuta una acción en cada elemento (como imprimirlo).List<String> frutas = Arrays.asList("Manzana", "Pera"); frutas.stream() .forEach(fruta -> System.out.print(fruta + " ")); // Resultado: "Manzana Pera " - sorted()
Ordena los elementos (requiere que sean comparables).List<Integer> numeros = Arrays.asList(3, 1, 4, 2); List<Integer> ordenados = numeros.stream() .sorted() .collect(Collectors.toList()); // Resultado: [1, 2, 3, 4] - distinct()
Elimina duplicados, retornando elementos únicos.List<Integer> numeros = Arrays.asList(2, 2, 5, 5); List<Integer> unicos = numeros.stream() .distinct() .collect(Collectors.toList()); // Resultado: [2, 5] - limit(long maxSize)
Limita el Stream a un número máximo de elementos.List<Integer> numeros = Arrays.asList(1, 2, 3, 4, 5); List<Integer> primeros3 = numeros.stream() .limit(3) .collect(Collectors.toList()); // Resultado: [1, 2, 3] - skip(long n)
Omite los primeros n elementos del Stream.List<Integer> numeros = Arrays.asList(1, 2, 3, 4, 5); List<Integer> sinPrimeros2 = numeros.stream() .skip(2) .collect(Collectors.toList()); // Resultado: [3, 4, 5]
Métodos para Agrupar Elementos
- Collectors.groupingBy(Function<? super T, ? extends K> classifier)
Agrupa elementos por una clave (ej: edad de una persona).List<Persona> personas = Arrays.asList( new Persona("Ana", 25), new Persona("Luis", 25) ); Map<Integer, List<Persona>> porEdad = personas.stream() .collect(Collectors.groupingBy(Persona::getEdad)); // Resultado: {25=[Ana, Luis]} - Collectors.partitioningBy(Predicate<? super T> predicate)
Divide el Stream en dos grupos: los que cumplen y no cumplen un predicado.// Agrupar por categoría + stock mayor a 5 Map<String, List<Producto>> porCategoriaYStock = productos.stream() .collect(Collectors.groupingBy(p -> p.getCategoria() + "-" + (p.getStock() > 5 ? "AltoStock" : "BajoStock") )); /* Resultado: { "Electrónica-AltoStock": [Laptop, Smartphone], "Ropa-AltoStock": [Camisa] } */ - Collectors.groupingBy(classifier, downstream)
Agrupa y luego aplica un segundo colector a cada grupo (ej: contar elementos).// Precio promedio por categoría Map<String, Double> precioPromedio = productos.stream() .collect(Collectors.groupingBy( Producto::getCategoria, Collectors.averagingDouble(Producto::getPrecio) )); /* Resultado: { "Electrónica": 1000.0, "Ropa": 40.0 } */ - Collectors.groupingBy(classifier, mapFactory, downstream)
Agrupa usando un tipo de mapa específico (ej: TreeMap).// Agrupar por rangos de precios Map<String, List<Producto>> porRangoPrecio = productos.stream() .collect(Collectors.groupingBy(p -> { if (p.getPrecio() < 100) return "Económico"; else if (p.getPrecio() < 1000) return "Medio"; else return "Premium"; })); /* Resultado: { "Premium": [Laptop], "Medio": [Smartphone], "Económico": [Camisa] } */ - Agrupar con downstream complejo (ej: contar y sumar stock)
// Por categoría: cantidad de productos y stock total
Map<String, Map<String, Object>> estadisticas = productos.stream()
    .collect(Collectors.groupingBy(
        Producto::getCategoria,
        Collectors.collectingAndThen(
            Collectors.toList(),
            lista -> {
                int cantidad = lista.size();
                int stockTotal = lista.stream().mapToInt(Producto::getStock).sum();
                return Map.of("Cantidad", cantidad, "Stock Total", stockTotal);
            }
        )
    ));
/*
Resultado:
{
  "Electrónica": {"Cantidad": 2, "Stock Total": 15},
  "Ropa": {"Cantidad": 1, "Stock Total": 20}
}
*/
Conclusión
Dominar los métodos de Java Streams no solo simplifica tu código, sino que también mejora su legibilidad y eficiencia. Al explorar y aplicar estos métodos, descubrirás nuevas formas de manipular colecciones de datos que pueden transformar tu enfoque en el desarrollo de software. ¡Sigue profundizando y experimentando con Java Streams para desbloquear todo su potencial!
¿SQL o NoSQL? Descubre la Base de Datos Ideal para tu Proyecto
- Mauricio ECR
- Persistencia
- 29 Mar, 2025
Introducción Elegir la base de datos adecuada para un proyecto es una decisión crítica que afecta la escalabilidad, el rendimiento y la facilidad de mantenimiento de una aplicación. ¿Necesitas una

¿SQL o NoSQL? Descubre la Base de Datos Ideal para tu Proyecto
- Mauricio ECR
- Persistencia
- 29 Mar, 2025
Introducción
Elegir la base de datos adecuada para un proyecto es una decisión crítica que afecta la escalabilidad, el rendimiento y la facilidad de mantenimiento de una aplicación. ¿Necesitas una base de datos relacional o una documental? Este cuestionario te ayudará a tomar la mejor decisión basada en los requisitos específicos de tu proyecto. Responde las siguientes preguntas y obtén una recomendación basada en tus necesidades técnicas y operativas.
Contexto del Proyecto
Antes de responder, defina:
- Caso de uso principal: Ej: sistema transaccional, catálogo de productos, IoT, contenido generado por usuarios.
- Velocidad de crecimiento de datos: Estimación anual (GB/TB).
- Ratio lecturas/escrituras: Ej: 80/20, 50/50.
1. Modelado de Datos
¿Los datos tienen una estructura fija y predefinida que se mantiene estable (>80% de los casos)?
- Ej: tablas de clientes con campos obligatorios vs. posts de redes sociales con metadatos variables.
¿Es crítico modelar relaciones muchos-a-muchos entre entidades principales?
- Ej: estudiantes-cursos vs. tags en un blog.
¿La normalización para evitar redundancia es prioritaria sobre la velocidad de lectura?
¿El esquema cambia menos de 2 veces/año?
¿Los registros comparten >90% de atributos comunes?
¿Los datos son principalmente planos o con anidamiento simple (≤2 niveles)?
- Ej: dirección
{calle, ciudad}vs. JSON con subdocumentos jerárquicos.
- Ej: dirección
¿La integridad referencial (FKs) es no negociable para el negocio?
¿Los datos son >70% valores escalares (números, textos cortos) vs. documentos/blobs?
¿Se pueden representar sin pérdida en tablas 2D?
- Ej: evita estructuras como arrays o árboles.
¿Prefiere almacenar documentos completos (JSON/XML) en lugar de desnormalizar?
¿Necesita consultar fragmentos específicos dentro de documentos anidados frecuentemente?
¿Los atributos varían significativamente entre registros de la misma entidad?
- Ej: productos con especificaciones técnicas heterogéneas.
2. Operaciones y Consultas
¿Las consultas frecuentes (≥30%) requieren JOINs entre ≥3 tablas?
¿Las búsquedas acceden a campos estructurados individuales (no documentos completos)?
¿Son esenciales transacciones ACID que abarcan múltiples operaciones/entidades?
- Nota: Algunas bases documentales (MongoDB 4.0+) soportan transacciones multi-documento.
¿Las consultas usan principalmente claves primarias/índices simples (no consultas ad-hoc)?
¿Se filtran datos usando ≥3 atributos simultáneamente en >50% de las consultas?
¿Prefiere consultar datos anidados directamente en lugar de desnormalizar?
¿Las escrituras implican actualizaciones parciales complejas (no reemplazos completos)?
¿Requiere agregaciones multidimensionales (OLAP) sobre >1TB de datos?
¿Las consultas acceden a ≥3 entidades relacionadas en >40% de los casos?
¿Es crítico tener un esquema fijo para validar datos en ingesta?
¿Usa consultas geoespaciales o de grafos con frecuencia?
- Nota: Ambos modelos pueden soportarlo, pero con implementaciones distintas.
¿Necesita índices compuestos sobre múltiples campos anidados?
3. Requerimientos No-Funcionales
¿El volumen total estimado en 3 años es <50TB?
- Nota: Bases relacionales distribuidas (CockroachDB) pueden manejar petabytes.
¿La alta disponibilidad requiere consistencia fuerte (no eventual)?
¿El ratio lecturas/escrituras es >70/30?
¿Puede tolerar latencias >15ms en operaciones críticas?
¿El equipo tiene ≥2 años de experiencia con SQL?
¿Es esencial compatibilidad con herramientas BI tradicionales (Power BI, Tableau)?
¿Requiere replicación transaccional cross-region?
¿Necesita escalado horizontal automático (sharding) sin downtime?
- Nota: Algunas RDBMS (Vitess) permiten sharding con límites.
¿La carga incluye >50K operaciones/segundo sostenidas?
¿Los backups deben ser incrementales con recuperación a momento específico?
¿Puede aceptar bloqueos por migraciones de esquema (>1 min de downtime)?
5 Preguntas Críticas Decisivas
¿Es no negociable la integridad referencial entre entidades?
- Sí → Relacional (a menos que use extensiones como PostgreSQL + FOREIGN KEY en JSONB).
¿Los datos son >60% documentos anidados con estructura irregular?
- Sí → Documental (pero considere híbridos como MySQL + MongoDB).
¿Requiere JOINs complejos (>3 tablas) en >25% de las consultas?
- Sí → Relacional (aunque algunas documentales tienen
$lookupsimilar a JOINs).
- Sí → Relacional (aunque algunas documentales tienen
¿Necesita escalar horizontalmente sin límites prácticos?
- Sí → Documental (pero evalúe NewSQL como YugabyteDB).
¿Requiere transacciones ACID multi-operación en >30% de los casos?
- Sí → Relacional (pero verifique si su documental soporta transacciones).
Regla decisiva
Si ≥3 respuestas clave apuntan a una categoría, priorícela. En empates (2-2), evalúe el contexto del proyecto.
Interpretación de Puntajes
| Puntos Totales | Recomendación | Tecnologías Ejemplo |
|---|---|---|
| 28-35 | Relacional Puro | PostgreSQL, MySQL, SQL Server |
| 20-27 | Relacional + Extensiones | PostgreSQL (JSONB), SQL Server (XML), Oracle (JSON) |
| 15-19 | Híbrido o Multi-Modelo | MongoDB (transacciones), Cosmos DB (modo SQL), CockroachDB |
| 8-14 | Documental Puro | MongoDB, Couchbase, Firebase Firestore |
Conclusión
Este cuestionario te ofrece un marco estructurado para evaluar qué tipo de base de datos es más adecuada para tu proyecto. Si la mayoría de tus respuestas favorecen la integridad referencial, los JOINs y la validación de esquema, una base relacional es la mejor opción. Si en cambio tu proyecto requiere flexibilidad en la estructura de datos, escalabilidad horizontal y almacenamiento de documentos, una base documental puede ser la respuesta. En casos híbridos, considera soluciones como PostgreSQL con JSONB o bases multimodelo como CosmosDB. ¡Elige sabiamente para optimizar el rendimiento y la escalabilidad de tu aplicación!
Desarrollo de Software Implementando Gitflow
- Mauricio ECR
- DevOps
- 19 Mar, 2025
Introducción El desarrollo de software requiere metodologías y flujos de trabajo que permitan un control eficiente del código fuente. Uno de los enfoques más utilizados para la gestión de versiones
Desarrollo de Software Implementando Gitflow
- Mauricio ECR
- DevOps
- 19 Mar, 2025
Introducción
El desarrollo de software requiere metodologías y flujos de trabajo que permitan un control eficiente del código fuente. Uno de los enfoques más utilizados para la gestión de versiones es Gitflow, una estrategia basada en Git que organiza el trabajo en ramas bien definidas.
Este artículo explora qué es Gitflow, su filosofía, los problemas que resuelve y cómo implementarlo paso a paso en un proyecto. También se comparará el uso de Gitflow con los comandos básicos de Git para quienes prefieran un enfoque manual.
¿Qué es Gitflow?
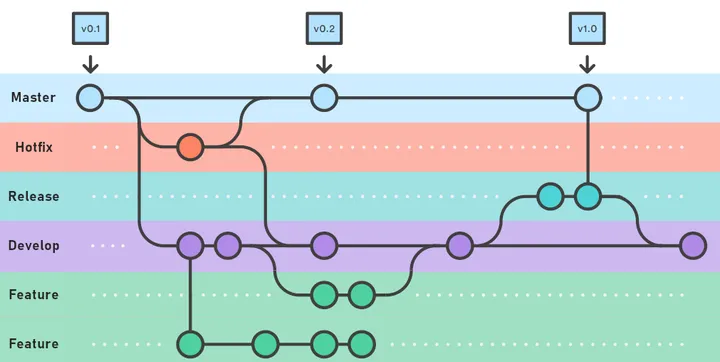
Gitflow es un modelo de ramificación para Git propuesto por Vincent Driessen. Define un conjunto de reglas y procedimientos para gestionar las diferentes etapas del desarrollo de software, asegurando estabilidad en la rama principal mientras se permite la integración de nuevas funcionalidades de manera organizada.
Filosofía de Gitflow
Gitflow se basa en la idea de separar el desarrollo en ramas específicas con propósitos bien definidos:
Explicación de cada rama en Gitflow
- main: Contiene la versión estable y en producción del software. Solo se realizan fusiones de versiones terminadas y correcciones críticas.
- develop: Es la rama principal de desarrollo donde se integran nuevas funcionalidades antes de ser lanzadas.
- feature: Se crean a partir de
developpara el desarrollo de nuevas características. Una vez terminadas, se fusionan de nuevo endevelop. - release: Se crean a partir de
developcuando se prepara una nueva versión. Aquí se realizan pruebas finales antes de integrarla enmain. - hotfix: Se crean a partir de
mainpara corregir errores críticos en producción y luego se fusionan enmainydevelop. - bugfix: Similar a
hotfix, pero se crean a partir dedeveloppara corregir errores antes de un lanzamiento.
¿Qué busca solucionar?
Gitflow aborda varios problemas comunes en el desarrollo de software, como:
- Integración desorganizada de nuevas características.
- Problemas al manejar versiones de lanzamiento.
- Falta de control sobre la corrección de errores en producción.
¿Cómo propone solucionarlo?
Gitflow impone un flujo de trabajo con reglas claras para la creación, fusión y eliminación de ramas, asegurando estabilidad y organización en el repositorio.
Implementación de Gitflow paso a paso
A continuación, se detalla cómo implementar Gitflow en un proyecto, tanto utilizando la herramienta git-flow como con comandos básicos de Git.
1. Inicializar un repositorio con Gitflow
Usando la herramienta git-flow:
git flow init
Manualmente con Git:
git init
git branch -M main
git checkout -b develop
2. Crear una nueva funcionalidad (feature)
Con git-flow:
git flow feature start nueva-funcionalidad
Con Git básico:
git checkout -b feature/nueva-funcionalidad develop
3. Finalizar una funcionalidad
Con git-flow:
git flow feature finish nueva-funcionalidad
Con Git:
git checkout develop
git merge --no-ff feature/nueva-funcionalidad
git branch -d feature/nueva-funcionalidad
4. Preparar una versión de lanzamiento
Con git-flow:
git flow release start v1.0.0
Con Git:
git checkout -b release/v1.0.0 develop
5. Finalizar una versión de lanzamiento
Con git-flow:
git flow release finish v1.0.0
Con Git:
git checkout main
git merge --no-ff release/v1.0.0
git tag -a v1.0.0 -m "Versión 1.0.0"
git checkout develop
git merge main
git branch -d release/v1.0.0
6. Aplicar una corrección en producción (hotfix)
Con git-flow:
git flow hotfix start fix-critico
Con Git:
git checkout -b hotfix/fix-critico main
Para finalizar el hotfix: Con git-flow:
git flow hotfix finish fix-critico
Con Git:
git checkout main
git merge --no-ff hotfix/fix-critico
git tag -a v1.0.1 -m "Corrección crítica"
git checkout develop
git merge main
git branch -d hotfix/fix-critico
Ventajas del uso de Gitflow
- Estructura clara: Organización de ramas para cada propósito.
- Mayor estabilidad: La rama principal se mantiene siempre en estado funcional.
- Mejor colaboración: Facilita la integración de cambios en equipos grandes.
- Gestión eficiente de versiones: Simplifica la publicación de nuevas versiones y correcciones de errores.
Conclusión
Gitflow es un modelo altamente eficiente para la gestión de versiones en proyectos de software. Aunque la herramienta git-flow automatiza muchos pasos, comprender los comandos básicos de Git permite un control más detallado del flujo de trabajo. Su implementación mejora la organización, facilita el trabajo en equipo y contribuye a la estabilidad del código en producción.
Estructuración de Carpetas en Proyectos de Software
- Mauricio ECR
- Convenciones
- 18 Mar, 2025
En proyectos de software de gran escala, la falta de una estructura de carpetas bien definida puede generar desorden, dificultando la mantenibilidad, escalabilidad y comprensión del código. Muchas vec

Estructuración de Carpetas en Proyectos de Software
- Mauricio ECR
- Convenciones
- 18 Mar, 2025
En proyectos de software de gran escala, la falta de una estructura de carpetas bien definida puede generar desorden, dificultando la mantenibilidad, escalabilidad y comprensión del código. Muchas veces, los proyectos crecen de manera descontrolada sin una estructura definida, lo que lleva a código difícil de navegar, dependencias circulares entre módulos, acoplamiento innecesario entre componentes y dificultad para incorporar nuevos desarrolladores al equipo.
Para estructurar un proyecto de software de manera eficiente, es recomendable seguir una organización de carpetas que refleje claramente la separación de responsabilidades. Esto ayuda a mantener un código modular, organizado y fácil de mantener.
Los principios clave para la organización de carpetas incluyen modularidad, donde cada módulo representa una unidad de negocio independiente; independencia, separando la lógica de negocio de la infraestructura y los adaptadores; cohesión, manteniendo agrupados los elementos relacionados dentro de un módulo; y evolución, permitiendo la escalabilidad sin afectar la estructura global.
Una estructura de carpetas recomendada puede verse de la siguiente manera:
/project-root
 ├── src
 │   ├── core  # Reglas de negocio y modelos
 │   │   ├── domain
 │   │   │   ├── entities
 │   │   │   ├── value_objects
 │   │   │   ├── repositories
 │   │   │   ├── services
 │   │   │   └── events
 │   │   ├── application
 │   │   │   ├── use_cases
 │   │   │   ├── dtos
 │   │   │   ├── mappers
 │   │   │   └── queries
 │   ├── modules  # Módulos específicos del negocio
 │   │   ├── user_management
 │   │   │   ├── domain
 │   │   │   ├── application
 │   │   │   ├── infrastructure
 │   │   │   ├── adapters
 │   ├── infrastructure  # Implementaciones técnicas y frameworks
 │   │   ├── persistence
 │   │   ├── messaging
 │   │   ├── external_services
 │   │   ├── config
 │   ├── adapters  # Interfaces externas y controladores
 │   │   ├── api
 │   │   ├── cli
 │   │   ├── event_consumers
 │   │   └── schedulers
 ├── tests  # Pruebas unitarias y de integración
 ├── docs  # Documentación del proyecto
 ├── scripts  # Herramientas para automatización
 ├── config  # Configuración general del proyecto
 ├── .gitignore
 ├── README.md
Dentro de esta estructura, 'core/' contiene la lógica de negocio (entidades, servicios, repositorios, etc.); 'modules/' agrupa los módulos del dominio de manera aislada; 'infrastructure/' contiene implementaciones técnicas como bases de datos, servicios externos y configuraciones; 'adapters/' define las interfaces de comunicación con el mundo exterior, incluyendo APIs, CLI y eventos; 'tests/' contiene pruebas unitarias e integración; 'docs/' almacena documentación técnica del proyecto; 'config/' centraliza archivos de configuración; y 'scripts/' incluye herramientas de automatización.
Por ejemplo, en un sistema de gestión de usuarios con autenticación, podríamos estructurar el módulo correspondiente de la siguiente manera:
/modules/user_management
 ├── domain
 │   ├── entities
 │   │   ├── UserEnt.ts
 │   ├── value_objects
 │   │   ├── EmailVO.ts
 │   ├── repositories
 │   │   ├── UserRepo.ts
 ├── application
 │   ├── use_cases
 │   │   ├── RegisterUserUC.ts
 │   │   ├── AuthenticateUserUC.ts
 │   ├── dtos
 │   │   ├── UserDTO.ts
 │   ├── mappers
 │   │   ├── UserMap.ts
 ├── infrastructure
 │   ├── persistence
 │   │   ├── UserRepoImpl.ts
 ├── adapters
 │   ├── api
 │   │   ├── UserCtrl.ts
Aquí, la capa de dominio maneja las reglas de negocio, la capa de aplicación contiene los casos de uso, la infraestructura gestiona la persistencia y los adaptadores exponen las funcionalidades a través de controladores API.
Resumen de Carpetas y su Uso
| Carpeta | Descripción | Ejemplo en 'user_management' |
|---|---|---|
| 'core/domain' | Contiene entidades, objetos de valor, repositorios y servicios | 'UserEnt.ts' define la entidad de usuario |
| 'core/application' | Define casos de uso, DTOs, mappers y queries | 'RegisterUserUC.ts' implementa la lógica de registro de usuario |
| 'modules' | Agrupa módulos específicos del negocio | 'user_management/' encapsula toda la gestión de usuarios |
| 'domain/entities' | Modelos de negocio que representan objetos persistentes | 'UserEnt.ts' representa los datos del usuario en la base de datos |
| 'domain/value_objects' | Objetos de valor inmutables del dominio | 'EmailVO.ts' maneja la lógica del correo electrónico |
| 'domain/repositories' | Interfaces para acceso a datos | 'UserRepo.ts' define la interfaz para obtener usuarios |
| 'application/use_cases' | Casos de uso que orquestan la lógica de negocio | 'RegisterUserUC.ts' contiene la lógica de registro de usuario |
| 'application/dtos' | Transporte de datos entre capas | 'UserDTO.ts' define el formato de los datos de usuario |
| 'application/mappers' | Conversión entre entidades y DTOs | 'UserMap.ts' convierte entre 'UserEnt' y 'UserDTO' |
| 'infrastructure/persistence' | Implementación de acceso a datos | 'UserRepoImpl.ts' implementa 'UserRepo.ts' |
| 'adapters/api' | Exposición de funcionalidades vía API | 'UserCtrl.ts' maneja solicitudes HTTP |
| 'tests' | Contiene pruebas unitarias y de integración | 'UserSvcTest.ts' prueba 'RegisterUserUC.ts' |
| 'docs' | Documentación técnica del proyecto | Documentación sobre el flujo de autenticación |
| 'config' | Configuración general de la aplicación | Configuración de base de datos y variables de entorno |
| 'scripts' | Scripts de automatización | Scripts para migraciones o configuración |
Implementar una estructura de carpetas bien organizada ayuda a crear proyectos más mantenibles, escalables y fáciles de entender. Al separar claramente las responsabilidades, evitamos el acoplamiento innecesario y mejoramos la colaboración dentro del equipo de desarrollo. Desde el inicio del proyecto, es recomendable definir y documentar la estructura de carpetas para que todo el equipo la adopte y mantenga. Con esta estructura clara y modular, los proyectos de software pueden escalar sin comprometer la calidad del código. 🚀