Tags (73)
- Agile
- Alta disponibilidad
- Alternativas cloud
- Aop
- Arquitectura
- Arquitectura distribuida
- Automatizacion
- Aws
- Azure devops
- Base de datos
- Buenas practicas
- Cloud
- Colas
- Competing consumers
- Convenciones
- Copilot
- Diseno
- Docker
- Docker compose
- Documentacion
- Eda
- Equipos
- Escalabilidad
- Flujo de negocio
- Flujo de trabajo
- Flyway
- Git
- Gradle
- Herramientas digitales
- Ia
- Iam
- Infraestructura
- Java
- Jerarquia tecnica
- Jpa
- Jsonb
- Kafka
- Kubernetes
- Liderazgo en software
- Lineamientos
- Log
- Logging
- Microservicios
- Mongodb
- Monitoreo
- Nosql
- Observabilidad
- Open source
- Plugins
- Postgresql
- Privacidad
- Programacion funcional
- Programacion reactiva
- Rabbitmq
- Rotacion de talento
- Saga
- Scrum
- Security
- Seguridad
- Self hosting
- Sistemas legados
- Snippets
- Spring boot
- Spring mvc
- Sql
- Streams
- Threadlocal
- Trazabilidad
- Versionado
- Web
- Webflux
- Websockets
- Zero trust
RabbitMQ 6: Alta Disponibilidad y Escalabilidad con Clustering en RabbitMQ
- Mauricio ECR
- Arquitectura
- 01 May, 2025
Hasta ahora, hemos hablado de cómo un nodo individual de RabbitMQ maneja mensajes, gestiona colas, y cómo monitorizar su rendimiento y seguridad. Sin embargo, para aplicaciones críticas que no pueden

RabbitMQ 6: Alta Disponibilidad y Escalabilidad con Clustering en RabbitMQ
- Mauricio ECR
- Arquitectura
- 01 May, 2025
Hasta ahora, hemos hablado de cómo un nodo individual de RabbitMQ maneja mensajes, gestiona colas, y cómo monitorizar su rendimiento y seguridad. Sin embargo, para aplicaciones críticas que no pueden permitirse tiempo de inactividad y necesitan procesar volúmenes de mensajes que superan la capacidad de un solo servidor, un solo nodo de RabbitMQ representa un punto único de fallo y un límite de escalabilidad inherente.
Aquí es donde entra en juego el clustering. Agrupar varios nodos de RabbitMQ para que trabajen juntos nos permite lograr alta disponibilidad (HA) y escalabilidad horizontal. Este artículo se sumergirá en el concepto de clustering, las arquitecturas comunes para HA de mensajes (Mirroring Clásico y Quorum Queues), cómo escalar añadiendo más nodos y algunas consideraciones avanzadas cruciales para la gestión de despliegues distribuidos y de misión crítica.
Concepto de Clustering en RabbitMQ
Para entender el clustering, primero debemos definir qué es un nodo en el contexto de RabbitMQ. Un nodo de RabbitMQ es, simplemente, una instancia individual del broker RabbitMQ ejecutándose en un servidor (físico o virtual). Es la unidad básica que inicia el servicio, maneja conexiones, gestiona recursos y procesa mensajes. Un despliegue de RabbitMQ con un solo servidor es un "clúster" de un solo nodo.
Un clúster de RabbitMQ es, por lo tanto, un grupo de dos o más nodos de RabbitMQ interconectados. Estos nodos trabajan conjuntamente y se comunican entre sí para compartir información vital sobre el estado y la topología del broker. Esta información compartida, conocida como metadatos, incluye detalles sobre usuarios, virtual hosts (vhosts), exchanges, colas, bindings y parámetros de configuración como políticas. Al compartir estos metadatos, el clúster presenta una vista unificada y consistente de la topología del sistema de mensajería a todas las aplicaciones cliente conectadas, sin importar a qué nodo específico se conecten inicialmente.
Sin embargo, y este es un punto crucial para entender la alta disponibilidad de los mensajes, aunque los metadatos de la configuración se replican automáticamente en todos los nodos del clúster, por defecto y en las arquitecturas clásicas (anteriores a Quorum Queues), los mensajes en sí mismos residían únicamente en el nodo donde la cola fue declarada o donde se estableció su nodo "master". Esto significaba que si ese nodo específico fallaba, los mensajes en esa cola se volvían inaccesibles o incluso se perdían si la cola no era persistente. Esta limitación convertía a un nodo individual en un punto único de fallo (Single Point Of Failure - SPOF) para los mensajes que gestionaba. Para superar esta restricción fundamental y asegurar que los mensajes permanecieran disponibles y duraderos incluso ante la caída de un nodo, se hizo necesario desarrollar mecanismos específicos dentro del framework de clustering orientados a la alta disponibilidad de los datos de los mensajes, dando origen a soluciones como el mirroring de colas y, más recientemente y de forma más robusta, las quorum queues.
Arquitecturas para Alta Disponibilidad de Mensajes: Asegurando la Resiliencia de Tus Datos
Como mencionamos, mientras que los metadatos del clúster se replican en todos los nodos, la alta disponibilidad de los mensajes mismos no es inherente al simple hecho de tener un clúster. Los mensajes residen físicamente en un nodo específico. Para asegurar que tus mensajes sobrevivan a la caída de un nodo y permanezcan accesibles, RabbitMQ ha desarrollado arquitecturas de réplica de datos. Históricamente, esto se abordó con el Mirroring de Colas Clásicas, y la solución moderna y recomendada son las Quorum Queues.
1. Mirroring de Colas (Classic Mirrored Queues): El Enfoque Tradicional
- Concepto: El mirroring fue la primera solución de RabbitMQ para lograr la alta disponibilidad de los mensajes en colas clásicas. Su propósito es replicar activamente el flujo de mensajes de una cola desde un nodo "maestro" designado para esa cola a uno o más nodos "espejo" dentro del mismo clúster. La idea es que, si el nodo maestro original falla, uno de los nodos espejo promocione a maestro, permitiendo que productores y consumidores continúen operando con la cola sin perder mensajes.
- Mecanismo: Cuando un mensaje es publicado en una cola que está configurada para mirroring, es enviado primero al nodo maestro de esa cola. El nodo maestro se encarga de escribir el mensaje localmente y luego replicarlo a sus nodos espejo configurados. La confirmación al productor puede ocurrir en diferentes momentos, dependiendo de la configuración de sincronización (
ha-sync-mode):- Sincronización Síncrona (
ha-sync-mode: exactlyoautomatic): El nodo maestro espera a que todos (o un número específico) de los espejos hayan recibido y persistido el mensaje antes de enviar la confirmación (ack) de vuelta al productor. Esto ofrece la garantía más fuerte contra la pérdida de datos en caso de fallo del maestro, pero introduce latencia adicional debido a la espera de la replicación. - Sincronización Asíncrona (
ha-sync-mode: manualyautomaticpost-sync): El nodo maestro confirma al productor tan pronto como ha procesado el mensaje localmente, replicándolo a los espejos en segundo plano. Esto ofrece un mayor throughput ya que no hay espera por la replicación, pero existe una pequeña ventana de riesgo donde un mensaje podría confirmarse al productor pero perderse si el nodo maestro falla antes de que el mensaje se replique a un espejo. Los consumidores siempre se conectan y operan con el nodo que es el maestro actual de la cola. El failover (promoción de un espejo a maestro) es un proceso automático gestionado por el clúster.
- Sincronización Síncrona (
- Configuración: El mirroring se define mediante Políticas. Una política especifica un patrón para los nombres de las colas y las propiedades de HA a aplicar, como el número de espejos (
ha-count: 3para 3 réplicas en total: 1 maestro + 2 espejos), o si se espeja en todos los nodos del clúster (ha-mode: all). - Consideraciones: Aunque fue la solución estándar durante años, el mirroring clásico es ahora considerado un enfoque heredado y se desaconseja para nuevas implementaciones de alta disponibilidad en favor de las Quorum Queues. Su principal desventaja radica en su complejidad operativa y de gestión. La distinción explícita entre maestro y espejos puede ser confusa, la gestión de la sincronización inicial de grandes colas a nuevos espejos puede ser costosa en tiempo y recursos, y el manejo de escenarios de partición de red es propenso a complicaciones ("split-brain") que requieren configuración y entendimiento cuidadosos. Su modelo de consistencia y failover es menos predecible que el de Quorum Queues.
2. Quorum Queues: La Solución Moderna Basada en Consenso Fuerte
- Concepto: Introducidas en RabbitMQ 3.8, las Quorum Queues representan la arquitectura recomendada y predeterminada para la alta disponibilidad de mensajes en RabbitMQ moderno. Están diseñadas desde cero para ofrecer consistencia fuerte y durabilidad utilizando una implementación integrada del probado algoritmo de consenso Raft. La clave de Quorum Queues es que operan como un conjunto de réplicas que colaboran activamente, eliminando la distinción rígida maestro/espejo del mirroring clásico (aunque internamente Raft elige un "líder").
- Mecanismo: Una Quorum Queue existe como un conjunto de réplicas distribuidas en diferentes nodos del clúster. Cualquier operación que altere el estado de la cola (como publicar un mensaje, reconocer una entrega) debe ser acordada por una mayoría (un quórum) de las réplicas antes de ser considerada exitosa y confirmada al cliente. Por ejemplo, en un conjunto de 3 réplicas, se necesitan al menos 2 réplicas para confirmar una operación. Este mecanismo basado en consenso garantiza la consistencia y previene la pérdida de datos en caso de fallos de nodo, siempre que la mayoría de las réplicas permanezcan disponibles.
- Publicación: Un productor envía un mensaje a la cola. Internamente, la solicitud es gestionada por el líder Raft actual. El mensaje se replica a las otras réplicas. La confirmación al productor solo se envía una vez que el líder ha confirmado que la mayoría de las réplicas han recibido y persistido el mensaje.
- Consumo: Un consumidor puede conectarse a cualquier nodo que albergue una réplica de la Quorum Queue. La operación de consumo (obtener un mensaje, enviar un ack/nack) también pasa por el líder Raft, y la confirmación del procesamiento también requiere consenso.
- Failover: Si el nodo que alberga el líder Raft actual falla, las réplicas restantes utilizan el algoritmo Raft para elegir automáticamente un nuevo líder entre ellas, siempre y cuando haya un quórum disponible. El proceso de failover es rápido y transparente para los clientes (aunque una reconexión puede ser necesaria si el nodo al que estaban conectados falla).
- Configuración: Las Quorum Queues se declaran explícitamente estableciendo el argumento
x-queue-typeaquorumal declarar la cola, ya sea directamente desde el cliente o, más comúnmente, mediante una Política. La política también se usa para definir el número deseado de réplicas (x-queue-replicas), que debe ser un número impar (típicamente 3 o 5) para garantizar que siempre pueda haber un quórum (N/2 + 1 réplicas necesarias para el quórum, donde N es el número total de réplicas). - Consideraciones: Las Quorum Queues son la opción preferida para la alta disponibilidad de mensajes en RabbitMQ debido a su simplicidad operativa en comparación con el mirroring, sus garantías de consistencia fuerte (basadas en Raft) y su robusto manejo de fallos. Su principal (ligero) trade-off puede ser un throughput de publicación potencialmente un poco menor en algunos escenarios en comparación con colas clásicas no mirrored, debido al overhead inherente del protocolo de consenso. Sin embargo, los beneficios de durabilidad y disponibilidad superiores generalmente superan esta posible diferencia. Requieren un número impar de réplicas para funcionar correctamente y evitar problemas de quórum.
En resumen, mientras que el clustering es la base para la HA y escalabilidad de los metadatos y la gestión de conexiones, son arquitecturas específicas como el mirroring (legado) y las Quorum Queues (recomendado) las que extienden la alta disponibilidad a los datos de los mensajes mismos, asegurando que tu sistema de mensajería pueda soportar fallos de nodo sin perder información crítica. Las Quorum Queues, con su enfoque basado en consenso, representan el estado del arte en la garantía de durabilidad y consistencia para tus mensajes en un clúster de RabbitMQ.
Beneficios de la Alta Disponibilidad en un Clúster
La implementación adecuada de HA para las colas dentro de un clúster de RabbitMQ ofrece beneficios cruciales para aplicaciones de misión crítica:
- Tolerancia a Fallos: Si un nodo individual en el clúster falla inesperadamente (debido a problemas de hardware, red o software), el clúster en su conjunto puede seguir operando. Para colas configuradas con mirroring o quorum queues, la pérdida del nodo que era primario/líder para esa cola no resulta en la pérdida de mensajes ni en la interrupción del servicio para productores y consumidores (tras un breve período de failover automático).
- Continuidad del Servicio: Minimiza o elimina el tiempo de inactividad no planificado. Las aplicaciones pueden seguir enviando y recibiendo mensajes sin una interrupción significativa, lo cual es vital para sistemas que deben estar siempre disponibles (ej. procesamiento de pagos, logs de auditoría, microservicios críticos).
Consideraciones al Implementar un Clúster de RabbitMQ
Implementar un clúster requiere atención a varios factores para asegurar su estabilidad y rendimiento óptimo:
- Particiones de Red (Split-Brain): Un clúster es susceptible a particiones de red donde los nodos se dividen en dos o más grupos que pierden la comunicación entre sí. Sin una estrategia de manejo adecuada, esto puede llevar a una situación de "split-brain" donde ambos grupos creen ser el estado correcto del clúster, causando inconsistencias y posible pérdida de datos cuando la red se restablece. RabbitMQ ofrece estrategias de manejo de particiones (configuradas por la política
network_partition_handling) que típicamente implican pausar al grupo minoritario (pause_minority) o requerir intervención manual (autoheal,ignore). La configuraciónpause_minorityes generalmente la más segura para evitar split-brain, pero requiere un número impar de nodos para funcionar correctamente en escenarios de partición en dos grupos. - Consistencia vs. Rendimiento: La elección entre mirroring (síncrono/asíncrono) y quorum queues implica un compromiso fundamental entre la fuerza de la garantía de consistencia y el rendimiento (throughput y latencia). Las Quorum Queues, al basarse en Raft y requerir quórum para las operaciones, ofrecen una consistencia mucho más fuerte y predecible que el mirroring clásico, especialmente en condiciones de fallo. Sin embargo, el overhead del consenso puede resultar en un throughput marginalmente menor en comparación con colas clásicas no mirrored o con mirroring asíncrono en condiciones ideales. Para HA y durabilidad garantizada, Quorum Queues son el camino a seguir.
- Descubrimiento de Nodos: Los nodos que van a formar un clúster necesitan poder encontrarse y comunicarse entre sí. Esto se puede configurar de varias maneras: manualmente (usando
rabbitmqctl join_cluster), mediante archivos de configuración (comocluster_formation.classic_config), o a través de mecanismos de descubrimiento automático, especialmente en entornos de nube o contenedores (plugins comorabbitmq_peer_discovery_consul,rabbitmq_peer_discovery_k8s, etc.). - Diseño de Aplicaciones Cliente: Las librerías cliente oficiales de RabbitMQ para la mayoría de los lenguajes de programación están diseñadas para ser "cluster-aware" hasta cierto punto. Generalmente soportan la especificación de una lista de nodos del clúster o la dirección de un balanceador de carga. Si un nodo al que la aplicación está conectada falla, la librería intentará reconectarse automáticamente a otro nodo disponible en la lista. Es crucial que las aplicaciones implementen mecanismos de reintento de conexión robustos.
Escalabilidad Horizontal de RabbitMQ
El clustering no solo proporciona HA, sino que también es la base fundamental para la escalabilidad horizontal en RabbitMQ.
Cómo Añadir Más Nodos al Clúster para Aumentar la Capacidad:
La capacidad de procesamiento de mensajes y conexiones de RabbitMQ se puede aumentar significativamente añadiendo más nodos al clúster existente. Esto distribuye la carga de trabajo a través de los nodos:
- Gestión de Metadatos: La carga de gestionar y replicar los metadatos (declaraciones de exchanges, colas, etc.) se distribuye entre los nodos.
- Gestión de Conexiones: Las conexiones entrantes de productores y consumidores pueden balancearse entre los nodos del clúster. Cada conexión consume recursos (CPU, memoria) en el nodo al que está conectada. Añadir nodos permite manejar un mayor número total de conexiones concurrentes.
- Throughput General: Al distribuir las colas (en el caso de colas clásicas no mirrored, que no son HA pero ilustran el punto) o las réplicas de colas (para Quorum Queues) a través de diferentes nodos, la carga de procesamiento de mensajes (publicación, enrutamiento, entrega) se distribuye. Incluso con colas mirrored o Quorum Queues, añadir nodos puede ayudar a distribuir la carga de replicación y el procesamiento total de mensajes, especialmente si el número de colas es grande o si diferentes conjuntos de colas son muy activos.
Añadir un nodo a un clúster existente es un proceso relativamente directo que implica instalar RabbitMQ en el nuevo servidor, asegurar la comunicación entre nodos y usar el comando rabbitmqctl join_cluster <nombre_del_nodo_existente> (o su equivalente en la configuración de descubrimiento automático). El nuevo nodo descargará los metadatos del clúster existente.
Consideraciones sobre el Balanceo de Carga entre Nodos:
Aunque un clúster comparte metadatos, RabbitMQ no actúa internamente como un balanceador de carga de red para las conexiones de clientes entrantes (a excepción del plugin de gestión que tiene un balanceador rudimentario para la UI web). Por lo tanto, para distribuir de manera uniforme las conexiones de productores y consumidores entre los nodos del clúster y evitar que un solo nodo se convierta en un cuello de botella, generalmente necesitas una capa de balanceo de carga externa:
- Un Balanceador de Carga Externo Dedicado: Esta es la estrategia más común y recomendada para despliegues en producción. Se coloca un balanceador de carga (como HAProxy, Nginx con
streammodule, un Load Balancer de la nube como AWS ELB/ALB, GCP Load Balancer, Azure Load Balancer) frente al clúster de RabbitMQ. El balanceador recibe todas las conexiones entrantes en una única dirección IP o nombre de host y las distribuye a los nodos del clúster según un algoritmo de balanceo (ej. round-robin, least-connection). Los balanceadores de carga pueden también realizar health checks a los nodos de RabbitMQ para enviar tráfico solo a los nodos saludables. - DNS Round-Robin: Una alternativa más simple es configurar una entrada DNS que resuelva el nombre de host del broker a las múltiples direcciones IP de los nodos del clúster. Las aplicaciones cliente intentarán conectarse a las IPs en el orden que les devuelve el DNS. Esta estrategia es menos sofisticada que un balanceador dedicado, ya que no realiza health checks y la distribución de carga depende de cómo los clientes resuelven y cachean las entradas DNS.
- Configuración en el Cliente: Algunas librerías cliente de RabbitMQ permiten especificar una lista de nodos del clúster (
amqp://user:pass@host1:port1,host2:port2,...). La librería intentará conectarse secuencialmente a los nodos de la lista hasta que una conexión tenga éxito. Esto proporciona una forma básica de failover a nivel de cliente pero no balancea activamente la carga entre conexiones concurrentes de múltiples instancias de la aplicación cliente.
Un balanceo de carga efectivo es crucial para la escalabilidad, ya que asegura que el tráfico de la aplicación se distribuya de manera uniforme, maximizando el uso de los recursos de cada nodo y aumentando el throughput total del clúster.
Implicaciones para Productores y Consumidores
Es importante entender cómo las aplicaciones cliente (productores y consumidores) interactúan con un clúster de RabbitMQ:
- Agentes Externos: Las aplicaciones cliente no son nodos del clúster; son agentes externos que se conectan a él.
- Conexión a un Punto del Clúster: Una aplicación cliente se conecta a uno de los nodos del clúster (o, idealmente, a la dirección IP/nombre del balanceador de carga que está frente al clúster). Una vez conectada, la conexión es gestionada por ese nodo específico.
- Transparencia (en su mayoría): Para los productores, una vez conectados, pueden publicar mensajes a exchanges que existen en el clúster. Los exchanges y bindings se replican en todos los nodos, por lo que el mensaje se enrutará correctamente a la(s) cola(s) destino, independientemente de en qué nodo residan primariamente o de qué nodo sea el líder Raft de la cola. Para los consumidores de colas mirrored o Quorum Queues, si el nodo al que están conectados falla, una librería cliente bien configurada intentará reconectarse a otro nodo disponible, y la cola (si está configurada para HA) seguirá disponible en otro nodo del clúster.
- Consideraciones de Topología: Las aplicaciones no necesitan saber en qué nodo reside primariamente una cola (a menos que usen colas clásicas no mirrored, lo cual no es una configuración de HA). El clúster maneja internamente el enrutamiento y la gestión de las colas distribuidas.
Consideraciones Avanzadas: Gestión y Conectividad Distribuida
Más allá del clustering básico para HA y escalabilidad dentro de un único grupo de nodos, RabbitMQ ofrece herramientas adicionales para gestionar configuraciones a gran escala y conectar brokers o clústeres distribuidos geográficamente o lógicamente.
Políticas (Policies):
- Concepto: Las políticas son un mecanismo poderoso para aplicar configuraciones a múltiples exchanges y/o colas en un clúster basándose en patrones de nombres. Se definen de forma centralizada en el clúster y se aplican dinámicamente a los recursos existentes o recién declarados que coincidan con el patrón.
- Uso: Permiten definir propiedades de recursos de manera uniforme sin que las aplicaciones tengan que declararlas explícitamente o si se necesita cambiar una configuración (ej. número de espejos,
x-queue-type,x-message-ttl,max-length) en runtime para muchas colas/exchanges a la vez. Son la forma principal de configurar el mirroring clásico (ha-mode,ha-params) y de definir el tipo de cola por defecto (x-queue-type) o el número de réplicas para Quorum Queues (x-queue-replicas) para colas coincidentes. - Beneficio: Simplifican enormemente la gestión de configuraciones uniformes, la aplicación de reglas de HA (espejado, Quorum) y la gestión de otras propiedades en un clúster con muchas colas y exchanges, reduciendo el riesgo de errores de configuración a nivel de aplicación.
Shovel y Federation para la Interconexión entre Brokers:
- Concepto: A diferencia del clustering que une nodos para formar un único broker lógico, Shovel y Federation son mecanismos para mover mensajes entre diferentes brokers, que pueden ser nodos independientes, clústeres separados o incluso brokers en diferentes centros de datos o regiones de la nube. No forman parte del clúster interno de RabbitMQ.
- Shovel: Es un plugin que define una tarea de copia de mensajes configurable. Típicamente, mueve mensajes de una cola en un broker ("broker de origen") a un exchange en otro broker ("broker de destino"). Es útil para escenarios de re-enrutamiento de mensajes entre sistemas o dominios de aplicación que están lógicamente separados o para migración/backhaul de mensajes. El Shovel es unidireccional y puede configurarse como dinámico (declarado y gestionado en runtime) o estático (configurado en el archivo de configuración de RabbitMQ).
- Federation: Es otro plugin diseñado para enlazar exchanges o colas entre brokers remotos de una manera más dinámica y distribuida que Shovel. La idea principal es que un exchange o cola en un broker puede "federar" con uno remoto, de modo que los mensajes publicados en el exchange/cola remoto aparezcan como si hubieran sido publicados localmente, o que un consumidor local pueda consumir de una cola remota. Federation es útil para escenarios de distribución de topología y mensajes a través de WANs o entre clústeres geográficamente dispersos, permitiendo que los mensajes "fluyan" entre ellos de manera transparente para las aplicaciones locales.
- Uso: Shovel y Federation son esenciales para arquitecturas más complejas que implican la conexión de múltiples brokers o clústeres, ya sea por razones organizacionales, geográficas o de aislamiento lógico.
Plugins y Extensiones para Funcionalidades Adicionales:
RabbitMQ es altamente extensible a través de su sistema de plugins. Más allá del esencial plugin de gestión (rabbitmq_management), existen muchos otros plugins que añaden funcionalidades:
- Soporte de Protocolos: Plugins para soportar otros protocolos de mensajería además de AMQP 0-9-1 (MQTT, STOMP).
- Autenticación/Autorización: Plugins para integrarse con sistemas de autenticación y autorización externos (LDAP, OAuth 2.0, etc.).
- Funcionalidades de Colas: Plugins que modifican o añaden comportamiento a las colas (ej.
rabbitmq_delayed_message_exchangepara colas de retraso). - Integración: Plugins para integrar con sistemas externos (ej.
rabbitmq_web_stomp,rabbitmq_web_mqtt).
Estas características avanzadas son cruciales para administrar despliegues de RabbitMQ complejos, conectar sistemas distribuidos, extender la funcionalidad base del broker y adaptarse a los requisitos específicos de las aplicaciones y la infraestructura.
Conclusión
La alta disponibilidad y la escalabilidad horizontal son requisitos fundamentales para la inmensa mayoría de las aplicaciones modernas, y RabbitMQ aborda estos desafíos de manera eficaz a través de su capacidad de clustering. Hemos visto cómo los nodos pueden agruparse no solo para compartir metadatos, sino también, y crucialmente, cómo arquitecturas como el mirroring de colas (un enfoque clásico, ahora en desuso para HA) y las modernas y robustas Quorum Queues (basadas en Raft) aseguran que los mensajes no se pierdan y que las colas permanezcan disponibles incluso si un nodo individual falla.
Comprendimos que la escalabilidad horizontal se logra fundamentalmente añadiendo más nodos al clúster para distribuir la carga de conexiones y procesamiento, y que una estrategia efectiva de balanceo de carga externo es esencial para maximizar el throughput y la utilización de recursos del clúster. Discutimos las implicaciones para productores y consumidores, que interactúan con el clúster como un único broker lógico.
Finalmente, exploramos herramientas avanzadas como las Políticas para la gestión centralizada y dinámica de la configuración de recursos, y los mecanismos de Shovel y Federation como soluciones para conectar brokers o clústeres distribuidos, así como la importancia del ecosistema de plugins para extender la funcionalidad base de RabbitMQ.
Con esta comprensión de la HA, el clustering y las herramientas avanzadas, tienes una visión completa de cómo diseñar, desplegar y gestionar RabbitMQ para escenarios de misión crítica, alta carga y distribuidos.
RabbitMQ 5: Consumo de Recursos, Latencia y Monitorización de RabbitMQ
- Mauricio ECR
- Arquitectura
- 29 Apr, 2025
Hemos explorado la teoría detrás de RabbitMQ, su arquitectura, cómo enruta mensajes y cómo podemos construir sistemas robustos y seguros. Sin embargo, para operar RabbitMQ de manera efectiva en produc

RabbitMQ 5: Consumo de Recursos, Latencia y Monitorización de RabbitMQ
- Mauricio ECR
- Arquitectura
- 29 Apr, 2025
Hemos explorado la teoría detrás de RabbitMQ, su arquitectura, cómo enruta mensajes y cómo podemos construir sistemas robustos y seguros. Sin embargo, para operar RabbitMQ de manera efectiva en producción, necesitamos entender cuántos recursos consume, qué esperar en términos de latencia de los mensajes y, lo más importante, cómo vigilarlo y gestionarlo activamente.
Este artículo se sumerge en estos aspectos prácticos, brindándote la información necesaria para dimensionar tu infraestructura, gestionar expectativas sobre el rendimiento y mantener tu broker funcionando sin problemas.
Consumo de Recursos e Implementación
El "costo" de ejecutar RabbitMQ, principalmente en términos de CPU, memoria RAM y espacio en disco, no es fijo. Varía significativamente en función de varios factores clave:
Factores que Influyen en el Consumo
- Carga (Throughput): El factor más obvio. Un alto volumen de mensajes publicados y entregados por segundo requiere más CPU y red para procesar las operaciones.
- Número de Colas y Exchanges: Aunque los recursos por cola/exchange inactivos son bajos, un gran número de ellos (miles o decenas de miles) puede aumentar la carga de gestión interna del broker y el consumo de memoria. Esto es especialmente cierto si hay muchas conexiones y bindings activos asociados a estos elementos.
- Persistencia de Mensajes y Durabilidad de Colas:
- Los mensajes persistentes (en colas duraderas) requieren escrituras a disco para asegurar que no se pierdan en caso de fallo del broker. Esto consume I/O de disco y puede ser un cuello de botella importante si el volumen es alto y el disco subyacente es lento.
- Las colas duraderas requieren que su estado (configuración, mensajes en cola, estado de consumidores) sea guardado persistentemente.
- Usar mensajes persistentes aumenta significativamente la demanda de recursos de disco y puede reducir el throughput máximo comparado con mensajes no persistentes.
- Número de Conexiones y Canales: Cada conexión de cliente TCP y cada canal AMQP asociado consumen memoria en el broker para mantener su estado. Un gran número de clientes conectados (cientos o miles) puede sumar un consumo notable de RAM, incluso si la tasa de mensajes no es extremadamente alta.
- Tamaño de los Mensajes: Mensajes más grandes consumen más ancho de banda de red al ser transferidos entre productores/consumidores y el broker. También consumen más memoria y/o disco al ser transferidos y almacenados temporalmente en el broker o en las colas.
- Uso de Características Avanzadas: Características como prioridades de mensajes (
x-max-priority), TTLs (x-message-ttl), o Dead-Lettering añaden algo de overhead de procesamiento interno en el broker para gestionar la lógica asociada.
Ejemplos de Carga y Consideraciones de Dimensionamiento
No hay una "calculadora" única y precisa para dimensionar RabbitMQ que funcione en todos los casos, ya que depende mucho de los factores anteriores y del hardware subyacente. Sin embargo, aquí hay algunas pautas generales basadas en la experiencia común:
| Mensajes/s | Tamaño Msg (bytes) | CPU Cores | RAM (GB) | Disco (IOPS / MB/s) | Ancho de Banda |
|---|---|---|---|---|---|
| 100 | 512 | 1 | 1 | 50 IOPS / 1 MB/s | ~0.4 Mbps |
| 1,000 | 1,024 (1 KB) | 2 | 2 | 100 IOPS / 5 MB/s | ~8 Mbps |
| 5,000 | 2,048 (2 KB) | 4 | 4 | 200 IOPS / 20 MB/s | ~80 Mbps |
| 10,000 | 4,096 (4 KB) | 6 | 6 | 400 IOPS / 40 MB/s | ~320 Mbps |
| 50,000 | 4,096 (4 KB) | 8–12 | 12–16 | 1,000 IOPS / 200 MB/s | ~1.6 Gbps |
| 100,000 | 8,192 (8 KB) | 16+ | 32+ | 2,000+ IOPS / 800 MB/s | ~6.4 Gbps |
🔍 Notas / Supuestos:
- Se asume que la persistencia está activada (uso típico).
- Uso de colas clásicas (classic queues) sin clustering.
- No se consideran configuraciones con replicación (HA) o federation.
- Basado en RabbitMQ 3.11+.
- Los mensajes tienen TTL o se procesan rápidamente (sin grandes acumulaciones).
- Red de baja latencia.
Estrategias para Optimizar el Uso de Recursos
- Minimizar la Persistencia: Usa persistencia solo para los mensajes y colas donde la pérdida sea inaceptable. Los mensajes no persistentes son mucho más rápidos y consumen significativamente menos recursos de disco y CPU asociados al I/O.
- Mantener las Colas Cortas: Idealmente, los consumidores deben procesar mensajes tan rápido como llegan. Colas que crecen indefinidamente son un signo de contrapresión (la tasa de producción excede la de consumo) y consumen progresivamente más RAM y eventualmente pagan a disco. Usa límites de cola (
x-max-length,x-max-length-bytes) para proteger el broker de crecimientos descontrolados. - Optimizar el Prefetch (QoS): Ajusta el prefetch de los consumidores. Un prefetch muy alto puede hacer que un consumidor acapare muchos mensajes en memoria, potencialmente agotando la RAM del consumidor y reduciendo el throughput si no puede procesarlos rápido. Un prefetch muy bajo (ej. 1) puede reducir el throughput total al esperar la confirmación de cada mensaje. Encuentra un balance óptimo para tu carga, el rendimiento de tus consumidores y la latencia deseada.
- Limitar Conexiones/Canales: Si es posible, reutiliza conexiones y canales en tus aplicaciones cliente en lugar de crear nuevos para cada operación. Mantener miles de conexiones efímeras puede ser costoso en recursos para el broker.
- Dimensionar el Disco Correctamente: Si usas persistencia o esperas colas largas (aunque esto último es una señal de alerta), invierte en discos SSD rápidos y con suficiente espacio para manejar tanto los mensajes en cola como los archivos de paginación y logs. La velocidad del disco impacta directamente el throughput y la latencia con persistencia.
- Monitorizar y Ajustar: Usa las métricas de RabbitMQ de forma constante para identificar cuellos de botella (I/O de disco alto, uso de CPU elevado, crecimiento persistente de colas, alta latencia, número excesivo de conexiones/canales) y ajusta tu configuración o escala tu infraestructura en consecuencia.
Latencia Esperada en los Mensajes
La latencia de un mensaje es el tiempo que tarda desde que un productor lo publica hasta que un consumidor lo recibe (y potencialmente lo procesa). No es cero, ya que implica varias etapas y tránsitos por la red y el broker.
La latencia total se puede conceptualizar aproximadamente como la suma de los tiempos en cada etapa:
$ Latencia_{Total} = Latencia_{Red} (Productor => Broker) + Tiempo_{Broker} (Enrutamiento, Encolamiento, Persistencia) + Latencia_{Red} (Broker => Consumidor) + Tiempo_{Procesamiento} (Consumidor) $
Nos centraremos en los factores que afectan el tiempo que el mensaje pasa dentro o viajando hacia/desde el broker. Varios factores afectan esta latencia:
Factores que Afectan la Latencia
- Carga del Broker: Un broker bajo alta carga (muchos mensajes, muchas conexiones, I/O de disco saturado) tardará más en procesar mensajes y entregarlos. Las operaciones se encolan internamente.
- Tamaño del Mensaje: Mensajes más grandes tardan más en viajar por la red y ser procesados por el broker y los clientes (serialización/deserialización).
- Persistencia: Publicar y encolar mensajes persistentes es significativamente más lento que con mensajes no persistentes, ya que requiere que el broker espere la confirmación de escritura a disco antes de reconocer la publicación al productor (si se usan confirmaciones de editor) y antes de considerarlo seguro en la cola. Esto añade latencia.
- Red: La latencia intrínseca de la red entre productores, el broker y consumidores es un componente directo y, a menudo, incontrolable si los componentes están distribuidos geográficamente. Brokers y aplicaciones en diferentes centros de datos o regiones tendrán mayor latencia de red.
- QoS (Prefetch): Un prefetch bajo (ej. 1) puede aumentar la latencia percibida entre mensajes para un mismo consumidor, ya que debe confirmar cada mensaje antes de recibir el siguiente. Un prefetch más alto reduce esta latencia inter-mensaje, pero puede aumentar el tiempo que un mensaje espera en el buffer del consumidor antes de ser procesado, aumentando su latencia dentro del consumidor.
- Número de Hops (Enrutamiento): Mensajes que son enrutados a través de múltiples Exchanges encadenados (topologías avanzadas con
shovelofederationo simples bindings secuenciales) pueden experimentar latencia adicional en cada paso de enrutamiento interno o entre brokers. - Paginación a Disco: Si las colas crecen y los mensajes que no caben en RAM se paginan a disco, la latencia para acceder a ellos cuando un consumidor los solicita aumenta drásticamente. Acceder a disco es mucho más lento que acceder a RAM.
Latencias Típicas Esperadas
Las latencias varían ampliamente, pero aquí hay un rango esperado bajo diferentes escenarios:
- Configuración Optimizada, Baja Carga, Mensajes Pequeños y No Persistentes, Red Rápida: Latencia muy baja, a menudo en el rango de pocos milisegundos. Este es el mejor escenario.
- Configuración Típica, Carga Moderada, Mensajes Persistentes, Red Estándar: Latencia moderada, probablemente en el rango de decenas o cientos de milisegundos. La persistencia suele ser el factor dominante aquí.
- Alta Carga, I/O de Disco Saturado, Colas Largas, Paginación Activa: Latencia puede dispararse a varios segundos o incluso más. Esto indica un problema grave de rendimiento o dimensionamiento.
Estrategias para Minimizar la Latencia Cuando es Crítico
- Usar Mensajes No Persistentes: Si la pérdida ocasional de mensajes es aceptable y la latencia es crítica (ej. datos de monitorización no vitales, notificaciones efímeras), usa mensajes no persistentes. Son significativamente más rápidos.
- Mantener Colas Cortas: Asegura que los consumidores procesen mensajes rápidamente para evitar que las colas se alarguen y los mensajes se paginen. Escalar el número de consumidores es la estrategia clave contra la contrapresión.
- Optimizar el Prefetch: Experimenta con el prefetch para encontrar el equilibrio adecuado que mantenga a tus consumidores ocupados sin sobrecargarlos ni acaparar mensajes innecesariamente.
- Hardware Rápido: Usa servidores con CPU potente (para el procesamiento interno), mucha RAM (para colas en memoria) y discos SSD muy rápidos (crítico si usas persistencia) para minimizar los tiempos de procesamiento del broker.
- Red de Baja Latencia: Coloca el broker y los consumidores/productores en la misma red o lo más cerca posible geográficamente para minimizar la latencia de red.
- Evitar Enrutamiento Complejo Innecesario: Si una topología de enrutamiento simple es suficiente, úsala en lugar de cadenas complejas de Exchanges, ya que cada paso añade una pequeña sobrecarga.
- Monitorizar la Latencia: Mide la latencia de extremo a extremo de tus mensajes en tus aplicaciones (productor -> broker -> consumidor -> procesamiento) para identificar cuellos de botella reales. Las métricas del broker te dirán cuánto tiempo pasa dentro de RabbitMQ.
Es importante recordar que RabbitMQ está diseñado principalmente para la comunicación asíncrona, el desacoplamiento de servicios y la entrega confiable (especialmente con persistencia), optimizando el throughput (mensajes por segundo) sobre la latencia ultrabaja. Si necesitas latencias de microsegundos y comunicación estrictamente síncrona, RabbitMQ podría no ser la herramienta adecuada; la comunicación directa via RPC o protocolos especializados de baja latencia serían más apropiados.
Monitorización y Gestión de RabbitMQ
Una vez que RabbitMQ está funcionando, la monitorización activa y la gestión son vitales para asegurar su salud, rendimiento, prever problemas y solucionarlos rápidamente cuando ocurren.
Uso Exhaustivo de la Interfaz de Administración Web
La interfaz web de gestión (Management Plugin) es una herramienta invaluable para la inspección manual del estado del broker. Se accede típicamente a través del puerto 15672 (asegúrate de que esté accesible solo desde redes de administración seguras). Permite visualizar:
- Overview: Métricas generales y gráficos de alto nivel como mensajes publicados/entregados por segundo, uso de memoria/disco, número de conexiones/canales, y estado del cluster.
- Connections: Listado de todas las conexiones activas, desde qué host se originan, qué usuario las estableció, qué vhost están usando, etc. Puedes cerrarlas forzadamente si es necesario.
- Channels: Detalles de los canales AMQP dentro de cada conexión, incluyendo el prefetch configurado y los mensajes no confirmados.
- Exchanges: Listado de todos los Exchanges declarados, su tipo (direct, fanout, topic, headers), durabilidad, y a qué colas están vinculados (
bindings). Puedes declarar/eliminar Exchanges. - Queues: La vista más importante para diagnosticar problemas. Muestra todas las colas, cuántos mensajes tienen listos para entregar (
messages ready), cuántos mensajes están entregados pero sin confirmar (messages unacknowledged), la tasa de entrada (incoming), la tasa de salida (outgoing), el número de consumidores activos, sus propiedades (durabilidad, auto-delete, argumentos), etc. Puedes declarar/eliminar colas, purgar mensajes (vaciar la cola), publicar mensajes de prueba. - Admin: Gestionar usuarios, vhosts (entornos virtuales), permisos de usuario en vhosts, políticas (para configuración a gran escala), y el estado del cluster (si aplica).
Aprender a navegar por esta interfaz e interpretar sus métricas es fundamental para diagnosticar problemas rápidamente (ej. colas creciendo consistentemente -> contrapresión, los consumidores no dan abasto; tasas de entrega bajas pero mensajes en cola -> problemas en los consumidores; muchas conexiones -> posible fuga de recursos en una aplicación cliente; uso de disco alto -> persistencia o paginación).
Herramientas de Línea de Comandos (rabbitmqctl)
rabbitmqctl es la herramienta de línea de comandos para interactuar con RabbitMQ. Es esencial para tareas de automatización, scripting, y gestión de bajo nivel, especialmente en servidores donde no tienes acceso fácil a una UI gráfica o para realizar operaciones repetitivas. Algunos comandos esenciales incluyen (siempre especificando el vhost con -p <vhost> si no es el / por defecto):
rabbitmqctl status
Muestra el estado general del nodo RabbitMQ, versión, estado de los procesos, uso de memoria, etc.
rabbitmqctl list_queues name messages_ready messages_unacknowledged consumers memory
Lista las colas y métricas clave como el número de mensajes listos y sin confirmar, consumidores activos y uso de memoria por cola. Puedes listar otras columnas según necesites (message_stats.publish, message_stats.deliver_get, etc.).
rabbitmqctl list_exchanges name type durable
Lista los Exchanges, su tipo y si son duraderos.
rabbitmqctl list_bindings source destination destination_type routing_key arguments
Lista todas las vinculaciones (bindings) entre Exchanges y Colas/Exchanges.
rabbitmqctl add_user <username> <password>
rabbitmqctl set_permissions -p <vhost> <user> "<configure>" "<write>" "<read>"
rabbitmqctl delete_user <username>
Gestión básica de usuarios y permisos. Los permisos son expresiones regulares. "<configure>" afecta a exchanges/colas, "<write>" a la publicación, "<read>" al consumo.
rabbitmqctl delete_queue [-p <vhost>] <name>
rabbitmqctl purge_queue [-p <vhost>] <name>
Elimina una cola o elimina todos los mensajes de una cola sin borrarla. ¡Usar con precaución en producción!
rabbitmqctl tiene muchos más comandos para gestionar el cluster, políticas, parámetros de vhost, etc., siendo una herramienta muy potente para la administración avanzada.
Integración con Sistemas de Monitorización Externos
Si bien la UI web es útil para la inspección manual y rabbitmqctl para la gestión puntual, para la monitorización proactiva, la visualización histórica y las alertas necesitas integrar RabbitMQ con sistemas de monitorización centralizados.
- Prometheus + Grafana: Una combinación muy popular en entornos de microservicios. El plugin de gestión de RabbitMQ expone métricas en un formato que Prometheus puede scrapear (
/metricsendpoint si el pluginprometheusestá habilitado, o via API si solo el pluginmanagementestá habilitado). Grafana se utiliza luego para crear dashboards visuales con estas métricas (uso de CPU/RAM, I/O de disco, longitud de colas a lo largo del tiempo, tasas de mensajes public/deliver/ack, latencia de confirmación, número de conexiones/canales, estado de health checks, etc.). - Otras Herramientas: RabbitMQ también puede integrarse con otras herramientas de monitorización como Nagios, Zabbix, Datadog, New Relic, etc., a menudo a través de plugins específicos, exportando métricas vía API de gestión o analizando sus logs.
Configurar alertas basadas en umbrales (ej. cola excede cierto número de mensajes, uso de CPU/RAM demasiado alto, espacio en disco casi lleno, nodo de cluster caído, tasa de mensajes entregados cae drásticamente) es vital para ser notificado y responder rápidamente a los problemas antes de que afecten significativamente a tus aplicaciones.
Logging y Alertas
Además de las métricas, los logs de RabbitMQ (generalmente ubicados en /var/log/rabbitmq/ en sistemas tipo Linux) contienen información valiosa sobre eventos, errores, advertencias, intentos de conexión, desconexiones, cambios de estado del cluster, etc. Es crucial tener un sistema centralizado de gestión de logs (ej. ELK Stack - Elasticsearch, Logstash, Kibana; Splunk; Loki+Grafana) para agregarlos desde todos tus nodos RabbitMQ, buscar patrones, diagnosticar fallos específicos y configurar alertas basadas en la aparición de eventos o errores particulares en los logs (ej. errores al escribir a disco, fallos de autenticación repetidos que podrían indicar un ataque, errores de sincronización de cluster).
La combinación de métricas en tiempo real (para el qué está pasando con el rendimiento y los recursos) y análisis de logs históricos (para el por qué algo falló o un evento ocurrió) te dará una visibilidad completa sobre la salud y el comportamiento de tu broker RabbitMQ.
Conclusión
Operar RabbitMQ en producción va mucho más allá de entender cómo enviar y recibir mensajes; implica comprender su apetito por los recursos, gestionar las expectativas de latencia y, sobre todo, tener herramientas robustas de monitorización y gestión para asegurar su estabilidad y rendimiento continuo.
Hemos visto los múltiples factores que influyen en el consumo de CPU, RAM y disco, y cómo la persistencia de mensajes y colas es un gran determinante del rendimiento de I/O, a menudo siendo el principal cuello de botella. Discutimos la latencia, sus componentes y cómo optimizarla según tus necesidades, recordando que RabbitMQ está optimizado para el throughput y el desacoplamiento más que para la latencia ultrabaja, un diseño fundamental para sistemas asíncronos robustos.
Finalmente, exploramos las herramientas esenciales para mantener el control: la indispensable interfaz de administración web para la inspección visual y diagnósticos puntuales, rabbitmqctl para la gestión por línea de comandos y automatización, y la integración con sistemas de monitorización externos como Prometheus y Grafana (junto con un buen sistema de logs) para tener visibilidad proactiva, análisis histórico y alertas cruciales.
Con estos conocimientos sobre el consumo de recursos, las expectativas de latencia y las herramientas de monitorización y gestión, estás mucho mejor equipado para desplegar, dimensionar y mantener una infraestructura de RabbitMQ saludable y resiliente. Un tema que complementa directamente la robustez en producción, especialmente a cargas altas, es la Alta Disponibilidad y el Clustering, que abordaremos en un futuro artículo.
Docker: La Revolución que Empaquetó tu Código
- Mauricio ECR
- DevOps
- 29 Apr, 2025
En el dinámico mundo del desarrollo y la infraestructura de tecnologías de la información, la necesidad de empaquetar, distribuir y ejecutar aplicaciones de forma consistente ha llevado a la populariz
Docker: La Revolución que Empaquetó tu Código
- Mauricio ECR
- DevOps
- 29 Apr, 2025
En el dinámico mundo del desarrollo y la infraestructura de tecnologías de la información, la necesidad de empaquetar, distribuir y ejecutar aplicaciones de forma consistente ha llevado a la popularización de tecnologías como Docker. Docker no inventó el concepto de contenedores, ya existían tecnologías como LXC (Linux Containers), pero sí los popularizó al proporcionar una forma sencilla y eficiente de trabajar con ellos. Lanzado en 2013, Docker se ha convertido rápidamente en una herramienta fundamental para desarrolladores, administradores de sistemas y profesionales de DevOps.
La promesa de Docker es resolver el clásico problema de "funciona en mi máquina, pero no en producción". Al encapsular una aplicación y todas sus dependencias en una unidad aislada llamada contenedor, garantiza que la aplicación se ejecute de la misma manera en cualquier entorno, ya sea desarrollo, pruebas o producción.
Conceptos Fundamentales de Docker
Para entender cómo funciona Docker, es crucial familiarizarse con algunos conceptos básicos:
Contenedor: Un contenedor es, fundamentalmente, un proceso que se ejecuta en un entorno aislado. Es una instancia en ejecución de una imagen. Un contenedor incluye la aplicación y sus dependencias, tanto de librerías del lenguaje de programación como de librerías de sistema operativo necesarias para la aplicación. Es importante diferenciarlo de una máquina virtual; no es un sistema operativo completo. Los contenedores se ejecutan con un propósito o comando principal y finalizan cuando este comando termina, aunque pueden ejecutar una tarea y finalizar, o un servicio que se mantenga en ejecución. Se pueden ejecutar, parar, reiniciar y eliminar. La eliminación de un contenedor no afecta la imagen de la que proviene.
Imagen: Una imagen es un archivo binario o una plantilla que contiene todos los elementos necesarios para ejecutar un contenedor. Esto incluye la aplicación, librerías de lenguaje, librerías de sistema operativo necesarias y la configuración de arranque. Las imágenes son inmutables una vez creadas; cualquier cambio requiere la creación de una nueva imagen. Están compuestas por capas, donde cada capa representa un cambio en el sistema de archivos. Esto permite reutilizar funcionalidades y optimizar el almacenamiento y la construcción, ya que Docker solo descarga las capas que no tiene en local.
Dockerfile: Un Dockerfile es un archivo de texto que contiene las instrucciones secuenciales necesarias para construir una imagen. Permite definir pasos como instalar dependencias (
RUN), copiar archivos (COPY), establecer el directorio de trabajo (WORKDIR), y definir el comando por defecto (CMD) o el comando principal (ENTRYPOINT) que se ejecutará al iniciar un contenedor. Cada instrucción crea una capa en la imagen.# Usamos una imagen base ligera de Python (basada en Alpine Linux) FROM python:3.9-alpine # Establecemos el directorio de trabajo dentro del contenedor WORKDIR /app # Copiamos el archivo app.py del host al directorio /app en el contenedor COPY app.py /app/ # Definimos el comando que se ejecutará cuando se inicie el contenedor # En este caso, ejecutar el script python CMD ["python", "app.py"]Docker Hub: Es un repositorio de imágenes de contenedor. Funciona de manera similar a GitHub, pero para imágenes. Permite buscar (
docker search), descargar (docker pull) y subir (docker push) imágenes creadas por la comunidad o propias. Existen otros repositorios que soportan el estándar de Docker, como GitHub Container Registry, GitLab Container Registry, etc., gracias al estándar OCI (Open Container Initiative).
Contenedores vs. Máquinas Virtuales
Una distinción clave para comprender Docker es su diferencia con las máquinas virtuales (VMs). Las VMs emulan hardware completo y ejecutan un sistema operativo completo y una capa de virtualización separada, lo que las hace independientes pero consume más recursos y es menos eficiente. Los contenedores, en cambio, comparten el mismo kernel del sistema operativo subyacente. Se ejecutan en un entorno aislado pero comparten los recursos del sistema. Esto los hace más ligeros, rápidos y eficientes en el uso de recursos que las VMs.
Instalación y Entornos
Docker ofrece dos componentes principales para su instalación:
- Docker Engine: El motor que permite crear y ejecutar contenedores. Es gratuito, sin restricciones y se instala principalmente en sistemas Linux. Se utiliza a través de la línea de comandos (CLI) y es ideal para servidores de desarrollo o producción por su rendimiento nativo.
- Docker Desktop: Una aplicación de escritorio para Windows y Mac (y opcionalmente Linux) que incluye Docker Engine más herramientas adicionales como interfaz gráfica, soporte para Kubernetes, plugins, etc. En Windows y Mac, utiliza una máquina virtual para ejecutar los contenedores. Es gratuito para uso personal y pequeñas empresas.
La instalación en Linux a menudo se simplifica con un script oficial.
#instale algunos paquetes de requisitos previos que permitan a apt usar paquetes a través de HTTPS
$ sudo apt install curl apt-transport-https ca-certificates software-properties-common
#descargue la clave GPG de Docker
$ curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo gpg --dearmor -o /usr/share/keyrings/docker-archive-keyring.gpg
#agregue el repositorio Docker APT a su sistema. El comando crea un docker.listarchivo de repositorio en el /etc/apt/sources.list.ddirectorio.
$ echo "deb [arch=$(dpkg --print-architecture) signed-by=/usr/share/keyrings/docker-archive-keyring.gpg] https://download.docker.com/linux/ubuntu $(lsb_release -cs) stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/null
$ sudo apt update
$ sudo apt install docker-ce -y
$ sudo docker --version
o
sudo docker run hello-world
Construcción de Imágenes con Dockerfile
La construcción de imágenes se realiza utilizando el comando
docker build
nota: El Dockerfile debe estar en el directorio desde donde se ejecuta el comando.
tambien se puede definir un Dockerfile y un contexto (el directorio de referencia). La sintaxis básica es
docker build -t <nombre_imagen> <directorio_contexto>
donde -t asigna un nombre y etiqueta.
Las instrucciones del Dockerfile se ejecutan secuencialmente, de arriba a abajo, y Docker intenta reutilizar capas para optimizar el proceso. Instrucciones clave incluyen:
FROM: Especifica la imagen base.RUN: Ejecuta comandos para instalar software, configurar, etc.COPY: Copia archivos/directorios del contexto de construcción a la imagen.WORKDIR: Define el directorio de trabajo por defecto.CMD: Define el comando por defecto al iniciar el contenedor. Puede ser sobreescrito al ejecutardocker run.ENTRYPOINT: Define el comando principal al iniciar el contenedor. Los comandos pasados adocker runse adjuntan como argumentos aENTRYPOINT.
La diferencia entre CMD y ENTRYPOINT radica en cómo manejan los argumentos pasados al docker run. CMD se sobreescribe, mientras que ENTRYPOINT usa esos argumentos como parámetros.
Para hacer las imágenes más flexibles, se pueden usar:
- Argumentos de Construcción (
ARG): Definidos conARGen el Dockerfile y pasados con--build-argdurante eldocker build. Permiten variabilizar el proceso de construcción. - Variables de Entorno: Se pasan al contenedor en tiempo de ejecución con
-eo--envendocker run. Permiten configurar la aplicación sin modificar la imagen, adaptándola a diferentes entornos.
Ejecución y Gestión de Contenedores
Los contenedores se arrancan con el comando
docker run <imagen>
Este comando crea y arranca un nuevo contenedor.
Comandos y opciones comunes para la gestión de contenedores:
docker ps: Lista los contenedores en ejecución. Añadir-amuestra todos (en ejecución y detenidos).- Opciones de
docker run:-d: Ejecuta el contenedor en segundo plano ("detached").-p <host_port>:<container_port>: Mapea puertos para permitir la comunicación.-v <host_path_o_volume>:<container_path>: Monta volúmenes o directorios/archivos para persistencia o compartir datos.--name <nombre>: Asigna un nombre al contenedor.--rm: Elimina el contenedor al pararlo.-e <variable>=<valor>: Pasa variables de entorno.--restart <policy>: Define una política de reinicio si el contenedor falla o se detiene (ej:always,unless-stopped,on-failure).
docker logs <id_o_nombre>: Muestra la salida del proceso principal.-fsigue la salida en tiempo real.docker attach <id_o_nombre>: Se acopla al proceso principal del contenedor. Control + p + q para desacoplar sin parar.docker exec <id_o_nombre> <comando>: Ejecuta un comando dentro de un contenedor en ejecución.-itpara un terminal interactivo.docker stop <id_o_nombre>: Detiene un contenedor.docker start <id_o_nombre>: Inicia un contenedor existente pero detenido.docker restart <id_o_nombre>: Detiene y vuelve a iniciar un contenedor.docker rm <id_o_nombre>: Elimina un contenedor detenido.-ffuerza la eliminación.docker container prune: Elimina todos los contenedores detenidos.
Persistencia de Datos con Volúmenes
Los contenedores están diseñados para ser efímeros. Para que los datos persistan, se utilizan volúmenes. Los volúmenes son directorios o archivos que se encuentran fuera del sistema de archivos del contenedor y se montan dentro de él.
La gestión de volúmenes incluye:
- Crear:
docker volume create <nombre> - Listar:
docker volume ls - Inspeccionar:
docker volume inspect <nombre> - Montar: Usando
-vo--mountendocker run. - Eliminar:
docker volume rm <nombre>
También es posible copiar archivos entre el host y el contenedor con
docker cp
Redes en Docker
Docker permite gestionar la comunicación entre contenedores y con el exterior mediante redes. Se controlan con el comando
docker network
Tipos de redes comunes incluyen:
bridge: La red por defecto para comunicación en el mismo host.host: Los contenedores comparten la red del host (menos aislamiento).overlay: Para comunicación entre contenedores en diferentes hosts (cargas distribuidas).none: Sin red.
Comandos de red:
- Crear:
docker network create [--driver <tipo>] <nombre> - Listar:
docker network ls - Inspeccionar:
docker network inspect <nombre> - Conectar/Desconectar:
ydocker network connect <red> <contenedor>docker network disconnect <red> <contenedor> - Eliminar:
docker network rm <nombre>
Gestión de Imágenes Avanzada y Repositorios
Además de construir imágenes con Dockerfile, se puede crear una imagen a partir del estado actual de un contenedor en ejecución usando
docker commit <id_contenedor> <nombre_imagen>
aunque esto no es la práctica más común. La buena práctica favorece las imágenes estáticas definidas por Dockerfiles.
Otras operaciones con imágenes:
- Exportar/Importar:
ydocker save -o <fichero>.tar <imagen>docker load -i <fichero>.tar - Etiquetar:
para renombrar o añadir etiquetas. Las etiquetas identifican el origen y la versión.docker tag <imagen_actual>:<etiqueta> <nuevo_nombre>:<nueva_etiqueta> - Buscar:
en Docker Hub.docker search <término> - Descargar:
docker pull <nombre_imagen> - Subir:
Requiere etiquetar la imagen correctamente (ej: usuario/nombre_imagen). Se puede especificar un repositorio remoto.docker push <nombre_imagen> - Eliminar:
docker rmi <id_o_nombre> - Limpiar:
elimina imágenes no asociadas a contenedores.docker image prune
Conclusión
Docker, a través de sus conceptos fundamentales de imágenes, contenedores, Dockerfiles y repositorios, ha estandarizado y simplificado enormemente el ciclo de vida de las aplicaciones. Su capacidad para empaquetar aplicaciones y sus dependencias en unidades portátiles y aisladas, y la eficiencia que ofrece al compartir el kernel del sistema operativo, lo convierten en una herramienta indispensable en la infraestructura de TI moderna. Ya sea para desarrollo, pruebas, microservicios, CI/CD o despliegues en la nube, los contenedores proporcionan una forma consistente y escalable de gestionar aplicaciones, permitiendo a los equipos trabajar de manera más eficiente y agnóstica del entorno. Entender y dominar estos conceptos básicos es el primer paso para aprovechar todo el potencial que Docker ofrece en la actualidad.
Implementando Trunk Based Development con Ramas de Vida Corta en Tu Equipo: Una Guía Completa
- Mauricio ECR
- DevOps
- 28 Apr, 2025
En el ámbito del desarrollo de software, la elección de una estrategia de versionamiento eficiente y estable es fundamental para el éxito de un equipo. El Trunk Based Development (TBD) tradicional, do
Implementando Trunk Based Development con Ramas de Vida Corta en Tu Equipo: Una Guía Completa
- Mauricio ECR
- DevOps
- 28 Apr, 2025
En el ámbito del desarrollo de software, la elección de una estrategia de versionamiento eficiente y estable es fundamental para el éxito de un equipo. El Trunk Based Development (TBD) tradicional, donde los desarrolladores trabajan directamente sobre una única rama principal (master o main), es ideal para equipos pequeños de 1 a 3 desarrolladores. Para equipos de 4 a 5 desarrolladores, aunque sigue siendo una opción viable, requiere indispensablemente la implementación de pruebas automáticas. Sin embargo, para equipos más grandes, con seis o más desarrolladores, una variante del TBD se presenta como una solución escalable: el Trunk Based Development con Ramas de Vida Corta (TBD con SLB). Esta estrategia, utilizada por empresas como Google, utiliza ramas de vida muy corta para gestionar los cambios en lugar de que los desarrolladores hagan commits directamente en el tronco.
¿En qué Consiste TBD con SLB?
En TBD con SLB, la práctica central es que los desarrolladores no hacen commits directos sobre la rama principal o tronco. En su lugar, trabajan en ramas dedicadas y de muy corta duración. Estas ramas, llamadas ramas de vida corta (short-lived branches), duran muy poco tiempo, idealmente menos de 3 días, y como máximo 3 días. Incluso, pueden contener un solo commit. Una vez que la tarea o funcionalidad de la rama está terminada y lista, se integra de nuevo al tronco mediante un merge back, y la rama de vida corta se elimina.
Implementación Paso a Paso (Desarrollo de Nuevas Funcionalidades)
La implementación de TBD con SLB para añadir o modificar funcionalidades sigue un ciclo bien definido. Suponiendo que la rama principal se llama main (puede ser master en repositorios antiguos).
1. Creación de Ramas de Vida Corta
Cada vez que un desarrollador inicia una nueva tarea, debe crear una nueva rama de desarrollo de vida corta. Esta rama se crea a partir de la última versión del tronco (main). Es crucial asegurarse de que tu copia local del tronco esté actualizada antes de crear la rama.
Comandos Git:
# Asegúrate de estar en la rama principal (trunk)
git checkout main
# Descarga los últimos cambios del tronco remoto
git pull origin main
# Crea una nueva rama de vida corta basada en el tronco actual
# Reemplaza 'feature/nombre-tarea' con un nombre descriptivo para tu tarea
git checkout -b feature/nombre-tarea

Ilustración: La rama feature/nombre-tarea se crea a partir del último commit en main (representado por los commits existentes C1 y C2 en main).
codigo mermaid
    gitGraph
        commit id: "C1"
        commit id: "C2"
        branch feature/nombre-tarea
        checkout feature/nombre-tarea
2. Desarrollo y Commits Locales
El desarrollador trabaja sobre su rama recién creada y realiza los commits necesarios con sus cambios, trabajando a su propio ritmo.
Comandos Git:
# Realiza cambios en tus archivos...
# Por ejemplo, crea o modifica un archivo: touch nuevo-archivo.txt
# Agrega los cambios al área de staging
git add .
# Realiza un commit con un mensaje descriptivo
git commit -m "Implementa la funcionalidad X"
# Repite los pasos add/commit según sea necesario mientras trabajas en la tarea

Ilustración: Nuevos commits (F1, F2) se añaden a la rama feature/nombre-tarea, mientras main permanece inalterada.
codigo mermaid
    gitGraph
        commit id: "C1"
        commit id: "C2"
        branch feature/nombre-tarea
        checkout feature/nombre-tarea
        commit id: "F1"
        commit id: "F2"
3. Sincronización con el Tronco (Previo al Merge)
Antes de preparar la integración de los cambios, es esencial que la rama local del desarrollador esté actualizada con los últimos cambios que ya se encuentran en el tronco. Esto se logra descargando los cambios del tronco y aplicándolos a tu rama, típicamente usando merge o rebase. rebase es a menudo preferido en TBD para mantener un historial más lineal.
Comandos Git (Usando Rebase - Preferido en TBD para historial limpio):
# Asegúrate de que tu tronco local esté actualizado
git checkout main
git pull origin main
# Vuelve a tu rama de trabajo
git checkout feature/nombre-tarea
# Rebase tu rama sobre el tronco actualizado
# Esto reescribe el historial de tu rama para que parezca que tus cambios
# se hicieron después de los últimos cambios del tronco
git rebase main
Comandos Git (Usando Merge - Alternativa):
# Asegúrate de que tu tronco local esté actualizado
git checkout main
git pull origin main
# Vuelve a tu rama de trabajo
git checkout feature/nombre-tarea
# Fusiona los cambios del tronco en tu rama
# Esto crea un commit de merge si hay cambios en el tronco
git merge main

Ilustración: main ha avanzado con C3. El merge crea un nuevo commit (M) en feature/nombre-tarea que combina los cambios de main y los de la rama feature.
codigo mermaid
    gitGraph
        commit id: "C1"
        commit id: "C2"
        branch feature/nombre-tarea
        commit id: "F1"
        commit id: "F2"
        checkout main
        commit id: "C3"
        checkout feature/nombre-tarea
        merge main id: "M"
4. Creación de un Pull Request (PR)
Una vez que los cambios están completos, la rama está sincronizada y lista para integrarse, el desarrollador crea un Pull Request (PR) dirigido al tronco (main). Este paso generalmente se realiza a través de la interfaz web de la plataforma de gestión de código (GitHub, GitLab, Bitbucket, Azure DevOps, etc.), después de haber subido la rama local al repositorio remoto.
Comandos Git (para subir la rama antes del PR):
# Sube tu rama de vida corta al repositorio remoto
# La opción -u (o --set-upstream-to) configura el seguimiento remoto
git push -u origin feature/nombre-tarea
5. Revisión de Código y Pruebas Automáticas Pre-Merge
El uso de PRs es una característica distintiva y ventajosa del TBD con SLB. Permite la revisión de código por otros miembros del equipo y, crucialmente, habilita la ejecución de pruebas automáticas antes de que se realice el merge. Esto es una diferencia significativa con el TBD tradicional, donde las pruebas automáticas a menudo se realizan después del merge. La ventaja clave es que evita que commits con errores lleguen al tronco. Este paso es un proceso que ocurre en la plataforma de código, no un comando Git ejecutado por el usuario para realizar la revisión o las pruebas, aunque los revisores pueden descargar la rama si necesitan probar localmente.
6. Merge al Tronco y Eliminación de la Rama
Si el PR es aprobado (por revisores) y las pruebas automáticas pasan, los cambios de la rama de vida corta se integran al tronco (main) mediante un merge (generalmente completando el PR en la plataforma). Posteriormente, la rama de vida corta es eliminada. Todo desarrollo futuro para nuevas tareas siempre empieza creando una nueva rama de vida corta desde el tronco.

codigo mermaid
   gitGraph
        commit id: "C1"
        commit id: "C2"
        branch feature/nombre-tarea
        commit id: "F1"
        commit id: "F2"
        checkout main
        commit id: "C3"
        checkout feature/nombre-tarea
        merge main id: "M"
        checkout main
        merge feature/nombre-tarea
Comandos Git (Después de completar el PR en la plataforma):
# Vuelve al tronco local
git checkout main
# Asegúrate de tener el último estado del tronco (que ahora incluye el merge)
git pull origin main
# Elimina la rama de vida corta localmente (usa -D para forzar si no se ha mergeado, -d es seguro)
git branch -d feature/nombre-tarea
# Elimina la rama de vida corta del repositorio remoto
git push origin --delete feature/nombre-tarea

codigo mermaid
   gitGraph
        commit id: "C1"
        commit id: "C2"
        commit id: "C3"
        commit id: "T1" tag: "merge tarea 1"
Cómo se Gestionan los Releases (Versiones para Producción)
Una parte fundamental del versionamiento es la gestión de las liberaciones de software (releases) a entornos productivos. En el TBD con SLB, el manejo de las ramas de release es directo y se deriva del tronco:
- Creación de la Rama de Release: Cuando el estado actual del tronco (
main) se considera listo para ser liberado como una nueva versión, simplemente se crea una nueva rama a partir de ese punto. - Denominación y Uso: Esta nueva rama se nombra típicamente con el número de la versión que se va a lanzar (por ejemplo,
release/1.0.0). Esta rama de versión es la que se utiliza para ser desplegada en producción. Es la línea base a partir de la cual se gestionarán los despliegues y, si es necesario, las correcciones de bugs específicos de esa versión. El tronco (main) sigue siendo la rama activa para el desarrollo de nuevas funcionalidades.
Comandos Git:
# Asegúrate de estar en el tronco y que esté actualizado
git checkout main
git pull origin main
# Crea la rama de release a partir del tronco actual
# Reemplaza 'release/1.0.0' con el nombre de tu versión
git checkout -b release/1.0.0
# Opcional pero recomendado: Etiqueta este punto para una referencia clara de la versión
git tag v1.0.0 release/1.0.0
# Sube la rama de release y la etiqueta al remoto
git push -u origin release/1.0.0
git push origin v1.0.0

Ilustración: Se crea la rama release/1.0.0 (y potencialmente se etiqueta v1.0.0) a partir de un commit específico en main (C5). main continúa para el desarrollo futuro.
codigo mermaid
   gitGraph
        commit id: "C1"
        commit id: "C2"
        commit id: "C3"
        commit id: "T1" tag: "merge tarea 1"
Escenarios para Solucionar Bugs en Producción
Los bugs que se descubren en una versión ya desplegada en producción (es decir, en la rama de Release) deben manejarse cuidadosamente para mantener la coherencia con la metodología TBD y la integridad del tronco. La forma de proceder depende de si el error aún se puede reproducir en la versión actual del tronco.
Escenario 1: El Bug Sigue Existiendo en el Tronco (Preferido)
Este es el escenario recomendado y se alinea con la práctica de empresas como Google. Se corrige el bug en el tronco y luego se "trasplanta" esa corrección a la rama de Release.
Verificar el Bug en el Tronco: Se confirma que el error se puede replicar en la versión actual del tronco (
main). (Esto es una verificación manual o automatizada, no un comando Git).Crear Rama de Vida Corta desde el Tronco: Se crea una nueva rama de vida corta específicamente para el bug fix, partiendo directamente del tronco.
Comandos Git:
# Asegúrate de estar en el tronco y actualizado
git checkout main
git pull origin main
# Crea la rama para el bug fix desde el tronco
git checkout -b bugfix/nombre-bug-en-produccion
- Solucionar el Bug: El bug se corrige en esta nueva rama de vida corta.
Comandos Git:
# Realiza los cambios para corregir el bug...
# Agrega y realiza el commit
git add .
git commit -m "Fix: Corrige el bug X reportado en v1.0.0 (también presente en main)"
- Merge del Bug Fix al Tronco: El commit que contiene la solución del bug se integra de vuelta al tronco (
main). Esto se hace mediante el proceso habitual de TBD con SLB (usando un PR).
Comandos Git (Después de completar el PR en la plataforma):
# Sube la rama con el bug fix
git push -u origin bugfix/nombre-bug-en-produccion
# Crea un PR en la plataforma de 'bugfix/nombre-bug-en-produccion' a 'main'
# ... (Una vez aprobado y mergeado) ...
# Vuelve al tronco local y actalízalo
git checkout main
git pull origin main
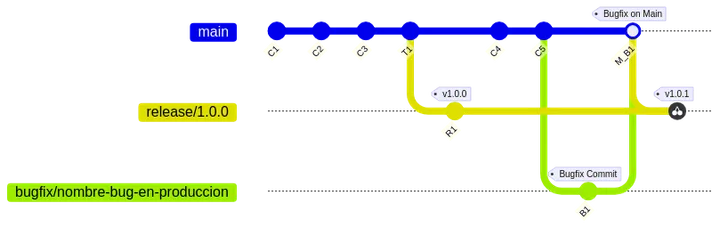
- Cherry Pick a la Rama de Release: Finalmente, se realiza un Cherry Pick del commit específico que contiene el bug fix (el commit
B1original o el merge commitM_B1, aunqueB1es más limpio para cherry-pick) desde el tronco (main) hacia la rama de la versión en producción (la ramarelease/1.0.0donde se encontró el bug).
Comandos Git:
# Identifica el hash del commit de bug fix en el tronco (ej: el commit B1 original o M_B1)
# Puedes usar 'git log main' para encontrarlo
# Vuelve a la rama de release
git checkout release/1.0.0
# Aplica el commit de bug fix desde el tronco a esta rama
# Reemplaza <commit-hash-del-bugfix> con el hash real
git cherry-pick <commit-hash-del-bugfix>
# Sube la rama de release actualizada al remoto
git push origin release/1.0.0

codigo mermaid
    gitGraph
        commit id: "C1"
        commit id: "C2"
        commit id: "C3"
        commit id: "T1"
        branch release/1.0.0
        checkout release/1.0.0
        commit id: "R1" tag: "v1.0.0"
        checkout main
        commit id: "C4"
        commit id: "C5"
        branch bugfix/nombre-bug-en-produccion
        checkout bugfix/nombre-bug-en-produccion
        commit id: "B1" tag: "Bugfix Commit"
        checkout main
        merge bugfix/nombre-bug-en-produccion id: "M_B1" tag: "Bugfix on Main"
        checkout release/1.0.0
        cherry-pick id:"M_B1" parent:"B1" tag:"v1.0.1"
Este proceso, aunque involucra más pasos (crear rama, merge al tronco, cherry pick a la rama de Release), garantiza que solo el bug fix se incorpore a la versión de producción. Es la forma de respetar el contrato del Trunk Based Development y asegurar que el tronco sigue siendo la fuente principal de verdad. El desarrollo normal de nuevas funcionalidades continúa siempre en nuevas ramas de vida corta creadas a partir del tronco. Google utiliza este enfoque: las soluciones de bugs para un release se desarrollan en la línea principal y luego se hace un cherry pick a la rama de release.
Escenario 2: El Bug NO Sigue Existiendo en el Tronco (Menos Sugerido)
Este escenario es menos común y no es el recomendado por los expertos en TBD. Ocurre si el bug ya fue corregido en el tronco por un commit que, sin embargo, incluye otras funcionalidades que no deben ir a la rama de Release actual, lo que impide crear la rama de bug fix desde el tronco.
Verificar el Bug y el Tronco: Se confirma que el bug no es replicable en el tronco, pero la solución en el tronco está ligada a otros cambios no deseados en la versión de producción. (Verificación manual/automatizada).
Crear Rama de Vida Corta desde la Rama de Release: En esta situación excepcional, se crea una rama de vida corta desde la rama de la versión en producción (la rama
release/1.0.0).
Comandos Git:
# Asegúrate de estar en la rama de release y actualizada
git checkout release/1.0.0
git pull origin release/1.0.0
# Crea la rama para el hotfix directamente desde la rama de release
git checkout -b hotfix/nombre-bug-solo-en-v1.0.0
- Solucionar el Bug: El bug se corrige en esta rama creada directamente desde la rama de Release.
Comandos Git:
# Realiza los cambios para corregir el bug...
# Agrega y realiza el commit
git add .
git commit -m "Hotfix: Corrige el bug Y específicamente en v1.0.0"
- Merge del Bug Fix a la Rama de Release: Se integra el bug fix de vuelta a la rama de la versión en producción (
release/1.0.0) mediante un merge (idealmente vía PR). La solución está ahora en la versión que la necesita.
Comandos Git (Después de completar el PR en la plataforma):
# Sube la rama con el hotfix
git push -u origin hotfix/nombre-bug-solo-en-v1.0.0
# Crea un PR en la plataforma de 'hotfix/nombre-bug-solo-en-v1.0.0' a 'release/1.0.0'
# ... (Una vez aprobado y mergeado) ...
# Vuelve a la rama de release local y actualízala
git checkout release/1.0.0
git pull origin release/1.0.0
# La rama hotfix/nombre-bug-solo-en-v1.0.0 ahora se eliminaría
- Merge de la Rama de Release al Tronco: Por último, se integra la rama de la versión en producción actualizada (
release/1.0.0) de vuelta al tronco (main). Esto es crucial para asegurar que la corrección hecha en la rama de Release también se refleje en el tronco, evitando la divergencia y que el mismo bug reaparezca en futuras versiones creadas desdemain.
Comandos Git:
# Asegúrate de estar en el tronco y actualizado
git checkout main
git pull origin main
# Fusiona la rama de release (ahora con el hotfix) en el tronco
git merge release/1.0.0
# Sube el tronco actualizado al remoto
git push origin main

codigo mermaid
    gitGraph
        commit id: "C1"
        commit id: "C2"
        commit id: "C3"
        commit id: "T1"
        branch release/1.0.0
        checkout release/1.0.0
        commit id: "R1" tag: "v1.0.0"
        checkout main
        commit id: "C4"
        commit id: "C5"
        checkout release/1.0.0
        branch bugfix/nombre-bug-en-produccion
        checkout bugfix/nombre-bug-en-produccion
        commit id: "B1" tag: "Bugfix Commit"
        checkout release/1.0.0
        merge bugfix/nombre-bug-en-produccion id:"M_B1" tag: "v1.0.1"
        checkout main
        cherry-pick id:"M_B1" parent:"B1"
Este escenario invierte el flujo habitual de los cambios. Una vez completado este proceso, el desarrollo continúa siempre en nuevas ramas de vida corta creadas desde el tronco.
Características Clave y Beneficios del TBD con SLB
El TBD con SLB se define por las siguientes características y aporta importantes beneficios:
- Ramas de Vida Corta: Las ramas de desarrollo duran muy poco, idealmente menos de 4 horas y un máximo de 3 días.
- Uso de Pull Requests: La integración de cambios al tronco se realiza exclusivamente a través de PRs, lo que trae consigo sus beneficios.
- Pruebas Automáticas Pre-Merge: Permite la ejecución de pruebas automatizadas antes de fusionar los cambios al tronco, lo que mejora significativamente la estabilidad del tronco al prevenir que lleguen commits con errores.
- Evita "Merge Hell": Al trabajar con ramas pequeñas e integrar cambios con mucha frecuencia, se minimizan los conflictos de merge dolorosos que son comunes con ramas de vida larga.
- Soporte para Versionamiento: Se gestionan versiones creando ramas de Release a partir del tronco.
- Escalabilidad: Es una variante escalable del TBD, siendo muy adecuada para equipos grandes con más de seis desarrolladores.
- Alineación con Prácticas de Grandes Empresas: Es una estrategia utilizada por compañías como Google, donde el desarrollo en ramas (excepto para releases) es inusual y las ramas de vida larga son extremadamente raras.
Conclusión
Implementar Trunk Based Development con Ramas de Vida Corta es una estrategia de versionamiento robusta, profesional y altamente escalable que se adapta bien a equipos de desarrollo grandes. Al basarse en la creación, el trabajo y la rápida fusión (vía PR y con pruebas pre-merge) de ramas muy pequeñas, esta metodología mantiene el tronco (master o main) en un estado más estable y listo para ser desplegado en cualquier momento. Aunque la gestión de bug fixes para versiones en producción requiere un proceso específico (preferiblemente el escenario 1, con Cherry Pick desde el tronco a la rama de Release), el flujo de trabajo general simplifica la integración continua, reduce drásticamente los conflictos de fusión (merge hell) y facilita un ritmo de desarrollo ágil y confiable. Su adopción por grandes empresas como Google subraya su eficacia y solidez como una práctica de versionamiento moderna y eficiente.
Relaciones en Bases de Datos NoSQL: ¿Embeber o Referenciar? Una Guía Técnica para la Toma de Decisiones
- Mauricio ECR
- Persistencia
- 27 Apr, 2025
El auge de las bases de datos NoSQL ha redefinido la manera en que abordamos el modelado de datos, ofreciendo flexibilidad y escalabilidad que a menudo superan las limitaciones de los modelos relacion

Relaciones en Bases de Datos NoSQL: ¿Embeber o Referenciar? Una Guía Técnica para la Toma de Decisiones
- Mauricio ECR
- Persistencia
- 27 Apr, 2025
El auge de las bases de datos NoSQL ha redefinido la manera en que abordamos el modelado de datos, ofreciendo flexibilidad y escalabilidad que a menudo superan las limitaciones de los modelos relacionales tradicionales. Sin embargo, esta libertad conlleva nuevas consideraciones, especialmente a la hora de definir las relaciones entre las entidades de nuestra aplicación. A diferencia de las claves foráneas y las uniones explícitas de las bases de datos SQL, en el mundo NoSQL (particularmente en las bases de datos orientadas a documentos), debemos decidir entre embeber documentos relacionados dentro de un documento principal o referenciar documentos a través de identificadores.
Esta decisión no es trivial y tiene un impacto profundo en el rendimiento, la escalabilidad, la consistencia y la complejidad de nuestra aplicación. Este artículo profundiza en los factores clave a considerar al tomar esta elección crítica, proporcionando una base sólida para arquitectos y desarrolladores de software que trabajan con bases de datos NoSQL.
Embeber Documentos: Consolidación para el Acceso Rápido
Embeber (embedding) implica anidar un documento dentro de otro. En este modelo, la información relacionada se almacena físicamente junta en un único documento.
Ventajas:
- Mejor rendimiento de lectura: Almacenar datos relacionados juntos permite recuperarlos en una sola operación de lectura, eliminando la necesidad de múltiples consultas o "joins" a nivel de aplicación o base de datos. Esto es ideal para escenarios donde los datos relacionados se acceden con mucha frecuencia junto con el documento principal.
- Operaciones atómicas: Las actualizaciones a los datos dentro de un único documento embebido suelen ser atómicas, lo que garantiza que las operaciones se completen por completo o no se realicen en absoluto, simplificando la lógica de manejo de concurrencia para esos datos específicos.
- Menor complejidad de consultas simples: Para patrones de acceso que siempre recuperan el documento principal y sus relacionados, la consulta es directa y sencilla.
Desventajas:
- Duplicación de datos: Si un documento embebido necesita aparecer en múltiples documentos principales, la información se duplicará, lo que puede llevar a inconsistencias si los datos embebidos cambian.
- Tamaño del documento: Embeber grandes cantidades de datos o datos que crecen sin límites puede aumentar significativamente el tamaño de los documentos. Esto puede impactar el rendimiento de lectura y escritura, y muchas bases de datos NoSQL tienen límites en el tamaño máximo de un documento (por ejemplo, 16 MB en MongoDB).
- Complejidad en actualizaciones frecuentes o parciales: Si los datos embebidos cambian con mucha frecuencia o si solo se necesita actualizar una pequeña parte de ellos, modificar el documento principal completo puede ser ineficiente.
- Dificultad para consultar datos embebidos de forma independiente: Consultar o agregar datos basándose únicamente en la información dentro de los documentos embebidos puede ser menos eficiente o más complejo que si estuvieran en una colección separada.
Referenciar Documentos: Flexibilidad y Normalización Controlada
Referenciar (referencing) implica almacenar documentos relacionados en colecciones separadas y utilizar identificadores (como el _id en MongoDB) en un documento para crear un enlace a otro. Este enfoque es más similar al concepto de claves foráneas en bases de datos relacionales.
Ventajas:
- Reduce la duplicación de datos: La información se almacena una sola vez en su propia colección, lo que simplifica la gestión de actualizaciones y reduce el riesgo de inconsistencia.
- Flexibilidad para consultar datos de forma independiente: Los documentos referenciados pueden ser consultados, actualizados y gestionados de forma independiente de los documentos que los referencian.
- Manejo eficiente de datos que crecen sin límites: Colecciones separadas son más adecuadas para almacenar grandes cantidades de datos o datos que se espera que crezcan considerablemente.
- Ideal para relaciones muchos-a-muchos: Las relaciones complejas donde múltiples documentos de una colección se relacionan con múltiples documentos de otra colección se manejan más naturalmente con referencias.
Desventajas:
- Mayor complejidad en la recuperación de datos relacionados: Para obtener el documento principal y sus relacionados, se requieren múltiples consultas (una para el documento principal y luego una o más para los documentos referenciados) o el uso de funcionalidades de "lookup" proporcionadas por la base de datos (si están disponibles), lo que puede aumentar la latencia de lectura.
- Falta de atomicidad en operaciones que involucran múltiples documentos: Las actualizaciones que afectan a datos en diferentes colecciones referenciadas no son atómicas por defecto, lo que requiere una lógica a nivel de aplicación o transacciones distribuidas (si la base de datos lo soporta) para garantizar la consistencia.
- Mayor complejidad en el modelo de datos para relaciones simples: Para relaciones uno-a-uno o uno-a-pocos, el modelo referenciado puede parecer más verboso que el modelo embebido.
Factores Clave para la Decisión
La elección entre embeber y referenciar depende en gran medida de los patrones de acceso a los datos y los requisitos de la aplicación. Aquí se detallan los factores más importantes a considerar:
Patrones de Acceso a Datos:
- Lectura intensiva y datos accedidos conjuntamente: Si los datos relacionados casi siempre se leen junto con el documento principal y las lecturas son mucho más frecuentes que las escrituras, embeber suele ofrecer un mejor rendimiento.
- Acceso independiente a datos relacionados: Si los datos relacionados se consultan o actualizan con frecuencia de forma independiente del documento principal, referenciar es la opción más eficiente.
- Necesidad de consultar y agregar datos relacionados por sí solos: Si se requiere realizar consultas o agregaciones complejas sobre los datos relacionados sin pasar por el documento principal, referenciar facilita estas operaciones.
Tamaño y Crecimiento de los Datos Relacionados:
- Datos relacionados pequeños y con crecimiento limitado: Embeber es viable si la cantidad de datos relacionados es pequeña y no se espera que crezca significativamente, manteniendo el tamaño total del documento dentro de límites razonables.
- Datos relacionados grandes o con crecimiento ilimitado: Referenciar es esencial cuando los datos relacionados pueden ser extensos (por ejemplo, una larga lista de comentarios o transacciones) para evitar exceder los límites de tamaño del documento y mantener un rendimiento de escritura eficiente.
Frecuencia y Naturaleza de las Actualizaciones:
- Actualizaciones frecuentes de datos embebidos: Si los datos que se considerarían para ser embebidos cambian muy a menudo, referenciar es preferible para evitar la sobrecarga de actualizar el documento principal constantemente.
- Actualizaciones atómicas requeridas para datos relacionados: Si un conjunto de datos relacionados debe actualizarse de manera atómica junto con el documento principal, embeber simplifica la implementación.
- Actualizaciones independientes de diferentes partes de los datos relacionados: Si distintos elementos dentro de los datos relacionados se actualizan de forma independiente y frecuente, referenciar permite actualizaciones más localizadas y eficientes.
Consistencia de los Datos:
- Alta prioridad en la consistencia global de los datos relacionados: Referenciar reduce la duplicación y simplifica la garantía de que las actualizaciones a los datos se reflejen consistentemente en toda la base de datos.
- Consistencia eventual aceptable para datos embebidos: Si una ligera inconsistencia temporal es tolerable para los datos embebidos (por ejemplo, la información duplicada tarda un corto tiempo en sincronizarse si cambia el original referenciado en otro lugar), embeber puede ser aceptable.
Complejidad del Esquema y las Relaciones:
- Relaciones uno-a-uno y uno-a-pocos contenidas: Embeber a menudo resulta en un esquema más simple y consultas directas para estas relaciones, especialmente cuando los "pocos" son realmente pocos y su crecimiento es limitado.
- Relaciones uno-a-muchos y muchos-a-muchos: Referenciar es generalmente la opción más escalable y manejable para estas relaciones, evitando documentos excesivamente grandes o la complejidad de manejar listas potencialmente ilimitadas dentro de un documento.
Consideraciones Específicas de la Base de Datos NoSQL:
- Aunque los principios generales son aplicables, las características específicas de la base de datos NoSQL utilizada (MongoDB, Cassandra, Couchbase, etc.) pueden influir en la decisión. Por ejemplo, las capacidades de "lookup" o las limitaciones de tamaño de documento varían entre bases de datos.
Un Enfoque Híbrido
Es importante destacar que no siempre es una elección binaria entre embeber o referenciar. En muchos casos, un enfoque híbrido puede ser la solución óptima. Esto implica embeber los datos relacionados que se acceden con mucha frecuencia y que tienen un tamaño limitado, mientras se referencian otros datos relacionados que son más grandes, cambian con frecuencia o se consultan de forma independiente.
Por ejemplo, en un documento de "pedido", se podría embeber una lista de "ítems del pedido" (si la lista no es excesivamente larga y se accede siempre con el pedido), pero referenciar el documento de "cliente" y los documentos de "productos" para evitar duplicar información del cliente o los detalles completos de cada producto en cada pedido.
Conclusión
La decisión de si embeber o referenciar datos en una base de datos NoSQL es un pilar fundamental en el diseño de esquemas eficientes y escalables. No existe una regla única para todos los casos; la elección debe basarse en una comprensión profunda de los patrones de acceso a datos de la aplicación, los requisitos de rendimiento, las expectativas de crecimiento de los datos y las características específicas de la base de datos NoSQL empleada.
Embeber favorece el rendimiento de lectura y la atomicidad para datos accedidos conjuntamente y de tamaño limitado. Referenciar ofrece flexibilidad, reduce la duplicación y es más adecuado para datos grandes, de crecimiento ilimitado, que cambian con frecuencia o que participan en relaciones complejas. Un enfoque híbrido a menudo permite capitalizar las ventajas de ambos modelos.
Una evaluación cuidadosa de los factores discutidos y la posibilidad de realizar pruebas de rendimiento con diferentes modelos de datos son pasos cruciales para asegurar que el diseño de la base de datos NoSQL soporte eficazmente las necesidades actuales y futuras de la aplicación. La continua monitorización y adaptación del esquema a medida que evolucionan los patrones de uso también son prácticas recomendadas en el dinámico entorno NoSQL.
A continuación, se presenta un diagrama de decisión simplificado para visualizar el proceso de elección entre embeber y referenciar:

codigo mermaid
    graph TD
        A[Iniciar: Modelando Relaciones NoSQL] --> B{Datos relacionados accedidos
principalmente con el padre?}
        B -->|Sí| C{Datos relacionados pequeños
y con crecimiento limitado?}
        C -->|Sí| D{Actualizaciones frecuentes
de datos relacionados?}
        D -->|No| E[Embeber]
        D -->|Sí| F{Consistencia global alta prioridad?}
        F -->|Sí| G[Referenciar]
        F -->|No| E
        C -->|No| H{Datos relacionados grandes
o crecimiento ilimitado?}
        H -->|Sí| G
        H -->|No| I{Relación muchos-a-muchos?}
        I -->|Sí| G
        I -->|No| J{Necesidad de consultar/actualizar
datos relacionados independientemente?}
        J -->|Sí| G
        J -->|No| E
        B -->|No| K{Datos relacionados consultados/actualizados
frecuentemente de forma independiente?}
        K -->|Sí| G
        K -->|No| I
        E --> L[Implementar modelo embebido]
        G --> M[Implementar modelo referenciado]
        L --> N[Fin]
        M --> N[Fin]
RabbitMQ 4: Robustez y Seguridad en RabbitMQ
- Mauricio ECR
- Arquitectura
- 27 Apr, 2025
Hemos recorrido el camino desde la introducción a RabbitMQ y su papel en la mensajería asíncrona, pasando por su arquitectura, componentes de enrutamiento (Exchanges y Bindings), y la gestión detallad

RabbitMQ 4: Robustez y Seguridad en RabbitMQ
- Mauricio ECR
- Arquitectura
- 27 Apr, 2025
Hemos recorrido el camino desde la introducción a RabbitMQ y su papel en la mensajería asíncrona, pasando por su arquitectura, componentes de enrutamiento (Exchanges y Bindings), y la gestión detallada de las Colas. Ahora es momento de abordar cómo hacer que nuestro sistema de mensajería sea verdaderamente robusto y seguro.
La robustez implica asegurar que los mensajes no se pierdan y que el broker pueda manejar situaciones de estrés. La seguridad es fundamental para proteger tus datos y recursos. Este artículo profundiza en la retención de mensajes, cómo gestionar la contrapresión (cuando los productores envían mensajes más rápido de lo que los consumidores pueden procesar) y los aspectos clave de la seguridad.
Retención de Mensajes en RabbitMQ
La retención de mensajes se refiere a cuánto tiempo y bajo qué condiciones un mensaje permanece en RabbitMQ antes de ser entregado o, potencialmente, descartado. Esto depende de una combinación de factores:
Comportamiento de Mensajes Persistentes vs No Persistentes
La persistencia de los mensajes se define en el momento en que el productor los publica, marcándolos como persistentes. Esto indica al broker que debe intentar escribir esos mensajes en disco tan pronto como llegan a una cola. Por el contrario, los mensajes que no se marcan como persistentes permanecen únicamente en memoria, siendo más vulnerables a pérdidas en caso de fallos.
En escenarios como el reinicio del broker, solo los mensajes persistentes almacenados en colas duraderas sobrevivirán; los mensajes no persistentes —incluso si estaban en colas duraderas— y todos los mensajes en colas no duraderas se perderán.
En el caso de fallos de consumidores, si un consumidor falla antes de confirmar (ACK) un mensaje, este puede ser re-enviado. Sin embargo, su estado de persistencia no cambia: sigue siendo el mismo con el que fue originalmente publicado. En estas situaciones, la confiabilidad en la reentrega depende principalmente de la durabilidad de la cola y del correcto manejo de los ACKs
Durabilidad de Colas y su Impacto en la Retención
La durabilidad de la cola (establecida mediante la propiedad durable=true) es independiente de la persistencia de los mensajes, aunque ambas características trabajan en conjunto para garantizar la retención de información a largo plazo. Una cola duradera asegura que su definición no se pierda incluso si el broker se reinicia. Sin embargo, para que un mensaje específico sobreviva a un reinicio, no basta con que la cola sea duradera: el propio mensaje también debe marcarse como persistente. Si cualquiera de estas condiciones falta —ya sea que la cola no sea duradera o el mensaje no sea persistente—, el mensaje se perderá tras el reinicio del broke
Time-To-Live (TTL) de Mensajes y Colas
El tiempo de vida de los mensajes puede controlarse de diferentes maneras. La propiedad x-message-ttl permite definir un tiempo de vida (TTL) predeterminado para todos los mensajes de una cola, asegurando que cualquier mensaje que exceda ese tiempo sea descartado automáticamente. Además, es posible establecer un TTL individual al momento de publicar un mensaje; en caso de que tanto el mensaje como la cola tengan valores TTL definidos, se aplicará siempre el menor de los dos. Por otro lado, la propiedad x-expires determina cuánto tiempo puede permanecer una cola sin actividad antes de ser eliminada automáticamente por el broker.
Dead-Letter Exchanges (DLX) y Dead-Letter Queues (DLQ)
los mensajes que expiran, los que son rechazados sin reenvío (requeue=false) o los descartados debido al desbordamiento de una cola pueden ser redirigidos a una Dead-Letter Exchange (DLX). Esta funcionalidad permite capturar mensajes no procesados para realizar análisis de errores y, si es necesario, reenviarlos o reprocesarlos posteriormente.
Problemas de Contrapresión (Backpressure)
La contrapresión ocurre cuando el ritmo de llegada de mensajes a una cola excede consistentemente el ritmo al que los consumidores pueden procesarlos. Si no se maneja, esto puede llevar a que las colas crezcan sin control, consuman la memoria y el disco del broker, y eventualmente afecten el rendimiento o incluso hagan que el broker colapse. RabbitMQ tiene varios mecanismos incorporados para manejar la contrapresión:
Mecanismos de Contrapresión en RabbitMQ:
- Límites de Prefetch (QoS): Vimos en el artículo anterior que QoS limita cuántos mensajes no confirmados puede tener un consumidor a la vez. Al establecer un prefetch bajo (ej. 10-100), evitas que un consumidor "acapare" mensajes, permitiendo una mejor distribución entre múltiples consumidores y limitando cuántos mensajes pendientes de ACK existen en tránsito. Si los consumidores son lentos, un prefetch bajo hace que RabbitMQ deje de enviarles mensajes, forzando a los mensajes a esperar en la cola.
- Límites de Longitud de Cola: Limitan explícitamente el tamaño de la cola. Cuando se alcanza el límite, la política de desbordamiento (x-overflow) entra en juego (drop-head descarta los mensajes más viejos, reject-publish detiene a los productores). Esto protege al broker de quedarse sin recursos, pero puede resultar en pérdida de mensajes si se usa drop-head y los mensajes no se consumen a tiempo.
- Políticas de Almacenamiento: RabbitMQ puede paginar mensajes fuera de la memoria al disco si la cola crece mucho, para liberar RAM. Esto añade latencia al acceder a esos mensajes, pero previene fallos por falta de memoria. Puedes configurar umbrales de memoria para activar la paginación.
- Control de Flujo TCP: A un nivel más bajo, si el broker detecta que no puede escribir datos salientes tan rápido como llegan los entrantes (ej. porque los consumidores no están recibiendo mensajes lo suficientemente rápido), puede activar el control de flujo a nivel de conexión TCP con los productores. Esto pausa temporalmente a los productores, forzándolos a esperar antes de enviar más mensajes. Este es el mecanismo de última instancia para proteger al broker de ser abrumado.
Estrategias para Diseñar Sistemas Resilientes:
- Monitorización: Monitorea activamente la longitud de las colas, el uso de memoria/disco del broker, y la tasa de entrega/ACKs de los consumidores. Esto te alerta antes de que la situación se vuelva crítica.
- Dimensionamiento Adecuado: Asegúrate de que tu broker y tus consumidores tengan suficientes recursos (CPU, RAM, disco) para manejar la carga esperada y picos.
- Escalabilidad de Consumidores: La forma principal de mitigar la contrapresión es escalar el número de consumidores para igualar o superar la tasa de llegada de mensajes. Asegúrate de que sea fácil desplegar más instancias de tus consumidores.
- Diseño Idempotente y Robusto:Consumidores que fallan a menudo o son lentos contribuyen a la contrapresión. Diseña consumidores eficientes y que puedan manejar fallos sin colapsar.
- Uso Cauteloso de Mensajes Persistentes: Los mensajes persistentes requieren escrituras a disco, lo que es más lento que escribir en memoria y puede limitar el throughput máximo si la carga es muy alta y el disco lento. Úsalos solo donde la pérdida de mensajes sea inaceptable.
- Límites de Cola y DLX: Decide qué es preferible: descartar mensajes viejos (drop-head) o detener a los productores (reject-publish) cuando la cola se llena. En muchos casos, usar drop-head junto con un DLX para capturar los mensajes descartados es una buena estrategia para auditar la pérdida sin detener a todo el sistema.
Seguridad en RabbitMQ en Detalle
Asegurar tu broker de mensajes es tan importante como asegurar tus bases de datos o APIs. Un broker comprometido puede ser utilizado para interceptar datos sensibles, inyectar mensajes maliciosos o interrumpir el servicio.
Autenticación de Usuarios y Hosts: RabbitMQ admite múltiples mecanismos de autenticación para verificar la identidad de las aplicaciones que intentan conectarse. El método más común es la autenticación basada en usuario y contraseña, donde RabbitMQ almacena las credenciales de forma segura (hashed) y las valida al momento de la conexión. Además, ofrece soporte para esquemas de autenticación más avanzados mediante Pluggable Authentication, permitiendo integrar mecanismos como LDAP, certificados X.509 (TLS) u OAuth 2.0 a través de plugins. También es posible configurar restricciones a nivel de red, limitando las conexiones únicamente a hosts específicos para reforzar la seguridad.
Autorización y Control de Acceso: Una vez que un usuario se autentica, necesita contar con los permisos adecuados para realizar operaciones dentro de un vhost. Los permisos se asignan específicamente a nivel de vhost, lo que significa que un mismo usuario puede tener distintos permisos en diferentes vhosts. Dentro de cada vhost, los permisos se otorgan sobre tres tipos de operaciones principales: Configure, que permite crear o eliminar exchanges y colas; Write, que permite publicar mensajes en exchanges; y Read, que permite consumir mensajes de colas. Es una buena práctica de seguridad aplicar el Principio del Mínimo Privilegio, creando usuarios separados para cada aplicación o servicio y otorgándoles únicamente los permisos estrictamente necesarios. Por ejemplo, un productor solo debería tener permisos de escritura (write) sobre determinados exchanges, mientras que un consumidor únicamente debería tener permisos de lectura (read) sobre las colas pertinentes.
Comunicación Segura con TLS/SSL: Por defecto, la comunicación entre los clientes y el broker de RabbitMQ no está cifrada, lo que representa un riesgo de seguridad si los mensajes contienen información sensible o si la red no es confiable. Para mitigar este riesgo, RabbitMQ soporta TLS/SSL, que permite cifrar las conexiones TCP entre clientes y el broker. La configuración de TLS implica obtener o generar certificados SSL/TLS tanto para el broker como, opcionalmente, para la autenticación del cliente, configurar el listener de RabbitMQ para aceptar conexiones TLS y ajustar los clientes para que utilicen TLS y validen el certificado del broker. Como mejor práctica, se recomienda utilizar TLS para todas las conexiones en entornos de producción, validar los certificados del broker desde el cliente y considerar la autenticación mutua, donde el cliente también presenta un certificado, para agregar una capa extra de seguridad.
Consideraciones de Seguridad en Entornos de Red: En cuanto a las consideraciones de seguridad en entornos de red para RabbitMQ, es fundamental tomar medidas para proteger el acceso al broker. Uno de los aspectos clave es configurar firewalls, restringiendo el acceso a los puertos predeterminados de RabbitMQ (5672 para AMQP sin cifrar, 5671 para AMQP con TLS y 15672 para la interfaz de administración web) solo a los servidores y redes que realmente lo necesiten. Además, se recomienda ejecutar RabbitMQ dentro de redes privadas o VPNs, lo que reduce su exposición a la red pública de Internet y mejora la seguridad. Por último, si gestionas múltiples aplicaciones, es aconsejable emplear segmentación lógica mediante el uso de diferentes vhosts y usuarios con permisos específicos, lo que facilita el aislamiento de los recursos y minimiza el riesgo de accesos no autorizados.
Auditoría y Registro de Eventos de Seguridad: En cuanto a la auditoría y registro de eventos de seguridad, RabbitMQ permite configurar el registro de eventos importantes, como conexiones, intentos de autenticación fallidos, operaciones de declaración o eliminación de recursos, entre otros. Estos registros son fundamentales para monitorear la seguridad del sistema, detectar actividades sospechosas y llevar a cabo auditorías para identificar quién realizó qué acciones dentro del entorno.
Implementar una estrategia de seguridad sólida es un paso no negociable antes de desplegar RabbitMQ en un entorno de producción.
Conclusión
Este artículo nos ha equipado con conocimientos esenciales para construir y operar sistemas de mensajería confiables y seguros con RabbitMQ. Hemos explorado a fondo cómo se retienen los mensajes, combinando la persistencia de mensajes con la durabilidad de colas, y cómo los mecanismos como TTL y DLX/DLQ nos permiten gestionar el ciclo de vida de los mensajes y manejar fallos de manera elegante.
Abordamos el desafío de la contrapresión, entendiendo los mecanismos de defensa de RabbitMQ (prefetch, límites de cola, control de flujo) y las estrategias de diseño para construir sistemas escalables que puedan absorber picos de carga sin colapsar o perder datos indiscriminadamente.
Finalmente, destacamos la importancia crítica de la seguridad, cubriendo la autenticación y autorización de usuarios, la protección de las comunicaciones con TLS/SSL y consideraciones de seguridad en la red.
Con una comprensión sólida de la arquitectura, la gestión de colas, la robustez y la seguridad, estás bien preparado para diseñar e implementar soluciones de mensajería con RabbitMQ. El próximo paso lógico en esta serie es ver todos estos conceptos en acción a través de un ejemplo práctico en código.