Tags (73)
- Agile
- Alta disponibilidad
- Alternativas cloud
- Aop
- Arquitectura
- Arquitectura distribuida
- Automatizacion
- Aws
- Azure devops
- Base de datos
- Buenas practicas
- Cloud
- Colas
- Competing consumers
- Convenciones
- Copilot
- Diseno
- Docker
- Docker compose
- Documentacion
- Eda
- Equipos
- Escalabilidad
- Flujo de negocio
- Flujo de trabajo
- Flyway
- Git
- Gradle
- Herramientas digitales
- Ia
- Iam
- Infraestructura
- Java
- Jerarquia tecnica
- Jpa
- Jsonb
- Kafka
- Kubernetes
- Liderazgo en software
- Lineamientos
- Log
- Logging
- Microservicios
- Mongodb
- Monitoreo
- Nosql
- Observabilidad
- Open source
- Plugins
- Postgresql
- Privacidad
- Programacion funcional
- Programacion reactiva
- Rabbitmq
- Rotacion de talento
- Saga
- Scrum
- Security
- Seguridad
- Self hosting
- Sistemas legados
- Snippets
- Spring boot
- Spring mvc
- Sql
- Streams
- Threadlocal
- Trazabilidad
- Versionado
- Web
- Webflux
- Websockets
- Zero trust
Cuando el sistema nuevo tiene que hablarle al sistema viejo en su idioma
- Mauricio ECR
- Arquitectura
- 31 May, 2026
Imagina que llevas meses construyendo un sistema moderno sobre PostgreSQL, desplegado en contenedores sobre una infraestructura en la nube. Los datos están bien estructurados, las relaciones son clara

Cuando el sistema nuevo tiene que hablarle al sistema viejo en su idioma
- Mauricio ECR
- Arquitectura
- 31 May, 2026
Imagina que llevas meses construyendo un sistema moderno sobre PostgreSQL, desplegado en contenedores sobre una infraestructura en la nube. Los datos están bien estructurados, las relaciones son claras, las consultas son rápidas. Un día descubres que el sistema con el que tienes que integrarte no sabe lo que es una API. Su protocolo de integración es un archivo CSV que aparece en una carpeta a las 2 de la mañana. Si el archivo llega, el sistema funciona. Si no llega, el negocio se detiene.
No es un escenario hipotético. Es la realidad operativa de una cantidad enorme de empresas que modernizaron una parte de su infraestructura sin poder modernizar todo al mismo tiempo. El sistema legado sigue ahí, inamovible, consumiendo archivos como siempre lo hizo, y el sistema nuevo tiene que aprender a hablarle en ese idioma.
La pregunta que surge de inmediato parece simple: ¿cómo tomas los datos que viven en tu base de datos y los conviertes en un archivo CSV que llega a S3 de forma confiable? Pero debajo de esa pregunta hay varias más que definen la complejidad real del problema, y entenderlas bien es lo que separa una integración sólida de una que falla en silencio cuando más importa.
El problema que se esconde detrás del problema
La primera reacción cuando te enfrentas a este reto suele ser optimista. Tienes los datos en la base de datos, sabes el formato que necesita el sistema legado, y S3 es solo una carpeta en la nube. La solución parece obvia: consultas los registros, los transformas y los subes. Tres pasos. Una tarde de trabajo.
Esa imagen se complica en cuanto empiezas a hacerte las preguntas correctas.
¿Cómo sabes qué registros procesar en cada ciclo? El proceso corre periódicamente y cada ejecución debe tomar exactamente los registros que le corresponden, sin repetir los del ciclo anterior ni perderse ninguno del actual. Necesitas algún mecanismo para rastrear qué ya se procesó y qué no. Luego está la pregunta de dónde viven realmente los datos que necesitas exportar: raramente en una sola tabla. Generalmente hay información distribuida en varias tablas relacionadas que hay que unir, transformar y formatear según la estructura exacta que el sistema legado espera, y esa transformación tiene un costo que no siempre es trivial. La más incómoda llega al final: ¿qué pasa si algo sale mal a mitad del proceso? ¿Los registros quedan marcados como procesados aunque el archivo nunca haya llegado a S3? ¿O el archivo llega pero la base de datos queda inconsistente porque el proceso murió antes de confirmar? ¿Y si el volumen crece y un solo proceso ya no alcanza a terminar a tiempo?
Cada una de esas preguntas revela una decisión de arquitectura que no puedes ignorar. Y hay una más que puede o no aplicar a tu caso: ¿el sistema legado espera un solo archivo por ciclo o varios, cada uno con un formato distinto? Si tu integración es simple y homogénea, la respuesta es uno. Pero si los datos que exportas representan entidades distintas con estructuras distintas, el sistema legado puede esperar un archivo por cada tipo. Vale la pena saberlo desde el principio, porque esa variable aparece en ambos enfoques y cambia algunas decisiones de implementación.
El flujo a grandes rasgos
Antes de entrar en los detalles, vale la pena tener clara la imagen completa de lo que estamos construyendo, porque esa imagen es la que le da sentido a cada decisión que viene después.
El sistema legado espera sus archivos a una hora determinada. No los solicita, no los consulta, no tiene una API a la que llamar: simplemente los recoge de una ubicación conocida en el momento que tiene programado. Eso impone una restricción que define toda la arquitectura: el proceso de exportación tiene que ejecutarse de forma programada, en un horario fijo, con suficiente anticipación para que los archivos estén listos cuando el sistema legado los busque.
El flujo general es el siguiente: a la hora programada se activa un proceso que extrae los registros pendientes de la base de datos, los transforma siguiendo el formato exacto que el sistema legado espera, genera los archivos CSV correspondientes y los deposita en S3. A partir de ahí el sistema legado toma esos archivos y los incorpora a su propio flujo de procesamiento.
Hora programada
     ↓
Proceso extrae registros pendientes de PostgreSQL
     ↓
Transforma y formatea según plantilla del sistema legado
     ↓
Deposita archivos CSV en S3
     ↓
Sistema legado recoge los archivos y los procesa
Simple en apariencia. Pero garantizar que ese flujo sea confiable, que cada registro se procese exactamente una vez y que los archivos lleguen siempre en un estado consistente, es donde está el verdadero reto.
Dos caminos, un mismo destino
Para resolver este problema existen dos enfoques que cubren la mayoría de los escenarios reales. Cuál usar depende principalmente del volumen de datos, de si el procesamiento por registro requiere lógica fuera de la base de datos y de qué tan detallada necesitas que sea la trazabilidad cuando algo falla.
El primero delega casi todo el trabajo a la base de datos. PostgreSQL tiene una instrucción llamada COPY TO STDOUT que puede leer registros, aplicar transformaciones y devolver el resultado en formato CSV directamente al proceso que hizo la consulta, todo en una sola operación. Es elegante, directo y eficiente cuando el dataset es acotado y predecible, y cuando un solo proceso tiene el tiempo y la memoria suficientes para manejarlo completo.
El segundo reconoce que hay situaciones donde esa elegancia no alcanza. Cuando el volumen es grande, cuando cada registro requiere procesamiento costoso fuera de la base de datos, o cuando un fallo no puede tirar todo el trabajo sino solo la parte afectada, necesitas un patrón más sofisticado: múltiples procesos trabajando en paralelo, cada uno tomando lotes pequeños, coordinándose a través de la misma base de datos y contribuyendo su parte a un archivo final que S3 ensambla mediante su mecanismo de carga en partes. Este mecanismo, sin embargo, exige que cada fragmento que se sube pese al menos 5MB, lo que convierte ese umbral en una condición técnica que determina si este enfoque es viable o no.
Ninguno de los dos es mejor en abstracto. La elección depende de tu escenario concreto, y para que esa decisión sea más fácil de tomar, aquí está el comparativo completo:
| Característica | Enfoque A: COPY TO STDOUT | Enfoque B: Procesos en paralelo |
|---|---|---|
| Volumen de datos | Acotado y predecible | Grande o impredecible |
| Tamaño del CSV por ciclo | Menor a 5MB | Mayor a 5MB |
| Procesamiento por registro | Vive en SQL | Requiere lógica fuera de la DB |
| Número de procesos | Un solo proceso | Múltiples procesos en paralelo |
| Trazabilidad por registro | No requerida | Requerida |
| Errores parciales | No se toleran | Se toleran y gestionan |
| Reintentos individuales | Reintentos individuales | No necesarios |
| Tipos de archivo | Pocos y fijos | Dinámicos según los datos |
| Escalabilidad futura | No se contempla | Se contempla o es necesaria |
Con la decisión tomada, entremos en los detalles de cada uno.
Enfoque A: dejar que la base de datos haga el trabajo pesado
Hay algo intuitivamente correcto en la idea de que quien tiene los datos es quien mejor puede procesarlos. PostgreSQL no es solo un lugar donde guardar información: es un motor de procesamiento con capacidades que muchos equipos subutilizan, y COPY TO STDOUT es una de esas capacidades.
Cuando ejecutas COPY TO STDOUT con una consulta SQL, PostgreSQL lee los registros, aplica las transformaciones que definas, los marca como procesados dentro de la misma operación y devuelve el resultado en formato CSV directamente al proceso a través de la conexión. El proceso que recibe ese stream solo tiene que subirlo a S3. El trabajo pesado de transformación y formateo ocurre dentro de la base de datos, no en el proceso que la llama.
Al recibir el resultado en un único stream, el archivo completo se sube a S3 en un solo envío sin restricciones de tamaño mínimo. Este enfoque es especialmente adecuado cuando el CSV resultante del ciclo no supera los 5MB, lo que en la práctica cubre la gran mayoría de integraciones con volúmenes diarios moderados. A partir de ese umbral, las opciones de consolidación disponibles cambian y vale la pena evaluar si este enfoque sigue siendo el más apropiado.
Una preparación que vale la pena
Antes de ejecutar esa consulta, hay una decisión de diseño que puede marcar la diferencia entre un proceso ágil y uno que pone la base de datos bajo presión innecesaria. Los registros que necesitas exportar raramente viven en una sola tabla con el formato exacto que necesita el CSV. Generalmente hay que unir varias tablas, transformar algunos campos y ordenar las columnas de cierta manera. Hacer toda esa lógica en el momento de la exportación, sobre todos los registros de un ciclo, puede ser costoso cuando el volumen es considerable.
La alternativa es preparar el terreno antes: mantener una tabla auxiliar cuya estructura sea idéntica al CSV destino. La lógica de transformación ocurre cuando los datos llegan al sistema, no cuando salen. Si el sistema que alimenta la base de datos puede escribir directamente en esa tabla con el formato correcto, perfecto. Si no puede, un disparador en PostgreSQL puede hacer esa transformación automáticamente cada vez que se inserta un registro nuevo, sin que el proceso de exportación tenga que preocuparse por eso.
En cualquier caso el resultado es el mismo: en el momento de exportar tienes una tabla limpia y lista donde la consulta del COPY TO STDOUT es un SELECT simple sin transformaciones costosas. Para este enfoque esa tabla no es una recomendación opcional: es prácticamente un requisito. Una consulta compleja sobre decenas de miles de registros con múltiples uniones puede tardar lo suficiente como para alcanzar los límites de tiempo de la conexión, y el impacto sobre la base de datos durante esa operación puede afectar otros procesos que corren al mismo tiempo.
El flujo completo
Con la tabla de exportación lista, el proceso arranca consultando qué tipos de registros existen con trabajo pendiente. Si solo se tiene un tipo de formato de CSV, este paso es trivial: siempre hay un único archivo que generar. Si tienes varios, cada tipo corresponde a una plantilla distinta y puede haber uno o varios archivos por ciclo. En cualquier caso el proceso abre una transacción por cada tipo, ejecuta el COPY TO STDOUT que lee los registros y los marca como procesados en la misma operación, recibe el stream CSV completo, lo sube a S3 y confirma la transacción si S3 respondió con éxito. Si S3 falla, hace rollback y ese tipo queda pendiente para el siguiente ciclo.
Proceso arranca
     ↓
Consulta qué tipos tienen registros pendientes
     ↓
Por cada tipo:
     Abre transacción
          ↓
     COPY TO STDOUT:
     SELECT sobre tabla de exportación
     + marca registros como procesados
     + devuelve CSV listo
          ↓
     Sube CSV a S3
          ↓
     S3 exitoso → confirma transacción ✅
     S3 falla   → rollback → registros vuelven a pendiente 🔄
Aquí aparece una decisión de diseño que vale la pena tomar conscientemente antes de implementar: ¿el fallo de un tipo debe afectar a los demás o cada uno es independiente?
Cuando cada tipo vive su propia historia
Si los tipos son independientes entre sí, cada uno tiene su propia transacción. El sistema legado puede recibir los archivos de los tipos que funcionaron mientras el tipo fallido se reintenta en el siguiente ciclo. Es la opción más resiliente y la más simple de implementar porque los fallos están contenidos: un problema con un tipo no contamina a los demás.
Tipo A → transacción propia → éxito ✅
Tipo B → transacción propia → falla → rollback → pendiente 🔄
Tipo C → transacción propia → éxito ✅
El siguiente ciclo solo tiene trabajo pendiente del Tipo B. Los demás ya están procesados y no se vuelven a tocar.
Cuando todos los tipos son parte de un todo
Hay casos donde el sistema legado espera todos los archivos juntos o ninguno. Recibir una parte y no la otra puede generar inconsistencias en el proceso de negocio del otro lado. En esos casos necesitas que la subida a S3 sea atómica: o llegan todos los archivos o no llega ninguno.
S3 no ofrece esa atomicidad de forma nativa para múltiples archivos independientes. Pero hay una forma de conseguirla: comprimir todos los CSVs en un único archivo y hacer un solo envío a S3. O el archivo comprimido llega completo o no llega nada. No hay estado intermedio posible.
Abre una sola transacción
     ↓
Por cada tipo ejecuta COPY TO STDOUT
y acumula los CSVs en memoria
     ↓
Comprime todos los CSVs en un único archivo
     ↓
Un solo envío a S3
     ↓
Éxito  → confirma transacción ✅
Falla  → rollback → todos los registros vuelven a pendiente 🔄
Esta variante tiene un requisito adicional del lado del sistema legado: necesita poder descomprimir el archivo antes de procesarlo. Si el sistema legado no tiene esa capacidad —y muchos no la tienen precisamente porque son legados— la solución es una función Lambda en S3 que se dispara automáticamente cuando llega el archivo comprimido, lo descomprime y deja los CSVs individuales en la ubicación que el sistema legado espera. El sistema legado nunca sabe que hubo un archivo comprimido de por medio.
Lo que necesitas para implementarlo
Para que este enfoque funcione, la tabla de exportación debe tener al menos dos elementos además de las columnas del CSV: un campo de estado que indique si el registro está pendiente o ya fue procesado, y la estructura debe estar alimentada por el sistema origen o por un disparador según la capacidad disponible.
| Elemento | Detalle |
|---|---|
| Tabla de exportación | Estructura idéntica al CSV destino, con campo de estado |
| Campo de estado | PENDING, COMPLETED |
| Alimentación | Sistema origen o disparador en PostgreSQL |
| Lambda en S3 | Solo para la variante de tipos dependientes |
Enfoque B: cuando el trabajo es demasiado para uno solo
Hay un punto en el crecimiento de cualquier sistema donde un solo proceso ya no es suficiente. El volumen supera lo que puede procesarse en el tiempo disponible, o simplemente la infraestructura escala horizontalmente y levantar múltiples instancias del mismo proceso es la forma natural de responder a la demanda. Pero este enfoque tiene dos condiciones que deben cumplirse para que tenga sentido aplicarlo.
La primera es que haya procesamiento real y costoso por registro fuera de la base de datos: llamadas a APIs externas, validaciones complejas en código o transformaciones que no pueden vivir en SQL. Si todo el procesamiento puede ocurrir en la base de datos, el Enfoque A resuelve el problema con mucha menos complejidad.
La segunda es que el volumen de datos por ciclo supere los 5MB. Este número no es arbitrario: es el tamaño mínimo que S3 exige por cada parte en su mecanismo de carga en partes, que es el que permite consolidar el trabajo de múltiples pods en un único archivo final. Por debajo de ese umbral, el mecanismo de consolidación no es aplicable y el Enfoque A sigue siendo la opción correcta.
Si ambas condiciones se cumplen, este enfoque ofrece algo que el Enfoque A no puede dar: escala horizontal, trazabilidad por registro y manejo de errores individuales sin detener el ciclo completo.
El problema central: coordinación y consolidación
Cuando múltiples pods consultan la base de datos al mismo tiempo y encuentran los mismos registros pendientes, ambos intentarán procesarlos y terminarás con duplicados. Evitar eso sin introducir un componente externo de coordinación es precisamente lo que hace interesante este enfoque.
La solución para la coordinación está en PostgreSQL mismo. La instrucción SELECT FOR UPDATE SKIP LOCKED permite que un pod tome un conjunto de registros y los bloquee de forma que otros pods que ejecuten la misma consulta simplemente los salten y tomen registros distintos. El bloqueo dura solo el tiempo necesario para que el pod reclame esos registros como suyos, no durante todo el procesamiento. Así múltiples pods pueden trabajar en paralelo sobre el mismo conjunto de datos sin coordinación externa y sin duplicados.
El segundo problema es la consolidación: ¿cómo unen su trabajo múltiples pods en un único archivo final? La respuesta está en una tabla temporal en la misma base de datos. Cada pod, al terminar de procesar un registro, deposita la línea CSV ya formateada junto con su peso en bytes en esa tabla. Cualquier pod puede consultar el peso acumulado en esa tabla y cuando detecta que hay suficiente para una parte válida de 5MB, toma esas líneas y las sube al mecanismo de carga en partes de S3. El peso pre-calculado en bytes permite saber con precisión cuándo se tiene suficiente para una parte válida sin estimaciones ni aproximaciones.
La sesión como punto de coordinación
Para que múltiples pods trabajen sobre el mismo conjunto de registros de forma ordenada, necesitan compartir cierta información: qué registros les corresponde procesar en este ciclo y a qué carga en partes de S3 deben contribuir. Esa información vive en lo que llamamos una sesión de exportación.
Una sesión representa un ciclo completo de exportación. Contiene la ventana de registros que se van a procesar —definida por el identificador mínimo y máximo de los registros pendientes al inicio del ciclo— y los tipos de registro que existen dentro de esa ventana. Todos los pods del ciclo leen esa sesión para saber qué les toca hacer.
La sesión se crea una sola vez al inicio del ciclo y cierra una sola vez al final. Ambas operaciones son bloqueantes: cuando múltiples pods arrancan al mismo tiempo, el primero que llega crea la sesión mientras los demás esperan. El mecanismo que garantiza que solo un pod hace cada una de esas operaciones es el mismo bloqueo pesimista de PostgreSQL: SELECT FOR UPDATE sobre el registro de control de la sesión.
El ciclo de vida completo
El flujo completo tiene tres fases que se ejecutan en orden estricto.
Inicio de la sesión. Cuando el cron dispara los pods, todos intentan iniciar o unirse a una sesión activa. El primero que llega no encuentra sesión activa, bloquea el registro de control y asume la responsabilidad de inicializar el ciclo.
Lo primero que hace ese pod —antes de definir qué registros procesará— es revisar si quedaron registros atascados del ciclo anterior. Un pod puede morir en medio del procesamiento por razones fuera de su control: un fallo de infraestructura, un timeout, una excepción no manejada. Cuando eso ocurre, los registros que ese pod había tomado quedan marcados como en procesamiento pero nunca llegan a completarse. El pod que inicia la sesión los detecta buscando registros que lleven más tiempo del razonable en ese estado y los devuelve a pendiente antes de continuar.
Con los registros huérfanos recuperados, el pod determina la ventana del ciclo: consulta el identificador mínimo y máximo de los registros pendientes y fija esos valores como los límites del ciclo. Ningún registro que llegue después de ese momento entra en este ciclo. Luego consulta qué tipos de registros existen dentro de esa ventana y registra esa información en la sesión sin iniciar aún ninguna carga en S3. El Multipart Upload no se inicia en este momento porque todavía no se sabe si habrá suficiente volumen para justificarlo. Finalmente libera el bloqueo y los demás pods pueden empezar a trabajar.
Primer pod llega
     ↓
No encuentra sesión activa → bloquea registro de control
     ↓
Recupera registros huérfanos del ciclo anterior
     ↓
Determina ventana: min_id y max_id de registros pendientes
     ↓
Consulta tipos distintos dentro de la ventana
     ↓
Por cada tipo registra en DB:
     - el tipo
     - estado OPEN
     - sin uploadId aún
     ↓
Marca sesión como activa y libera bloqueo
     ↓
Los demás pods leen la sesión y empiezan a trabajar
Procesamiento en lotes. Cada pod entra en un ciclo continuo donde toma lotes de registros, los procesa y deposita las líneas resultantes en la tabla temporal, hasta que no queden registros pendientes dentro de la ventana.
Por cada lote, el pod ejecuta SELECT FOR UPDATE SKIP LOCKED sobre los registros pendientes dentro de la ventana. Inmediatamente los marca como en procesamiento y cierra la transacción, liberando el bloqueo para que otros pods puedan seguir tomando registros distintos. Luego procesa cada registro consultando sus tablas relacionadas, validando los datos y formateando la línea CSV según la plantilla del tipo correspondiente.
Al terminar cada registro, el pod deposita en la tabla temporal la línea CSV formateada, su peso en bytes y el tipo al que pertenece, y marca el registro como completado. Si el procesamiento de un registro falla, registra el error en la tabla de auditoría. Si el registro lleva menos de tres intentos, vuelve a pendiente. Si ya acumula tres intentos fallidos, se marca como descartado y no vuelve a procesarse: sigue visible en la tabla de auditoría para revisión manual pero no bloquea el avance del ciclo.
En paralelo al procesamiento, cualquier pod consulta el peso acumulado en la tabla temporal por tipo. Cuando detecta que hay suficiente para una parte válida de 5MB, toma esas líneas mediante SELECT FOR UPDATE SKIP LOCKED, las marca como en subida y ejecuta el siguiente flujo:
Si es la primera parte que se sube para ese tipo, el pod inicia el Multipart Upload en S3, sube los headers del CSV junto con las líneas acumuladas como primera parte, y registra el uploadId en la tabla de partes por tipo. Incluir los headers en la primera parte real de datos es necesario porque S3 Multipart no permite subir una parte vacía o con solo encabezados: la primera parte debe tener contenido suficiente para alcanzar el mínimo de 5MB. Si el Multipart ya fue iniciado por otro pod, simplemente sube las líneas como la siguiente parte disponible.
Pod consulta peso acumulado en tabla temporal por tipo
     ↓
¿Hay 5MB pendientes de subir?
     ├── NO → sigue procesando registros
     └── SÍ → toma líneas via SELECT FOR UPDATE SKIP LOCKED
               marca líneas como en subida
               ↓
               ¿Existe uploadId para este tipo?
               ├── NO → inicia Multipart Upload en S3
                         sube headers + líneas acumuladas
                         como primera parte
                         registra uploadId en DB
               └── SÍ → usa uploadId existente
                         sube líneas como siguiente parte
               ↓
               Marca líneas como subidas
               Registra número de parte en DB
Proceso entra en loop
     ↓
SELECT FOR UPDATE SKIP LOCKED
registros pendientes dentro de la ventana
     ↓
¿Hay registros?
     ├── No → sale del loop
     └── Sí → marca como en procesamiento
               cierra transacción → libera bloqueo
               ↓
               Por cada registro:
               consulta tablas relacionadas
               valida y formatea línea CSV
               deposita en tabla temporal con peso en bytes
               marca registro como completado
               ↓
               Para fallidos:
               registra error en auditoría
               < 3 intentos → vuelve a pendiente
               ≥ 3 intentos → marca como descartado
Cierre de la sesión. Al terminar cada lote, el pod verifica si quedan registros pendientes o con menos de tres intentos dentro de la ventana. Los registros descartados se consideran procesados porque ya superaron el límite de reintentos y no volverán a intentarse.
Si no quedan registros pendientes, el pod verifica si quedan líneas en la tabla temporal que no hayan sido subidas a S3, independientemente de si superan o no los 5MB. Estas son las líneas residuales del ciclo: los últimos registros procesados que no alcanzaron a formar una parte completa. El pod que detecta esta condición intenta ser el que cierra la sesión usando el mismo mecanismo bloqueante del inicio.
Bloquea el registro de control y verifica el estado de la sesión. Si otro pod ya la cerró, simplemente libera el bloqueo y termina. Si la sesión sigue activa, este pod es el responsable del cierre: toma las líneas residuales de la tabla temporal y las sube como última parte del Multipart Upload de cada tipo. S3 permite que la última parte sea menor a 5MB, por lo que no hay restricción de tamaño en este paso. Luego llama a completeMultipartUpload para consolidar todas las partes en el archivo final, marca la sesión como cerrada y libera el bloqueo.
Al terminar cada lote:
     ↓
¿Quedan registros pendientes o con menos de 3 intentos
dentro de la ventana?
     ├── Sí → siguiente lote
     └── No → ¿Quedan líneas sin subir en tabla temporal?
               ↓
               Bloquea registro de control
               ↓
               ¿Sesión ya cerrada?
               ├── Sí → libera bloqueo y termina
               └── No → toma líneas residuales de tabla temporal
                         sube como última parte de cada tipo
                         llama completeMultipartUpload por cada tipo
                         marca sesión como cerrada
                         libera bloqueo
Lo que necesitas para implementarlo
Este enfoque requiere más elementos que el primero, pero cada uno tiene una razón de ser clara.
| Elemento | Detalle |
|---|---|
| Campo de estado en tabla de jobs | PENDING, PROCESSING, COMPLETED, FAILED, DEAD |
Campo locked_at en tabla de jobs |
Timestamp para detectar registros huérfanos |
| Tabla temporal de líneas CSV | Línea formateada, peso en bytes, tipo y estado de subida |
| Tabla de auditoría | Referencia al registro, número de intento, error y timestamp |
| Tabla de sesión | Ventana de procesamiento (min_id, max_id) y estado (OPEN, DONE) |
| Tabla de partes por tipo | Tipo, uploadId de S3 y estado (OPEN, DONE) |
| Tabla de exportación | Opcional, recomendada como buena práctica para simplificar el procesamiento por lote |
Lo que ninguno de los dos te dice hasta que fallas en producción
Después de ver los dos enfoques en detalle puede parecer que la decisión está tomada y la implementación es directa. Pero hay un punto que ninguno de los dos resuelve por sí solo y que, si no se atiende, puede hacer que cualquiera de las dos soluciones falle de una manera silenciosa y difícil de detectar.
PostgreSQL y S3 no viven en el mismo mundo transaccional. Cuando haces un cambio en la base de datos dentro de una transacción, puedes deshacerlo si algo falla: eso es precisamente lo que hace una transacción. Pero cuando subes un archivo a S3, esa operación no participa en ninguna transacción de base de datos. Es independiente, definitiva e irreversible desde el punto de vista de PostgreSQL. Si el archivo llega a S3 y luego la transacción de base de datos falla, el archivo ya está ahí y no hay forma de retirarlo automáticamente.
Esto crea una ventana de inconsistencia que puede ser devastadora si no se maneja. Imagina que marcas los registros como procesados, confirmas la transacción y luego intentas subir a S3. Si S3 falla, los registros ya están marcados como procesados en la base de datos pero el archivo nunca llegó. El sistema legado no recibe nada, pero el siguiente ciclo tampoco reintenta porque los registros ya no están pendientes. Los datos simplemente desaparecen del proceso sin que nadie lo detecte fácilmente.
La solución está en el orden de las operaciones, y ese orden debe ser disciplinado y consistente en toda la implementación: primero marcas los registros como procesados dentro de una transacción que aún no has confirmado, luego subes el archivo a S3, y solo si S3 confirma el éxito confirmas la transacción en PostgreSQL. Si S3 falla, haces rollback y los registros vuelven a su estado anterior, listos para reintentarse en el siguiente ciclo.
Marcar registros como procesados en DB (sin confirmar aún)
          ↓
     Subir archivo a S3
          ↓
S3 exitoso → confirmar transacción en PostgreSQL ✅
S3 falla   → rollback → registros vuelven a pendiente 🔄
Este orden no es una preferencia de implementación: es la única secuencia que garantiza consistencia entre los dos sistemas en todos los escenarios posibles. Con él, un fallo en S3 siempre deja la base de datos en un estado coherente y el siguiente ciclo retoma el trabajo sin intervención manual. Sin él, cualquier fallo entre la confirmación de la transacción y la subida a S3 crea un estado inconsistente que requiere corrección manual para detectar y resolver.
El sistema legado no va a cambiar. Pero tu integración sí puede ser confiable.
Volvamos al punto de partida. Tienes un sistema moderno que genera datos y un sistema legado que consume archivos. Entre los dos hay una brecha que no vas a poder cerrar cambiando el sistema legado, porque ese no es el juego. El juego es construir un puente confiable entre los dos mundos, y la complejidad de ese puente debe estar justificada por los problemas que resuelve, no por los que imaginas que podrían aparecer.
Desde aquí hay líneas naturales hacia las que vale la pena mirar. La observabilidad es la más inmediata: métricas de ciclo integradas en una herramienta de monitoreo permiten detectar degradaciones antes de que se conviertan en incidentes. La gestión operativa de registros descartados es la que más se subestima: una interfaz mínima para que un operador los inspeccione, corrija y reintroduzca al flujo es lo que transforma este sistema en algo verdaderamente autónomo. Y para quienes están en el extremo de mayor volumen, vale explorar si COPY TO STDOUT puede coexistir con el patrón distribuido, usando la capacidad de PostgreSQL para exportar directamente incluso en un escenario de múltiples procesos.
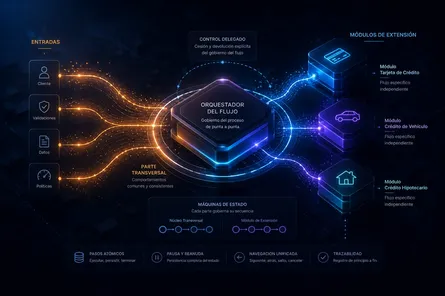
Cuando un sistema debe ejecutar lo mismo siempre y algo distinto cada vez
- Mauricio ECR
- Arquitectura
- 24 May, 2026
Imagina que estás diseñando el flujo de solicitud de productos financieros de un banco. Un cliente puede pedir una tarjeta de crédito o un crédito para comprar un vehículo. Los dos productos son disti

Cuando un sistema debe ejecutar lo mismo siempre y algo distinto cada vez
- Mauricio ECR
- Arquitectura
- 24 May, 2026
Imagina que estás diseñando el flujo de solicitud de productos financieros de un banco. Un cliente puede pedir una tarjeta de crédito o un crédito para comprar un vehículo. Los dos productos son distintos: tienen pasos diferentes, documentos diferentes, validaciones diferentes. Pero también comparten algo que no puede variar: antes de que cualquier producto se evalúe, el banco necesita saber quién es el cliente, confirmar su identidad y consultar su historial crediticio. Eso ocurre siempre, para cualquier producto, sin excepción.
La pregunta que se presenta de inmediato parece técnica pero es en realidad arquitectónica: ¿dónde vive ese comportamiento compartido? ¿Lo repites en cada flujo de producto? ¿Lo centralizas en algún lugar y los flujos de producto lo invocan? ¿Construyes un flujo único con condicionales que bifurcan la lógica según el tipo de producto?
Cualquiera de esas tres respuestas funciona mientras el sistema es pequeño. El problema aparece cuando el banco decide lanzar un tercer producto, luego un cuarto. Cuando un equipo necesita cambiar la validación de identidad sin tocar los flujos de tarjeta ni de vehículo. Cuando hay que agregar un paso transversal nuevo y ese cambio no puede romper nada de lo que ya está operando. Ahí es donde las soluciones aparentemente razonables revelan su costo real.
Si duplicaste la lógica compartida, ahora debes modificarla en tres o cuatro lugares y confiar en que todos los cambios sean consistentes. Si la centralizaste mediante invocaciones directas, los flujos de producto están acoplados a ese componente central y cualquier cambio en él requiere verificar el impacto en todos los consumidores. Si construiste un flujo con condicionales, cada nuevo producto aumenta la complejidad del núcleo hasta que nadie entiende del todo qué hace ese código.
La tensión es real: hay pasos que deben ejecutarse de forma consistente en toda instancia del flujo, pero cada caso de negocio introduce lógica específica que no puede ni debe generalizarse. Y esa tensión no se resuelve eligiendo uno de los dos lados. Se resuelve separándolos con precisión y definiendo el mecanismo exacto por el que conviven.
La separación que sostiene todo lo demás
El problema que tienen las tres soluciones descritas antes es que todas intentan resolver la tensión desde el mismo lugar: deciden quién ejecuta qué. Una duplica la ejecución, otra la centraliza, otra la condiciona. Pero ninguna se hace la pregunta más profunda: ¿quién tiene el gobierno del flujo en cada momento?
Esa distinción importa porque gobernar el flujo no es lo mismo que ejecutar un paso. Gobernar significa saber en qué punto está el proceso, decidir qué viene después y ser responsable de que el flujo llegue a su fin de forma consistente. Cuando esa responsabilidad está dispersa entre varios componentes que ejecutan partes del proceso, nadie la tiene completamente. Y cuando nadie la tiene completamente, el flujo se fragmenta.
La respuesta natural a ese problema es concentrar el gobierno. Que haya un único responsable del flujo completo que sepa en todo momento dónde está el proceso y qué debe ocurrir a continuación. Ese responsable ejecuta lo que es común a todos los casos y, cuando llega el momento en que cada caso tiene su propia lógica, cede el gobierno temporalmente a quien sabe cómo manejarla. No lo invoca, no lo llama como si fuera una función: le transfiere el control de forma explícita, permanece en espera y lo recupera cuando termina.
Eso es exactamente lo que hace el núcleo transversal: concentra el gobierno del flujo completo, ejecuta los pasos que son comunes a todos los casos y cede el control cuando la especificidad de cada caso debe intervenir. Y eso es exactamente lo que hace un módulo de extensión: recibe ese control, ejecuta la lógica propia de su caso y lo devuelve. El módulo no conoce al núcleo, no depende de él y no lo dirige. Solo sabe que en algún momento va a recibir el gobierno y que cuando termine debe devolverlo.
Para que esa cesión y esa devolución ocurran con precisión, ambas partes necesitan saber en todo momento dónde están y qué viene después. Ese mecanismo es una máquina de estados: un registro del punto exacto en que se encuentra el proceso y un conjunto de transiciones válidas desde ahí. El núcleo tiene la suya, que gobierna sus pasos transversales. Cada módulo tiene la propia, completamente independiente, que gobierna sus pasos específicos. Cuando el núcleo cede el gobierno, su máquina de estados transiciona a un estado que reconoce explícitamente esa cesión. Mientras está en ese estado, cualquier solicitud de navegación que llegue al núcleo es redirigida al módulo activo. Cuando el módulo termina, el núcleo recibe el control de vuelta y su máquina de estados avanza hacia el cierre.
El flujo, visto desde afuera, parece continuo. Visto desde adentro, está compuesto por pasos atómicos: unidades independientes que no conocen ni necesitan conocer los pasos anteriores ni los siguientes. Cada paso se ejecuta, produce un resultado, lo persiste y termina. La secuencia no es responsabilidad del paso, es responsabilidad de la máquina de estados que lo gobierna.
Esa independencia entre pasos le da al flujo algo que los modelos continuos no tienen: la capacidad de pausarse sin romperse. Si un paso necesita información del cliente, el flujo persiste su estado completo y se detiene. Cuando el cliente responde, la máquina de estados retoma exactamente desde donde estaba. Y si el cliente quiere corregir algo que ya ingresó, puede retroceder: la máquina activa, sea la del núcleo o la del módulo, hace la transición hacia atrás y el paso anterior vuelve a estar disponible.
Un núcleo que no cambia pero se adapta
La estabilidad del núcleo es una decisión de diseño, no una limitación técnica. Cuando se incorpora un nuevo producto al banco, el núcleo no se modifica. No necesita saber qué pasos tiene el nuevo módulo, qué validaciones aplica ni qué documentos solicita. Lo único que necesita es que el módulo cumpla un contrato: un acuerdo lógico formal que define las reglas mínimas de interacción entre el núcleo y cualquier módulo que quiera participar del flujo. El módulo no tiene referencia al núcleo ni a otros módulos. Su única dependencia es hacia ese contrato.
Ese contrato es deliberadamente mínimo. En el momento de la cesión, el núcleo no le entrega al módulo un paquete de información recopilada durante la parte transversal. Le entrega una sola cosa: el identificador de la transacción en curso, un identificador único que el núcleo genera cuando el flujo se inicia y que lo acompaña hasta el cierre. Con ese identificador, el módulo puede relacionar cada uno de sus pasos con la transacción correcta. Y si en algún punto de su ejecución necesita información que el núcleo recolectó durante la parte transversal, como los datos del cliente o el resultado de la validación de identidad, la solicita activamente a través de los endpoints que el núcleo expone para ese propósito.
Eso resuelve un problema que los modelos con contratos de entrada ricos suelen enfrentar: si el núcleo evoluciona y empieza a recolectar información nueva, no hay necesidad de modificar el contrato de cesión ni de actualizar los módulos existentes. El núcleo simplemente expone un endpoint nuevo. Los módulos que necesitan esa información lo adoptan cuando lo necesitan. Los que no lo necesitan no saben que existe y no se ven afectados.
Pero la estabilidad del núcleo no significa rigidez. Cuando un módulo se registra, puede declarar una configuración que adapta ciertos comportamientos del núcleo para su caso particular: activar o desactivar capacidades transversales, ajustar ciertas acciones según las respuestas esperadas. La distinción es precisa: el núcleo decide desde su diseño qué aspectos son adaptables y los expone de forma explícita. Un módulo solo puede moverse dentro de ese espacio predefinido, nunca ampliarlo ni redefinirlo. Lo que no fue diseñado como configurable permanece invariante sin importar qué módulo se registre.
Cómo se registra un módulo
Antes de que cualquier flujo pueda ejecutarse, cada módulo debe registrarse en el núcleo. Este proceso ocurre una única vez por módulo y es completamente independiente del flujo de ejecución.
El módulo se presenta ante el componente de registro del núcleo, declara su identidad y entrega su configuración. Como parte de esa configuración, declara también el listado completo de sus pasos: cuántos son y cómo se llama cada uno. Esa información queda almacenada en el núcleo como dato estático y se convierte en la fuente de verdad para el indicador de progreso que verá el cliente durante el flujo. El núcleo valida que el módulo cumpla el contrato de extensión y que su configuración sea válida dentro del espacio de adaptación permitido. Si todo es correcto, el módulo queda disponible para ser invocado.
A partir de ese momento el núcleo sabe que ese módulo existe, cómo debe comportarse cuando sea invocado y cuántos pasos lo componen. No sabe nada más. No conoce la lógica interna del módulo, no puede modificarla y no necesita hacerlo.
Cómo se ejecuta el flujo
Cuando el cliente inicia una solicitud e indica qué producto desea, el núcleo busca el módulo correspondiente, carga su configuración y adapta su comportamiento dentro de los límites predefinidos. Su máquina de estados transiciona al primer estado activo.
El primer paso es el preprocesamiento: el núcleo normaliza y construye el contexto inicial del flujo. En el caso del banco, esto incluye los datos básicos del cliente que llegaron con la solicitud. Al completarse, persiste el estado y la máquina de estados avanza al siguiente paso.
El siguiente paso es la validación transversal. El núcleo confirma la identidad del cliente y consulta su historial crediticio. Si alguna de esas validaciones requiere información adicional del cliente, el flujo se pausa, persiste su estado completo y espera. Cuando el cliente responde, la máquina de estados retoma exactamente desde donde estaba y la validación continúa. Al completarse, el estado se persiste y la máquina de estados avanza.
Es en este punto donde el flujo hace algo que ninguno de los tres modelos anteriores podía hacer limpiamente: reconoce que lo que sigue ya no le pertenece. La máquina de estados del núcleo transiciona al estado de control delegado y genera el identificador único de la transacción en curso. Ese identificador es lo único que el núcleo le entrega al módulo en el momento de la cesión. Con él, el módulo sabe a qué transacción pertenece cada uno de sus pasos. Y con él, puede consultar al núcleo cualquier información que necesite de la parte transversal ya completada.
A partir de ese instante, la máquina de estados del módulo toma el gobierno. El núcleo permanece en ese estado de espera activa, sin intervenir. Toda solicitud de navegación que llegue al núcleo durante este período es redirigida al módulo activo.
La máquina de estados del módulo activa sus pasos en la secuencia que ella misma define. Cada paso se ejecuta, produce un resultado y termina. Si un paso requiere interacción con el cliente, el flujo se pausa y espera exactamente igual que en la parte transversal. Después de cada paso, el estado se persiste y la máquina evalúa si hay un paso siguiente o si el módulo ha terminado.
Cuando no hay más pasos, el módulo devuelve el control al núcleo. La máquina de estados del núcleo transiciona desde el estado de control delegado hacia el cierre: registra la trazabilidad del flujo completo, persiste el estado final y notifica al cliente que el proceso ha concluido.
Lo que ve el cliente durante todo este proceso
Desde la perspectiva del cliente, el flujo es una secuencia continua de pantallas con un indicador de progreso que avanza. No hay ninguna señal visible de que en algún punto el gobierno pasó de una máquina de estados a otra. Esa continuidad no es cosmética: es el resultado de dos decisiones de diseño que trabajan juntas.
La primera es que el núcleo actúa como proxy de navegación. Toda instrucción del cliente, avanzar, retroceder, saltar a un paso anterior, cancelar, llega siempre al núcleo. El núcleo evalúa en qué punto del flujo se encuentra y decide si la ejecuta directamente o la redirige al módulo activo. El cliente nunca sabe esa distinción. Para él, siempre está hablando con el mismo interlocutor.
La segunda es que el indicador de progreso funciona sin necesidad de consultar al módulo en cada momento. El núcleo ya sabe cuántos pasos tiene el flujo completo desde el registro: el módulo declaró sus pasos al registrarse y esa información quedó almacenada de forma estática. Durante la ejecución, el núcleo solo necesita consultar al módulo por el paso actual, y únicamente cuando el control está delegado. El total de pasos nunca cambia y nunca necesita preguntarse de nuevo.
Con esas dos piezas en su lugar, cada pantalla puede ser completamente autónoma. No necesita conocer el flujo completo para saber qué mostrar ni con quién hablar. La navegación, avanzar, retroceder, saltar, cancelar, siempre pasa por el núcleo. Pero la interacción propia de cada paso, los datos que el cliente ingresa y las respuestas específicas de ese punto del flujo, van directamente al responsable de ese paso: el núcleo si el paso es transversal, el módulo si el paso le pertenece a él. Esto es posible porque cada pantalla es tan atómica como el paso que representa: desde el diseño se definen sus puntos de comunicación, con quién habla y para qué. No hay lógica en tiempo de ejecución que decida eso. La pantalla ya lo sabe.
Los comandos que el cliente puede dar en cualquier momento del flujo, y quién los resuelve, son los siguientes:
| Comando | Propósito | Quién resuelve la lógica |
|---|---|---|
| Consulta de pasos | Obtiene el total de pasos y el nombre de cada uno | Núcleo, usando el dato declarado en el registro del módulo |
| Consulta de progreso | Retorna el total de pasos, el paso actual y el último paso completado | Núcleo. Cuando el control está delegado, consulta al módulo por el paso actual |
| Siguiente | Avanza al siguiente paso lógico | Núcleo si el paso es transversal, módulo si el paso es del módulo |
| Atrás | Retrocede al paso anterior | Núcleo si el paso es transversal, módulo si el paso es del módulo |
| Salto | Navega a un paso específico, siempre que no supere el último paso alcanzado | Núcleo si el destino es transversal, módulo si el destino es del módulo |
| Cancelar | Termina el flujo completamente | Núcleo |
Lo que esta tabla muestra, más allá de los detalles técnicos, es que el cliente siempre tiene el mismo conjunto de comandos disponibles sin importar en qué parte del flujo se encuentra. El hecho de que algunos los resuelva el núcleo y otros el módulo es invisible para él. Y esa invisibilidad es exactamente lo que permite que el caso del banco, con sus dos productos distintos, se sienta como una sola experiencia coherente.
Lo que esta separación realmente cuesta
Sería deshonesto presentar este modelo sin nombrar lo que exige.
El contrato de extensión debe estar bien definido desde el principio. No en términos de la información que se transfiere en la cesión, que es mínima por diseño, sino en términos de las reglas de interacción: cómo se registra un módulo, qué debe declarar, cómo devuelve el control y qué formato tienen las respuestas que el núcleo espera. Si esas reglas están mal definidas o son ambiguas, los módulos las interpretarán de formas distintas y el flujo producirá comportamientos inconsistentes que son difíciles de rastrear porque la causa no está en la lógica de ningún paso sino en el acuerdo que los articula.
La máquina de estados de cada módulo requiere diseño cuidadoso. No es compleja en términos de implementación, pero sí requiere que quien diseña el módulo tenga claridad total sobre la secuencia de sus pasos, las transiciones válidas y los estados de pausa. Un módulo con una máquina de estados mal definida produce comportamientos inconsistentes que son difíciles de rastrear porque la lógica de secuencia está separada de la lógica de cada paso. Cuando algo falla, no es obvio si el problema está en el paso que se ejecutó o en la transición que lo activó.
Los endpoints que el núcleo expone para que los módulos consulten información transversal deben tratarse con la misma disciplina que el contrato de extensión. Son una interfaz pública que los módulos van a consumir, y cualquier cambio en ellos tiene el potencial de romper módulos existentes. Agregar endpoints nuevos es seguro: los módulos que no los necesitan simplemente no los usan. Pero modificar o eliminar endpoints existentes requiere coordinación con todos los módulos que los consumen, y esa coordinación tiene un costo real que crece con la cantidad de módulos operativos.
El modelo de proxy de navegación en el núcleo introduce una dependencia en tiempo de ejecución que debe estar bien resuelta. Cuando el núcleo redirige una solicitud de navegación al módulo activo, necesita tener una referencia válida a ese módulo. Si el módulo no está disponible por cualquier razón, esa solicitud falla. Esto no es diferente a cualquier otra dependencia en tiempo de ejecución, pero debe tenerse en cuenta en el diseño de tolerancia a fallos del sistema.
Finalmente, la disciplina de no modificar el núcleo es una restricción organizacional además de técnica. En la práctica, siempre hay presión para agregar una excepción aquí, un comportamiento especial allá. Cada vez que esa presión cede, el núcleo pierde algo de su estabilidad y el modelo empieza a degradarse. Mantener esa disciplina requiere que el equipo entienda bien por qué el núcleo es cerrado a modificación, no solo que sepa que lo es.
Todo ese costo tiene un punto de equilibrio. Si el sistema tiene un solo tipo de caso y es poco probable que eso cambie, el modelo agrega complejidad estructural sin beneficio real. La separación entre núcleo y módulos, las dos máquinas de estados, el contrato de extensión, los endpoints de consulta: todo eso se justifica cuando hay variabilidad real entre casos, cuando el comportamiento transversal necesita mantenerse consistente y evolucionar de forma independiente, y cuando la incorporación de nuevos casos debe ser posible sin riesgo sobre lo que ya está operando. Cuanto más de esas tres condiciones se cumplen, más sentido tiene asumir la exigencia que el modelo impone.
De vuelta al banco
Con el modelo completo sobre la mesa, el caso del banco deja de verse como un flujo de productos financieros y empieza a revelar el problema arquitectónico que realmente estaba presente desde el principio.
La dificultad nunca fue únicamente validar identidad, consultar historial crediticio o pedir documentos distintos según el producto. Eso podía resolverse de muchas maneras. El problema real era otro: cómo permitir que el sistema creciera sin que cada nuevo producto aumentara el acoplamiento, duplicara lógica o volviera más frágil el flujo completo.
Cuando el núcleo concentra únicamente las responsabilidades transversales y los productos viven en módulos independientes con su propia máquina de estados, el crecimiento deja de sentirse como una modificación del sistema existente y empieza a comportarse como una extensión controlada. Nuevos productos pueden incorporarse sin intervenir los flujos que ya operan, los equipos dejan de depender entre sí para evolucionar casos específicos y la complejidad deja de acumularse en un único lugar.
Hoy existen dos productos. Mañana habrá créditos hipotecarios, productos empresariales, validaciones regulatorias nuevas y recorridos especializados que todavía no existen. Cada uno traerá lógica distinta, pasos distintos y reglas distintas. Pero todos seguirán compartiendo la misma necesidad transversal: entender quién es el cliente antes de tomar cualquier decisión.
El valor del modelo no está en resolver bien los dos productos actuales. Está en evitar que el tercer producto convierta al sistema en algo más difícil de modificar que el segundo. Está en permitir que la variabilidad crezca sin que el núcleo pierda estabilidad. Está en separar la evolución de los productos de la evolución del flujo transversal.
Las tres soluciones iniciales parecían razonables mientras el sistema era pequeño. Duplicar lógica, centralizar mediante invocaciones directas o resolver todo con condicionales podían funcionar durante un tiempo. El problema aparecía después, cuando cada nuevo caso hacía que el sistema completo fuera más difícil de entender, probar y evolucionar. La pregunta que el banco se hacía al principio, dónde vive el comportamiento compartido, no tenía una respuesta técnica. Tenía una respuesta arquitectónica. Y la diferencia entre las dos es exactamente lo que determina si el cuarto producto se incorpora con la misma facilidad que el segundo o si para entonces ya nadie quiere tocar ese código.
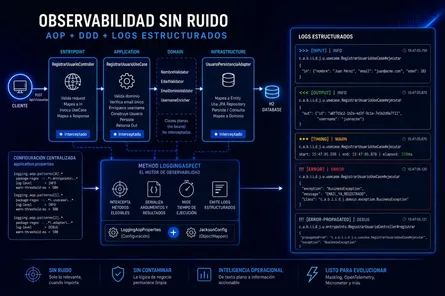
Observabilidad sin Ruido: Diseñando un Sistema de Logs con AOP en Arquitecturas DDD — Parte II
- Mauricio ECR
- Arquitectura
- 18 May, 2026
La primera parte de este artículo construyó el argumento conceptual: por qué los logs dispersos se convierten en deuda técnica, cómo AOP permite centralizar la observabilidad sin contaminar la lógica

Observabilidad sin Ruido: Diseñando un Sistema de Logs con AOP en Arquitecturas DDD — Parte II
- Mauricio ECR
- Arquitectura
- 18 May, 2026
La primera parte de este artículo construyó el argumento conceptual: por qué los logs dispersos se convierten en deuda técnica, cómo AOP permite centralizar la observabilidad sin contaminar la lógica de negocio, qué información debe registrarse en cada capa de una arquitectura DDD, y cómo los campos estructurados convierten un archivo de texto en una fuente de inteligencia operacional. Lo que quedó pendiente fue la demostración concreta: cómo se construye ese sistema, qué decisiones se toman en cada pieza, y por qué cada una de ellas importa.
Eso es exactamente lo que ocupa esta segunda parte. El objetivo es preciso: que al terminar de leerla, un desarrollador con experiencia en Spring pueda reproducir el sistema completo en su proyecto. No como una lista de pasos a seguir ciegamente, sino con el entendimiento de por qué cada componente existe, qué problema resuelve y qué ocurriría si se omitiera o se implementara de otra manera.
El stack es Java 21, Spring Boot 3.5.x, Gradle. Las dependencias que habilitan el sistema son spring-boot-starter-aop, que trae AspectJ y el soporte de proxies de Spring, y jackson-datatype-jsr310, que permite serializar correctamente los tipos de fecha y hora de Java 8 en los logs. Lombok está presente por conveniencia, pero no es estructuralmente necesario. Ninguna dependencia adicional es requerida.
El proyecto de ejemplo
Para que cada decisión técnica tenga contexto real, el sistema de logs se implementa sobre un proyecto concreto: una API REST que registra usuarios. Es un caso de uso deliberadamente simple, lo suficiente para que el flujo sea fácil de seguir, pero con la estructura completa de una arquitectura DDD: entrada HTTP, caso de uso, validaciones de dominio, persistencia, y manejo de errores.
El proyecto tiene esta estructura:
src/main/java/com/app_247/blog/id202603212000art/
│
├── Id202603212000artApplication.java                          ★ [LOG]
│
├── applications/
│   └── aop/
│       ├── aspect/
│       │   └── MethodLoggingAspect.java                      ★ [LOG]
│       └── config/
│           ├── JacksonConfig.java                            ★ [LOG]
│           └── LoggingAopProperties.java                     ★ [LOG]
│
├── domain/
│   ├── model/
│   │   ├── exception/
│   │   │   ├── BusinessException.java
│   │   │   └── DomainValidationException.java
│   │   └── usuario/
│   │       ├── gateway/
│   │       │   └── IUsuarioGateway.java
│   │       └── Usuario.java
│   └── usecase/
│       └── registrarusuario/
│           ├── dto/
│           │   ├── RegistrarUsuarioIn.java
│           │   └── RegistrarUsuarioOut.java
│           ├── enricher/
│           │   └── UsernameEnricher.java
│           ├── validator/
│           │   ├── EdadValidator.java
│           │   ├── EmailDominioValidator.java
│           │   └── NombreValidator.java
│           └── RegistrarUsuarioUseCase.java
│
└── infrastructure/
    ├── drivenadapters/
    │   └── jpa/
    │       └── usuario/
    │           ├── adapter/
    │           │   └── UsuarioPersistenciaAdapter.java
    │           ├── entity/
    │           │   └── UsuarioEntity.java
    │           ├── mapper/
    │           │   └── UsuarioPersistenciaMapper.java
    │           └── repository/
    │               └── UsuarioJpaRepository.java
    └── entrypoints/
        └── api/
            └── registrarusuario/
                ├── dto/
                │   ├── RegistrarUsuarioRequest.java
                │   └── RegistrarUsuarioResponse.java
                ├── mapper/
                │   └── RegistrarUsuarioApiMapper.java
                ├── RegistrarUsuarioController.java
                └── util/
                    └── Exception/
                        └── GlobalExceptionHandler.java

src/main/resources/
└── application.properties                                     ★ [LOG]
Las clases marcadas con ★ [LOG] son las que forman el sistema de observabilidad. Todo lo demás es la lógica del negocio y la infraestructura del proyecto, que no tiene ninguna instrucción de log y no necesita tenerla.
El flujo de una solicitud
Antes de abrir cualquier clase del sistema de logs vale la pena recorrer el flujo completo de una solicitud de registro de usuario. Es el flujo que el aspecto va a observar, y entenderlo con claridad hace que cada decisión de implementación tenga sentido inmediato.
El cliente envía un POST /api/v1/usuarios con un cuerpo JSON que contiene nombre, email y edad. A partir de ahí, la solicitud atraviesa estas capas en orden:
RegistrarUsuarioController es el punto de entrada. Recibe el request HTTP, lo valida con Bean Validation (@Valid), y usa RegistrarUsuarioApiMapper para convertir el RegistrarUsuarioRequest en un RegistrarUsuarioIn, que es el DTO que entiende el dominio. Luego invoca el caso de uso y convierte el resultado de vuelta a un RegistrarUsuarioResponse para la respuesta HTTP. El controlador no tiene lógica de negocio: solo traduce entre el mundo HTTP y el mundo del dominio.
RegistrarUsuarioUseCase es donde ocurre la orquestación. Recibe el RegistrarUsuarioIn y ejecuta la secuencia de negocio: primero llama a NombreValidator, EdadValidator y EmailDominioValidator para validar que los datos cumplan las reglas del dominio. Luego consulta el gateway para verificar que el email no esté ya registrado. Si todo es válido, usa UsernameEnricher para generar el nombre de usuario a partir del email, construye el objeto Usuario y lo persiste a través del gateway. Finalmente construye y retorna el RegistrarUsuarioOut.
Es importante notar que NombreValidator, EdadValidator, EmailDominioValidator y UsernameEnricher son clases con métodos estáticos, sin estado, sin anotaciones de Spring. El UseCase los llama directamente como utilidades. No son beans y el aspecto no los ve, lo cual es correcto: su comportamiento queda capturado por la observación del UseCase que los invoca.
IUsuarioGateway es la interfaz del puerto de salida. El dominio la define; la infraestructura la implementa. El UseCase solo conoce la interfaz, nunca la implementación concreta.
UsuarioPersistenciaAdapter es la implementación del gateway. Está anotado con @Component, es un bean de Spring, y es aquí donde realmente ocurre la interacción con la base de datos. Usa UsuarioPersistenciaMapper para convertir entre el modelo de dominio Usuario y la entidad JPA UsuarioEntity, y delega en UsuarioJpaRepository para las operaciones sobre H2.
GlobalExceptionHandler intercepta cualquier excepción que no haya sido manejada antes de llegar al cliente. Para DomainValidationException devuelve un 422 con el detalle del campo que falló. Para BusinessException devuelve un 409 con el código de error. Para errores de validación de Bean Validation devuelve un 400 con el mapa de campos y mensajes.
Con ese recorrido claro, el flujo completo se puede representar así:
POST /api/v1/usuarios
        │
        ▼
RegistrarUsuarioController        ← @RestController  ★ interceptado
        │ toCommand()
        ▼
RegistrarUsuarioApiMapper         ← @Component (MapStruct)
        │ RegistrarUsuarioIn
        ▼
RegistrarUsuarioUseCase           ← @Service         ★ interceptado
        │
        ├── NombreValidator.validar()        ← clase plana, NO interceptada
        ├── EdadValidator.validar()          ← clase plana, NO interceptada
        ├── EmailDominioValidator.validar()  ← clase plana, NO interceptada
        │
        ├── gateway.existeEmail()
        │       └── UsuarioPersistenciaAdapter#existeEmail  ← @Component ★ interceptado
        │               └── UsuarioJpaRepository (Spring Data)
        │
        ├── UsernameEnricher.generarUsername()  ← clase plana, NO interceptada
        │
        └── gateway.guardar()
                └── UsuarioPersistenciaAdapter#guardar      ← @Component ★ interceptado
                        └── UsuarioJpaRepository (Spring Data)
        │
        ▼ RegistrarUsuarioOut
RegistrarUsuarioController
        │ toResponse()
        ▼
RegistrarUsuarioApiMapper
        │
        ▼
RegistrarUsuarioResponse  →  HTTP 201
Este flujo es el que el aspecto va a observar en tiempo de ejecución. Cada clase marcada con ★ interceptado genera sus propios registros de INPUT, OUTPUT y TIMING sin que ninguna de ellas sepa que está siendo observada. Las clases planas que no son beans simplemente no aparecen en los logs, y eso es correcto: su comportamiento está implícito en la observación de las capas que las contienen.
La arquitectura del sistema de logs
Con el flujo del proyecto claro, el sistema de logs se puede describir con precisión. Son tres piezas con responsabilidades distintas que operan juntas:
LoggingAopProperties es la configuración. Define qué interceptar: qué paquetes, qué clases, qué métodos, en qué nivel de log y a partir de qué tiempo de ejecución emitir una advertencia. No sabe nada del aspecto ni de Jackson.
MethodLoggingAspect es el motor. Intercepta cada método elegible, mide el tiempo, serializa los argumentos y resultados, y emite los registros según las reglas que encontró en las propiedades. No sabe nada de la lógica de negocio del proyecto.
JacksonConfig proporciona el ObjectMapper que el aspecto usa para convertir objetos Java en texto JSON. Está configurado para manejar correctamente los tipos de fecha de Java 8, que sin esta configuración se serializarían como arrays de números en lugar de strings ISO.
La relación entre las tres piezas es deliberadamente asimétrica: LoggingAopProperties no sabe nada del aspecto, y el aspecto no sabe nada de Jackson más allá de que tiene un ObjectMapper disponible. Cada pieza tiene una responsabilidad única y bien delimitada.
LoggingAopProperties: el contrato de configuración
Todo el comportamiento del sistema de logs se controla desde application.properties a través de LoggingAopProperties. Esta clase es un @ConfigurationProperties que mapea el prefijo logging.aop a una estructura de objetos en memoria:
@Data
@ConfigurationProperties(prefix = "logging.aop")
public class LoggingAopProperties {
    private boolean enabled = true;
    private String basePackage = "com.app_247.blog.id202603212000art";
    private List<PatternConfig> patterns = List.of();

    @Data
    public static class PatternConfig {
        private String packageRegex = ".*";
        private String classRegex = ".*";
        private String methodRegex = ".*";
        private String logLevel = "INFO";
        private long warnThresholdMs = 500L;
    }
}
La estructura interna PatternConfig representa una regla de interceptación. Tiene tres expresiones regulares que se evalúan contra el paquete, el nombre simple de la clase y el nombre del método. Si las tres hacen match, la regla aplica y sus otros dos campos determinan el comportamiento: logLevel controla en qué nivel se emiten los registros normales de esa capa, y warnThresholdMs define el umbral de tiempo a partir del cual el registro de timing se eleva automáticamente a WARN independientemente del nivel configurado.
Los valores por defecto de las tres regex son ".*", que en regex significa "cualquier cosa". Esto garantiza que una PatternConfig construida sin configuración explícita intercepta todo, lo cual es un default seguro para desarrollo pero que en producción se reemplaza por reglas precisas.
Para que Spring Boot cargue esta clase al arrancar, la clase principal de la aplicación debe registrarla explícitamente:
@SpringBootApplication
@EnableConfigurationProperties(LoggingAopProperties.class)
public class Id202603212000artApplication {
    public static void main(String[] args) {
        SpringApplication.run(Id202603212000artApplication.class, args);
    }
}
@EnableConfigurationProperties es el mecanismo que le indica a Spring Boot que debe crear un bean de tipo LoggingAopProperties y enlazarlo con el prefijo logging.aop del archivo de propiedades. Sin esta anotación, la clase existe pero nunca se puebla: el aspecto recibiría una instancia con todos los valores por defecto y sin ningún patrón configurado, lo que significa que no interceptaría nada. Es un error silencioso difícil de diagnosticar si no se conoce el mecanismo.
La configuración del proyecto de ejemplo define tres patrones, uno por cada capa que se quiere observar:
logging.aop.enabled=true
logging.aop.base-package=com.app_247.blog.id202603212000art

# UseCase
logging.aop.patterns[0].package-regex=com\\.app_247\\.blog\\.id202603212000art\\.domain\\.usecase.*
logging.aop.patterns[0].class-regex=.*UseCase
logging.aop.patterns[0].method-regex=.*
logging.aop.patterns[0].log-level=INFO
logging.aop.patterns[0].warn-threshold-ms=300

# Adapter de persistencia
logging.aop.patterns[1].package-regex=com\\.app_247\\.blog\\.id202603212000art\\.infrastructure\\.drivenadapters.*
logging.aop.patterns[1].class-regex=.*Adapter
logging.aop.patterns[1].method-regex=.*
logging.aop.patterns[1].log-level=DEBUG
logging.aop.patterns[1].warn-threshold-ms=100

# Controller
logging.aop.patterns[2].package-regex=com\\.app_247\\.blog\\.id202603212000art\\.infrastructure\\.entrypoints.*
logging.aop.patterns[2].class-regex=.*Controller
logging.aop.patterns[2].method-regex=.*
logging.aop.patterns[2].log-level=INFO
logging.aop.patterns[2].warn-threshold-ms=500
Tres decisiones de diseño visibles en esta configuración merecen atención. Primera: el adapter de persistencia tiene log-level=DEBUG mientras que el UseCase y el Controller tienen log-level=INFO. Esto significa que en producción con nivel INFO configurado, los logs del adapter son invisibles por defecto y solo aparecen cuando se activa DEBUG dinámicamente para diagnosticar un problema. La lógica es que saber que el UseCase llamó al adapter y cuánto tardó ya es información suficiente en condiciones normales; el detalle de qué exactamente se guardó o consultó es información de diagnóstico que solo se necesita ocasionalmente.
Segunda: el umbral de WARN del adapter es de 100ms, mucho más estricto que los 300ms del UseCase y los 500ms del Controller. Esto refleja una expectativa operacional: una operación de base de datos que tarde más de 100ms en este proyecto es una señal de alerta, mientras que el UseCase puede acumular ese tiempo y más en su orquestación sin que sea necesariamente un problema.
Tercera: los patrones se evalúan en orden y se aplica el primero que haga match. Si en el futuro existiera una clase que fuera a la vez un UseCase y un Adapter, lo cual no debería ocurrir en una arquitectura DDD bien diseñada pero podría ocurrir en un proyecto en transición, el patrón 0 ganaría porque aparece primero. Esta semántica de primer match es predecible y fácil de razonar.
JacksonConfig: el ObjectMapper para los logs
El aspecto necesita convertir los argumentos y resultados de los métodos en texto para escribirlos en el log. Jackson es la herramienta natural para esto en un proyecto Spring, pero la configuración por defecto tiene un problema concreto con los tipos de fecha de Java 8.
Sin configuración adicional, un LocalDateTime como 2026-05-18T15:47:05.875 se serializa como un array de números: [2026,5,18,15,47,5,875000000]. En un log de producción eso es ilegible. La solución es registrar el módulo JavaTimeModule y deshabilitar la serialización de fechas como timestamps:
@Configuration
public class JacksonConfig {
    @Bean
    public ObjectMapper objectMapper() {
        ObjectMapper mapper = new ObjectMapper();
        mapper.registerModule(new JavaTimeModule());
        mapper.disable(SerializationFeature.WRITE_DATES_AS_TIMESTAMPS);
        return mapper;
    }
}
El resultado es que LocalDateTime aparece en los logs como "2026-05-18T15:47:05.8756894", que es exactamente lo que se ve en la salida de consola de referencia.
Una pregunta legítima es por qué esta configuración vive en el paquete applications/aop/config y no en un paquete de configuración general de la aplicación. La respuesta es de propiedad: este ObjectMapper existe para el sistema de logs, no para la aplicación en general. En el futuro, cuando se incorpore el sistema de enmascaramiento que se documentará en la tercera parte de esta serie, este mapper recibirá configuración adicional específica para logs que no debe afectar a las respuestas HTTP. Mantenerlo en el paquete del sistema de logs hace explícita esa propiedad desde el principio.
MethodLoggingAspect: el motor de la interceptación
Con la configuración clara y el ObjectMapper disponible, el aspecto puede construirse. MethodLoggingAspect es un @Component anotado con @Aspect que recibe por inyección las propiedades y el mapper:
@Slf4j
@Aspect
@Component
@RequiredArgsConstructor
@ConditionalOnProperty(prefix = "logging.aop", name = "enabled", havingValue = "true", matchIfMissing = true)
public class MethodLoggingAspect {

    private final ObjectMapper objectMapper;
    private final LoggingAopProperties properties;
    private final ConcurrentHashMap<String, Optional<PatternConfig>> matchCache = new ConcurrentHashMap<>();
@ConditionalOnProperty con matchIfMissing = true significa que el aspecto está activo por defecto aunque la propiedad logging.aop.enabled no aparezca en el archivo de configuración. Solo se desactiva si la propiedad está explícitamente en false. Esto es un default sensato: en un proyecto nuevo donde todavía no se ha configurado nada, el sistema de logs funciona.
El matchCache es un ConcurrentHashMap de instancia, no estático. Esto es deliberado: si en algún escenario de pruebas o de recarga de contexto se creara una nueva instancia del aspecto, el cache empieza vacío y se reconstituye limpiamente. Un cache estático compartiría estado entre instancias del aspecto, lo que en tests de integración puede producir comportamientos inesperados difíciles de reproducir.
El pointcut y el filtro inicial
El pointcut captura todos los beans anotados con los estereotipos principales de Spring, excluyendo el propio paquete del aspecto:
@Around("(within(@org.springframework.stereotype.Service *)                    " +
        "|| within(@org.springframework.stereotype.Component *)                " +
        "|| within(@org.springframework.web.bind.annotation.RestController *)" +
        "|| within(@org.springframework.stereotype.Repository *))              " +
        "&& !within(com.app_247.blog.id202603212000art.aop..*)")
public Object logMethod(ProceedingJoinPoint joinPoint) throws Throwable {
Usar within con estereotipos en lugar de una expresión de paquete tiene una implicación directa en DDD que ya se mencionó al describir el flujo: los validadores y enrichers del dominio, que son clases planas sin anotaciones de Spring, no son interceptados. El aspecto solo ve lo que Spring gestiona, y eso es exactamente lo correcto.
Lo primero que hace el advice una vez que captura una invocación es extraer la información del método y aplicar el filtro de paquete base:
MethodSignature signature = (MethodSignature) joinPoint.getSignature();
Method method = signature.getMethod();
String packageName = method.getDeclaringClass().getPackageName();
String className = method.getDeclaringClass().getSimpleName();
String methodName = method.getName();

if (!packageName.startsWith(properties.getBasePackage())) {
    return joinPoint.proceed();
}
Este filtro descarta en una comparación de strings todas las invocaciones que provienen de beans de Spring propios del framework o de librerías de terceros. Es el filtro más barato posible y elimina la gran mayoría de las invocaciones que el pointcut captura pero que no son de la aplicación.
Las invocaciones que pasan ese filtro enfrentan la evaluación de patrones, protegida por el cache:
String cacheKey = packageName + "." + className + "#" + methodName;
Optional<PatternConfig> matchedPattern = matchCache.computeIfAbsent(
        cacheKey,
        k -> findMatchingPattern(packageName, className, methodName));

if (matchedPattern.isEmpty()) {
    return joinPoint.proceed();
}
Si ningún patrón hace match, la invocación pasa sin ningún registro. Si hay match, el PatternConfig resultante determina todo el comportamiento posterior: nivel de log, umbral de tiempo, y por extensión qué tan visible es esa capa en producción.
La firma comprimida
Cada registro incluye una firma que identifica el método observado. La firma completa de un método en este proyecto puede ocupar una línea entera de log por sí sola. El aspecto la comprime preservando solo la inicial de cada segmento del paquete excepto el último:
private String compressPackage(String packageName) {
    if (packageName == null || packageName.isBlank()) return "";
    String[] segments = packageName.split("\\.");
    if (segments.length == 1) return packageName;
    StringBuilder sb = new StringBuilder();
    for (int i = 0; i < segments.length - 1; i++) {
        sb.append(segments[i].charAt(0)).append('.');
    }
    sb.append(segments[segments.length - 1]);
    return sb.toString();
}
El resultado para com.app_247.blog.id202603212000art.infrastructure.drivenadapters.jpa.usuario.adapter es c.a.b.i.i.d.j.u.adapter. El último segmento se preserva completo porque es el que aporta contexto: adapter, usecase, entrypoints. Los segmentos anteriores son el prefijo que cualquier desarrollador del proyecto reconoce por su inicial. La firma completa que aparece en cada registro queda así:
c.a.b.i.i.d.j.u.adapter.UsuarioPersistenciaAdapter#guardar
Legible, compacta, y suficientemente precisa para ubicar el método en el árbol de archivos sin ambigüedad.
Los cuatro tipos de registro
El advice @Around tiene visibilidad completa sobre la invocación: puede ejecutar código antes, durante y en el camino de error. Esa visibilidad se materializa en cuatro tipos de registro con marcadores visuales distintos que permiten identificarlos de un vistazo en la consola:
private static final String INPUT_MARKER     = ">>> [INPUT] |";
private static final String OUTPUT_MARKER    = "<<< [OUTPUT] |";
private static final String TIMING_MARKER    = "*** [TIMING] |";
private static final String ERROR_MARKER     = "!!! [ERROR] |";
private static final String PROPAGATED_MARKER = "!!! [ERROR-PROPAGATED] |";
Los marcadores no son decorativos. En una consola con decenas de líneas por segundo, la diferencia visual entre >>>, <<<, *** y !!! permite al ojo localizar inmediatamente qué tipo de evento está leyendo sin procesar el texto completo de cada línea.
INPUT
El registro INPUT captura los argumentos del método en el momento de la invocación. La lógica recorre los parámetros usando reflexión para asociar cada valor con el nombre del parámetro declarado:
private void logInput(
        String methodSignature,
        MethodSignature signature,
        Object[] args,
        PatternConfig pattern) {
    Parameter[] parameters = signature.getMethod().getParameters();
    if (parameters.length == 0) {
        logAtLevel(pattern, "{} {} args: (none)", methodSignature, INPUT_MARKER);
        return;
    }
    Map<String, Object> inputMap = new LinkedHashMap<>();
    IntStream.range(0, parameters.length)
            .forEach(i -> inputMap.put(
                    parameters[i].getName(),
                    formatArg(args[i])));
    logAtLevel(pattern, "{} {} args: {}", methodSignature, INPUT_MARKER, inputMap);
}
LinkedHashMap preserva el orden de inserción, que coincide con el orden de declaración de los parámetros. El resultado en el log es un mapa legible donde cada clave es el nombre exacto del parámetro y cada valor es la representación JSON del argumento. Para que los nombres de los parámetros estén disponibles en tiempo de ejecución a través de parameter.getName(), el proyecto debe compilarse con la opción -parameters. En Spring Boot esto está habilitado por defecto desde la versión 3.2, así que en este stack no requiere ninguna configuración adicional.
La serialización de cada argumento pasa por formatArg:
private String formatArg(Object arg) {
    if (arg == null) return "null";
    try {
        return objectMapper.writeValueAsString(arg);
    } catch (Exception e) {
        e.printStackTrace();
        return arg.toString();
    }
}
Si Jackson no puede serializar el objeto, el método cae de vuelta a toString() como último recurso. Esto evita que un argumento no serializable rompa el flujo de logging y, por extensión, el flujo de negocio. El aspecto es un observador: nunca debe interferir con la ejecución que está observando.
OUTPUT
El registro OUTPUT captura el valor de retorno una vez que el método completa su ejecución normalmente:
private void logOutput(
        String methodSignature,
        Class<?> returnType,
        Object result,
        PatternConfig pattern) {
    if (void.class.equals(returnType) || Void.class.equals(returnType)) {
        logAtLevel(pattern, "{} {} return: void", methodSignature, OUTPUT_MARKER);
        return;
    }
    logAtLevel(pattern, "{} {} return: {}",
            methodSignature, OUTPUT_MARKER, formatArg(result));
}
El caso especial es cuando el tipo de retorno es void: no hay nada que serializar, pero sí vale la pena registrar que el método completó su ejecución. Un registro OUTPUT ausente en un flujo donde se esperaba puede ser la primera pista de que algo no terminó correctamente.
TIMING
El registro TIMING es el más rico en información operacional. Se emite siempre, tanto en el flujo normal como en el flujo de error, lo que garantiza que siempre hay una métrica de tiempo disponible independientemente de cómo terminó la ejecución:
private void logTiming(
        String methodSignature,
        Instant start,
        Instant end,
        long elapsedMs,
        PatternConfig pattern) {
    String startStr = formatInstant(start);
    String endStr = formatInstant(end);
    String elapsedFormatted = formatElapsed(elapsedMs);
    if (elapsedMs >= pattern.getWarnThresholdMs()) {
        log.warn("{} {} start: {} | end: {} | elapsed: {} ⚠️ superó umbral de {}ms",
                methodSignature, TIMING_MARKER,
                startStr, endStr,
                elapsedFormatted,
                pattern.getWarnThresholdMs());
        return;
    }
    logAtLevel(pattern, "{} {} start: {} | end: {} | elapsed: {}",
            methodSignature, TIMING_MARKER, startStr, endStr, elapsedFormatted);
}
La lógica del umbral merece atención: si elapsedMs supera warnThresholdMs, el registro se emite en WARN directamente con log.warn(), ignorando el nivel configurado en el patrón. Esto significa que aunque el adapter tenga log-level=DEBUG y en producción sus logs normales sean invisibles, un TIMING que supere el umbral siempre aparece en INFO y superior. La lentitud es siempre visible, independientemente del nivel de verbosidad configurado para esa capa.
El tiempo se formatea de forma legible según su magnitud:
private String formatElapsed(long elapsedMs) {
    if (elapsedMs < 1_000) {
        return elapsedMs + "ms";
    } else if (elapsedMs < 60_000) {
        return "%.3fs".formatted(elapsedMs / 1_000.0);
    } else {
        long minutes = elapsedMs / 60_000;
        long seconds = (elapsedMs % 60_000) / 1_000;
        long millis = elapsedMs % 1_000;
        return "%dm %ds %dms".formatted(minutes, seconds, millis);
    }
}
Menos de un segundo se muestra en milisegundos: 120ms. Entre un segundo y un minuto se muestra con tres decimales: 1.234s. Por encima de un minuto se desglosa en componentes: 2m 3s 456ms. Esta progresión hace que el número sea siempre legible en la unidad que le corresponde, sin que el ojo tenga que convertir 120000ms a 2 minutos mentalmente.
Los instantes de inicio y fin se formatean con precisión de milisegundos:
private static final DateTimeFormatter FORMATTER =
    DateTimeFormatter.ofPattern("HH:mm:ss.SSS");

private String formatInstant(Instant instant) {
    return LocalDateTime
            .ofInstant(instant, ZoneId.systemDefault())
            .format(FORMATTER);
}
El resultado en el log es start: 15:47:05.750 | end: 15:47:05.870 | elapsed: 120ms. Con esos tres valores en cada registro TIMING es posible reconstruir la línea de tiempo completa de una transacción sin necesidad de ninguna herramienta externa: basta con ordenar los registros por hora de inicio y la secuencia de etapas queda visible.
ERROR y ERROR-PROPAGATED
El manejo de errores es donde el diseño del aspecto muestra su complejidad más interesante. El problema a resolver es este: cuando una excepción sube por el stack, cada capa interceptada la captura en su bloque catch, lo que sin ningún mecanismo de control produciría un registro ERROR en cada capa que la excepción atraviesa. En el flujo del proyecto de ejemplo, una BusinessException lanzada en el UseCase sería logueada como ERROR tanto en el UseCase como en el Controller, duplicando la información y contaminando los dashboards con falsos positivos.
La solución usa dos ThreadLocal que trabajan juntos:
private static final ThreadLocal<Throwable> loggedExceptionHolder = new ThreadLocal<>();
private static final ThreadLocal<Integer> depthHolder =
    ThreadLocal.withInitial(() -> 0);
depthHolder cuenta cuántos métodos interceptados están activos simultáneamente en el stack del hilo actual. Se incrementa al entrar a cada método interceptado y se decrementa al salir, tanto en el flujo normal como en el flujo de error. loggedExceptionHolder almacena una referencia a la excepción que ya fue logueada como ERROR origen.
La lógica en el bloque de error funciona así:
} catch (Throwable ex) {
    Instant endInstant = Instant.now();
    long elapsed = endInstant.toEpochMilli() - startInstant.toEpochMilli();
    if (loggedExceptionHolder.get() == null) {
        loggedExceptionHolder.set(ex);
        logException(methodSignature, ex, elapsed, ERROR_MARKER);
    } else {
        logException(methodSignature, ex, elapsed, PROPAGATED_MARKER);
    }
    logTiming(methodSignature, startInstant, endInstant, elapsed, pattern);
    int currentDepth = depthHolder.get() - 1;
    depthHolder.set(currentDepth);
    if (currentDepth == 0) {
        loggedExceptionHolder.remove();
        depthHolder.remove();
    }
    throw ex;
}
La primera capa interceptada que captura la excepción encuentra loggedExceptionHolder vacío, la registra con ERROR_MARKER y la almacena en el holder. Cada capa superior que captura la misma excepción encuentra el holder poblado y la registra con PROPAGATED_MARKER en nivel DEBUG. En la consola, el ERROR aparece exactamente una vez, en el punto donde se originó el problema, y las capas superiores emiten un DEBUG discreto que confirma la propagación sin duplicar el ruido.
La limpieza de los ThreadLocal ocurre cuando depthHolder llega a cero, es decir, cuando el método más externo del stack interceptado termina su manejo del error. Este punto de limpieza es crítico: los hilos en un servidor web son reutilizados de un request al siguiente a través de un pool. Si los ThreadLocal no se limpian, el hilo llega al siguiente request con valores residuales del request anterior. El efecto concreto sería que la primera excepción del nuevo request encontraría loggedExceptionHolder ya poblado y se registraría como ERROR-PROPAGATED en lugar de ERROR, perdiendo el origen real del error. Es un bug silencioso que solo aparece bajo carga, cuando los hilos se reutilizan frecuentemente, y que es extremadamente difícil de reproducir en desarrollo.
La razón por la que depthHolder es necesario además de loggedExceptionHolder es precisamente esta: no basta con saber que hay una excepción registrada; hay que saber cuándo es seguro limpiarla. Sin el contador de profundidad, el aspecto no puede distinguir entre el momento en que la excepción está siendo propagada por capas internas, donde el holder debe mantenerse, y el momento en que salió completamente del stack interceptado, donde el holder debe limpiarse.
El método que emite el registro de error diferencia los dos casos:
private void logException(
        String methodSignature,
        Throwable ex,
        long elapsedMs,
        String marker) {
    if (marker.equals(PROPAGATED_MARKER)) {
        log.debug("{} {} exception: {} - {} | elapsed: {}",
                methodSignature,
                marker,
                ex.getClass().getSimpleName(),
                ex.getMessage(),
                formatElapsed(elapsedMs));
    } else {
        log.error("{} {} exception: {} - {} | elapsed: {}",
                methodSignature,
                marker,
                ex.getClass().getSimpleName(),
                ex.getMessage(),
                formatElapsed(elapsedMs));
    }
}
El ERROR origen siempre se emite en nivel ERROR, independientemente del nivel configurado en el patrón. La propagación se emite en DEBUG para que en producción con nivel INFO sea completamente invisible. Si se necesita ver la cadena de propagación para diagnosticar un problema, basta con activar DEBUG dinámicamente.
El flujo completo bajo la lupa
Con todos los componentes descritos, vale la pena recorrer la salida de consola real del proyecto para el flujo feliz y para el flujo de error. No como validación de que el código funciona, sino como lectura del sistema contando su propia historia.
Flujo feliz: registro exitoso de un usuario
La solicitud llega al Controller con nombre, email y edad. El aspecto captura la invocación antes de que el método ejecute su primera línea y emite el INPUT con los argumentos serializados:
INFO  : c.a.b.i.i.e.a.registrarusuario.RegistrarUsuarioController#registrar
        >>> [INPUT] | args: {request={"nombre":"Juan Perez","email":"[email protected]","edad":25}}
El Controller mapea el request a un RegistrarUsuarioIn e invoca el UseCase. El aspecto intercepta esa invocación también y emite el INPUT del UseCase con el comando ya mapeado:
INFO  : c.a.b.i.d.u.registrarusuario.RegistrarUsuarioUseCase#ejecutar
        >>> [INPUT] | args: {command={"nombre":"Juan Perez","email":"[email protected]","edad":25}}
Dentro del UseCase ocurren las validaciones de dominio: NombreValidator, EdadValidator y EmailDominioValidator se invocan secuencialmente. Son clases planas sin anotaciones de Spring, no son beans, y el aspecto no las ve. Su comportamiento queda implícito en el contexto del UseCase que las llama. Si alguna lanzara una excepción, aparecería en el log del UseCase como un ERROR, no en un log propio del validador.
Superadas las validaciones, el UseCase llama a gateway.existeEmail(). Spring resuelve esa llamada hacia UsuarioPersistenciaAdapter, que sí es un bean y sí está interceptado:
DEBUG : c.a.b.i.i.d.j.u.adapter.UsuarioPersistenciaAdapter#existeEmail
        >>> [INPUT] | args: {email="[email protected]"}

DEBUG : c.a.b.i.i.d.j.u.adapter.UsuarioPersistenciaAdapter#existeEmail
        <<< [OUTPUT] | return: false

WARN  : c.a.b.i.i.d.j.u.adapter.UsuarioPersistenciaAdapter#existeEmail
        *** [TIMING] | start: 15:47:05.750 | end: 15:47:05.870 | elapsed: 120ms ⚠️ superó umbral de 100ms
Tres registros para una sola llamada al adapter. El INPUT muestra exactamente qué email se consultó. El OUTPUT confirma que no existe. El TIMING revela que la operación tardó 120ms, superando el umbral de 100ms configurado para esta capa, lo que eleva automáticamente el registro a WARN aunque el nivel configurado para el adapter sea DEBUG. Este WARN es visible en producción con nivel INFO aunque todos los demás registros del adapter sean invisibles. La lentitud siempre se ve.
El UseCase continúa: genera el username, construye el objeto Usuario y llama a gateway.guardar(). El adapter es interceptado de nuevo:
DEBUG : c.a.b.i.i.d.j.u.adapter.UsuarioPersistenciaAdapter#guardar
        >>> [INPUT] | args: {usuario={"id":null,"nombre":"Juan Perez","email":"[email protected]","edad":25,"username":"juanperez","fechaRegistro":"2026-05-18T15:47:05.8756894"}}

DEBUG : c.a.b.i.i.d.j.u.adapter.UsuarioPersistenciaAdapter#guardar
        <<< [OUTPUT] | return: {"id":1,"nombre":"Juan Perez","email":"[email protected]","edad":25,"username":"juanperez","fechaRegistro":"2026-05-18T15:47:05.8756894"}

DEBUG : c.a.b.i.i.d.j.u.adapter.UsuarioPersistenciaAdapter#guardar
        *** [TIMING] | start: 15:47:05.877 | end: 15:47:05.939 | elapsed: 62ms
El INPUT del guardar muestra el objeto completo antes de persistirse, con id en null porque todavía no ha pasado por la base de datos. El OUTPUT muestra el mismo objeto con el id asignado por H2 ya presente. El TIMING marca 62ms, dentro del umbral de 100ms, así que se emite en DEBUG normal.
El UseCase completa su ejecución y retorna el RegistrarUsuarioOut. El aspecto lo captura:
INFO  : c.a.b.i.d.u.registrarusuario.RegistrarUsuarioUseCase#ejecutar
        <<< [OUTPUT] | return: {"id":1,"nombre":"Juan Perez","email":"[email protected]","username":"juanperez","fechaRegistro":"2026-05-18T15:47:05.8756894"}

INFO  : c.a.b.i.d.u.registrarusuario.RegistrarUsuarioUseCase#ejecutar
        *** [TIMING] | start: 15:47:05.748 | end: 15:47:05.940 | elapsed: 192ms
El OUTPUT del UseCase no incluye el campo edad porque RegistrarUsuarioOut no lo tiene: ese DTO de salida solo expone lo que el contrato del caso de uso devuelve. El TIMING del UseCase registra 192ms totales de orquestación, que incluyen las validaciones, las dos llamadas al adapter y la construcción de objetos intermedios.
Finalmente el Controller recibe el resultado, lo mapea a RegistrarUsuarioResponse y retorna:
INFO  : c.a.b.i.i.e.a.registrarusuario.RegistrarUsuarioController#registrar
        <<< [OUTPUT] | return: {"id":1,"nombre":"Juan Perez","email":"[email protected]","username":"juanperez","fechaRegistro":"2026-05-18T15:47:05.8756894","mensaje":"Usuario registrado exitosamente"}

INFO  : c.a.b.i.i.e.a.registrarusuario.RegistrarUsuarioController#registrar
        *** [TIMING] | start: 15:47:05.747 | end: 15:47:05.944 | elapsed: 197ms
El OUTPUT del Controller incluye el campo mensaje que RegistrarUsuarioResponse agrega al mapear desde el RegistrarUsuarioOut. El TIMING del Controller registra 197ms de extremo a extremo, 5ms más que el UseCase, que es exactamente el overhead del Controller en mappers y serialización de la respuesta HTTP.
Con esos once registros, sin ninguna línea de log escrita en ninguna clase del proyecto, el sistema cuenta su historia completa: qué llegó, por qué capas pasó, cuánto tardó cada una, y qué salió.
Flujo de error: email duplicado
La misma solicitud llega por segunda vez. El Controller y el UseCase emiten sus INPUT normalmente, idénticos a los del flujo feliz. El adapter consulta si el email existe:
DEBUG : c.a.b.i.i.d.j.u.adapter.UsuarioPersistenciaAdapter#existeEmail
        >>> [INPUT] | args: {email="[email protected]"}

DEBUG : c.a.b.i.i.d.j.u.adapter.UsuarioPersistenciaAdapter#existeEmail
        <<< [OUTPUT] | return: true

DEBUG : c.a.b.i.i.d.j.u.adapter.UsuarioPersistenciaAdapter#existeEmail
        *** [TIMING] | start: 15:47:12.883 | end: 15:47:12.887 | elapsed: 4ms
Esta vez el OUTPUT es true. El adapter completó su ejecución normalmente: encontró el email, retornó el resultado, el aspecto registró el TIMING. Hasta aquí no hay ningún error. El error ocurre en el UseCase, que recibe el true y lanza la BusinessException:
ERROR : c.a.b.i.d.u.registrarusuario.RegistrarUsuarioUseCase#ejecutar
        !!! [ERROR] | exception: BusinessException - El email ya está registrado | elapsed: 4ms

INFO  : c.a.b.i.d.u.registrarusuario.RegistrarUsuarioUseCase#ejecutar
        *** [TIMING] | start: 15:47:12.883 | end: 15:47:12.887 | elapsed: 4ms
Dos registros para el camino de error del UseCase. El ERROR captura el tipo de excepción y su mensaje, que en este caso es suficientemente descriptivo para entender qué ocurrió sin necesidad de un stacktrace. El TIMING se emite de todas formas: 4ms desde que entró el comando hasta que la excepción salió del UseCase. Nótese que no hay OUTPUT: el método no completó normalmente, así que el aspecto nunca llega al código que lo emite. La ausencia del OUTPUT es en sí misma información.
La excepción sube al Controller. El aspecto la intercepta, encuentra loggedExceptionHolder ya poblado por el UseCase, y la registra como propagación:
DEBUG : c.a.b.i.i.e.a.registrarusuario.RegistrarUsuarioController#registrar
        !!! [ERROR-PROPAGATED] | exception: BusinessException - El email ya está registrado | elapsed: 5ms

INFO  : c.a.b.i.i.e.a.registrarusuario.RegistrarUsuarioController#registrar
        *** [TIMING] | start: 15:47:12.883 | end: 15:47:12.888 | elapsed: 5ms
El ERROR-PROPAGATED se emite en DEBUG, invisible en producción con nivel INFO. El TIMING del Controller registra 5ms de extremo a extremo, 1ms más que el UseCase, que es el overhead del propio Controller antes de invocar el UseCase.
Desde el Controller la excepción sigue subiendo hasta el GlobalExceptionHandler, que la captura y construye la respuesta de error apropiada. El handler no está interceptado por el aspecto porque no tiene ninguno de los estereotipos del pointcut que coincida con un patrón configurado, así que su ejecución es completamente silenciosa desde el punto de vista del sistema de logs. El cliente recibe un HTTP 409 con el detalle del error.
Lo que este flujo demuestra es la distinción que se anticipó en la primera parte: un ERROR en el log del aspecto no siempre significa un fallo del sistema. Una BusinessException por email duplicado es una condición esperada del negocio. En un dashboard de monitoreo, filtrar por ERROR en los logs del aspecto va a incluir estos casos junto con los errores reales de infraestructura. La forma de separar ambos tipos es observar de dónde viene el ERROR: si viene de un UseCase lanzando una excepción de negocio, es ruido operacional esperado; si viene de un adapter fallando al conectar con la base de datos, es un problema genuino que requiere atención. El campo de la firma en el registro, que incluye la capa y la clase, es la clave para hacer esa distinción.
Producción sin redespliegue
Hay un escenario que todo sistema productivo enfrenta eventualmente: un comportamiento anómalo que no se reproduce en desarrollo y que requiere ver el detalle de las capas internas para diagnosticarse. En el modelo tradicional, la respuesta era subir el nivel de log a DEBUG, redesplegar, reproducir el problema, bajar el nivel, redesplegar de nuevo. En sistemas con tráfico real ese ciclo puede tomar horas y el volumen de logs generado puede saturar la infraestructura de observabilidad.
El diseño de este sistema evita ese ciclo de dos formas complementarias. La primera es estructural: los logs del adapter están en DEBUG por configuración, así que en producción con nivel INFO son completamente invisibles sin ningún costo operativo. No hay nada que desactivar porque nunca estuvieron activos. La segunda es dinámica: Spring Boot Actuator expone un endpoint que permite cambiar el nivel de log de cualquier paquete en tiempo de ejecución sin reiniciar la aplicación.
Para activarlo basta con incluir Actuator en las dependencias y exponer el endpoint de loggers en la configuración:
management.endpoints.web.exposure.include=loggers
management.endpoint.loggers.enabled=true
Con eso disponible, activar DEBUG para el paquete de los adapters en un ambiente productivo es una llamada HTTP:
POST /actuator/loggers/com.app_247.blog.id202603212000art.infrastructure.drivenadapters
Content-Type: application/json

{"configuredLevel": "DEBUG"}
A partir de ese momento, todos los registros del adapter que estaban silenciados aparecen en el log en tiempo real. Cuando el diagnóstico termina, una segunda llamada restaura el nivel a INFO y el silencio vuelve. Sin redespliegue, sin ventana de mantenimiento, sin riesgo de introducir cambios mientras se investiga un problema.
Este mecanismo refleja una filosofía más amplia que vale la pena nombrar explícitamente: el sistema de observabilidad debe poder adaptarse al momento sin modificar el sistema que está observando. La configuración por niveles y los patrones por capa son precisamente el mecanismo que hace eso posible.
Lo que se gana con este diseño
Vale la pena hacer explícito el inventario de lo que este sistema aporta, porque no todo es inmediatamente visible en el código.
La consistencia es quizás el beneficio más silencioso. Cada método interceptado produce exactamente el mismo formato de registro, con los mismos marcadores, la misma estructura de tiempo y la misma firma comprimida. No importa quién escribió la clase ni cuándo: el sistema de logs tiene siempre el mismo aspecto. En un equipo donde varias personas trabajan en paralelo sobre distintas partes del proyecto, esa consistencia es la diferencia entre un log que se puede leer y uno que requiere interpretación caso a caso.
La herencia automática es el segundo beneficio. Cada nueva clase que se añada al proyecto y que cumpla con los patrones configurados, un nuevo UseCase, un nuevo adapter, un nuevo Controller, hereda la observabilidad completa sin que nadie tenga que recordar añadir ninguna instrucción de log. El sistema crece y la observabilidad crece con él.
La separación de responsabilidades es el tercero. La lógica de negocio no sabe que está siendo observada. Los validadores de dominio no importan ninguna librería de logging. El UseCase no tiene ninguna instrucción de log. Si en el futuro el equipo decide cambiar el formato de los registros, añadir un campo nuevo a cada entrada, o integrar el sistema con OpenTelemetry, ese cambio ocurre en un único lugar: MethodLoggingAspect. Ninguna clase de negocio necesita ser modificada.
La granularidad controlable es el cuarto beneficio. El sistema tiene tres niveles de visibilidad configurables de forma independiente: los logs del Controller y el UseCase son INFO y siempre visibles, los logs del adapter son DEBUG y silenciosos en producción, y los WARN de latencia son siempre visibles independientemente del nivel de su capa. Esta estratificación permite operar en producción con un volumen de logs manejable mientras se mantiene la capacidad de activar el detalle completo en segundos cuando se necesita.
Mirando hacia adelante
Lo construido en este artículo es un sistema completo y funcional, pero no es un punto de llegada. Hay líneas naturales de evolución que vale la pena tener en el horizonte.
La más inmediata es el enmascaramiento de datos sensibles, que será el tema de la tercera parte de esta serie. El sistema actual serializa los argumentos y resultados tal como son: un email aparece en el log como texto plano, un número de identificación aparece completo. En muchos contextos eso es inaceptable desde el punto de vista de privacidad y cumplimiento regulatorio. La solución es extender el ObjectMapper que usa el aspecto con un introspector personalizado que lea anotaciones declaradas en el modelo de dominio y aplique estrategias de enmascaramiento antes de escribir el registro. El modelo de dominio declara qué es sensible; el sistema de logs lo respeta automáticamente.
Más allá del enmascaramiento, la integración con OpenTelemetry es otra extensión natural. Los registros estructurados que produce este sistema, con sus marcadores de capa y sus métricas de tiempo, son completamente compatibles con el modelo de spans de OpenTelemetry. Los mismos puntos de interceptación del aspecto que hoy emiten registros de texto podrían emitir spans instrumentados que una plataforma como Jaeger o Zipkin renderiza como árboles de llamadas con tiempos y metadatos. La transición no requeriría cambios en ninguna clase de negocio: solo en el aspecto.
La generación de métricas de aplicación a través de Micrometer desde los mismos puntos de intercepción es otra línea de evolución que elimina la duplicación entre el sistema de logs y el sistema de métricas. Hoy, para saber la latencia promedio de un adapter externo se necesita parsear los registros TIMING. Con Micrometer integrado en el aspecto, ese mismo dato podría alimentar un contador o un histograma directamente, sin pasar por texto. Una única fuente de verdad para logs y métricas, gestionada desde el mismo componente transversal.
Lo que todo esto ilustra, más allá de los detalles técnicos, es que un sistema de observabilidad diseñado con los mismos principios que se aplican a la lógica de negocio, separación de responsabilidades, consistencia, configurabilidad, no es una carga que el equipo arrastra sino una ventaja que el equipo usa. El código del proyecto queda limpio, la observabilidad queda centralizada, y la capacidad de entender qué está pasando en producción en cualquier momento queda disponible sin adivinar y sin redesplegar.
Anexo: Código fuente completo
Las clases que siguen son exactamente las que forman el sistema de logs. Todo lo demás, los validadores, los mappers, las entidades JPA, el handler de excepciones, es lógica del proyecto de ejemplo que no tiene ninguna relación con el sistema de observabilidad y que se puede reemplazar por la lógica propia de cualquier proyecto sin afectar el funcionamiento del aspecto.
Estructura de carpetas
src/main/java/com/app_247/blog/id202603212000art/
│
├── Id202603212000artApplication.java                  ★
│
└── applications/
    └── aop/
        ├── aspect/
        │   └── MethodLoggingAspect.java               ★
        └── config/
            ├── JacksonConfig.java                     ★
            └── LoggingAopProperties.java              ★

src/main/resources/
└── application.properties                             ★
Cinco artefactos. Tres en el paquete applications/aop, uno en la raíz de la aplicación y uno en recursos. Todo el sistema de observabilidad vive en esas cinco piezas.
Grupo 1 — Propiedades de configuración
LoggingAopProperties.java
package com.app_247.blog.id202603212000art.applications.aop.config;

import java.util.List;

import org.springframework.boot.context.properties.ConfigurationProperties;

import lombok.Data;

@Data
@ConfigurationProperties(prefix = "logging.aop")
public class LoggingAopProperties {
    /** Habilita o deshabilita el aspecto completo */
    private boolean enabled = true;
    /** Paquete raíz de la aplicación, primer filtro antes de evaluar regex */
    private String basePackage = "com.app_247.blog.id202603212000art";
    /** Lista de patrones de interceptación */
    private List<PatternConfig> patterns = List.of();

    @Data
    public static class PatternConfig {
        /** Regex que debe cumplir el paquete completo */
        private String packageRegex = ".*";
        /** Regex que debe cumplir el nombre simple de la clase */
        private String classRegex = ".*";
        /** Regex que debe cumplir el nombre del método */
        private String methodRegex = ".*";
        /** Nivel de log: TRACE, DEBUG, INFO, WARN, ERROR */
        private String logLevel = "INFO";
        /** Umbral en ms a partir del cual se emite un WARN de tiempo */
        private long warnThresholdMs = 500L;
    }
}
Grupo 2 — Configuración de Jackson
JacksonConfig.java
package com.app_247.blog.id202603212000art.applications.aop.config;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

import com.fasterxml.jackson.databind.ObjectMapper;
import com.fasterxml.jackson.databind.SerializationFeature;
import com.fasterxml.jackson.datatype.jsr310.JavaTimeModule;

@Configuration
public class JacksonConfig {
    @Bean
    public ObjectMapper objectMapper() {
        ObjectMapper mapper = new ObjectMapper();
        mapper.registerModule(new JavaTimeModule());
        mapper.disable(SerializationFeature.WRITE_DATES_AS_TIMESTAMPS);
        return mapper;
    }
}
Grupo 3 — El aspecto
MethodLoggingAspect.java
package com.app_247.blog.id202603212000art.applications.aop.aspect;

import java.lang.reflect.Method;
import java.lang.reflect.Parameter;
import java.time.Instant;
import java.time.LocalDateTime;
import java.time.ZoneId;
import java.time.format.DateTimeFormatter;
import java.util.LinkedHashMap;
import java.util.Map;
import java.util.Optional;
import java.util.concurrent.ConcurrentHashMap;
import java.util.stream.IntStream;

import org.aspectj.lang.ProceedingJoinPoint;
import org.aspectj.lang.annotation.Around;
import org.aspectj.lang.annotation.Aspect;
import org.aspectj.lang.reflect.MethodSignature;
import org.springframework.boot.autoconfigure.condition.ConditionalOnProperty;
import org.springframework.stereotype.Component;

import com.app_247.blog.id202603212000art.applications.aop.config.LoggingAopProperties;
import com.app_247.blog.id202603212000art.applications.aop.config.LoggingAopProperties.PatternConfig;
import com.fasterxml.jackson.databind.ObjectMapper;

import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;

@Slf4j
@Aspect
@Component
@RequiredArgsConstructor
@ConditionalOnProperty(prefix = "logging.aop", name = "enabled", havingValue = "true", matchIfMissing = true)
public class MethodLoggingAspect {

    private final ObjectMapper objectMapper;
    private final LoggingAopProperties properties;

    // -------------------------------------------------------------------------
    // Marcadores visuales
    // -------------------------------------------------------------------------
    private static final String INPUT_MARKER      = ">>> [INPUT] |";
    private static final String OUTPUT_MARKER     = "<<< [OUTPUT] |";
    private static final String TIMING_MARKER     = "*** [TIMING] |";
    private static final String ERROR_MARKER      = "!!! [ERROR] |";
    private static final String PROPAGATED_MARKER = "!!! [ERROR-PROPAGATED] |";
    private static final DateTimeFormatter FORMATTER =
            DateTimeFormatter.ofPattern("HH:mm:ss.SSS");

    // -------------------------------------------------------------------------
    // ThreadLocal: registra la excepción que ya fue logueada como ERROR origen
    // evita que capas superiores la vuelvan a loguear como ERROR
    // -------------------------------------------------------------------------
    private static final ThreadLocal<Throwable> loggedExceptionHolder =
            new ThreadLocal<>();

    // -------------------------------------------------------------------------
    // ThreadLocal: contador de profundidad de métodos interceptados activos
    // permite saber cuándo estamos en el método más externo del stack
    // -------------------------------------------------------------------------
    private static final ThreadLocal<Integer> depthHolder =
            ThreadLocal.withInitial(() -> 0);

    // -------------------------------------------------------------------------
    // Cache de matching por firma de método
    // Key: "com.app_247...RegistrarUsuarioUseCase#ejecutar"
    // Value: PatternConfig que hizo match, o empty si no hubo match
    // -------------------------------------------------------------------------
    private final ConcurrentHashMap<String, Optional<PatternConfig>> matchCache =
            new ConcurrentHashMap<>();

    // -------------------------------------------------------------------------
    // Pointcut: limitado a beans Spring, excluye el propio paquete aop
    // -------------------------------------------------------------------------
    @Around("(within(@org.springframework.stereotype.Service *)                    " +
            "|| within(@org.springframework.stereotype.Component *)                " +
            "|| within(@org.springframework.web.bind.annotation.RestController *)" +
            "|| within(@org.springframework.stereotype.Repository *))              " +
            "&& !within(com.app_247.blog.id202603212000art.aop..*)")
    public Object logMethod(ProceedingJoinPoint joinPoint) throws Throwable {
        MethodSignature signature = (MethodSignature) joinPoint.getSignature();
        Method method = signature.getMethod();
        String packageName = method.getDeclaringClass().getPackageName();
        String className   = method.getDeclaringClass().getSimpleName();
        String methodName  = method.getName();

        // Filtro rápido por paquete base antes de evaluar regex
        if (!packageName.startsWith(properties.getBasePackage())) {
            return joinPoint.proceed();
        }

        // Cache de matching: evita re-evaluar regex en invocaciones repetidas
        String cacheKey = packageName + "." + className + "#" + methodName;
        Optional<PatternConfig> matchedPattern = matchCache.computeIfAbsent(
                cacheKey,
                k -> findMatchingPattern(packageName, className, methodName));

        if (matchedPattern.isEmpty()) {
            return joinPoint.proceed();
        }

        PatternConfig pattern = matchedPattern.get();

        // Firma comprimida:
        // c.a.b.i.d.u.registrarusuario.RegistrarUsuarioUseCase#ejecutar
        String methodSignature = "%s.%s#%s".formatted(
                compressPackage(packageName),
                className,
                methodName);

        // Incrementar profundidad al entrar en un método interceptado
        depthHolder.set(depthHolder.get() + 1);

        logInput(methodSignature, signature, joinPoint.getArgs(), pattern);

        Instant startInstant = Instant.now();
        Object result;
        try {
            result = joinPoint.proceed();
        } catch (Throwable ex) {
            Instant endInstant = Instant.now();
            long elapsed = endInstant.toEpochMilli() - startInstant.toEpochMilli();

            if (loggedExceptionHolder.get() == null) {
                // Primera captura → origen del error
                loggedExceptionHolder.set(ex);
                logException(methodSignature, ex, elapsed, ERROR_MARKER);
            } else {
                // Ya fue logueada más abajo → propagación
                logException(methodSignature, ex, elapsed, PROPAGATED_MARKER);
            }

            logTiming(methodSignature, startInstant, endInstant, elapsed, pattern);

            // Decrementar profundidad al salir con excepción
            int currentDepth = depthHolder.get() - 1;
            depthHolder.set(currentDepth);

            // Limpiar ThreadLocals solo cuando salimos del método más externo
            if (currentDepth == 0) {
                loggedExceptionHolder.remove();
                depthHolder.remove();
            }

            throw ex;
        }

        Instant endInstant = Instant.now();
        long elapsed = endInstant.toEpochMilli() - startInstant.toEpochMilli();

        // Decrementar profundidad al salir en flujo normal
        depthHolder.set(depthHolder.get() - 1);

        logOutput(methodSignature, method.getReturnType(), result, pattern);
        logTiming(methodSignature, startInstant, endInstant, elapsed, pattern);

        return result;
    }

    // -------------------------------------------------------------------------
    // Compresión de paquete
    // com.app_247.blog.id202603212000art.domain.usecase.registrarusuario
    // → c.a.b.i.d.u.registrarusuario
    // -------------------------------------------------------------------------
    private String compressPackage(String packageName) {
        if (packageName == null || packageName.isBlank()) return "";
        String[] segments = packageName.split("\\.");
        if (segments.length == 1) return packageName;
        StringBuilder sb = new StringBuilder();
        for (int i = 0; i < segments.length - 1; i++) {
            sb.append(segments[i].charAt(0)).append('.');
        }
        sb.append(segments[segments.length - 1]);
        return sb.toString();
    }

    // -------------------------------------------------------------------------
    // Busca el primer patrón configurado que haga match con el método
    // -------------------------------------------------------------------------
    private Optional<PatternConfig> findMatchingPattern(
            String packageName,
            String className,
            String methodName) {
        return properties.getPatterns()
                .stream()
                .filter(pattern -> packageName.matches(pattern.getPackageRegex())
                        && className.matches(pattern.getClassRegex())
                        && methodName.matches(pattern.getMethodRegex()))
                .findFirst();
    }

    // -------------------------------------------------------------------------
    // Log INPUT
    // -------------------------------------------------------------------------
    private void logInput(
            String methodSignature,
            MethodSignature signature,
            Object[] args,
            PatternConfig pattern) {
        Parameter[] parameters = signature.getMethod().getParameters();
        if (parameters.length == 0) {
            logAtLevel(pattern, "{} {} args: (none)", methodSignature, INPUT_MARKER);
            return;
        }
        Map<String, Object> inputMap = new LinkedHashMap<>();
        IntStream.range(0, parameters.length)
                .forEach(i -> inputMap.put(
                        parameters[i].getName(),
                        formatArg(args[i])));
        logAtLevel(pattern, "{} {} args: {}", methodSignature, INPUT_MARKER, inputMap);
    }

    // -------------------------------------------------------------------------
    // Log OUTPUT
    // -------------------------------------------------------------------------
    private void logOutput(
            String methodSignature,
            Class<?> returnType,
            Object result,
            PatternConfig pattern) {
        if (void.class.equals(returnType) || Void.class.equals(returnType)) {
            logAtLevel(pattern, "{} {} return: void", methodSignature, OUTPUT_MARKER);
            return;
        }
        logAtLevel(pattern, "{} {} return: {}",
                methodSignature, OUTPUT_MARKER, formatArg(result));
    }

    // -------------------------------------------------------------------------
    // Log TIMING
    // -------------------------------------------------------------------------
    private void logTiming(
            String methodSignature,
            Instant start,
            Instant end,
            long elapsedMs,
            PatternConfig pattern) {
        String startStr        = formatInstant(start);
        String endStr          = formatInstant(end);
        String elapsedFormatted = formatElapsed(elapsedMs);
        if (elapsedMs >= pattern.getWarnThresholdMs()) {
            log.warn("{} {} start: {} | end: {} | elapsed: {} ⚠️ superó umbral de {}ms",
                    methodSignature, TIMING_MARKER,
                    startStr, endStr,
                    elapsedFormatted,
                    pattern.getWarnThresholdMs());
            return;
        }
        logAtLevel(pattern, "{} {} start: {} | end: {} | elapsed: {}",
                methodSignature, TIMING_MARKER, startStr, endStr, elapsedFormatted);
    }

    // -------------------------------------------------------------------------
    // Log ERROR / PROPAGATED
    // El marcador se recibe como parámetro para distinguir origen de propagación
    // Siempre se emite en ERROR independiente del nivel configurado en el patrón
    // -------------------------------------------------------------------------
    private void logException(
            String methodSignature,
            Throwable ex,
            long elapsedMs,
            String marker) {
        if (marker.equals(PROPAGATED_MARKER)) {
            // Solo informativo — el error real ya fue logueado en el origen
            log.debug("{} {} exception: {} - {} | elapsed: {}",
                    methodSignature,
                    marker,
                    ex.getClass().getSimpleName(),
                    ex.getMessage(),
                    formatElapsed(elapsedMs));
        } else {
            // Origen del error — siempre visible
            log.error("{} {} exception: {} - {} | elapsed: {}",
                    methodSignature,
                    marker,
                    ex.getClass().getSimpleName(),
                    ex.getMessage(),
                    formatElapsed(elapsedMs));
        }
    }

    // -------------------------------------------------------------------------
    // Emisión de log según nivel configurado en el patrón
    // -------------------------------------------------------------------------
    private void logAtLevel(PatternConfig pattern, String message, Object... args) {
        switch (pattern.getLogLevel().toUpperCase()) {
            case "TRACE" -> log.trace(message, args);
            case "DEBUG" -> log.debug(message, args);
            case "WARN"  -> log.warn(message, args);
            case "ERROR" -> log.error(message, args);
            default      -> log.info(message, args);
        }
    }

    // -------------------------------------------------------------------------
    // Helpers
    // -------------------------------------------------------------------------
    private String formatInstant(Instant instant) {
        return LocalDateTime
                .ofInstant(instant, ZoneId.systemDefault())
                .format(FORMATTER);
    }

    private String formatElapsed(long elapsedMs) {
        if (elapsedMs < 1_000) {
            return elapsedMs + "ms";
        } else if (elapsedMs < 60_000) {
            return "%.3fs".formatted(elapsedMs / 1_000.0);
        } else {
            long minutes = elapsedMs / 60_000;
            long seconds = (elapsedMs % 60_000) / 1_000;
            long millis  = elapsedMs % 1_000;
            return "%dm %ds %dms".formatted(minutes, seconds, millis);
        }
    }

    private String formatArg(Object arg) {
        if (arg == null) return "null";
        try {
            return objectMapper.writeValueAsString(arg);
        } catch (Exception e) {
            e.printStackTrace();
            return arg.toString();
        }
    }
}
Grupo 4 — Bootstrap
Id202603212000artApplication.java
package com.app_247.blog.id202603212000art;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.boot.context.properties.EnableConfigurationProperties;

import com.app_247.blog.id202603212000art.applications.aop.config.LoggingAopProperties;

@SpringBootApplication
@EnableConfigurationProperties(LoggingAopProperties.class)
public class Id202603212000artApplication {

    public static void main(String[] args) {
        SpringApplication.run(Id202603212000artApplication.class, args);
    }
}
Grupo 5 — Configuración de la aplicación
application.properties
spring.application.name=id202603212000art

# ================================
# SERVER
# ================================
server.port=8080

# ================================
# H2 DATABASE
# ================================
spring.datasource.url=jdbc:h2:mem:usuariosdb;DB_CLOSE_DELAY=-1;DB_CLOSE_ON_EXIT=FALSE
spring.datasource.driver-class-name=org.h2.Driver
spring.datasource.username=sa
spring.datasource.password=

# H2 Console (http://localhost:8080/h2-console)
spring.h2.console.enabled=true
spring.h2.console.path=/h2-console

# ================================
# JPA / HIBERNATE
# ================================
spring.jpa.database-platform=org.hibernate.dialect.H2Dialect
spring.jpa.hibernate.ddl-auto=create-drop

# ================================
# JACKSON
# ================================
spring.jackson.serialization.write-dates-as-timestamps=false
spring.jackson.time-zone=America/Bogota

# ================================
# AOP LOGGING
# ================================
logging.aop.enabled=true
logging.aop.base-package=com.app_247.blog.id202603212000art

# UseCase
logging.aop.patterns[0].package-regex=com\\.app_247\\.blog\\.id202603212000art\\.domain\\.usecase.*
logging.aop.patterns[0].class-regex=.*UseCase
logging.aop.patterns[0].method-regex=.*
logging.aop.patterns[0].log-level=INFO
logging.aop.patterns[0].warn-threshold-ms=300

# Adapter de persistencia
logging.aop.patterns[1].package-regex=com\\.app_247\\.blog\\.id202603212000art\\.infrastructure\\.drivenadapters.*
logging.aop.patterns[1].class-regex=.*Adapter
logging.aop.patterns[1].method-regex=.*
logging.aop.patterns[1].log-level=DEBUG
logging.aop.patterns[1].warn-threshold-ms=100

# Controller
logging.aop.patterns[2].package-regex=com\\.app_247\\.blog\\.id202603212000art\\.infrastructure\\.entrypoints.*
logging.aop.patterns[2].class-regex=.*Controller
logging.aop.patterns[2].method-regex=.*
logging.aop.patterns[2].log-level=INFO
logging.aop.patterns[2].warn-threshold-ms=500
Con esas cinco piezas el sistema está completo. LoggingAopProperties define las reglas, JacksonConfig provee el serializador, MethodLoggingAspect aplica la observabilidad, Id202603212000artApplication registra las propiedades en el contenedor, y application.properties conecta la configuración con el comportamiento deseado para cada capa. Cualquier proyecto que adopte estas cinco piezas y ajuste los patrones a su propia estructura de paquetes tiene el sistema funcionando desde el primer arranque, sin ninguna modificación en las clases de negocio.

Cuando todo falla, ¿Quién decide?
- Mauricio ECR
- Gestion
- 05 May, 2026
Son las 11 de la noche. El servicio de pagos lleva cuarenta minutos fallando silenciosamente — no con un error dramático que dispara alertas, sino con transacciones que se pierden sin dejar rastro en

Cuando todo falla, ¿Quién decide?
- Mauricio ECR
- Gestion
- 05 May, 2026
Son las 11 de la noche. El servicio de pagos lleva cuarenta minutos fallando silenciosamente — no con un error dramático que dispara alertas, sino con transacciones que se pierden sin dejar rastro en los logs. Un cliente lo detectó antes que el equipo y ya escribió enojado en el chat de soporte. El volumen de ventas del día está cayendo en tiempo real.
Alguien tiene que decidir: ¿revertir el último despliegue y perder dos semanas de trabajo del equipo, o seguir investigando con el riesgo de que el problema se agrave? No hay tiempo para una reunión. No hay forma de reunir a todos. Cada minuto que pasa es dinero que se pierde y confianza que se erosiona.
En ese momento, la pregunta más importante no es técnica. Es estructural: ¿quién tiene la autoridad para tomar esa decisión ahora mismo, sin consultar a nadie más, y con la confianza de que el equipo va a ejecutar lo que decida?
Si la respuesta a esa pregunta demora más de treinta segundos en aparecer, el equipo tiene un problema que no está en el código.
Dos modelos, dos promesas, un mismo contexto de caos
La industria del software lleva décadas construyendo respuestas a esa pregunta, y ha producido fundamentalmente dos modelos de organización que prometen resolverla de formas opuestas.
El primero se conoce informalmente como la Catedral: una estructura donde la jerarquía es deliberada y la responsabilidad técnica final tiene nombre y apellido. El Arquitecto, el Líder Técnico, el Tech Lead — el título varía según la empresa — es quien toma la decisión difícil cuando el sistema falla, quien responde ante el negocio por las consecuencias y quien firma con su reputación cada decisión de arquitectura. La promesa de este modelo es claridad: siempre hay alguien a quien llamar, siempre hay alguien que puede actuar sin pedir permiso. Pero esa claridad tiene un prerequisito que el modelo suele omitir en su descripción ideal: para que ese líder pueda tomar decisiones técnicas con autoridad real, necesita haber construido y operado sistemas similares. No es un rol de coordinación — es un rol de criterio técnico profundo con responsabilidad organizacional encima.
El segundo se conoce como el Bazar: una red orgánica donde la autoridad emana del conocimiento técnico del momento, no de un cargo en un organigrama. Los roles son fluidos, la propiedad del producto es compartida y la apuesta es que la inteligencia colectiva del equipo supera consistentemente a la de cualquier individuo. La promesa de este modelo es agilidad y autonomía: el equipo puede moverse rápido porque no necesita esperar que una sola persona apruebe cada decisión. Pero esa agilidad también tiene su prerequisito silencioso: para que funcione, cada miembro del equipo necesita tener el criterio técnico suficiente para tomar decisiones sin supervisión. No basta con que alguien del equipo sea técnicamente sólido — todos deben serlo, porque en ausencia de jerarquía formal, la calidad de las decisiones depende de la calidad técnica de quien las toma en cada momento.
Ambos modelos tienen defensores apasionados con argumentos sólidos. Ambos tienen casos de éxito reales y fracasos documentados. Y el debate entre ellos suele quedarse en el plano teórico, comparando los beneficios abstractos de cada uno sin hacerse la pregunta que realmente importa: ¿en qué contexto se aplica cada modelo, y qué pasa cuando se aplica en el contexto equivocado?
Lo que ambos modelos dan por sentado y nadie dice en voz alta
Antes de comparar jerarquía y autonomía, hay algo que los dos modelos asumen en silencio y que casi nunca se nombra en las discusiones sobre estructura de equipos: ninguno funciona sin una base técnica sólida como punto de partida. La diferencia está en dónde debe estar concentrada esa base.
En la Catedral, el peso técnico recae principalmente sobre el líder. Él es quien debe poder leer un stack trace a las 3 de la mañana y saber en qué capa del sistema está el problema. Quien debe entender las implicaciones de elegir consistencia eventual sobre consistencia fuerte en un modelo de datos. Quien puede evaluar si la propuesta de un ingeniero junior resuelve el problema de hoy pero crea uno mayor en seis meses. Sin ese fundamento técnico, el líder no tiene jerarquía real — tiene un título. Y un título sin criterio técnico produce algo peor que la ausencia de liderazgo: produce decisiones con autoridad pero sin fundamento, que el equipo aprende rápidamente a rodear o ignorar.
En el Bazar, ese mismo peso técnico debe estar distribuido en cada miembro del equipo. No basta con que haya dos o tres personas técnicamente sólidas rodeadas de ingenieros que ejecutan. Cuando la autoridad emana del conocimiento del momento, cada persona que toma una decisión — sobre arquitectura, sobre deuda técnica, sobre qué vale la pena optimizar ahora y qué puede esperar — necesita tener el criterio para tomarla bien. Un equipo con responsabilidad fluida y base técnica desigual no es un equipo autónomo: es un equipo donde las decisiones importantes las toman silenciosamente las dos o tres personas que saben más, mientras los demás asienten sin entender del todo las implicaciones. Eso no es horizontalidad — es una jerarquía informal y no reconocida, que tiene todos los problemas de la jerarquía sin ninguna de sus ventajas.
Nombrar esto importa porque hay una tendencia creciente en la industria a separar el liderazgo técnico de la base técnica. Cada vez más, los roles de liderazgo en equipos de software se llenan con perfiles esencialmente directivos: personas con habilidades de gestión, comunicación y coordinación, pero con poca o ninguna experiencia construyendo los sistemas que van a liderar. El argumento que suele justificarlo es que el líder no necesita saber programar — necesita saber gestionar personas y procesos. Eso puede ser cierto para un gerente de producto o un director de operaciones. Para alguien que debe tomar decisiones técnicas con consecuencias reales sobre un sistema en producción, es una trampa. El equipo lo nota desde la primera semana. Y cuando lo nota, la estructura jerárquica colapsa en la práctica aunque siga existiendo en el organigrama.
El problema que ninguno de los dos nombra
Tanto la Catedral como el Bazar comparten un supuesto silencioso: que la estructura del equipo puede diseñarse de forma independiente al sistema que ese equipo va a construir y mantener. Y ese supuesto es el origen de la mayoría de los fracasos que se atribuyen a uno u otro modelo.
La variable que ninguno de los dos nombra con suficiente claridad es el horizonte temporal del sistema.
Una landing page de campaña es efímera por diseño. Una herramienta interna de validación de datos puede ser efímera por accidente. Pero un CRM, un sistema de autenticación, una plataforma de pagos — estos sistemas nacen con la intención explícita de sobrevivir ciclos de negocio, rotaciones de personal y cambios de tecnología. Nadie construye un CRM pensando en tirarlo en dieciocho meses.
¿Cómo se distingue en la práctica un sistema persistente de uno efímero? No siempre por el tamaño ni por la complejidad técnica, sino por la intención de origen: ¿se espera que este sistema funcione más allá del equipo que lo construyó? ¿Sus decisiones de arquitectura, sus integraciones, su modelo de datos, van a necesitar ser entendidas y mantenidas por personas que todavía no han sido contratadas? Cuando la respuesta es sí, el sistema es persistente. Y los sistemas persistentes acumulan algo que no aparece en ningún diagrama de arquitectura: contexto implícito. Decisiones tomadas hace tres años por personas que ya no están. Compromisos con clientes que nunca quedaron en ningún ticket. Workarounds que resuelven problemas que nadie recuerda haber tenido. Ese conocimiento no vive en la documentación — vive en las personas.
El Bazar, con su promesa de propiedad compartida, asume que ese conocimiento se distribuye de forma natural entre el equipo. Pero en la práctica, cuando alguien se va — y en el mercado actual la rotación es la norma, no la excepción — el conocimiento se va con esa persona sin que nadie tenga la responsabilidad de haberlo transferido. Cuando esto ocurre de forma repetida, el sistema persistente se convierte en un sistema frágil que nadie entiende del todo y que todos temen tocar.
Para sistemas efímeros, la responsabilidad fluida puede funcionar razonablemente bien, especialmente cuando el equipo es pequeño, cohesionado y tiene un objetivo claro y acotado. El costo de la ambigüedad de roles es tolerable cuando el proyecto tiene fecha de muerte. Para sistemas persistentes, la ecuación cambia radicalmente.
Lo que el lector ya está pensando
Antes de continuar, vale la pena nombrar las objeciones que probablemente ya están tomando forma.
La primera es la más obvia: ¿qué pasa si el líder es mediocre? Un líder técnico malo en una estructura jerárquica produce un equipo dependiente y un sistema frágil. Es verdad. Pero un equipo mediocre en una estructura fluida produce algo diferente y en muchos aspectos peor: decisiones que nadie tomó, responsabilidades que nadie asumió y sistemas que se degradan silenciosamente porque no hay nadie a quien señalar cuando algo sale mal. La mediocridad no desaparece con la horizontalidad — solo se vuelve más difícil de identificar y, por lo tanto, más difícil de corregir.
Aquí está la pregunta que el debate suele esquivar: entre encontrar un líder técnico que sea genuinamente bueno y encontrar un equipo completo donde cada persona sea genuinamente buena, ¿cuál es estadísticamente más probable? La respuesta incómoda es que es más fácil identificar, contratar y desarrollar una persona excepcional que construir de golpe un equipo donde todos lo sean. No porque los equipos excepcionales no existan — existen, y son notables cuando aparecen — sino porque construirlos toma años de trabajo deliberado, y la mayoría de los proyectos no tienen ese tiempo ni esa estabilidad. Lo fluido funciona con equipos excepcionales. La jerarquía bien ejercida funciona con equipos buenos liderados por alguien excepcional. Esa diferencia en el umbral de entrada es, en la práctica, enorme.
La segunda objeción es igualmente legítima: la jerarquía atrofia al equipo. Si el líder concentra todas las decisiones, los ingenieros se convierten en ejecutores que esperan instrucciones y pierden la capacidad de resolver problemas por su cuenta. También es verdad — pero describe un liderazgo mal ejercido, no la jerarquía como estructura. La diferencia entre un líder que concentra y uno que distribuye es real, y tiene consecuencias técnicas enormes que conviene detallar antes de seguir.
La tercera viene con ejemplos famosos: Google, Spotify y Netflix construyeron sistemas de escala global con estructuras horizontales. Si funciona ahí, ¿por qué no acá? La respuesta requiere mirar con más cuidado lo que esas organizaciones realmente hacen — y lo que no se menciona cuando se cita su ejemplo.
El caso de Google y Spotify: lo que el ejemplo omite
Es el argumento favorito de los defensores de la autonomía radical, y merece una respuesta que no lo descarte con un gesto sino que lo examine en serio.
Primero: esas organizaciones tienen jerarquía. Spotify tiene Chapter Leads, Tribe Leads y arquitectos de plataforma. Google tiene Staff Engineers y Distinguished Engineers cuya función explícita es ser custodios del criterio técnico a escala. Lo que estas empresas han logrado no es eliminar la jerarquía sino hacerla menos visible y más permeable — lo cual es un logro notable, pero no equivale a eliminarla. Cuando en Spotify un equipo toma una decisión de arquitectura que afecta a otros equipos, hay alguien con la autoridad y el contexto para evaluar ese impacto. Ese alguien tiene un título, aunque ese título no aparezca en el organigrama que se comparte en las conferencias.
Segundo: esas empresas tienen algo que la mayoría de equipos no tiene y que rara vez se menciona cuando se cita su ejemplo: densidad de talento excepcional acumulada durante años. Google puede darse el lujo de tener autonomía radical en sus equipos porque el umbral de entrada para trabajar ahí filtra a la mayoría del mercado. Sus equipos "horizontales" están compuestos por personas que en cualquier otra empresa serían los líderes técnicos más senior. Cuando todos en el equipo tienen ese nivel de criterio técnico, la jerarquía puede volverse implícita porque cada persona ya sabe qué decisiones le corresponden y cuáles requieren coordinación. Eso no es horizontalidad — es una jerarquía tan interiorizada que ya no necesita formalizarse.
Tercero, y quizás lo más importante: esas empresas llegaron a sus modelos actuales después de haber pasado por estructuras más jerárquicas en sus primeros años. La horizontalidad que exhiben hoy es el resultado de haber construido cultura, procesos y criterio técnico compartido durante mucho tiempo, no la condición con la que empezaron. Tomar el modelo de madurez de una organización de veinte años y aplicarlo a un equipo que lleva seis meses trabajando junto es importar la conclusión sin haber hecho el trabajo.
La solución: jerarquía con función pedagógica
Lo que funciona para sistemas persistentes no es la jerarquía tradicional donde el líder acumula decisiones, ni la horizontalidad donde nadie las tiene con claridad. Es algo más preciso: una jerarquía con función pedagógica explícita, donde la autoridad se usa para distribuir capacidad, no para concentrarla.
En este modelo, el líder técnico no es el embudo de todas las decisiones. Es el arquitecto del conocimiento del equipo. Su responsabilidad principal no es tomar decisiones — es asegurarse de que el equipo pueda tomarlas sin él para el día a día, mientras él retiene la autoridad y la responsabilidad sobre las decisiones que determinan la dirección de largo plazo del sistema.
La herramienta central de este modelo es la delegación de autoridad con responsabilidad retenida. El líder puede — y debe — dar a otro miembro del equipo autoridad total sobre una subtarea específica cuando ese miembro tiene la expertise necesaria. Si el problema requiere optimización profunda de base de datos, quien tiene ese conocimiento recibe no solo la tarea sino la autoridad completa sobre esa decisión. Pero la responsabilidad de que esa persona fue elegida bien, fue informada correctamente y tiene el soporte necesario para ejecutar, sigue siendo del líder. La responsabilidad no fluye. La autoridad sí.
Esta distinción es exactamente lo que diferencia este modelo de la responsabilidad fluida: en todo momento hay claridad absoluta sobre quién responde si algo sale mal, incluso cuando quien está ejecutando no es el líder. Y es lo que resuelve la objeción de la atrofia: el equipo gana autonomía real dentro de dominios bien definidos, con la red de seguridad de saber que hay alguien que puede intervenir si la decisión excede su criterio actual.
El segundo componente es la mentoría como obligación estructural, no como virtud opcional. El líder asigna micro-responsabilidades calibradas según la capacidad de cada persona — no para quitarse trabajo de encima, sino para desarrollar el criterio técnico de quienes trabajan con él. Cuando alguien en el equipo se equivoca, el líder no corrige el error y sigue adelante: usa ese momento como insumo de aprendizaje. El objetivo explícito es que, con el tiempo, cada miembro del equipo pueda asumir responsabilidades más grandes y, eventualmente, reemplazar al líder en su función.
El tercer componente es la cadena organizacional como red de seguridad. Una de las preguntas más difíciles para cualquier estructura jerárquica es qué pasa cuando el líder se va antes de haber formado a su reemplazo. En mercados con rotación alta — que es la norma en la industria actual — esa transferencia no siempre alcanza a completarse. Pero aquí está la respuesta que el debate teórico suele omitir: ningún equipo existe en el vacío. El líder técnico reporta a alguien que tiene contexto sobre el sistema y sobre el equipo, y sobre quiénes dentro del grupo tienen el potencial de asumir más responsabilidad. Cuando hay una ruptura en la cadena de transferencia, la organización tiene el mecanismo para absorber ese golpe y reinsertar un responsable desde arriba. La responsabilidad fluida no tiene ese mecanismo: cuando el miembro más conocedor se va, simplemente distribuye el vacío entre todos los que quedan.
Lo que este modelo produce en la práctica
La diferencia más inmediata y visible es la que ocurre a las 11 de la noche cuando el servicio de pagos falla. En un equipo con esta estructura, hay una persona que puede tomar la decisión de revertir o investigar sin convocar una reunión de emergencia. Esa persona conoce el sistema, conoce el historial de decisiones y tiene la autoridad para actuar. El tiempo de respuesta se mide en minutos, no en horas de coordinación.
Pero el impacto más profundo no es la crisis — es lo que ocurre entre crisis. Un líder que mentoriza activamente produce ingenieros que crecen. Con el tiempo, las personas del equipo desarrollan criterio propio, asumen responsabilidades más complejas y operan con creciente autonomía dentro de su dominio. El sistema no queda atado a la visión de una sola persona — queda sostenido por un equipo que entiende la visión porque alguien se tomó el trabajo de transferirla.
Hay también un efecto sobre la arquitectura base que es difícil de cuantificar pero fácil de observar. Un líder que sabe que su nombre está en el sistema tiende a tomar mejores decisiones de largo plazo. No porque la responsabilidad lo haga más capaz técnicamente, sino porque lo hace más cuidadoso: la arquitectura que construye es su carta de presentación ante el equipo, ante la organización y ante el próximo proyecto donde quiera trabajar. Los atajos que funcionan esta semana pero destruyen el sistema el próximo año también llevan el nombre de quien los autorizó.
Por último, este modelo tiene un mecanismo que la responsabilidad fluida no puede replicar fácilmente: la capacidad de corregir lo que no funciona. Un equipo sin jerarquía clara no puede fácilmente remover a alguien que está frenando al grupo, porque nadie tiene la autoridad formal para hacerlo sin generar un conflicto político que paraliza al equipo entero. Un líder con responsabilidad clara tiene ese mecanismo. No es un poder cómodo de ejercer, pero su ausencia tiene un costo que se acumula en silencio durante meses hasta que se vuelve insostenible.
El modelo fluido: cuándo funciona y por qué no es el punto de partida
Sería deshonesto no dedicarle un espacio honesto al modelo que se está cuestionando. La responsabilidad fluida tiene valor real, pero en condiciones muy específicas que rara vez se discuten con honestidad cuando se promueve.
Para que funcione sin colapsar en ambigüedad y evasión, se necesitan simultáneamente varias condiciones difíciles de alcanzar: un equipo que lleva años trabajando junto, con rotación casi nula, donde cada persona ha interiorizado tan profundamente su rol y el del resto que la estructura ya no necesita ser explícita porque está implícita en la cultura. Se necesita también un sentido de pertenencia o profesionalismo lo suficientemente elevado como para que cada persona asuma responsabilidades difíciles sin que nadie se las asigne formalmente. Y se necesita que todos tengan claridad sobre el objetivo — no a nivel de ticket, sino a nivel de hacia dónde va el sistema y por qué.
Pero hay una condición que suele omitirse incluso en las descripciones más honestas del modelo: todos los miembros del equipo deben tener una base técnica sólida y homogénea. No similar — homogénea. Porque en un modelo donde la autoridad emana del conocimiento del momento, la calidad de las decisiones depende directamente de la calidad técnica de quien las toma. Un equipo fluido con base técnica desigual no es autónomo: es un equipo donde las decisiones importantes recaen silenciosamente sobre los más capaces, mientras los demás participan en la ilusión del consenso sin poder evaluarlo con criterio real. Eso no es horizontalidad — es una jerarquía informal sin los mecanismos de rendición de cuentas que la jerarquía formal provee.
Cuando esas condiciones existen, lo fluido funciona porque la jerarquía está interiorizada, no porque haya desaparecido. El equipo se comporta de forma ordenada y responsable no porque haya un organigrama que lo fuerce, sino porque años de trabajo conjunto han producido algo más poderoso que cualquier estructura formal: confianza mutua y claridad implícita de roles. Ese estado es exactamente adonde apunta la jerarquía pedagógica descrita antes — es el destino, no el método.
Usar la responsabilidad fluida como estructura inicial en un equipo nuevo, con personas que no se conocen, en un sistema que acaba de nacer, es confundir el destino con el método. Y el costo de ese error no aparece de inmediato. Aparece dieciocho meses después, cuando alguien renuncia y nadie sabe exactamente qué sabía esa persona, ni quién tiene autoridad para decidir cómo llenar ese vacío, ni cómo se toma una decisión urgente sin convocar a diez personas que tienen opiniones igualmente válidas pero ninguna responsabilidad final.
Hay además un efecto secundario que pocas organizaciones están dispuestas a nombrar en voz alta: la ambigüedad de rol no libera a las personas. Las paraliza. Un equipo donde nadie sabe con certeza qué es suyo y qué no lo es no es un equipo autónomo — es un equipo ansioso. Cuando "todos son responsables", las tareas menos gratificantes no encuentran dueño, las decisiones difíciles se postergan en busca de un consenso que a veces nunca llega, y el estrés de la incertidumbre se distribuye silenciosamente entre todos los miembros sin que nadie lo nombre como problema estructural. La claridad de responsabilidad no es una limitación a la creatividad técnica. Es la condición que la hace posible.
Los desafíos que este modelo no resuelve solo
Sería igualmente deshonesto presentar la jerarquía pedagógica sin nombrar sus dificultades reales.
El primero y más obvio es que depende de encontrar a la persona correcta para el rol de liderazgo. Un líder que acumula en lugar de distribuir, que protege sus decisiones malas porque admitirlas equivale a dañar su carta de presentación, o que carece de la vocación de mentorizar, produce exactamente el equipo atrofiado que los críticos de la jerarquía describen. El modelo no funciona con cualquier persona en el rol — funciona con alguien que entiende que su éxito se mide por la capacidad del equipo, no por su propia indispensabilidad.
Hay además una variante de este problema que se está volviendo cada vez más común y que merece nombrarse directamente: el líder técnico que dejó de ser técnico. Con el tiempo, muchos ingenieros excelentes ascienden a roles de liderazgo y gradualmente se alejan de la práctica técnica — dejan de revisar código, de entender las decisiones de arquitectura a fondo, de tener opinión informada sobre las herramientas que usa el equipo. Se vuelven coordinadores: gestionan reuniones, comunican hacia arriba, administran tiempos. El problema no es que gestionen — es que siguen teniendo la autoridad técnica final sin tener ya el criterio técnico para ejercerla bien. El equipo lo percibe, y el resultado es predecible: las decisiones técnicas reales las toman informalmente quienes sí tienen el criterio, mientras el líder firma lo que le presentan sin poder evaluarlo con profundidad. La estructura sigue existiendo en el papel, pero la autoridad real se ha desconectado de la responsabilidad formal. Ese desacople es uno de los orígenes más frecuentes y menos diagnosticados de la deuda técnica acumulada en sistemas persistentes.
El segundo desafío es que la mentoría toma tiempo que compite con la entrega. Desarrollar el criterio técnico de un equipo es un trabajo de largo plazo que no produce resultados inmediatos. En organizaciones con presión de corto plazo constante, el líder que mentoriza bien puede parecer menos productivo en el trimestre que el que simplemente ejecuta y entrega. Esa tensión es real y requiere que la organización — no solo el líder — entienda y valore el trabajo de formación de equipo como inversión, no como overhead.
El tercero es que la transición de un equipo nuevo a un equipo maduro no es lineal. Al principio, el líder necesariamente concentra más decisiones porque el equipo no tiene todavía el contexto ni el criterio para tomarlas. Con el tiempo, esa concentración debe ir disminuyendo de forma deliberada. Si no disminuye — si el líder sigue siendo el embudo de todo dos años después — el modelo ha fallado sin que nadie lo haya nombrado explícitamente.
Cómo aplicarlo sin esperar condiciones perfectas
La buena noticia es que este modelo no requiere que todo esté resuelto desde el primer día. Requiere claridad sobre el punto de partida y honestidad sobre hacia dónde se quiere llegar.
El primer paso es nombrar explícitamente el horizonte temporal del sistema. Antes de diseñar la estructura del equipo, la organización debe poder responder con honestidad: ¿se espera que este sistema funcione más allá de las personas que lo están construyendo hoy? Si la respuesta es sí, la estructura debe reflejarlo desde el inicio, no improvisarse cuando los primeros miembros del equipo comiencen a rotar.
El segundo paso es definir con claridad quién tiene la responsabilidad final, y asegurarse de que esa persona entiende que su rol incluye transferir conocimiento, no solo ejercer autoridad. Eso puede hacerse explícito en la definición del rol, en los objetivos de desempeño y en las conversaciones de seguimiento. Un líder técnico que no puede describir cómo está formando a su sucesor no está cumpliendo la parte más importante de su trabajo.
El tercero, y quizás el más importante en la práctica, es empezar a construir la cadena de reemplazo antes de necesitarla. El líder técnico debe poder señalar, en cualquier momento, quién dentro del equipo tiene el criterio y el contexto suficientes para asumir su rol si él se va mañana. Si esa persona no existe todavía, desarrollarla es la tarea más urgente del líder — más urgente que cualquier decisión técnica pendiente. Un equipo donde esa pregunta no tiene respuesta clara no es un equipo resiliente: es un equipo que está a una renuncia de distancia de una crisis.
El círculo que se cierra
Cuando una organización decide entre jerarquía y responsabilidad fluida, cree que está eligiendo una estructura de equipo. En realidad está eligiendo algo más fundamental: quién carga con el peso cuando las cosas salen mal, y qué mecanismo existe para que ese peso nunca quede sin dueño.
En un sistema jerárquico bien ejercido, esa persona es conocida por todos. Tiene la autoridad necesaria para actuar, la responsabilidad de haber construido un equipo capaz de operar cuando ella no está, y el incentivo de cuidar el sistema porque su reputación está ligada a él. Su trabajo no termina cuando asigna tareas — termina cuando el equipo puede prescindir de ella para las decisiones del día a día y aun así mantener la dirección correcta.
En un sistema verdaderamente fluido — no el fluido teórico de los libros, sino el fluido real de los equipos con plazos y presiones — esa carga se distribuye de forma que a menudo resulta en que nadie la carga del todo. Las decisiones difíciles se postergan, las tareas menos gratificantes no encuentran dueño, y cuando el sistema falla a las 11 de la noche, la primera pregunta no es "¿cómo lo arreglamos?" sino "¿a quién le corresponde arreglarlo?". Esa pregunta, en un momento de crisis, es el lujo que un sistema persistente no puede permitirse.
Volvamos al martes. El servicio de pagos sigue fallando. El equipo está disperso. El cliente espera.
En un equipo con la estructura descrita, hay una persona que toma el teléfono, evalúa la situación con el contexto que lleva meses acumulando y toma la decisión en minutos. Puede ser el líder técnico, puede ser quien él formó para ese tipo de situación, puede ser quien escaló desde la organización cuando el líder no estaba disponible. Pero hay alguien. Y ese alguien tiene tanto la autoridad como el conocimiento para actuar.
Esa certeza — saber que hay alguien que puede responder — no es un lujo organizacional. Es la diferencia entre un sistema que sobrevive el paso del tiempo y uno que se vuelve frágil cada vez que alguien del equipo decide irse.
El martes de las 11 de la noche no es la excepción. Es el criterio de verdad de cualquier estructura de equipo. Y la pregunta que toda organización debería hacerse antes de diseñar la suya no es "¿jerarquía o autonomía?" sino algo más honesto: si el sistema falla ahora mismo, ¿quién responde?
El fin de la 'Jaula de Oro': recuperar el control de tu infraestructura
- Mauricio ECR
- DevOps
- 22 Mar, 2026
Seguramente has pasado por esa etapa de "luna de miel" con las plataformas propietarias. Al principio, todo es idílico: lanzas una aplicación en Firebase en minutos, gestionas tus notas en Notion sin
El fin de la 'Jaula de Oro': recuperar el control de tu infraestructura
- Mauricio ECR
- DevOps
- 22 Mar, 2026
Seguramente has pasado por esa etapa de "luna de miel" con las plataformas propietarias. Al principio, todo es idílico: lanzas una aplicación en Firebase en minutos, gestionas tus notas en Notion sin fricciones y despliegas en Vercel con un simple clic. Sin embargo, a medida que el proyecto crece, la realidad empieza a morder. Llega una factura inesperada por un exceso de uso o te das cuenta de que tus datos están atrapados en una estructura que no puedes exportar fácilmente. Es la famosa "jaula de oro".
Esta sensación de vulnerabilidad es lo que está impulsando a miles de desarrolladores a buscar el código abierto. Pero no lo hacen solo por ahorro; lo hacen por soberanía. Quieren ser dueños del motor, no solo conductores. Para lograrlo, el primer paso es elegir los cimientos sobre los que construirás tu próxima idea.
El corazón de la App: ¿Qué motor elegimos para nuestros datos?
Cuando decides alejarte de soluciones cerradas, la primera gran pregunta es cómo sustituir la comodidad de un Backend como Servicio (BaaS). Aquí es donde el camino se bifurca según la complejidad de lo que tienes en mente.
Si buscas el rascacielos de las bases de datos, Supabase es tu respuesta. Al estar construido sobre PostgreSQL y Deno, te ofrece integridad relacional, autenticación y hasta capacidades de Inteligencia Artificial con bases de datos vectoriales. Es la opción para quien no quiere sacrificar nada. Pero quizás sientas que es "demasiada herramienta" para un proyecto personal. En ese caso, PocketBase es una revelación: un solo archivo ejecutable que usa SQLite y almacena todo localmente. Es sencillez pura, aunque requiere que tú mismo configures detalles como el servidor de correos (SMTP).
Para quienes prefieren un enfoque moderno y reactivo, Convex permite hacer consultas directamente en TypeScript, mientras que Appwrite destaca por su enfoque en la IA y su marketplace de integraciones, permitiéndote incluso alojar tu frontend en el mismo sitio. Y si eres de los que prefiere ensuciarse las manos con arquitecturas más puras, siempre puedes optar por alternativas basadas en GraphQL que se conectan a Postgres y ofrecen extensiones para gRPC o Kafka, aunque esto te obligará a escribir mucho más código propio.
Elegir el motor es vital, pero surge la duda inmediata: ¿Dónde vamos a poner a funcionar todo esto sin depender de las nubes tradicionales?
El despliegue: De inquilinos a dueños del servidor
Pasar de Vercel a un servidor propio (VPS) solía ser un proceso árido de comandos. Hoy, herramientas como Coolify actúan como tu propio panel de control privado. Con una interfaz gráfica, puedes desplegar proyectos de Node, React o bases de datos como MongoDB sin límites. Es el puente perfecto para quien quiere la facilidad de la nube en hardware propio.
Si buscas algo todavía más intuitivo y ligero, Dokploy ofrece una administración de usuarios y copias de seguridad que te hará olvidar que estás gestionando un servidor. Para los nostálgicos de Heroku que prefieren la terminal, Dokku sigue siendo el estándar del minimalismo, mientras que CapRover es la opción para el desarrollador avanzado que no quiere que una interfaz le oculte el acceso a la configuración de Nginx o Docker Swarm.
Una vez que la app está "viva", el flujo de trabajo diario nos lleva a la comunicación con el servidor. ¿Cómo probamos nuestras APIs de forma privada?
El laboratorio de APIs: Pruebas sin intermediarios
El malestar creció cuando herramientas como Postman forzaron la nube. Como respuesta, Bruno propone algo brillante: tus colecciones de API se guardan localmente en Git. Si quieres que la documentación viaje con el código, esta es la vía. Si prefieres algo más tradicional, Insomnia ofrece una experiencia casi idéntica a Postman, aunque su capa gratuita sea limitada para equipos.
Para pruebas rápidas desde el navegador, Hoppscotch (antes hop.io) es imbatible por su minimalismo. Pero el ecosistema es amplio: tienes a Yaak para despliegues en Docker, HTTPie para quienes aman la terminal legible estilo Curl, o Red Fox, un cliente minimalista para peticiones rápidas de gRPC o GraphQL sin distracciones.
Con las tuberías conectadas, el siguiente paso es organizar la mente del equipo. ¿Cómo gestionar el conocimiento sin regalar nuestras ideas a terceros?
Productividad y Datos: El cerebro del equipo
Es contradictorio construir un backend seguro si luego toda la estrategia vive en Notion. Para recuperar ese espacio, AppFlowy es el clon más fiel: tableros y bloques con la rapidez de Rust. Si necesitas algo más robusto para documentación técnica, Docmost soporta hasta ecuaciones y corre bajo Docker con Postgres y Redis.
Para quienes piensan de forma visual y conectada, Logseq usa un grafo de conocimiento y pizarras infinitas que rompen con la jerarquía de carpetas. Si el foco es la colaboración en tiempo real, Affine.pro es el especialista, mientras que BookStack se mantiene como el clásico para organizar notas anidadas de forma sencilla.
A veces, sin embargo, no necesitas notas, sino una base de datos visual. NocoDB transforma cualquier base de datos en una hoja de cálculo tipo Airtable, permitiéndote manejar imágenes y formatos complejos. Si buscas automatizar procesos, Baserow brilla con sus flujos visuales de eventos, mientras que Grist sigue siendo la opción veterana para consultas sencillas.
Pero un proyecto que crece se convierte en una organización. ¿Cómo escalamos la comunicación y los procesos de negocio?
El ecosistema empresarial: Gestión y Comunicación
Cuando Jira o ClickUp se vuelven lentos, Plane aparece como un reemplazo directo y ágil, con tableros e IA para gestionar tickets. Para la comunicación interna, Mattermost es el "Slack privado" por excelencia, ofreciendo canales y tableros en tu servidor.
Si necesitas videollamadas, Jitsi te permite tener tu propio "Zoom", aunque es de las herramientas que más hardware exige. Y para el control total de la empresa (ventas, pagos, logística), gigantes como Odoo (modular y en Python) o ERPNext te permiten administrar áreas completas bajo tu propio control.
Estimación de Recursos: ¿Qué nos cuesta la libertad?
Autohospedar te da control total, pero requiere que planifiques bien el hardware. Aquí tienes una estimación de lo que consumirá tu servidor según el uso:
| Herramienta | Reemplaza a | Uso | RAM Mínima (1-5 usuarios) | RAM Equipo (20+) | Desafío Honesto |
|---|---|---|---|---|---|
| Supabase | Firebase | Backend Pro | 4 GB RAM | 8 GB+ | Arquitectura compleja (Docker). |
| PocketBase | Firebase | MVP / Personal | 512 MB RAM | 2 GB | SQLite (límite de concurrencia). |
| Coolify | Vercel | PaaS / Despliegue | 2 GB RAM | 4 GB | Consume recursos al compilar apps. |
| Insomnia / Bruno | Postman | API Testing | Local | - | La colaboración es vía Git. |
| AppFlowy | Notion | Notas | 1 GB RAM | 2 GB | Todavía puliendo integraciones. |
| Plane | Jira | Proyectos | 4 GB RAM | 8 GB | Múltiples servicios corriendo. |
| NocoDB | Airtable | DB Visual | 1 GB RAM | 4 GB | Depende del volumen de datos. |
| Mattermost | Slack | Chat | 2 GB RAM | 4 GB | Búsquedas en tiempo real. |
| Jitsi | Zoom | Video | 4 GB / 4 vCPU | 8 GB+ | Muy sensible a la CPU y red. |
| Odoo / ERPNext | SAP / Oracle | ERP | 2 GB RAM | 8 GB | Curva de aprendizaje técnica. |
Conclusión: El círculo de la autonomía
Empezamos hablando de esa factura inesperada y de la fragilidad de no ser dueños de nuestra casa tecnológica. El recorrido por este ecosistema demuestra que la alternativa existe y es madura. No tienes que mudarte de golpe; la soberanía tecnológica es un hábito. Puedes empezar cambiando tus pruebas de API a Bruno hoy mismo, o levantando un pequeño PocketBase para tu próximo prototipo. Cada herramienta que recuperas es una llave que vuelve a tu bolsillo.
Arquitectura Modular por Contexto: Cuando la Teoría se Encuentra con la Realidad
- Mauricio ECR
- Arquitectura
- 21 Mar, 2026
Has estado ahí. Es lunes por la mañana, abres el proyecto en tu IDE, y necesitas modificar cómo se procesa un pedido. Treinta minutos después, todavía estás navegando entre carpetas intentando encontr

Arquitectura Modular por Contexto: Cuando la Teoría se Encuentra con la Realidad
- Mauricio ECR
- Arquitectura
- 21 Mar, 2026
Has estado ahí. Es lunes por la mañana, abres el proyecto en tu IDE, y necesitas modificar cómo se procesa un pedido. Treinta minutos después, todavía estás navegando entre carpetas intentando encontrar todas las piezas del rompecabezas. El caso de uso está en algún lugar del módulo de dominio, el controlador REST disperso en los entry points, el adaptador de base de datos perdido en persistencia, y probablemente algunos DTOs compartidos en carpetas que juraste que recordarías. Este es el dilema que enfrentamos constantemente: las herramientas que usamos nos imponen una estructura técnica impecable, pero nuestro cerebro humano necesita algo diferente. Necesitamos que todo lo relacionado con "procesar un pedido" esté junto, fácil de encontrar, fácil de entender, fácil de modificar.
La Estructura que las Herramientas Imponen
Para entender el problema, primero necesitamos entender cómo funcionan las herramientas de scaffolding modernas, particularmente Scaffolding of Clean Architecture—una herramienta que muchas organizaciones adoptan porque estandariza proyectos y acelera su inicio. Esta herramienta genera automáticamente una estructura basada en Clean Architecture, pero con una característica particular: todo se organiza estrictamente por naturaleza técnica a través de módulos independientes de Gradle. No son simples carpetas; son módulos que se compilan independientemente, gestionan sus propias dependencias, y establecen fronteras arquitectónicas reales. La estructura generada típicamente incluye: Un módulo de dominio completamente independiente, sin dependencias hacia otros módulos del proyecto. Aquí viven las entidades, los casos de uso, los servicios de dominio, y crucialmente, las interfaces (gateways) que definen qué operaciones necesita el dominio sin especificar cómo se implementan. Es el núcleo puro de la lógica de negocio. Un módulo de infraestructura que se subdivide en dos grandes grupos. Por un lado, los "driven adapters"—módulos para implementar persistencia (jpa-repository), para consumir servicios externos (rest-consumer), para publicar mensajes (message-sender), y otros adaptadores que implementan los contratos que el dominio define. Por otro lado, los "entry points"—módulos para exponer APIs REST (api-rest), para consumir eventos (message-listener), para tareas programadas (scheduled-task), y otros puntos de entrada al sistema. Un módulo de aplicación que ensambla todo, conteniendo la configuración que conecta las piezas, los aspectos transversales como logging y auditoría, y el punto de arranque que levanta el sistema. Desde una perspectiva arquitectónica pura, es hermoso. Inversión de dependencias impecable: el dominio define contratos, la infraestructura los implementa. Separación clara de responsabilidades: cada módulo tiene su propósito bien definido. Fronteras forzadas por el sistema de build: no puedes violar accidentalmente las dependencias porque Gradle simplemente no compilará.
El Problema que Nadie Quiere Admitir
Pero entonces llega el día a día del desarrollo, y la fricción se hace evidente.
Necesitas implementar una nueva funcionalidad: registrar un usuario. Ejecutas el comando de scaffolding para generar el caso de uso. La herramienta lo crea en domain/usecase/ en una estructura genérica. Ejecutas otro comando para generar el entry point REST. Se crea en infrastructure/entry-points/api-rest/ en otra ubicación genérica. Necesitas persistencia, ejecutas el comando para generar el adaptador JPA. Aparece en infrastructure/driven-adapters/jpa-repository/ en su propia ubicación técnica.
Cada componente vive exactamente donde debe vivir según su naturaleza técnica. El problema es que conceptualmente todos estos componentes están relacionados—todos son parte de "registrar un usuario"—pero físicamente están dispersos por toda la estructura del proyecto según su clasificación técnica.
El resultado es predecible: cinco pestañas abiertas en tu IDE, navegación constante entre módulos y carpetas, DTOs compartidos en ubicaciones centralizadas que sirven a múltiples propósitos, validadores reutilizables que intentan ser genéricos, y mappers comunes que traducen entre representaciones para varios casos de uso.
Y hay algo peor: seis meses después, cuando otro desarrollador necesita modificar esa funcionalidad de registro de usuarios, el proceso se repite. Buscar, navegar, intentar recordar dónde quedaron todas las piezas dispersas. El conocimiento está fragmentado, la comprensión es difícil, y cada modificación se siente como resolver un rompecabezas.
La pregunta natural surge: ¿por qué no simplemente abandonar esta estructura modular y volver a algo más simple donde todo esté junto? Porque entonces perdemos beneficios reales que los módulos independientes proporcionan: compilación incremental que solo recompila lo que cambió, gestión explícita de dependencias que previene acoplamiento accidental, y fronteras arquitectónicas forzadas que mantienen la integridad del diseño a largo plazo.
O podrías pensar: ¿por qué no compartir más componentes entre funcionalidades? Crear carpetas centralizadas de DTOs reutilizables, validadores comunes, mapeadores genéricos. Suena eficiente hasta que dos funcionalidades que comparten un validador divergen en sus necesidades. Entonces enfrentas la decisión imposible: ¿modificas el validador compartido arriesgando romper la otra funcionalidad, o duplicas el código que justamente intentabas evitar?
La Solución Está en la Dualidad
La respuesta no está en elegir entre estructura técnica o cohesión conceptual. La respuesta está en reconocer que ambas son valiosas pero en diferentes niveles.
Imagina mantener la estructura de módulos técnicos que Scaffolding of Clean Architecture genera—porque proporciona beneficios arquitectónicos reales—pero cambiar radicalmente cómo organizas el código dentro de cada módulo. En lugar de estructuras técnicas genéricas donde todos los componentes del mismo tipo conviven en carpetas planas, organizas por contextos de negocio donde cada funcionalidad tiene su propio espacio autocontenido.
El módulo de dominio sigue siendo un módulo de dominio, pero cuando lo abres, en lugar de encontrar una carpeta usecase/ con cincuenta casos de uso en una lista plana, encuentras algo diferente. Cada caso de uso vive en su propia carpeta de contexto: usecase/registrar-usuario/, usecase/procesar-pedido/, usecase/consultar-inventario/. Cada contexto agrupa todo lo que esa funcionalidad específica necesita.
Dentro de registrar-usuario/ no solo está el archivo del caso de uso. Está su carpeta dto/ con los DTOs de entrada y salida diseñados exactamente para lo que este caso de uso necesita—no DTOs genéricos compartidos que intentan servir múltiples propósitos. Está su carpeta mapper/ con traductores que mapean precisamente entre las representaciones que este caso de uso maneja. Está su carpeta validator/ con validadores que aplican las reglas específicas de negocio de registrar usuarios. Si necesita enriquecer datos desde otras fuentes, tiene su carpeta enricher/. Si requiere utilidades especializadas, tiene su carpeta util/.
Todo junto. Todo cohesivo. Todo autocontenido.
Lo mismo sucede en el módulo de entry points. En lugar de una carpeta genérica api-rest/ con todos los controladores mezclados, encuentras api-rest/registrar-usuario-api/ como su propio contexto. Dentro están los DTOs específicos de la API REST—diferentes de los DTOs del caso de uso porque representan el contrato externo, no el contrato de dominio. Están los mapeadores que traducen entre el mundo HTTP y el mundo del dominio. Están los validadores específicos de la capa de presentación que verifican formatos y restricciones del protocolo.
Y en el módulo de adaptadores, en lugar de entidades JPA genéricas en una carpeta común, encuentras jpa-repository/usuario-persistencia/ como contexto autocontenido con sus entidades JPA, sus repositorios Spring Data, su implementación del gateway del dominio, sus mapeadores entre entidades JPA y entidades de dominio, todo junto porque conceptualmente pertenece junto.
La estructura de módulos técnicos permanece intacta. El dominio sigue siendo independiente. Los adaptadores siguen implementando contratos del dominio. Los entry points siguen invocando casos de uso. Clean Architecture se mantiene en todo su esplendor. Pero dentro de cada módulo, la organización refleja el negocio, no solo la técnica.
Los Beneficios Tangibles que Cambian Todo
Esta dualidad—módulos técnicos afuera, contextos de negocio adentro—transforma radicalmente la experiencia de desarrollo.
Cuando necesitas modificar el registro de usuarios seis meses después de implementarlo, abres domain/usecase/registrar-usuario/ y todo está ahí. No hay búsquedas en carpetas compartidas. No hay intentos de recordar dónde quedó el validador o el mapper. La lógica del caso de uso, sus DTOs, sus validadores, sus enriquecedores, sus utilidades—todo en un solo lugar. Abres api-rest/registrar-usuario-api/ y encuentras todo lo relacionado con cómo esa funcionalidad se expone vía REST. Abres jpa-repository/usuario-persistencia/ y encuentras todo lo relacionado con cómo se persiste.
La velocidad de comprensión se dispara. Un desarrollador nuevo asignado a modificar una funcionalidad específica puede abrir su contexto y ver inmediatamente qué hace, cómo lo hace, y qué elementos utiliza. No necesita entender todo el sistema, solo el contexto específico con el que trabajará. El onboarding que solía tomar semanas ahora toma días porque el conocimiento no está disperso por todo el código base sino contenido en unidades comprensibles.
El mantenimiento se simplifica dramáticamente. Un bug en el procesamiento de pedidos significa ir a domain/usecase/procesar-pedido/. La mayoría de las veces, el problema y la solución están completamente contenidos en ese contexto. Haces el cambio, ejecutas los tests de ese contexto específico, y tienes alta confianza de que no rompiste nada más porque la independencia entre contextos minimiza los efectos colaterales.
La evolución del sistema se vuelve orgánica y natural. Una funcionalidad crítica del negocio crece en complejidad: agregas más validadores en su carpeta validator/, más enriquecedores en su carpeta enricher/, más utilidades en su carpeta util/. Otra funcionalidad permanece simple porque así lo requiere el negocio, con solo el caso de uso, un par de DTOs, y un mapper básico. No hay presión por mantener todo al mismo nivel de complejidad o estructura uniforme. Cada contexto crece según sus propias necesidades.
El trabajo en equipo fluye mejor sin fricción constante. Múltiples desarrolladores trabajan simultáneamente en diferentes contextos—uno en registrar usuarios, otro en procesar pedidos, un tercero en consultar inventario—sin colisionar porque el código está físicamente separado. Los conflictos de merge que solían ser diarios ahora son raros. Las revisiones de código son más efectivas porque los cambios están claramente contenidos: puedes ver exactamente qué se modificó dentro de un contexto específico y entender su alcance sin necesitar conocimiento exhaustivo de todo el sistema.
Y quizás lo más valioso: la confianza al hacer cambios. Cuando todo lo relacionado con una funcionalidad está junto y los contextos son genuinamente independientes, puedes modificar código con la confianza de que tus cambios no tendrán efectos colaterales sorpresa en funcionalidades no relacionadas. Los tests del contexto verifican que no rompiste esa funcionalidad específica, y la independencia entre contextos garantiza que no afectaste otras inadvertidamente.
El Principio de Duplicación Intencional
Pero hay un elefante en la habitación que necesitamos abordar directamente: verás código aparentemente duplicado. Y eso va a incomodarte.
Dos contextos tendrán validadores que lucen similares. Tres contextos tendrán mappers que parecen hacer traducciones parecidas. Varios contextos tendrán utilidades que se ven redundantes. Tu instinto—entrenado por años de escuchar "Don't Repeat Yourself"—gritará que esto está mal, que debes extraer, generalizar, compartir.
Necesitas resistir ese impulso porque está basado en una falsa equivalencia entre similitud y identidad.
Dos validadores que hoy lucen idénticos no son el mismo concepto. Uno valida emails en el contexto de registrar usuarios, donde quizás solo verificas el formato básico. Otro valida emails en el contexto de enviar campañas de marketing, donde quizás verificas que el dominio no esté en una lista de bloqueo, que el usuario haya dado consentimiento, que el email haya sido verificado previamente. Parecen el mismo código hoy, pero representan reglas de negocio de contextos diferentes que inevitablemente divergirán mañana.
Si hubieras compartido ese validador "para no duplicar código", cuando uno de los contextos necesite evolucionar—y lo necesitará—enfrentarás una decisión imposible. O modificas el validador compartido y arriesgas romper todos los contextos que lo usan, o agregas condicionales que verifican desde qué contexto se está llamando (acoplamiento horrible), o terminas duplicando el código de todas formas cuando la presión del deadline no te deja tiempo para refactorizaciones elegantes.
La duplicación intencional es el precio que pagas por la independencia. Y resulta ser un precio extraordinariamente bajo comparado con el costo del acoplamiento que crearías compartiendo componentes prematuramente.
Esto no significa nunca compartir nada. Significa compartir solo lo que tiene una razón de negocio genuina para ser compartido. Un modelo de dominio como Usuario que representa el mismo concepto fundamental a través de múltiples contextos merece vivir en domain/model/usuario/ como elemento transversal. Un servicio de dominio con lógica compleja de cálculo de precios que múltiples casos de uso invocan justifica su existencia en domain/service/calculo-precios/. Pero un validador que casualmente verifica el mismo formato en dos contextos diferentes no necesita ser compartido solo porque el código se ve similar.
La guía es simple: extrae como transversal solo cuando hay identidad conceptual de negocio, no cuando hay mera similitud técnica superficial. Y cuando dudes, prefiere duplicar. Es más fácil extraer código duplicado después cuando verdaderamente lo necesitas que desenredar dependencias compartidas cuando los contextos necesitan divergir.
Cómo Convive con las Herramientas de Scaffolding
La pregunta práctica que surge inmediatamente es: si Scaffolding of Clean Architecture genera código en ubicaciones genéricas basadas en naturaleza técnica, ¿cómo logras esta organización por contextos?
La respuesta es un flujo de trabajo disciplinado que combina generación automática con reorganización consciente.
Cuando necesitas crear un caso de uso, ejecutas el comando de scaffolding que lo genera en domain/usecase/ en una estructura base genérica. Inmediatamente después, antes de escribir una línea de lógica, creas manualmente la carpeta de contexto domain/usecase/nombre-funcionalidad/ y mueves el archivo generado ahí. Creas las subcarpetas que ese caso de uso específico necesitará: dto/, mapper/, validator/, etc.
Cuando generas un entry point REST, el scaffolding lo crea en infrastructure/entry-points/api-rest/ en ubicación genérica. De inmediato creas la carpeta de contexto api-rest/nombre-funcionalidad-api/ y reorganizas. Cuando generas un adaptador de persistencia, se crea en infrastructure/driven-adapters/jpa-repository/ genéricamente. Creas jpa-repository/contexto-persistencia/ y contextualizas.
El scaffolding proporciona el esqueleto técnico correcto en el módulo correcto con la estructura base apropiada. Tú proporcionas la organización conceptual que refleja el negocio. Es trabajo adicional, sí, pero es trabajo que pagas una vez y recuperas mil veces cada vez que necesitas encontrar, entender, o modificar código.
Esta reorganización no puede ser opcional ni algo que "haremos cuando tengamos tiempo". Debe ser parte no negociable del proceso de desarrollo desde el día uno. Cada componente generado se contextualiza inmediatamente antes de comenzar a escribir su lógica. Las revisiones de código verifican no solo que el código funciona sino que está correctamente organizado en su contexto apropiado.
La disciplina es crucial porque es fácil tomar atajos bajo presión. "Solo por esta vez dejaré el código donde el scaffolding lo generó, no tengo tiempo de reorganizar ahora." Pero esos atajos se acumulan. La estructura se vuelve inconsistente—algunos componentes contextualizados, otros dispersos genéricamente—y gradualmente pierdes todos los beneficios. Es como mantener limpia una cocina: si lavas los platos después de cada comida es fácil, si los dejas acumular se vuelve insoportable.
Maximizando los Beneficios: Desarrollo Outside-In
Con la estructura clara y el proceso de reorganización establecido, hay una práctica que potencia enormemente los beneficios de esta organización por contextos: el desarrollo outside-in. No es obligatorio seguir este enfoque, pero resulta extraordinariamente efectivo para avanzar con la seguridad de que cada paso está correctamente implementado antes de pasar al siguiente. Esta afirmación se entiende mejor al contrastarla con los inconvenientes de la forma tradicional de iniciar el desarrollo. En la forma tradicional normalmente se comienza desde el dominio y se trabaja hacia afuera. Esto implica que no puedes validar realmente que algo funciona hasta que todas las capas están implementadas. Pasas días o semanas escribiendo código sin poder ejecutar nada end-to-end, descubriendo problemas de integración solo al final cuando son más caros de resolver. El enfoque que mejor aprovecha esta estructura es el opuesto: comenzar desde el punto de entrada y avanzar hacia adentro, validando cada capa inmediatamente después de crearla.
Empiezas con el entry point. Si la funcionalidad se expondrá vía REST, generas el controlador con scaffolding, lo reorganizas en su contexto api-rest/crear-pedido-api/, creas sus DTOs de request y response, y haces que devuelva datos inventados pero con la estructura correcta. Levantas la aplicación. Haces una petición HTTP real. El endpoint responde en menos de treinta minutos desde que comenzaste. Son datos falsos, pero el contrato de la API está validado y tienes algo tangible que puedes mostrar.
Ahora creas el caso de uso. Generas con scaffolding, reorganizas en domain/usecase/crear-pedido/, creas sus DTOs—diferentes de los de la API—y lo haces devolver también datos simulados. Creas los mapeadores en api-rest/crear-pedido-api/mapper/ que traducen entre DTOs de API y DTOs de caso de uso. Inyectas el caso de uso en el controlador y conectas el flujo.
Levantas la aplicación nuevamente. Haces una petición. Los datos fluyen: API recibe → mapea a lenguaje de dominio → caso de uso procesa → mapea a lenguaje de API → responde. Todo funciona. Siguen siendo datos simulados, pero la arquitectura de comunicación entre capas está validada. Has probado que las abstracciones encajan correctamente.
Continúas capa por capa. Si el caso de uso necesita un modelo transversal que no existe, lo creas en domain/model/pedido/ con su gateway. Si necesita lógica reutilizable, creas el servicio en domain/service/calculo-descuentos/. Cada uno inicialmente con lógica simplificada o simulada.
Implementas el adaptador de persistencia. Generas con scaffolding, organizas en jpa-repository/pedido-persistencia/ con sus entidades JPA, repositorios, implementación del gateway, mapeadores. Lo pruebas de forma aislada con tests de integración contra base de datos de prueba. Solo cuando funciona correctamente lo conectas al caso de uso. Haces una petición end-to-end y por primera vez los datos realmente se persisten y recuperan.
Agregas validadores al caso de uso, uno a la vez, en domain/usecase/crear-pedido/validator/. Pruebas que rechazan correctamente datos inválidos. Agregas enriquecedores en enricher/ que complementan información. Implementas clientes para servicios externos, cada uno en su contexto en rest-consumer/servicio-inventario/. En cada paso tienes algo funcional que puedes probar.
Este flujo outside-in con retroalimentación temprana transforma el desarrollo. Nunca estás más de un paso alejado de algo que funciona. Los problemas de integración se descubren tempranamente cuando son fáciles de resolver. Siempre tienes una versión funcional—aunque incompleta—en lugar de un sistema completo que no funciona hasta el final. Y la presión psicológica desaparece porque constantemente ves progreso tangible.
Con la estructura clara y el proceso de reorganización establecido, hay una práctica que potencia enormemente los beneficios de esta organización por contextos: el desarrollo outside-in. No es obligatorio seguir este enfoque, pero resulta extraordinariamente efectivo para avanzar con la seguridad de que cada paso está correctamente implementado antes de pasar al siguiente. Esta afirmación se entiende mejor al contrastarla con los inconvenientes de la forma tradicional de iniciar el desarrollo. En la forma tradicional normalmente se comienza desde el dominio y se trabaja hacia afuera. Esto implica que no puedes validar realmente que algo funciona hasta que todas las capas están implementadas. Pasas días o semanas escribiendo código sin poder ejecutar nada end-to-end, descubriendo problemas de integración solo al final cuando son más caros de resolver. El enfoque que mejor aprovecha esta estructura es el opuesto: comenzar desde el punto de entrada y avanzar hacia adentro, validando cada capa inmediatamente después de crearla.
Con la estructura clara y el proceso de reorganización establecido, hay una práctica que potencia enormemente los beneficios de esta organización por contextos: el desarrollo outside-in. No es obligatorio seguir este enfoque, pero resulta extraordinariamente efectivo para avanzar con la seguridad de que cada paso está correctamente implementado antes de pasar al siguiente. Esta afirmación se entiende mejor al contrastarla con los inconvenientes de la forma tradicional de iniciar el desarrollo. En la forma tradicional normalmente se comienza desde el dominio y se trabaja hacia afuera. Esto implica que no puedes validar realmente que algo funciona hasta que todas las capas están implementadas. Pasas días o semanas escribiendo código sin poder ejecutar nada end-to-end, descubriendo problemas de integración solo al final cuando son más caros de resolver. El enfoque que mejor aprovecha esta estructura es el opuesto: comenzar desde el punto de entrada y avanzar hacia adentro, validando cada capa inmediatamente después de crearla.
Las Incomodidades Reales
Seamos honestos sobre los desafíos porque existen y necesitas conocerlos antes de adoptar esta aproximación. La disciplina de reorganización después de cada generación de scaffolding es real y constante. Bajo presión de deadlines, saltarse este paso es tentador. "Lo reorganizaré después" se convierte en "nunca". La solución no es intentar automatizar la reorganización—requiere juicio humano sobre qué constituye un contexto apropiado—sino hacer de la reorganización una parte no negociable del proceso. La definición de "done" incluye código correctamente contextualizado. Las revisiones de código lo verifican. Los desarrolladores nuevos son entrenados en esto desde el día uno. Las estructuras de carpetas serán más profundas. Más niveles de anidamiento que en estructuras tradicionales. Inicialmente esto se siente lento y confuso. Los IDEs modernos ayudan significativamente con búsquedas rápidas y navegación inteligente, pero aún así hay un período de adaptación de algunas semanas. Después, la mayoría de desarrolladores encuentra que localizar código es más rápido porque saben exactamente dónde buscar: todo lo relacionado con una funcionalidad está en su contexto. Decidir qué extraer como transversal y qué mantener en contextos requiere experiencia y juicio. No hay reglas absolutas que puedas seguir mecánicamente. Un modelo de dominio usado extensamente claramente debe ser transversal. Un servicio con lógica compleja reutilizable justifica extracción. Pero un mapper usado por un solo caso de uso debe permanecer en ese contexto. Esta decisión requiere práctica, y a veces te equivocarás y necesitarás refactorizar. Eso es normal y esperado. El tamaño del código base crecerá más que en aproximaciones tradicionales debido a la duplicación intencional. Esto puede parecer problemático especialmente en equipos acostumbrados a optimizar por menos líneas de código. Pero la métrica relevante no es el tamaño absoluto sino la mantenibilidad y comprensibilidad. Un código base más grande pero bien organizado, donde cada pieza tiene su lugar claro, es infinitamente más fácil de mantener que un código base más pequeño con componentes compartidos complejos y dependencias cruzadas que hacen imposible entender el impacto de los cambios.
Haciendo la Transición en Tu Equipo
Si esto resuena contigo y quieres adoptarlo, la transición requiere más que cambiar la estructura de carpetas. Comienza solo con código nuevo. Intentar refactorizar todo un código base existente de una vez es una receta para el fracasgo: demasiado costo, demasiado riesgo, demasiada resistencia del equipo. Aplica la filosofía a nuevas funcionalidades que implementes desde cero. Refactoriza código existente solo cuando ese código necesita modificaciones significativas de todas formas—entonces aprovechar para reorganizarlo en contextos apropiados es inversión que ya estás haciendo. Esta adopción gradual permite que el equipo aprenda sin el trauma de una reescritura masiva. Por algunos meses convivirán dos estilos: código viejo en estructura tradicional, código nuevo en contextos. Está bien. Eventualmente, a medida que el código viejo se modifica, se va reorganizando. En un año, la mayoría del código activo estará contextualizado. Invierte en documentación viva con ejemplos concretos de tu código base real. Abstracciones teóricas sobre "contextos autocontenidos" no funcionan tan bien como mostrar "mira, así organizamos el caso de uso de procesar pedidos, aquí están todos sus elementos, esta es la razón por la que cada uno está donde está". Cuando los desarrolladores pueden ver ejemplos reales del propio proyecto, la comprensión es inmediata. Las sesiones de pair programming donde desarrolladores experimentados en la filosofía trabajan con nuevos miembros aplicándola en práctica valen más que cualquier documento. Ver cómo alguien genera código con scaffolding y luego inmediatamente lo reorganiza, cómo decide qué subcarpetas crear, cómo identifica qué debe ser transversal versus específico del contexto—eso se aprende haciendo, no leyendo. Las revisiones de código son críticas para mantener integridad arquitectónica. Verifica que el código está en el contexto correcto, que sigue principios de autocontención, que no está creando acoplamiento innecesario. Esta verificación debe tener el mismo peso que verificar corrección funcional. Si el código funciona pero está mal organizado, solicitar cambios no es pedantería—es proteger la mantenibilidad a largo plazo del sistema. Y mantén flexibilidad dentro del marco. No todo contexto necesita la misma estructura. Un caso de uso simple no necesita todas las subcarpetas que uno complejo requiere. Lo importante son los principios—autocontención, cohesión conceptual, independencia—no seguir rígidamente una plantilla.
Performance: La Pregunta que Todos Hacen
Eventualmente alguien preguntará: "¿Toda esta separación y múltiples traducciones entre DTOs no tiene costo de performance prohibitivo?" La respuesta pragmática: en la vasta mayoría de aplicaciones empresariales, no. El costo de mapear entre DTOs de API, DTOs de caso de uso, entidades de dominio, y entidades JPA se mide en microsegundos. Las operaciones que realmente importan—queries a base de datos, llamadas HTTP a servicios externos, procesamiento de lógica de negocio compleja—se miden en milisegundos o más. Los mapeos son ruido estadístico en comparación. Cuando la performance es genuinamente crítica—procesamiento batch de millones de registros, sistemas de alta frecuencia, servicios con SLAs de latencia extremos—la arquitectura no lo prohíbe. Un caso de uso puede saltarse algunos mapeos, trabajando más directamente con representaciones de niveles inferiores si es necesario. La clave es que esto sea una decisión consciente, documentada, y justificada por mediciones reales de performance bajo carga real, no por optimización prematura basada en suposiciones. Las optimizaciones del compilador Java y la JVM también ayudan enormemente. El inlining de métodos pequeños significa que muchos mapeos que parecen caros en el código fuente son esencialmente gratuitos en el bytecode optimizado. La eliminación de código muerto elimina paths que nunca se ejecutan. El profile-guided optimization del JIT compiler optimiza los caminos que realmente se usan frecuentemente. La guía es clara: construye con la arquitectura limpia por defecto. Mide cuando tengas dudas reales. Optimiza solo donde las mediciones bajo carga real muestren necesidad. La claridad arquitectónica facilita la optimización cuando es necesaria porque es trivial identificar dónde está el cuello de botella—está en un contexto específico—y modificar solo esa parte sin afectar el resto.
El Impacto en la Cultura del Equipo
Más allá de la estructura de carpetas, esta filosofía cambia cómo los equipos trabajan y colaboran. El ownership del código se vuelve natural y claro. Cuando todo lo relacionado con una funcionalidad está en un contexto específico, es fácil asignar ownership de ese contexto a alguien. No significa que solo esa persona puede tocarlo—eso crearía silos de conocimiento—pero hay alguien responsable de su calidad, coherencia, y evolución. Cuando surge una pregunta sobre esa funcionalidad, hay un punto de contacto claro. Cuando necesita evolucionar, hay alguien que entiende su contexto completo. La planificación de sprints se simplifica porque las historias de usuario frecuentemente se mapean directamente a casos de uso, y los casos de uso son contextos autocontenidos. Estimar el esfuerzo se vuelve más predecible: implementar un caso de uso significa crear su contexto con los elementos que necesita. La variabilidad viene de cuántos y qué tipo de elementos específicos requiere—validadores complejos versus simples, múltiples enriquecedores versus ninguno—pero el patrón general es consistente. Las estimaciones mejoran porque hay menos incertidumbre sobre alcance y dependencias. La colaboración cambia de naturaleza. En lugar de conflictos constantes por múltiples personas modificando los mismos archivos compartidos, diferentes desarrolladores trabajan en diferentes contextos con mínima interferencia. Cuando necesitan coordinación, típicamente es a través de interfaces bien definidas—un caso de uso invocando un servicio de dominio, un entry point usando un caso de uso—no modificando los mismos archivos internos simultáneamente. El testing se vuelve más natural. Cada contexto puede probarse de forma aislada con sus dependencias mockeadas apropiadamente. Los tests unitarios se enfocan en lógica específica del contexto. Los tests de integración verifican que el contexto se comunica correctamente con sus dependencias reales. Los tests end-to-end verifican que el flujo completo funciona atravesando múltiples contextos. Esta separación hace que los tests sean más simples de escribir, más rápidos de ejecutar, y más fáciles de mantener porque el alcance de cada nivel de testing es claro. La rotación de personas—tanto salidas como nuevas incorporaciones—se maneja mejor. El conocimiento no está uniformemente distribuido por un código base monolítico donde entender cualquier parte requiere entender el todo. El conocimiento está organizado por contextos. Un desarrollador saliente puede documentar y traspasar los contextos de los que tenía ownership específico. Un desarrollador entrante puede comenzar tomando ownership de contextos particulares, aprendiendo el sistema incrementalmente en lugar de necesitar una descarga masiva de conocimiento de todo desde el día uno.
Evolución y Futuro
Esta filosofía híbrida no es un destino final sino un punto en la evolución continua de cómo organizamos código complejo. Las herramientas seguirán mejorando. Los IDEs se volverán más inteligentes en entender y navegar estructuras modulares complejas. Las herramientas de scaffolding podrían eventualmente aprender a generar código ya organizado por contextos, preguntando al desarrollador a qué contexto de negocio pertenece el componente antes de generarlo. La generación de código asistida por IA podría entender patrones arquitectónicos como esta filosofía de contextos y generar código que automáticamente se organiza correctamente, reduciendo la carga de disciplina manual. Las herramientas de análisis estático podrían detectar violaciones de la organización por contextos, identificando cuando un contexto accede directamente a detalles internos de otro o cuando la estructura se está volviendo inconsistente. A medida que más sistemas evolucionan hacia arquitecturas distribuidas, la clara separación de contextos se vuelve aún más valiosa. Los bounded contexts bien definidos facilitan decisiones sobre qué debe desplegarse junto y qué podría beneficiarse de despliegue independiente como microservicios. Los módulos Gradle proporcionan las fronteras naturales para estas decisiones, y la organización por contextos asegura que cada unidad desplegable sea cohesiva y completa. Pero más allá de las herramientas futuras, los principios permanecen: autocontención facilita comprensión, cohesión conceptual facilita mantenimiento, independencia entre contextos facilita evolución. Estos principios son atemporales incluso si los detalles de implementación evolucionan con nuevas tecnologías.
Casos Reales y Lecciones Aprendidas
En equipos que han adoptado esta aproximación, ciertos patrones emergen consistentemente. La transición inicial típicamente toma entre cuatro y ocho semanas. Las primeras dos semanas son de confusión y resistencia—"esto parece más complicado", "por qué estamos duplicando código", "no entiendo dónde poner las cosas". Las siguientes dos a cuatro semanas son de adaptación—el músculo de reorganizar después de scaffolding se desarrolla, las decisiones sobre qué contextualizar versus qué extraer se vuelven más naturales. Después de seis a ocho semanas, la mayoría de desarrolladores reporta que encontrar y modificar código se siente significativamente más fácil que antes. El momento "ajá" típicamente llega cuando un desarrollador necesita modificar una funcionalidad que implementó semanas antes. Abre el contexto esperando tener que buscar piezas dispersas por todo el proyecto, y descubre sorprendido que todo está ahí. "Oh, esto realmente funciona." Los equipos exitosos típicamente desarrollan sus propias convenciones específicas sobre nombrado de contextos, cuándo crear subcarpetas adicionales, cómo documentar decisiones de diseño dentro de contextos. Estas convenciones locales complementan los principios generales, adaptando la filosofía a las necesidades específicas del dominio y la cultura del equipo. Un error común es intentar que todos los contextos tengan exactamente la misma estructura. Un caso de uso complejo puede tener ocho subcarpetas diferentes. Uno simple puede tener solo tres. Ambos están bien. La estructura sirve a la funcionalidad, no al revés. Forzar uniformidad rígida crea carpetas vacías o artificialmente pobladas que no agregan valor. Otro error es ser demasiado conservador con la duplicación, intentando extraer cualquier similitud mínima. Esto recrea el problema original de componentes compartidos con dependencias complejas. La guía que funciona: cuando dudes si extraer, espera. Duplica inicialmente. Solo extrae cuando el tercer o cuarto contexto necesita exactamente lo mismo y tienes evidencia clara de que representa un concepto verdaderamente transversal del negocio, no solo similitud técnica superficial.
Relación con Otros Patrones
Esta filosofía no existe en vacío sino que complementa y se integra con otros patrones y prácticas establecidas. Domain-Driven Design proporciona el vocabulario para identificar y organizar contextos. Los bounded contexts de DDD se mapean naturalmente a agrupaciones de contextos en esta arquitectura. Las entidades, value objects, aggregates, y domain events de DDD encuentran su lugar en los contextos de modelo. Los servicios de dominio de DDD corresponden directamente a los servicios de dominio en esta estructura. CQRS puede aplicarse dentro de la organización por contextos. Los casos de uso que modifican estado (comandos) pueden organizarse claramente separados de los que solo leen (queries), permitiendo optimizaciones diferentes para cada tipo sin sacrificar claridad organizacional. Event Sourcing se integra naturalmente. Los domain events que las entidades generan pueden persistirse como event stream. Los adaptadores de persistencia implementan event stores. Los casos de uso publican eventos que otros contextos consumen, manteniendo independencia entre bounded contexts mientras permiten coordinación. La relación con Microservicios es interesante. Cada bounded context con sus casos de uso, servicios, y adaptadores podría potencialmente extraerse como microservicio independiente. Los módulos Gradle proporcionan fronteras naturales para esta extracción. Los gateways que actualmente se implementan con adaptadores locales podrían reemplazarse con adaptadores que hacen llamadas remotas. La organización por contextos facilita esta evolución porque las dependencias entre contextos son explícitas a través de gateways, haciendo visible el acoplamiento que necesitaría convertirse en comunicación remota.
El Verdadero Valor
Al final, todo esto se reduce a una verdad simple: la arquitectura de software existe para facilitar resolver problemas de negocio de manera efectiva y sostenible en el tiempo.
Una buena arquitectura es aquella que permite a los desarrolladores entender rápidamente qué hace el código, hacer cambios con confianza, y evolucionar el sistema según las necesidades del negocio cambian. No es la que se ve más elegante en un diagrama. No es la que usa las tecnologías más nuevas. No es la que tiene menos líneas de código. Es la que funciona para el equipo que la mantiene y el negocio que la necesita.
Esta filosofía híbrida de contextos dentro de módulos técnicos busca precisamente eso. No promete eliminar toda complejidad—la complejidad es inherente a sistemas empresariales que resuelven problemas complejos—pero promete organizarla de manera que sea manejable y comprensible.
Promete que cuando necesites modificar algo, sabrás dónde buscar porque todo lo relacionado está junto. Promete que tus cambios estarán contenidos y sus efectos predecibles porque los contextos son independientes. Promete que nuevos desarrolladores pueden comenzar a contribuir sin necesitar entender todo el sistema porque pueden tomar ownership de contextos específicos.
No es la única manera de organizar código, y no será la mejor para todos los proyectos y equipos. Pero para equipos que trabajan con herramientas de scaffolding que generan estructura modular, que construyen aplicaciones empresariales complejas donde el código vive y evoluciona durante años, y que valoran tanto la disciplina arquitectónica como la productividad práctica, ofrece un balance probado entre estructura y pragmatismo.
La adopción requiere más que cambiar carpetas. Requiere cambiar cómo piensas sobre organización de código. Requiere disposición a cuestionar dogmas como "nunca duplicar código" y reconocer que la duplicación intencional es frecuentemente mejor que el acoplamiento prematuro. Requiere disciplina para mantener integridad arquitectónica incluso bajo presión. Requiere inversión en documentación, entrenamiento, y procesos de revisión que refuercen los principios.
Pero para equipos dispuestos a hacer esa inversión, los retornos son reales y duraderos. Código que seis meses después todavía puedes entender rápidamente. Cambios que implementas con confianza sabiendo que no romperás cosas no relacionadas. Sistemas que crecen en funcionalidad sin colapsar bajo su propio peso. En un mundo donde el software exitoso inevitablemente crece en complejidad, eso no es poca cosa.
Así que la próxima vez que abras un proyecto y necesites modificar cómo se procesa un pedido, no pasarás treinta minutos buscando piezas dispersas por toda la estructura. Abrirás domain/usecase/procesar-pedido/ y todo estará ahí. Esa es la promesa. Esa es la diferencia.